
Karpenter vs Cluster Autoscaler: comparação de escalabilidade de nós no AWS EKS
Introdução
Três da manhã. Você está olhando para os alertas vermelhos no Grafana, e os Pods já estão há quatro minutos presos em Pending. O pico de tráfego chegou, mas os nós ainda estão “iniciando”.
No cluster ao lado, o administrador já está dormindo. O sistema de escalabilidade dele colocou os nós no ar em 55 segundos.
Isso não é exagero. É a diferença real entre Karpenter e Cluster Autoscaler.
Para ser sincero, eu também duvidei quando vi esses números pela primeira vez. A diferença entre um minuto e três minutos é mesmo tão grande assim? Só depois de rodar os dois sistemas no EKS eu entendi: a diferença é grande o suficiente para fazer você repensar toda a estratégia de escalabilidade de nós.
Segundo um relatório da Reintech de 2026, o Karpenter escala em menos de 60 segundos, enquanto o Cluster Autoscaler, daqui em diante CA, precisa de 3 a 5 minutos [1]. Em custos, relatos reais de usuários apontam economia de 20% a 40% [2]. A Salesforce chegou a concluir a migração em uma frota de mais de mil clusters [3].
Este artigo vai ajudar você a entender onde essas duas ferramentas realmente diferem, qual escolher e como migrar. Vou responder com dados reais, exemplos completos de configuração e uma linha do tempo de migração.
1. Comparação de arquitetura: por que a diferença de velocidade é tão grande?
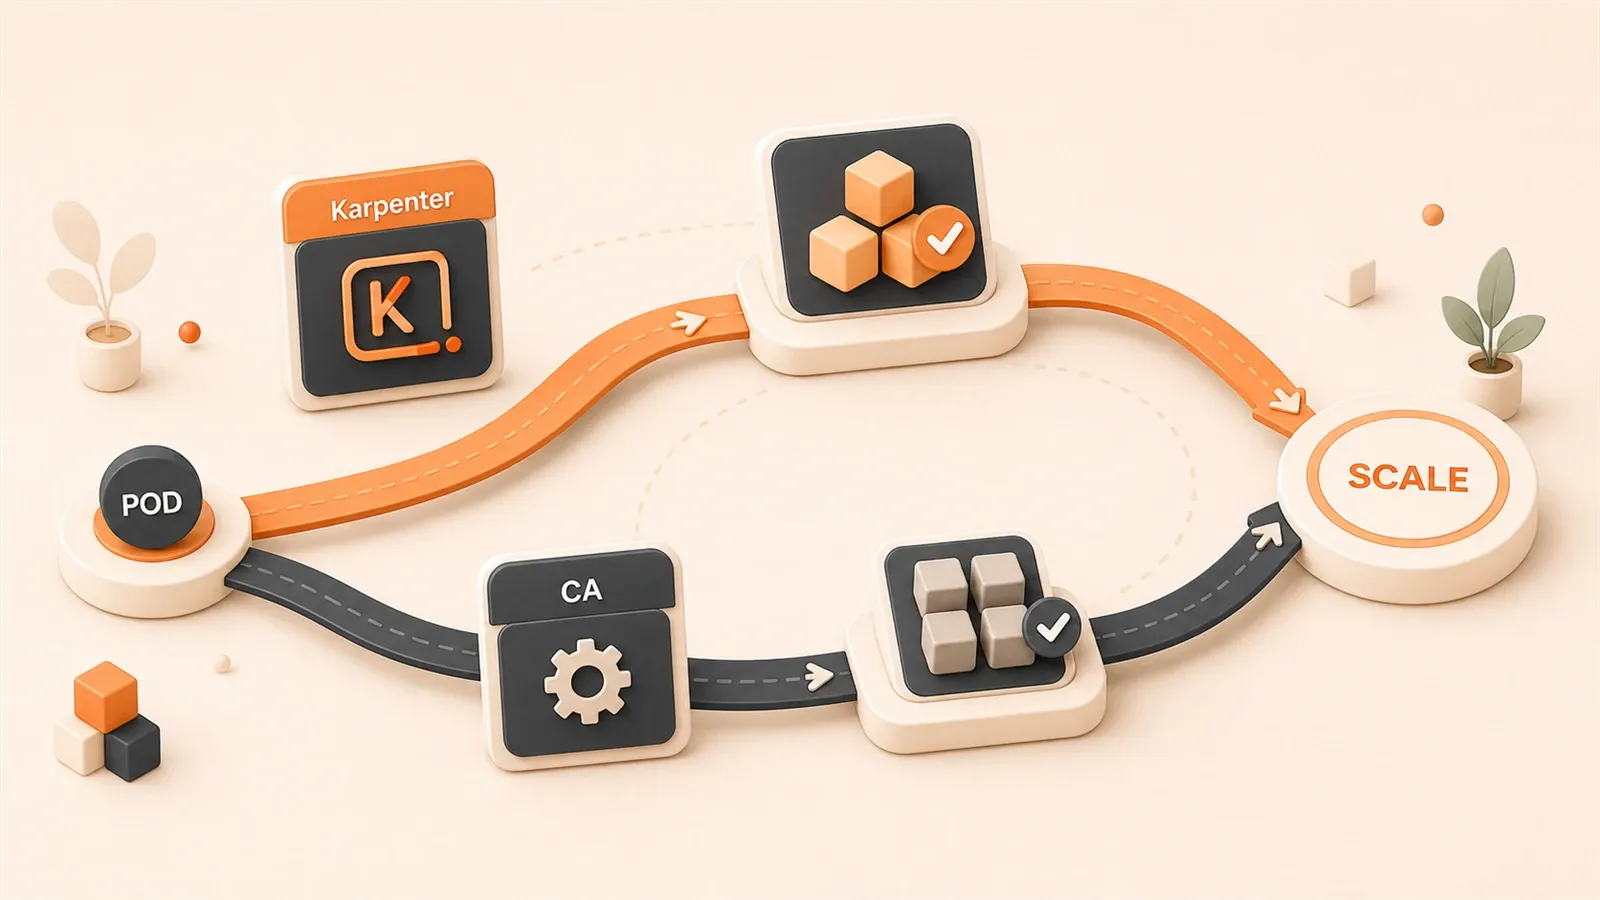
A diferença central: o CA depende de grupos de nós; o Karpenter configura nós diretamente.
A frase parece simples, mas a diferença arquitetural por trás dela afeta todo o fluxo de escalabilidade.
O caminho “com desvio” do Cluster Autoscaler
O CA trabalha como se precisasse dar uma volta.
Quando o agendamento de um Pod falha, o CA primeiro verifica os grupos de nós predefinidos, os Node Groups. Cada grupo de nós está vinculado a tipos fixos de instância. Por exemplo: você pode ter um node-group-1 configurado com m5.large e um node-group-2 configurado com c5.xlarge.
O CA precisa pensar primeiro: qual grupo de nós serve? Depois de escolher, ele chama a API da nuvem, no caso da AWS a Auto Scaling Groups API, para pedir expansão. Em seguida, espera o ASG iniciar a instância, espera a instância entrar no cluster, espera o nó ficar Ready e só então consegue agendar o Pod.
No fim, são 4 a 5 etapas. Cada uma adiciona latência.
O ponto mais sensível é o trecho “verificar grupos de nós -> escolher grupo de nós”. Se o seu Pod precisa de GPU, mas nenhum grupo de nós tem esse tipo, o CA fica sem saída: ele só consegue escolher entre os grupos já existentes.
O caminho direto do Karpenter
O Karpenter funciona de outro jeito.
O agendamento do Pod falhou? Sem problema. O Karpenter olha diretamente para as necessidades do Pod: quanto de CPU? Quanta memória? Precisa de GPU? Existe algum toleration ou nodeSelector especial?
Depois de analisar a demanda, o Karpenter chama diretamente a API do EC2 e provisiona a instância mais adequada. Não precisa de grupo de nós, não precisa de ASG; ele casa a instância com a necessidade do Pod.
Depois, o nó inicia, entra no cluster e o Pod é agendado. São 2 etapas principais, sem aquela camada intermediária.
A documentação oficial da AWS é bem direta: o Karpenter consegue iniciar capacidade computacional em menos de 1 minuto [4].
Uma analogia
Pense no CA como o fluxo de pedido em um restaurante. O cliente quer frango apimentado; o garçom precisa olhar se o prato existe no cardápio, ou seja, verificar o grupo de nós. Se existir, ele envia o pedido, a cozinha prepara os ingredientes, a instância inicia e, por fim, o prato chega à mesa, ou o Pod é agendado.
O Karpenter parece mais uma cozinha sob demanda. O cliente quer frango apimentado; o cozinheiro olha direto para o pedido, pega os ingredientes no estoque, chama a API do EC2 e prepara na hora.
Qual é mais rápido? Dá para ver de cara.
Por que o CA depende de grupos de nós?
O CA foi desenhado desde o início para suportar multicloud. O mecanismo de grupos de nós permite usar a mesma lógica em AWS, GCP e Azure; o nome da peça muda em cada nuvem, como ASG na AWS, MIG no GCP e VMSS no Azure.
Mas esse desenho também traz limites. Você precisa definir os grupos de nós antes. Quer usar um novo tipo de instância? Crie um grupo de nós primeiro. Quer adicionar instâncias Spot? Crie um grupo de nós Spot primeiro. O custo de manutenção sobe, e a flexibilidade cai.
O Karpenter, por outro lado, nasceu com desenho nativo para AWS. Ele não precisa dessa camada intermediária de grupos de nós e conversa diretamente com a API do EC2. O ponto fraco é o suporte multicloud mais limitado, hoje principalmente AWS. O ponto forte é velocidade, flexibilidade e configuração mais enxuta.
2. Benchmark de desempenho: o que aparece em ambiente real
O Karpenter escala para cima rápido, e também não fica para trás na redução.
Os dados deste capítulo vêm principalmente de duas fontes: testes técnicos da CHKK e feedback real de usuários.
Velocidade de expansão: comparação prática
Os dados de teste da CHKK são bem visuais [5]:
- Karpenter: tempo para colocar um Pod intensivo em CPU no ar em cerca de 55 segundos
- Cluster Autoscaler: mesma carga, 3 a 4 minutos
Essa diferença bate com a afirmação oficial da AWS de “menos de 1 minuto” [4].
Um usuário no Reddit fez um teste próprio e comentou que, no ambiente dele, a diferença não foi tão dramática: o atraso até o nó ficar pronto era parecido, provavelmente porque o cluster era pequeno, com cerca de 10 nós [6]. Mas é um relato de um único usuário, com amostra limitada; vale como referência, não como conclusão.

Eficiência na redução: quem economiza mais?
Expandir rápido é só a superfície. A eficiência ao reduzir capacidade é o que realmente economiza dinheiro.
A lógica de redução do CA é baseada em varredura periódica: a cada intervalo, por padrão 10 segundos, ele verifica o cluster e procura nós que ficaram ociosos por tempo suficiente. Se o nó passa do limite, por padrão 10 minutos, a redução é disparada.
O Karpenter é diferente. Ele usa o recurso de Consolidation: monitora a utilização dos nós em tempo real e combina ou substitui nós quando faz sentido.
Um exemplo: seu cluster tem 3 nós m5.xlarge, com utilização de 30%, 25% e 20%. O Karpenter avalia: esses Pods cabem em 1 nó m5.large? Se couberem, ele remove os 3 nós maiores e troca por 1 nó menor.
O ganho dessa lógica aparece em dados da própria AWS: instâncias Spot combinadas com Consolidation podem economizar até 90% de custo em relação a On-demand [7].
Diferença em clusters grandes
O CA tem gargalos em clusters grandes, com mais de 100 nós.
O blog da ScaleOps menciona que, quanto mais grupos de nós existem, mais lenta fica a decisão de agendamento do CA [8]. Isso acontece porque o CA precisa percorrer todos os grupos de nós para encontrar o mais adequado. Quando o número de grupos aumenta, o tempo de varredura cresce e a latência piora.
O Karpenter não tem essa limitação. Ele não depende de grupos de nós; analisa diretamente a demanda do Pod e encontra o melhor tipo de instância. Mesmo com o cluster crescendo, a lógica permanece a mesma.
Caso prático: cargas em lote
Um cenário real que já vi.
Um pipeline de dados dispara um batch a cada hora e precisa de 50 worker Pods. No ambiente com CA, os Pods ficaram 3 minutos em Pending, o batch começou atrasado e o ciclo completo do pipeline ficou mais longo.
Depois da migração para Karpenter, todos os Pods ficaram Running em menos de 50 segundos. O batch começou no horário, e o ciclo de processamento downstream voltou ao normal.
O ponto-chave desse cenário é a sensibilidade ao tempo de partida. Três minutos de espera podem atrasar toda a cadeia de dados. Escalar em menos de um minuto, para esse tipo de carga, é necessidade prática.
3. Economia de custo: o segredo dos 20% a 40%
A vantagem de custo do Karpenter vem de três mecanismos: instâncias Spot, Consolidation e estratégia de seleção de instâncias.
Separados, esses três pontos não são novidade. Combinados, chegam a uma economia de 20% a 40%, segundo dados reais de usuários no relatório da Reintech [2].
Instâncias Spot: até 90% de economia
O preço das instâncias AWS Spot pode ser até 90% menor que On-demand [7]. Esse dado vem da própria AWS, então tem alta confiabilidade.
Mas Spot tem risco: a instância pode ser interrompida a qualquer momento. A AWS avisa com 2 minutos de antecedência e então recupera a instância [7].
Com CA, usar Spot exige criar grupos de nós Spot manualmente e configurar a lógica de tratamento de interrupção. O fluxo é trabalhoso e fácil de errar.
O Karpenter trata interrupções Spot automaticamente. Quando recebe o aviso de interrupção, ele faz cordon, marcando o nó como não agendável, e drain, movendo os Pods para outros nós, dentro da janela de 2 minutos. Você não precisa escrever scripts extras; essa lógica já vem no Karpenter.
Estratégia PCO: escolher Spot com inteligência
O Karpenter usa a estratégia Price Capacity Optimized (PCO) [7].
Em termos simples: primeiro ele escolhe os pools Spot com menor probabilidade de interrupção; depois, dentro desses pools, escolhe o tipo de instância mais barato.
A inteligência dessa estratégia está em equilibrar dois objetivos: economizar e manter estabilidade. Escolher o pool mais barato pode aumentar interrupções; escolher o mais estável pode reduzir a economia. O PCO procura um ponto intermediário.
O blog oficial da AWS explica a lógica em detalhes [7]:
- O Karpenter monitora a taxa de interrupção dos pools Spot, com dados oficiais da AWS
- Filtra pools com taxa alta de interrupção
- Escolhe, entre os pools restantes, os tipos de instância mais baratos
Essa lógica não exige configuração. O Karpenter habilita isso por padrão.
Consolidation: economia em tempo real
Eu já mencionei Consolidation no segundo capítulo. Aqui vale mostrar a configuração.
O Karpenter suporta duas políticas de Consolidation [7]:
WhenEmpty: remove nós completamente ociososWhenUnderutilized: tenta combinar ou substituir nós com baixa utilização
O padrão é WhenUnderutilized, mais agressivo.
Exemplo:
# Karpenter NodePool - configuração de Consolidation
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  disruption:
    consolidationPolicy: WhenUnderutilized  # combinação mais agressiva
    consolidateAfter: 1m                     # dispara após 1 minuto ocioso
O CA não tem esse recurso. Ele só consegue remover periodicamente nós ociosos por bastante tempo. Não consegue “combinar nós pequenos em um maior” nem “substituir uma instância cara por outra mais barata” com a mesma lógica.
Cálculo de ROI: ganho real
Suponha que seu cluster custe $50.000 por mês, com 100 nós e tipos mistos de instância.
Depois de migrar para Karpenter, uma estimativa conservadora de 20% economizaria $10.000/mês.
Uma estimativa agressiva, usando bastante Spot + Consolidation, economizaria 40%: $20.000/mês.
Em um ano, isso significa de $120.000 a $240.000 de economia.
Esse cálculo não é inventado; ele se baseia nos dados reais de usuários da Reintech [2]. Claro, o ganho real depende do tipo de carga, da proporção de Spot e da configuração de Consolidation.
Comparação de configuração: qual dá menos trabalho?
Fluxo de configuração Spot com CA:
- Criar um ASG Spot, escolhendo manualmente os tipos de instância
- Configurar a estratégia de alocação Spot do ASG
- Escrever script de tratamento de interrupção, monitorando avisos e fazendo drain manual
- Configurar o parâmetro
--node-group-auto-discoverydo CA
Configuração Spot com Karpenter:
# Um NodePool resolve
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values: ["spot", "on-demand"]  # escolhe Spot ou On-demand automaticamente
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values: ["c", "m", "r"]  # famílias c/m/r, com diversidade suficiente
  disruption:
    consolidationPolicy: WhenUnderutilized
Um único YAML cobre escolha de Spot, diversidade de tipos de instância e Consolidation. O Karpenter trata interrupções automaticamente, escolhe a melhor instância automaticamente e combina nós automaticamente.
A diferença de esforço operacional é bem clara.
4. Complexidade de configuração: análise de custo-benefício
O CA é rápido de configurar; o Karpenter demora mais para aprender, mas o custo de manutenção se inverte no longo prazo.
Os dados deste capítulo vêm do relatório da Reintech [1]: tempo de configuração do CA em “algumas horas” e do Karpenter em “1 a 2 dias”.
Quando vi esse número pela primeira vez, achei exagerado. Depois de configurar na prática, percebi que a Reintech estava bem perto da realidade.
CA: fácil de começar, cansativo de manter
Fluxo de configuração do CA:
# CA Deployment (versão simplificada)
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cluster-autoscaler
  namespace: kube-system
spec:
  containers:
  - name: cluster-autoscaler
    image: k8s.gcr.io/autoscaling/cluster-autoscaler:v1.30.0
    command:
    - ./cluster-autoscaler
    - --node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled
    - --scale-down-unneeded-time=10m
    - --scale-down-delay-after-add=10m
Os parâmetros principais são poucos: descoberta de grupos de nós, limites de redução e tempos de atraso. Depois de configurar o Deployment e criar os grupos de nós, ou ASGs, o CA já consegue rodar.
Algumas horas são suficientes. Não é exagero.

Mas o custo de manutenção aparece depois.
Sempre que você quiser adicionar um novo tipo de instância, precisa criar um novo grupo de nós. Quer adicionar Spot? Crie um grupo de nós Spot. Com muitos grupos, a gestão fica trabalhosa: cada ASG tem seu próprio min/max de nós, tipo de instância e configuração de labels.
Com o tempo, os arquivos de configuração de grupos de nós viram uma pilha de YAML. Mudar um parâmetro pode afetar vários grupos.
Karpenter: mais lento para aprender, mais confortável para manter
A complexidade do Karpenter está em entender os conceitos.
Você precisa compreender NodePool, Disruption, Consolidation e requirements. Na primeira vez que usei, levei um dia para entender o significado de cada parâmetro.
# Karpenter NodePool (versão completa)
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values: ["c", "m", "r"]
      - key: karpenter.sh/capacity-type
        operator: In
        values: ["spot", "on-demand"]
      - key: karpenter.k8s.aws/instance-generation
        operator: Gt
        values: ["5"]  # instâncias de 5ª geração ou mais novas
      nodeClassRef:
        name: default
  disruption:
    consolidationPolicy: WhenUnderutilized
    consolidateAfter: 1m
  limits:
    cpu: 1000
    memory: 1000Gi
Esse YAML tem mais parâmetros do que o Deployment do CA. Mas, depois de entender, fica claro: um único NodePool cobre vários tipos de instância, mistura Spot/On-demand e habilita Consolidation automática.
O custo de manutenção fica quase zerado.
Quer adicionar novos tipos de instância? Altere os values em requirements e adicione uma família. Quer ajustar a estratégia de Consolidation? Mude consolidationPolicy.
Tudo em um único YAML, sem manter uma coleção de grupos de nós.
O trade-off entre as duas configurações
A recomendação da Reintech é bem prática [1]:
- CA combina com: equipes com poucos recursos de engenharia, preferência por configuração simples e cargas homogêneas
- Karpenter combina com: equipes de plataforma, cargas variadas, sensibilidade a custo e disposição para investir tempo de aprendizado
Se você mantém um cluster pequeno sozinho, com 10 a 20 nós, a simplicidade do CA talvez seja mais adequada.
Se você opera um cluster médio ou grande, com mais de 50 nós, ou cargas variadas, como batch + serviços web + tarefas com GPU, o custo de manutenção do Karpenter tende a ser menor no longo prazo.
5. Roteiro de migração: do CA para o Karpenter
O ciclo de migração leva de 2 a 4 semanas; o principal risco é executar os dois sistemas em paralelo.
Esse dado vem do relatório da Reintech [1]. O caso da Salesforce é ainda mais convincente: eles concluíram a migração em mais de 1000 clusters EKS [3].
A Salesforce usou o Karpenter transition tool, a ferramenta oficial de transição, junto com uma estratégia de execução em paralelo. Vou detalhar isso adiante.
Semana 1: preparação
Objetivo: instalar o Karpenter, criar um NodePool e configurar permissões IAM.
Checklist de tarefas:
- Instalar o Karpenter, via helm ou eksctl
- Criar um NodePool, começando com algo simples e misturando Spot/On-demand
- Configurar permissões IAM, já que o Karpenter precisa de permissões do EC2
- Validar que o Karpenter consegue provisionar nós normalmente
Pontos de atenção:
- As permissões IAM precisam estar completas. O Karpenter precisa de
ec2:RunInstances,ec2:TerminateInstances,ec2:DescribeInstancese outras permissões. - Os
limitsdo NodePool precisam ser razoáveis para evitar expansão excessiva. Por exemplo, definacpu: 100para impedir provisionamento sem limite. - Não pare o CA. Ele continua rodando; o Karpenter entra como opção em teste.
Semana 2: testes
Objetivo: migrar cargas não críticas para o Karpenter e comparar desempenho com monitoramento.
Checklist de tarefas:
- Escolher cargas de teste, como jobs de batch ou serviços de baixa prioridade
- Usar
nodeSelectorouaffinitypara direcionar essas cargas aos nós provisionados pelo Karpenter - Observar velocidade de expansão, tratamento de interrupções Spot e efeito da Consolidation
- Comparar latência e custo entre CA e Karpenter
Pontos de atenção:
- Não migre muitas cargas no teste; mantenha entre 10% e 20% dos recursos do cluster.
- Métricas importantes: tempo de Pod em Pending, tempo de inicialização do nó, número de interrupções Spot e utilização dos nós.
- Se o Karpenter não performar bem, ajuste os
requirementsdo NodePool ou aconsolidationPolicy.
Semana 3: execução híbrida
Objetivo: migrar cargas de produção gradualmente, com CA e Karpenter rodando em paralelo.
Checklist de tarefas:
- Migrar de 10% a 15% das cargas de produção por dia
- Usar
nodeSelectorpara controlar a distribuição dos Pods, deixando parte nos nós do CA e parte nos nós do Karpenter - Monitorar frequência de escalabilidade, custo e estabilidade dos dois sistemas
- Fazer rollback rapidamente se houver problema, apontando os Pods de volta para nós do CA
Pontos de atenção:
- Durante a execução em paralelo, os dois sistemas podem interferir um no outro. Por exemplo, a Consolidation do Karpenter pode remover por engano nós escalados pelo CA. Separar a distribuição dos Pods com
nodeSelectoré essencial. - Configure alertas: se um Pod ficar Pending por mais de 3 minutos, dispare um alerta, como recomenda a AWS [7].
- Se o custo subir em vez de cair, verifique a proporção de Spot no NodePool e a configuração de Consolidation.
Semana 4: troca completa
Objetivo: desativar o CA, limpar os grupos de nós e deixar o Karpenter assumir todas as cargas.
Checklist de tarefas:
- Desativar o CA, reduzindo as replicas do Deployment para 0
- Limpar os grupos de nós do CA, ou ASGs
- Remover o
nodeSelectorde todos os Pods para deixar o Karpenter agendar automaticamente - Monitorar o Karpenter em carga total e ajustar o NodePool
Pontos de atenção:
- Antes de desativar o CA, confirme que o Karpenter já assumiu todas as cargas.
- Tenha cuidado ao limpar grupos de nós: antes de excluir um ASG, confirme que ele não tem nós em execução.
- Depois da troca completa, observe por alguns dias para garantir que não há comportamento anormal.
A experiência de migração da Salesforce
O caso da Salesforce está registrado em detalhes no AWS Architecture Blog [3].
O fluxo de migração deles foi:
- Usar o Karpenter transition tool para detectar automaticamente a configuração dos grupos de nós do CA e gerar um NodePool equivalente
- Rodar CA e Karpenter em paralelo e migrar cargas gradualmente
- Monitorar latência de escalabilidade e mudança de custos em cada cluster
- Depois de desativar o CA, limpar os grupos de nós
O ponto-chave: o transition tool simplificou a migração da configuração. A configuração dos grupos de nós do CA foi convertida automaticamente em NodePools do Karpenter, evitando boa parte do trabalho manual.
"Concluímos a migração do Cluster Autoscaler para o Karpenter em mais de 1000 clusters EKS, usando o Karpenter transition tool para simplificar o processo de conversão de configuração."
Checklist de redução de risco
- Execução em paralelo: não desative o CA diretamente; rode os dois por um período
- Controle com nodeSelector: use labels para separar a distribuição dos Pods e evitar interferência entre sistemas
- Definição de limits: configure CPU/Memory limits no NodePool para evitar expansão excessiva
- Monitoramento e alertas: dispare alerta quando Pod Pending > 3 minutos [7]
- Plano de rollback: mantenha os arquivos de configuração do CA para poder voltar rapidamente
6. Framework de decisão: como escolher em 2026?
Não existe certo ou errado absoluto; depende das suas prioridades.
A Reintech oferece uma tabela de decisão [1], e eu complementei com informações oficiais da AWS.
Matriz de decisão em cinco dimensões
| Dimensão de prioridade | Quando escolher CA | Quando escolher Karpenter |
|---|---|---|
| Velocidade de expansão | Atraso de 5 minutos é aceitável | Precisa escalar em menos de 1 minuto |
| Economia de custo | Grupos de nós já foram ajustados manualmente | Precisa de gestão automática de custos |
| Complexidade de configuração | Prefere começar com algo simples | Tem equipe de plataforma |
| Ambiente de nuvem | Multicloud ou fora da AWS | Ambiente principalmente AWS |
| Tipo de carga | Cargas homogêneas | Cargas variadas e dinâmicas |
Recomendações por cenário típico
Cenário 1: equipe pequena, carga simples
- Tamanho do cluster: 10 a 20 nós
- Carga: principalmente serviços web, tráfego estável
- Prioridade: configuração simples e início rápido
Recomendação: CA.
Motivo: o CA fica pronto em algumas horas, e o custo de manutenção não pesa tanto em clusters pequenos. A curva de aprendizado do Karpenter pode não compensar para equipes pequenas.
Cenário 2: equipe média ou grande, sensível a custo
- Tamanho do cluster: 50+ nós
- Carga: mista, com web + batch + tarefas em Spot
- Prioridade: controle de custo e gestão automatizada
Recomendação: Karpenter.
Motivo: a economia de 20% a 40% é significativa em clusters médios e grandes [2]. Consolidation e automação de Spot também reduzem esforço operacional.
Cenário 3: ambiente multicloud

- Distribuição do cluster: AWS + GCP + Azure
- Prioridade: solução única de escalabilidade
Recomendação: CA.
Motivo: o suporte multicloud do CA é maduro, e GCP/Azure também têm mecanismos de grupos de nós. O Karpenter hoje é principalmente AWS, por desenho nativo.
Tendência futura: EKS Auto Mode
Em 2026, a AWS lançou o EKS Auto Mode, uma solução nativa baseada no Karpenter [4].
Em termos simples: a AWS integrou a lógica do Karpenter ao EKS Auto Mode. Você não precisa instalar o Karpenter separadamente; o EKS faz a escalabilidade dos nós automaticamente.
Essa tendência mostra a direção da AWS: a arquitetura do Karpenter é o caminho futuro reconhecido pela própria plataforma.
Se você está criando um cluster novo, vale considerar o EKS Auto Mode diretamente e evitar a etapa de instalação e configuração do Karpenter.
Comparação de suporte multicloud
CA: cobre AWS, GCP e Azure.
- AWS: Auto Scaling Groups
- GCP: Managed Instance Groups
- Azure: Virtual Machine Scale Sets
O mecanismo de grupos de nós do CA se encaixa naturalmente em multicloud.
Karpenter: principalmente AWS, com progresso lento em outras nuvens.
Hoje, o Karpenter oficial oferece suporte apenas à AWS. A comunidade tem PRs para Azure, com suporte parcial, e o suporte a GCP ainda está no começo.
Se você precisa de multicloud, o CA ainda é a única escolha madura. No longo prazo, o suporte multicloud do Karpenter deve melhorar.
Minha recomendação
Se o seu cluster roda na AWS e atende às condições abaixo:
- Tamanho do cluster > 30 nós
- Cargas variadas
- Custo é um critério importante
- Existe uma equipe de plataforma
Vá direto de Karpenter, ou use EKS Auto Mode.
Se o cluster é pequeno, com < 20 nós, ou se o ambiente é multicloud, o CA ainda é uma escolha segura.
No AWS EKS em 2026, o Karpenter já é a opção recomendada. Mas o CA ainda tem valor em cenários específicos, como multicloud e clusters pequenos.
Conclusão
Depois de tudo isso, a conclusão cabe em três frases:
O Karpenter vence em velocidade, custo e flexibilidade. O CA ainda tem valor em simplicidade e suporte multicloud.
No AWS EKS em 2026, o Karpenter é a opção recomendada. Mas a migração precisa de 2 a 4 semanas de planejamento e testes; não é algo para trocar com pressa.
Se você tem um cluster AWS nativo, cargas variadas e sensibilidade a custo, comece testando seu primeiro NodePool do Karpenter. Siga o guia oficial de migração [9], rode em paralelo por duas semanas e faça a troca gradualmente.
Se o seu cluster está em um ambiente multicloud, ou é pequeno e tem carga estável, o CA ainda dá conta. Não há motivo para migrar à força.
Próximos passos:
- Ler a documentação oficial de migração do Karpenter [9]
- Criar um NodePool de teste e rodar uma tarefa de batch
- Monitorar tempo de Pod em Pending e mudança de custos, comparando com o CA
Vou continuar escrevendo artigos práticos sobre gestão de clusters EKS. Assine o blog para não perder as próximas atualizações.
Referências
[1] Reintech - Karpenter vs Cluster Autoscaler: Which Should You Use in 2026
https://reintech.io/blog/karpenter-vs-cluster-autoscaler-comparison-2026
[2] Reintech - Relatos reais de usuários sobre economia de custo, de 20% a 40%
[3] AWS Architecture Blog - How Salesforce migrated from Cluster Autoscaler to Karpenter
https://aws.amazon.com/blogs/architecture/how-salesforce-migrated-from-cluster-autoscaler-to-karpenter-across-their-fleet-of-1000-eks-clusters/
[4] AWS EKS Official Docs - Scale cluster compute with Karpenter and Cluster Autoscaler
https://docs.aws.amazon.com/eks/latest/userguide/autoscaling.html
[5] CHKK - Karpenter vs. Cluster Autoscaler
https://www.chkk.io/blog/karpenter-vs-cluster-autoscaler
[6] Reddit r/kubernetes - Feedback de usuário em teste prático, com atraso até o nó ficar pronto
https://www.reddit.com/r/kubernetes/comments/zsmqrk/karpenter_vs_cluster_autoscaler_findings/
[7] AWS Blog - Using Amazon EC2 Spot Instances with Karpenter
https://aws.amazon.com/blogs/containers/using-amazon-ec2-spot-instances-with-karpenter/
[8] ScaleOps - Karpenter vs Cluster Autoscaler: Definitive Guide for 2025
https://scaleops.com/blog/karpenter-vs-cluster-autoscaler/
[9] Karpenter Official Docs - Migrating from Cluster Autoscaler
https://karpenter.sh/docs/getting-started/migrating-from-cas/
FAQ
Qual é a principal diferença entre Karpenter e Cluster Autoscaler?
Quanto custo o Karpenter consegue economizar?
Quanto tempo leva para migrar do Cluster Autoscaler para o Karpenter?
O Karpenter oferece suporte a ambientes multicloud?
Clusters pequenos, com 10 a 20 nós, combinam com Karpenter?
Como funciona o tratamento de interrupções Spot no Karpenter?
Como evitar que CA e Karpenter interfiram um no outro durante a migração?
21 min de leitura · Publicado em: 4 mai 2026 · Atualizado em: 14 jul 2026


Comentários
Entre com GitHub para comentar