
Karpenter vs Cluster Autoscaler: AWS EKS 노드 오토스케일링 비교
들어가며
새벽 세 시. Grafana의 빨간 알림을 바라보고 있습니다. Pods는 이미 4분째 Pending 상태입니다. 트래픽 피크가 왔지만 노드는 아직도 “시작 중”입니다.
옆 클러스터의 관리자는 이미 잠들었습니다. 그의 오토스케일링 시스템은 55초 만에 노드 준비를 끝냈습니다.
과장이 아닙니다. 이것이 Karpenter와 Cluster Autoscaler의 실제 차이입니다.
솔직히 말해, 저도 이 비교 데이터를 처음 봤을 때는 꽤 의심했습니다. 1분과 3분의 차이가 정말 그렇게 클까? 하지만 EKS에서 두 시스템을 직접 돌려보고 나서야 알았습니다. 이 차이는 전체 확장 전략을 다시 생각하게 만들 만큼 큽니다.
Reintech의 2026년 보고서에 따르면 Karpenter의 확장 속도는 60초 이내인 반면, Cluster Autoscaler(이하 CA)는 3-5분이 필요합니다 [1]. 비용 측면에서는 실제 사용자들이 20-40% 절감을 보고했습니다 [2]. Salesforce는 1000개 규모의 클러스터에서 마이그레이션까지 완료했습니다 [3].
이 글에서는 두 도구가 정확히 어디서 다른지, 무엇을 선택해야 하는지, 어떻게 마이그레이션해야 하는지 정리합니다. 실제 데이터, 완전한 설정 예시, 마이그레이션 타임라인으로 답해 보겠습니다.
1. 아키텍처 비교: 왜 속도 차이가 이렇게 클까?
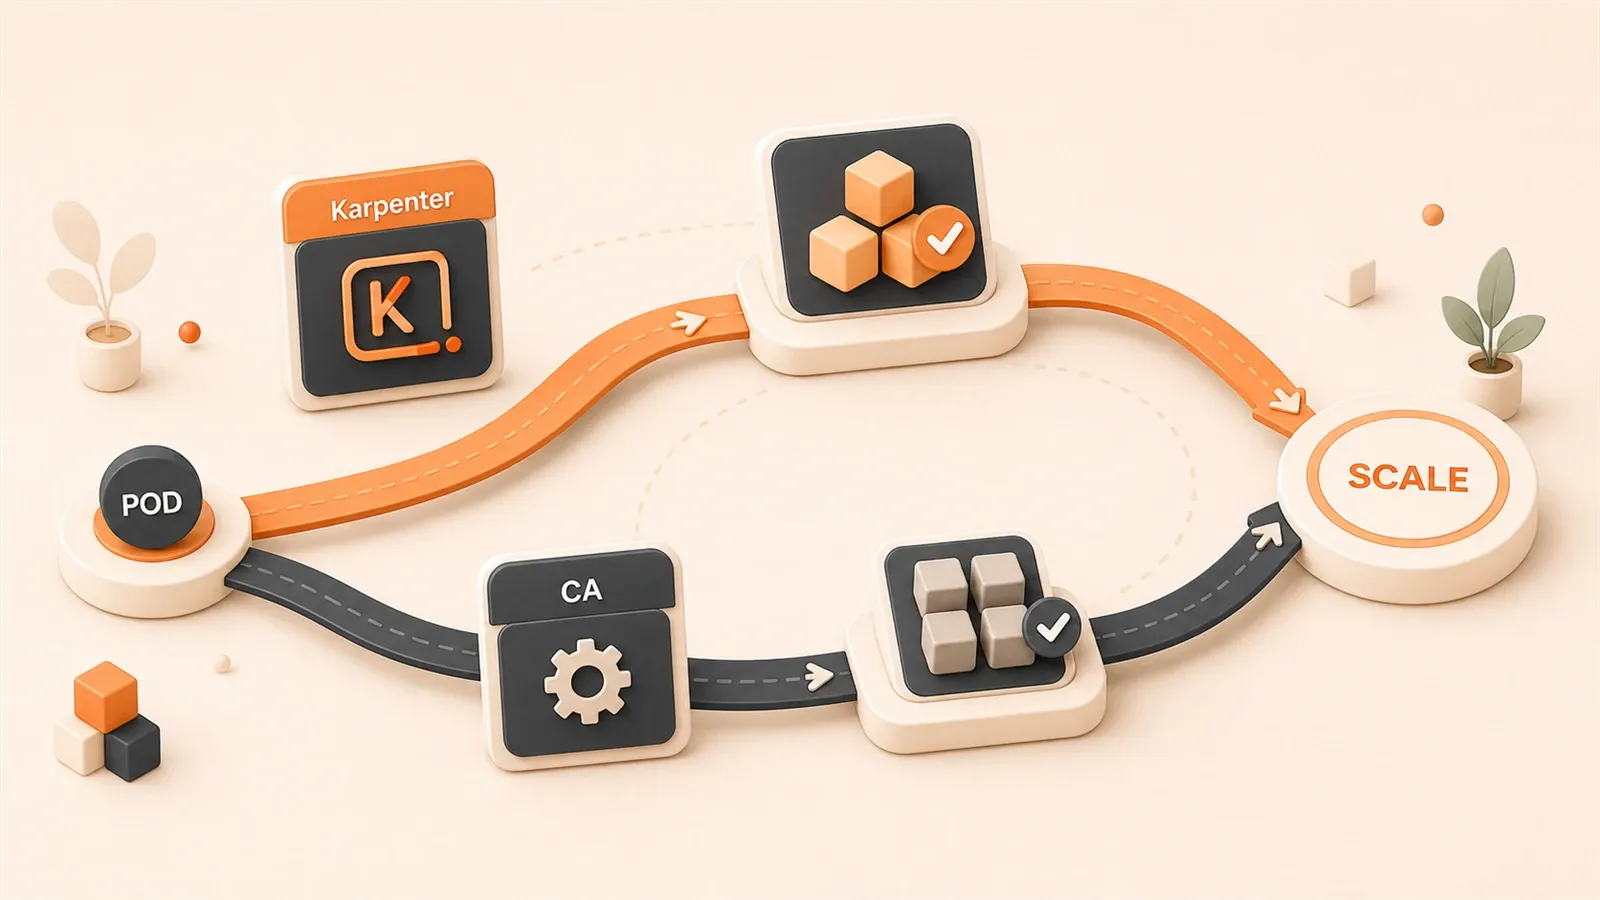
핵심 차이: CA는 노드 그룹에 의존하고, Karpenter는 노드를 직접 구성합니다.
이 말은 단순하게 들리지만, 그 뒤의 아키텍처 차이는 전체 오토스케일링 흐름에 영향을 줄 만큼 큽니다.
Cluster Autoscaler의 ‘우회’ 흐름
CA의 작동 방식은 우회로를 도는 것과 비슷합니다.
Pod 스케줄링이 실패하면 CA는 먼저 미리 정의된 노드 그룹(Node Group)을 확인합니다. 각 노드 그룹은 고정된 인스턴스 타입에 묶여 있습니다. 예를 들어 node-group-1은 m5.large, node-group-2는 c5.xlarge로 구성되어 있을 수 있습니다.
CA는 먼저 어떤 노드 그룹이 적합한지 판단해야 합니다. 그룹을 고른 뒤 클라우드 API(AWS Auto Scaling Groups API)를 호출해 확장을 요청합니다. 그다음 ASG가 인스턴스를 시작하고, 인스턴스가 클러스터에 합류하고, 노드가 Ready 상태가 되기를 기다린 뒤에야 Pod를 스케줄링할 수 있습니다.
이 전체 과정은 4-5단계입니다. 각 단계마다 지연이 있습니다.
특히 “노드 그룹 확인 → 노드 그룹 선택” 단계가 문제입니다. Pod에 GPU가 필요한데 노드 그룹에 GPU 타입이 없다면 CA는 할 수 있는 일이 없습니다. 기존 노드 그룹 중에서만 고를 수 있기 때문입니다.
Karpenter의 ‘직구’ 방식
Karpenter는 완전히 다릅니다.
Pod 스케줄링이 실패했나요? 괜찮습니다. Karpenter는 Pod의 요구사항을 직접 봅니다. CPU가 얼마나 필요한지, 메모리는 얼마나 필요한지, GPU가 필요한지, 특별한 toleration이나 nodeSelector가 있는지 확인합니다.
요구사항 분석이 끝나면 Karpenter는 EC2 API를 직접 호출해 가장 적합한 인스턴스를 Provisioning합니다. 노드 그룹도, ASG도 필요 없습니다. Pod 요구사항에 바로 맞춥니다.
그다음 노드가 시작되고, 클러스터에 합류하고, Pod가 스케줄링됩니다. 핵심 단계는 2개뿐이라 중간의 우회 절차가 사라집니다.
AWS 공식 문서는 Karpenter가 1분 안에 컴퓨팅 리소스를 시작할 수 있다고 꽤 직접적으로 설명합니다 [4].
비유로 이해하기
CA를 식당 주문 과정에 비유해 봅시다. 손님이 매운 닭요리를 먹고 싶다고 하면, 직원은 먼저 메뉴에 있는지 확인하고(노드 그룹 확인), 있으면 주문을 넣고(ASG 호출), 주방이 재료를 준비하고(인스턴스 시작), 마지막에 음식을 냅니다(Pod 스케줄링).
Karpenter는 셀프 주방에 가깝습니다. 손님이 매운 닭요리를 원하면, 요리사가 손님 요구사항(Pod specs)을 바로 보고 창고에서 재료를 꺼내(EC2 API 호출) 즉석에서 만들어 냅니다.
어느 쪽이 더 빠를까요? 한눈에 보입니다.
왜 CA는 노드 그룹에 의존할까?
CA는 처음부터 멀티 클라우드 지원을 염두에 두고 설계되었습니다. 노드 그룹 메커니즘 덕분에 AWS, GCP, Azure에서 같은 로직을 사용할 수 있습니다. 단지 각 클라우드에서 노드 그룹을 부르는 이름이 다를 뿐입니다. AWS는 ASG, GCP는 MIG, Azure는 VMSS입니다.
하지만 이 설계는 한계도 만듭니다. 노드 그룹을 미리 정의해야 합니다. 새 인스턴스 타입을 쓰고 싶다면 먼저 노드 그룹을 만들어야 합니다. Spot 인스턴스를 추가하고 싶어도 먼저 Spot 노드 그룹을 만들어야 합니다. 유지보수 비용은 올라가고 유연성은 내려갑니다.
Karpenter는 AWS 네이티브 설계입니다. 노드 그룹이라는 중간 계층이 필요 없고 EC2 API와 직접 상호작용합니다. 단점은 멀티 클라우드 지원이 약하다는 점(현재는 주로 AWS)이고, 장점은 빠른 속도와 단순한 설정입니다.
2. 성능 벤치마크: 실제 환경에서의 모습
Karpenter는 확장이 빠르고, 축소도 느리지 않습니다.
이 장의 데이터는 주로 두 출처에서 가져왔습니다. CHKK의 기술 테스트와 실제 사용자 피드백입니다.
확장 속도: 실측 비교
CHKK의 테스트 데이터는 꽤 직관적입니다 [5].
- Karpenter: CPU 집약형 Pod가 올라오는 데 약 55초
- Cluster Autoscaler: 같은 워크로드에서 3-4분
이 차이는 AWS 공식 설명인 “1분 이내”와도 대체로 일치합니다 [4].
Reddit에는 직접 테스트한 사용자의 피드백도 있습니다. 실제 차이가 그렇게 극적이지는 않았고, 노드 준비 지연은 비슷했다는 내용입니다. 아마 그의 클러스터 규모가 작았기 때문일 수 있습니다(약 10개 노드) [6]. 다만 이 데이터는 단일 사용자 피드백이라 표본이 제한적입니다. 결론이 아니라 참고로 보는 것이 좋습니다.

축소 효율: 누가 더 돈을 아낄까?
확장이 빠른 것은 표면적인 장점입니다. 비용 절감의 핵심은 축소 효율입니다.
CA의 축소 로직은 주기적 점검입니다. 일정 간격(기본 10초)으로 클러스터를 스캔해 오래 유휴 상태인 노드가 있는지 확인합니다. 임계값(기본 10분)을 넘으면 축소를 트리거합니다.
Karpenter는 다릅니다. Consolidation 기능을 사용합니다. 노드 사용률을 실시간으로 모니터링하다가 병합할 수 있으면 병합하고, 교체할 수 있으면 교체합니다.
예를 들어 클러스터에 m5.xlarge 노드 3개가 있고 사용률이 각각 30%, 25%, 20%라고 해봅시다. Karpenter는 판단합니다. 이 Pod들을 m5.large 1개에 넣을 수 있을까? 가능하다면 큰 노드 3개를 삭제하고 작은 노드 1개로 바꿉니다.
이 로직의 효과에 대해 AWS 공식 블로그는 데이터를 제시했습니다. Spot 인스턴스를 Consolidation과 결합하면 On-demand 대비 최대 90% 비용을 절감할 수 있습니다 [7].
대규모 클러스터에서의 차이
CA는 대규모 클러스터(100개 이상 노드)에서 성능 병목이 있습니다.
ScaleOps 블로그는 노드 그룹이 많을수록 CA의 스케줄링 결정이 느려진다고 설명합니다 [8]. CA가 모든 노드 그룹을 순회해 가장 적합한 그룹을 찾아야 하기 때문입니다. 노드 그룹이 많아지면 순회 시간이 늘고 지연도 커집니다.
Karpenter는 이 제한을 받지 않습니다. 노드 그룹에 의존하지 않고 Pod 요구사항을 직접 분석해 최적의 인스턴스 타입을 찾습니다. 클러스터가 커져도 로직은 같습니다.
실전 사례: 배치 처리 시나리오
제가 본 실제 사례를 하나 들겠습니다.
어떤 데이터 파이프라인은 매시간 한 번씩 배치 작업을 트리거했고, 50개의 worker Pods가 필요했습니다. CA 환경에서는 Pods가 Pending 상태로 3분을 기다렸고, 배치 작업 시작이 지연되면서 전체 데이터 파이프라인 주기가 길어졌습니다.
Karpenter로 이전한 뒤에는 Pods가 50초 안에 모두 Running이 되었습니다. 배치 처리는 제시간에 시작했고, 하류 데이터 처리 주기도 정상으로 돌아왔습니다.
이 시나리오의 핵심은 배치 처리가 시작 지연에 민감하다는 점입니다. 3분의 대기는 전체 데이터 흐름을 지연시킬 수 있습니다. 1분 이내 확장은 이런 워크로드에는 필수에 가깝습니다.
3. 비용 절감: 20-40%의 비밀
Karpenter의 비용 우위는 세 가지 메커니즘에서 나옵니다. Spot 인스턴스, Consolidation, 인스턴스 선택 전략입니다.
각각만 보면 아주 새로운 것은 아닙니다. 하지만 조합하면 20-40% 비용 절감이라는 결과가 나옵니다. 이는 Reintech 보고서의 실제 사용자 데이터입니다 [2].
Spot 인스턴스: 최대 90% 절감
AWS Spot 인스턴스는 On-demand 대비 최대 90% 저렴할 수 있습니다 [7]. 이 수치는 AWS 공식 데이터라 신뢰도가 높습니다.
하지만 Spot에는 리스크가 있습니다. 언제든 중단될 수 있습니다. AWS는 2분 전에 알림을 보낸 뒤 인스턴스를 회수합니다 [7].
CA로 Spot 인스턴스를 사용하려면 Spot 노드 그룹을 직접 만들고 중단 처리 로직도 구성해야 합니다. 절차가 번거롭고 실수하기 쉽습니다.
Karpenter는 Spot 중단을 자동 처리합니다. 중단 알림을 받으면 2분 안에 cordon(노드를 스케줄 불가 상태로 표시)과 drain(Pod를 다른 노드로 이전)을 완료합니다. 추가 스크립트가 필요 없고, Karpenter에 이 로직이 내장되어 있습니다.
PCO 전략: 똑똑하게 Spot 선택하기
Karpenter는 Price Capacity Optimized(PCO) 전략을 사용합니다 [7].
간단히 말하면, 먼저 중단 확률이 가장 낮은 Spot 풀을 고르고, 그 풀 안에서 가장 저렴한 인스턴스를 선택합니다.
이 전략이 영리한 이유는 비용 절감과 안정성이라는 두 목표의 균형을 잡기 때문입니다. 가장 싼 풀은 중단되기 쉽고, 가장 안정적인 풀은 충분히 저렴하지 않을 수 있습니다. PCO는 그 중간 지점을 찾습니다.
AWS 공식 블로그는 다음과 같이 설명합니다 [7].
- Karpenter가 Spot 풀의 중단률을 모니터링합니다(AWS 공식 데이터).
- 중단률이 높은 풀을 걸러냅니다.
- 남은 풀 중 가격이 가장 낮은 인스턴스 타입을 선택합니다.
이 로직은 별도 설정이 필요 없고, Karpenter에서 기본으로 활성화됩니다.
Consolidation: 실시간 비용 절감
Consolidation 기능은 2장에서 언급했습니다. 여기서는 설정을 조금 더 보겠습니다.
Karpenter는 두 가지 Consolidation 전략을 지원합니다 [7].
WhenEmpty: 노드가 완전히 비었을 때 삭제WhenUnderutilized: 노드 사용률이 낮을 때 병합 또는 교체 시도
기본값은 WhenUnderutilized이며 더 공격적입니다.
예시는 다음과 같습니다.
# Karpenter NodePool - Consolidation 설정
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  disruption:
    consolidationPolicy: WhenUnderutilized  # 공격적 병합
    consolidateAfter: 1m                     # 유휴 1분 후 트리거
CA에는 이 기능이 없습니다. 오래 비어 있던 노드를 주기적으로 삭제할 수는 있지만, “작은 노드들을 큰 노드로 병합”하거나 “비싼 인스턴스를 저렴한 인스턴스로 교체”하는 일은 할 수 없습니다.
ROI 계산: 실제 수익
클러스터 월 비용이 $50,000이라고 가정해 봅시다(100개 노드, 혼합 인스턴스 타입).
Karpenter로 이전한 뒤 보수적으로 20%를 절감하면 월 $10,000입니다.
공격적으로 추정해 Spot과 Consolidation을 충분히 활용해 40%를 절감하면 월 $20,000입니다.
1년이면 $120,000에서 $240,000를 아낍니다.
이 계산은 허구가 아니라 Reintech의 실제 사용자 데이터 [2]를 바탕으로 한 것입니다. 물론 실제 수익은 워크로드 유형, Spot 사용 비율, Consolidation 설정에 따라 달라집니다.
설정 비교: 어느 쪽이 더 편할까?
CA의 Spot 설정 흐름은 다음과 같습니다.
- Spot ASG 생성(인스턴스 타입 수동 선택)
- ASG의 Spot allocation strategy 설정
- 중단 처리 스크립트 작성(중단 알림 모니터링, 수동 drain)
- CA의
--node-group-auto-discovery파라미터 설정
Karpenter의 Spot 설정은 다음과 같습니다.
# NodePool 하나로 완료
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
      - key: karpenter.sh/capacity-type
        operator: In
        values: ["spot", "on-demand"]  # Spot 또는 On-demand 자동 선택
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values: ["c", "m", "r"]  # c/m/r 계열, 충분히 다양화
  disruption:
    consolidationPolicy: WhenUnderutilized
YAML 하나로 Spot 선택, 인스턴스 타입 다양화, Consolidation을 모두 다룹니다. Karpenter가 중단을 자동 처리하고, 최적의 인스턴스를 자동 선택하며, 노드도 자동 병합합니다.
운영 편의성 차이는 분명합니다.
4. 설정 복잡도: 투입 대비 효과 분석
CA는 설정이 빠르고, Karpenter는 배우는 데 시간이 걸립니다. 하지만 장기 유지보수 비용은 역전됩니다.
이 장의 데이터는 Reintech 보고서 [1]에서 가져왔습니다. CA 설정 시간은 “몇 시간”, Karpenter 설정 시간은 “1-2일”입니다.
처음 이 데이터를 봤을 때는 과장이라고 느꼈습니다. 하지만 직접 한 번 해보니 Reintech의 설명이 꽤 맞았습니다.
CA: 시작은 빠르고, 유지보수는 피곤하다
CA 설정 흐름은 다음과 같습니다.
# CA Deployment(간소화 버전)
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cluster-autoscaler
  namespace: kube-system
spec:
  containers:
  - name: cluster-autoscaler
    image: k8s.gcr.io/autoscaling/cluster-autoscaler:v1.30.0
    command:
    - ./cluster-autoscaler
    - --node-group-auto-discovery=asg:tag=k8s.io/cluster-autoscaler/enabled
    - --scale-down-unneeded-time=10m
    - --scale-down-delay-after-add=10m
핵심 파라미터는 몇 개뿐입니다. 노드 그룹 자동 발견, 축소 임계값, 지연 시간입니다. Deployment를 설정하고 노드 그룹(ASG)을 만들면 CA는 동작합니다.
몇 시간이면 된다는 말은 과장이 아닙니다.

하지만 유지보수 비용은 뒤에서 옵니다.
새 인스턴스 타입을 추가하고 싶을 때마다 새 노드 그룹을 만들어야 합니다. Spot 인스턴스를 추가하려면 Spot 노드 그룹도 만들어야 합니다. 노드 그룹이 많아지면 관리가 번거로워집니다. 각 ASG에는 고유한 min/max 노드 수, 인스턴스 타입, 라벨 설정이 있습니다.
시간이 지나면 노드 그룹 설정 파일이 YAML 더미처럼 쌓입니다. 파라미터 하나를 바꾸는 일이 여러 노드 그룹에 영향을 줄 수 있습니다.
Karpenter: 시작은 느리지만, 유지보수는 편하다
Karpenter의 설정이 복잡한 이유는 개념 이해가 필요하기 때문입니다.
NodePool, Disruption, Consolidation, requirements 같은 개념을 이해해야 합니다. 저도 처음 접했을 때 각 파라미터의 의미를 이해하는 데 하루가 걸렸습니다.
# Karpenter NodePool(전체 버전)
apiVersion: karpenter.sh/v1beta1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
      - key: karpenter.k8s.aws/instance-category
        operator: In
        values: ["c", "m", "r"]
      - key: karpenter.sh/capacity-type
        operator: In
        values: ["spot", "on-demand"]
      - key: karpenter.k8s.aws/instance-generation
        operator: Gt
        values: ["5"]  # 5세대 이상 인스턴스
      nodeClassRef:
        name: default
  disruption:
    consolidationPolicy: WhenUnderutilized
    consolidateAfter: 1m
  limits:
    cpu: 1000
    memory: 1000Gi
이 YAML은 CA의 Deployment보다 파라미터가 많습니다. 하지만 이해하고 나면 NodePool 하나로 여러 인스턴스 타입, Spot/On-demand 혼합, 자동 Consolidation을 모두 다룰 수 있다는 점이 보입니다.
유지보수 비용은 거의 0에 가깝습니다.
새 인스턴스 타입을 추가하고 싶나요? requirements의 values에 인스턴스 계열을 추가하면 됩니다. Consolidation 전략을 조정하고 싶나요? consolidationPolicy를 바꾸면 됩니다.
YAML 하나로 관리하므로 노드 그룹 여러 개를 유지할 필요가 없습니다.
두 설정 방식의 트레이드오프
Reintech의 제안은 꽤 현실적입니다 [1].
- CA가 적합한 경우: 팀의 엔지니어링 리소스가 제한적이고, 단순 설정을 선호하며, 워크로드 유형이 동질적일 때
- Karpenter가 적합한 경우: 플랫폼 엔지니어링 팀이 있고, 워크로드 유형이 다양하며, 비용에 민감하고, 학습 시간을 투자할 의지가 있을 때
개인이 유지하는 작은 클러스터(10-20개 노드)라면 CA의 단순한 설정이 더 적합할 수 있습니다.
팀이 운영하는 중대형 클러스터(50개 이상 노드)이거나 워크로드 유형이 자주 바뀐다면(배치 처리 + Web 서비스 + GPU 작업), Karpenter의 장기 유지보수 비용이 더 낮습니다.
5. 마이그레이션 로드맵: CA에서 Karpenter로
마이그레이션 기간은 2-4주이며, 핵심 리스크는 두 시스템의 병행 운영입니다.
이 데이터는 Reintech 보고서 [1]에서 가져왔습니다. Salesforce 사례는 더 설득력 있습니다. 그들은 1000개 이상의 EKS 클러스터에서 마이그레이션을 완료했습니다 [3].
Salesforce는 Karpenter transition tool(공식 마이그레이션 도구)과 병행 운영 전략을 사용했습니다. 구체적인 내용은 아래에서 설명하겠습니다.
1주 차: 준비 단계
목표: Karpenter를 설치하고, NodePool을 만들고, IAM 권한을 설정합니다.
작업 목록:
- Karpenter 설치(helm 또는 eksctl)
- NodePool 생성(먼저 Spot/On-demand 혼합의 단순한 NodePool 생성)
- IAM 권한 설정(Karpenter에는 EC2 권한 필요)
- Karpenter가 정상적으로 노드를 Provisioning할 수 있는지 검증
핵심 주의점:
- IAM 권한은 완전해야 합니다. Karpenter에는
ec2:RunInstances,ec2:TerminateInstances,ec2:DescribeInstances등의 권한이 필요합니다. - NodePool의
limits를 합리적으로 설정해야 합니다. 예를 들어cpu: 100을 설정해 Karpenter가 무제한 Provisioning하지 못하게 합니다. - CA를 멈추지 마세요. 계속 실행하고, Karpenter는 예비로 둡니다.
2주 차: 테스트 단계
목표: 비핵심 워크로드를 Karpenter로 옮기고 성능을 비교 모니터링합니다.
작업 목록:
- 테스트 워크로드 선택(배치 작업, 낮은 우선순위 서비스)
nodeSelector또는affinity로 테스트 워크로드를 Karpenter가 Provisioning한 노드로 보냅니다.- 확장 속도, Spot 중단 처리, Consolidation 효과를 관찰합니다.
- CA와 Karpenter의 지연, 비용을 비교합니다.
핵심 주의점:
- 테스트 워크로드는 너무 많지 않게 유지하고, 클러스터 리소스의 10-20%로 제한합니다.
- 모니터링 지표는 Pod Pending 시간, 노드 시작 시간, Spot 중단 횟수, 노드 사용률을 중점적으로 봅니다.
- Karpenter 성능이 좋지 않다면 NodePool의
requirements또는consolidationPolicy를 즉시 조정합니다.
3주 차: 혼합 운영
목표: 프로덕션 워크로드를 점진적으로 이전하고, CA와 Karpenter를 병행 운영합니다.
작업 목록:
- 매일 프로덕션 워크로드의 10-15%를 이전합니다.
nodeSelector로 Pod 분포를 제어합니다. 일부는 CA 노드로, 일부는 Karpenter 노드로 보냅니다.- 두 시스템의 확장/축소 빈도, 비용, 안정성을 모니터링합니다.
- 문제가 생기면 즉시 롤백합니다(Pod를 다시 CA 노드로 보냄).
핵심 주의점:
- 병행 운영 중에는 두 시스템이 서로 간섭할 수 있습니다. 예를 들어 CA가 확장한 노드를 Karpenter의 Consolidation이 잘못 삭제할 수 있습니다.
nodeSelector로 Pod 분포를 분리하는 것이 핵심입니다. - 알림을 설정하세요. Pod Pending이 3분을 넘으면 알림을 발생시킵니다(AWS 공식 권장 [7]).
- 비용이 오히려 증가한다면 NodePool의 Spot 사용 비율과 Consolidation 설정을 확인합니다.
4주 차: 완전 전환
목표: CA를 비활성화하고 노드 그룹을 정리한 뒤, Karpenter가 모든 워크로드를 맡게 합니다.
작업 목록:
- CA 비활성화(Deployment의 replicas를 0으로 축소)
- CA 노드 그룹(ASG) 정리
- 모든 Pod의
nodeSelector를 제거해 Karpenter가 자동으로 스케줄링하게 합니다. - 전체 Karpenter 운영 상태를 모니터링하고 NodePool 설정을 조정합니다.
핵심 주의점:
- CA를 비활성화하기 전에 Karpenter가 모든 워크로드를 이미 맡고 있는지 확인합니다.
- 노드 그룹 정리는 조심해야 합니다. ASG를 삭제하기 전에 그 안에 실행 중인 노드가 없는지 확인하세요.
- 전체 전환 뒤에는 며칠 동안 관찰해 이상이 없는지 확인합니다.
Salesforce의 마이그레이션 경험
Salesforce의 마이그레이션 사례는 AWS Architecture Blog에 자세히 기록되어 있습니다 [3].
그들의 마이그레이션 흐름은 다음과 같습니다.
- Karpenter transition tool로 CA 노드 그룹 설정을 자동 감지하고 동등한 NodePool을 생성
- CA와 Karpenter를 병행 운영하며 워크로드를 점진적으로 이전
- 각 클러스터의 확장/축소 지연과 비용 변화를 모니터링
- CA 비활성화 후 노드 그룹 정리
핵심은 transition tool이 설정 마이그레이션을 단순화했다는 점입니다. CA의 노드 그룹 설정이 Karpenter의 NodePool로 자동 변환되어 수동 설정 시간을 줄였습니다.
"우리는 1000개 이상의 EKS 클러스터에서 Cluster Autoscaler에서 Karpenter로의 마이그레이션을 완료했으며, Karpenter transition tool로 설정 변환 과정을 단순화했습니다."
리스크 회피 체크리스트
- 병행 운영: CA를 바로 비활성화하지 말고 먼저 일정 기간 병행 운영합니다.
- nodeSelector 제어: 라벨로 Pod 분포를 분리해 두 시스템이 서로 간섭하지 않게 합니다.
- limits 설정: NodePool에 CPU/Memory limits를 설정해 과도한 확장을 방지합니다.
- 모니터링 알림: Pod Pending > 3분이면 알림을 발생시킵니다 [7].
- 롤백 준비: CA 설정 파일을 보존해 언제든 롤백할 수 있게 합니다.
6. 의사결정 프레임워크: 2026년에는 무엇을 선택할까?
절대적인 정답은 없습니다. 우선순위에 달려 있습니다.
Reintech는 의사결정 표 [1]를 제공했고, 여기에 AWS 공식 정보를 보완했습니다.
5가지 기준의 의사결정 매트릭스
| 우선순위 기준 | CA를 선택할 상황 | Karpenter를 선택할 상황 |
|---|---|---|
| 확장 속도 | 5분 지연을 받아들일 수 있음 | 1분 이내 확장이 필요함 |
| 비용 절감 | 이미 노드 그룹을 수동 최적화함 | 자동 비용 관리가 필요함 |
| 설정 복잡도 | 단순한 시작을 선호함 | 플랫폼 엔지니어링 팀이 있음 |
| 클라우드 환경 | 멀티 클라우드 또는 비 AWS | 주로 AWS 환경 |
| 워크로드 유형 | 동질적인 워크로드 | 다양하고 동적인 워크로드 |
대표 시나리오별 추천
시나리오 1: 작은 팀, 단순한 워크로드
- 클러스터 규모: 10-20개 노드
- 워크로드: Web 서비스 중심, 안정적인 트래픽
- 우선순위: 단순 설정, 빠른 시작
추천: CA.
이유: CA는 몇 시간이면 설정할 수 있고, 소규모 클러스터에서는 유지보수 비용이 크게 드러나지 않습니다. Karpenter의 학습 비용은 작은 팀에는 부담일 수 있습니다.
시나리오 2: 중대형 팀, 비용 민감
- 클러스터 규모: 50개 이상 노드
- 워크로드: 혼합 유형(Web + 배치 처리 + Spot 작업)
- 우선순위: 비용 제어, 자동화 관리
추천: Karpenter.
이유: 중대형 클러스터에서는 20-40% 비용 절감 효과가 큽니다 [2]. Consolidation과 Spot 자동화는 운영 부담도 줄입니다.
시나리오 3: 멀티 클라우드 환경

- 클러스터 분포: AWS + GCP + Azure
- 우선순위: 통합된 오토스케일링 방식
추천: CA.
이유: CA의 멀티 클라우드 지원은 성숙해 있고, GCP/Azure에도 노드 그룹 메커니즘이 있습니다. Karpenter는 현재 주로 AWS를 지원합니다(AWS 네이티브 설계).
미래 흐름: EKS Auto Mode
AWS는 2026년에 EKS Auto Mode를 출시했습니다. Karpenter 기반의 네이티브 솔루션입니다 [4].
간단히 말하면 AWS가 Karpenter의 로직을 EKS Auto Mode에 통합한 것입니다. Karpenter를 따로 설치하지 않아도 EKS가 자동으로 노드를 확장하고 축소합니다.
이 흐름은 AWS의 방향을 보여줍니다. Karpenter의 아키텍처가 AWS가 인정한 미래 방식이라는 뜻입니다.
새 클러스터라면 EKS Auto Mode를 바로 고려해 보세요. Karpenter 설치와 설정 단계를 줄일 수 있습니다.
멀티 클라우드 지원 비교
CA: AWS, GCP, Azure를 모두 지원합니다.
- AWS: Auto Scaling Groups
- GCP: Managed Instance Groups
- Azure: Virtual Machine Scale Sets
CA의 노드 그룹 메커니즘은 멀티 클라우드에 자연스럽게 맞습니다.
Karpenter: 주로 AWS이며, 다른 클라우드 지원은 느리게 진행 중입니다.
현재 Karpenter 공식 지원은 AWS뿐입니다. 커뮤니티에는 Azure PR(일부 기능)이 있고, GCP 지원은 아직 초기 단계입니다.
멀티 클라우드 요구사항이 있다면 CA가 현재 유일하게 성숙한 선택지입니다. 다만 장기적으로는 Karpenter의 멀티 클라우드 지원도 점차 개선될 것입니다.
제안
클러스터가 AWS에 있고 다음 조건을 만족한다면:
- 클러스터 규모 > 30개 노드
- 워크로드 유형이 다양함
- 비용이 핵심 고려사항임
- 플랫폼 엔지니어링 팀이 있음
Karpenter를 바로 도입하거나 EKS Auto Mode를 사용하세요.
클러스터 규모가 작거나(< 20개 노드), 멀티 클라우드 환경이라면 CA가 여전히 안정적인 선택입니다.
2026년 AWS EKS 환경에서는 Karpenter가 이미 추천할 만한 방식입니다. 하지만 CA도 특정 상황(멀티 클라우드, 소규모 클러스터)에서는 여전히 가치가 있습니다.
정리
길게 이야기했지만 핵심 결론은 세 문장입니다.
Karpenter는 속도, 비용, 유연성에서 앞섭니다. CA는 단순성, 멀티 클라우드 지원에서 여전히 가치가 있습니다.
2026년 AWS EKS 환경에서는 Karpenter가 추천할 만한 선택입니다. 하지만 마이그레이션에는 2-4주의 계획과 테스트가 필요하며, 급하게 전환해서는 안 됩니다.
AWS 네이티브 클러스터이고 워크로드가 다양하며 비용에 민감하다면 첫 번째 Karpenter NodePool 테스트를 시작하세요. 공식 마이그레이션 가이드 [9]를 참고해 2주 동안 병행 운영하고 점진적으로 전환하면 됩니다.
클러스터가 멀티 클라우드 환경에 있거나 규모가 작고 워크로드가 안정적이라면 CA도 충분합니다. 억지로 마이그레이션할 필요는 없습니다.
다음 행동:
- Karpenter 공식 마이그레이션 문서 [9] 읽기
- 테스트 NodePool을 만들고 배치 작업 하나를 실행해 보기
- Pod Pending 시간과 비용 변화를 모니터링하며 CA의 결과와 비교하기
앞으로도 EKS 클러스터 관리 실전 글을 계속 작성할 예정입니다. 블로그를 구독하면 업데이트를 놓치지 않을 수 있습니다.
참고 자료
[1] Reintech - Karpenter vs Cluster Autoscaler: Which Should You Use in 2026
https://reintech.io/blog/karpenter-vs-cluster-autoscaler-comparison-2026
[2] Reintech - 사용자 실제 비용 절감 보고(20-40%)
[3] AWS Architecture Blog - How Salesforce migrated from Cluster Autoscaler to Karpenter
https://aws.amazon.com/blogs/architecture/how-salesforce-migrated-from-cluster-autoscaler-to-karpenter-across-their-fleet-of-1000-eks-clusters/
[4] AWS EKS Official Docs - Scale cluster compute with Karpenter and Cluster Autoscaler
https://docs.aws.amazon.com/eks/latest/userguide/autoscaling.html
[5] CHKK - Karpenter vs. Cluster Autoscaler
https://www.chkk.io/blog/karpenter-vs-cluster-autoscaler
[6] Reddit r/kubernetes - 사용자 실측 피드백(노드 준비 지연)
https://www.reddit.com/r/kubernetes/comments/zsmqrk/karpenter_vs_cluster_autoscaler_findings/
[7] AWS Blog - Using Amazon EC2 Spot Instances with Karpenter
https://aws.amazon.com/blogs/containers/using-amazon-ec2-spot-instances-with-karpenter/
[8] ScaleOps - Karpenter vs Cluster Autoscaler: Definitive Guide for 2025
https://scaleops.com/blog/karpenter-vs-cluster-autoscaler/
[9] Karpenter Official Docs - Migrating from Cluster Autoscaler
https://karpenter.sh/docs/getting-started/migrating-from-cas/
FAQ
Karpenter와 Cluster Autoscaler의 핵심 차이는 무엇인가요?
Karpenter는 비용을 얼마나 절감할 수 있나요?
Cluster Autoscaler에서 Karpenter로 마이그레이션하는 데 얼마나 걸리나요?
Karpenter는 멀티 클라우드 환경을 지원하나요?
소규모 클러스터(10-20개 노드)에도 Karpenter가 적합한가요?
Karpenter의 Spot 인스턴스 중단 처리는 어떻게 동작하나요?
마이그레이션 중 CA와 Karpenter가 서로 간섭하지 않게 하려면 어떻게 해야 하나요?
4분 읽기 · 게시일: 2026년 5월 4일 · 수정일: 2026년 10월 21일


댓글
GitHub로 로그인하여 댓글을 남기세요