
Como avaliar a capacidade de planejamento de Agents: profundidade de raciocínio, decomposição de tarefas e autocorreção
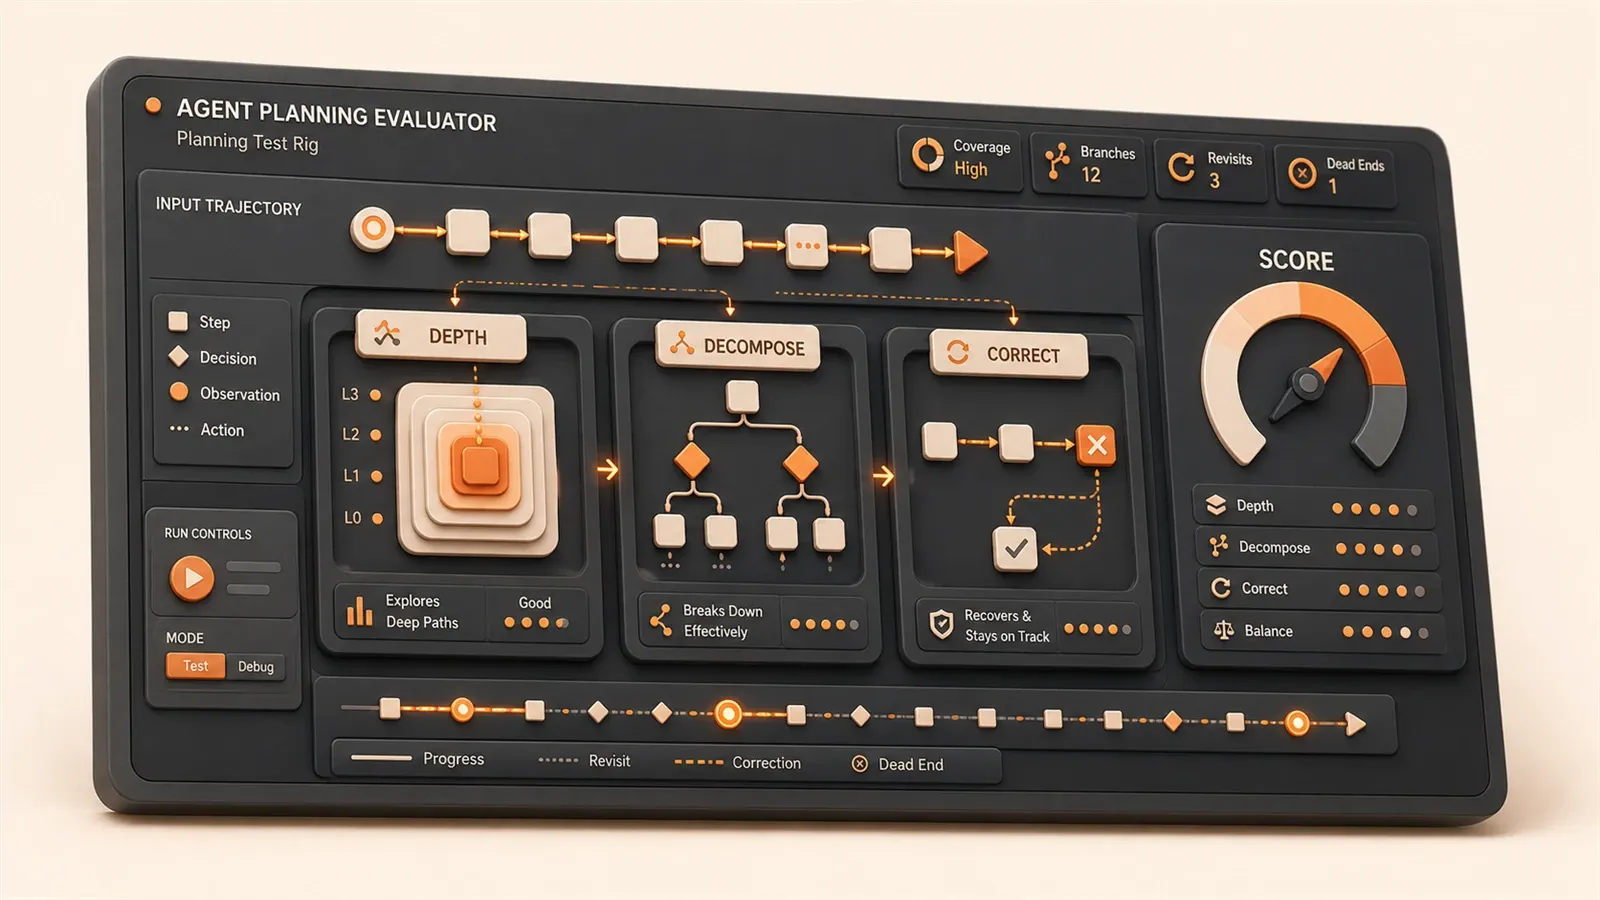
Uma avaliação de Agent rodou a noite inteira. Acurácia: 94%. No papel, bonito. Depois do deploy em produção, em três dias chegaram 11 reclamações de usuários: a tarefa travava no meio, chamava a mesma ferramenta em loop ou simplesmente pulava uma etapa importante.
O problema está no jeito tradicional de avaliar. Uma acurácia de 94% só mostra que o sistema acerta perguntas isoladas. Ela não mostra se ele consegue concluir uma tarefa que exige sete ou oito passos de raciocínio. É como avaliar capacidade de trabalho com uma prova só de múltipla escolha: dá para tirar nota alta e ainda assim não conseguir executar o trabalho real.
Então, como medir a capacidade de planejamento de um Agent? Por que olhar apenas para acurácia não basta? E como montar uma avaliação que realmente encontra os problemas? Este artigo detalha uma metodologia prática para medir profundidade de raciocínio, decomposição de tarefas e autocorreção, além de comparar benchmarks como AgentBench, ToolBench e ACPBench.
1. Por que avaliar Agents é mais complexo do que avaliar modelos?
Avaliar um modelo, em geral, é direto: você dá uma pergunta e verifica se a resposta está certa. Uma questão de múltipla escolha escolheu A ou B? O código gerado passou nos testes? A tradução ficou boa? Há várias dimensões, mas a lógica é clara.
Com Agents, é diferente. Em um blog de engenharia de 2025, a equipe da Anthropic apresentou uma ideia importante: a capacidade de um Agent é uma “capacidade de processo”, não uma “capacidade pontual”. Você não está medindo “ele sabe ou não sabe?”. Está medindo “ele consegue tomar uma sequência de decisões corretas dentro de um ambiente complexo?”.
Na prática, um Agent precisa de seis capacidades principais:
- Capacidade de chamar ferramentas: saber quando usar qual ferramenta e passar os parâmetros corretos.
- Capacidade de decompor tarefas: quebrar um objetivo grande em passos executáveis, com dependências razoáveis entre eles.
- Capacidade de raciocínio: lidar com raciocínio multissalto, derivando a resposta passo a passo em vez de tentar chegar nela de uma vez.
- Capacidade de memória: lembrar o contexto anterior e não esquecer a primeira etapa quando estiver executando a segunda.
- Capacidade de autocorreção: perceber quando errou, ajustar a estratégia e não insistir no mesmo caminho errado.
- Capacidade de planejamento de longo prazo: executar cadeias de dezenas de passos sem se perder no meio.
Veja o contraste: métricas tradicionais como acurácia, F1 e BLEU foram pensadas para saídas pontuais. Agents exigem avaliação de processo. E é aí que a coisa complica.
Um exemplo simples: você pede para o Agent reservar uma passagem de São Paulo para o Rio de Janeiro, com voo amanhã à tarde e orçamento máximo de 800 reais. Parece fácil, mas a tarefa envolve:
- Consultar informações de voos (chamada de ferramenta)
- Filtrar os resultados que atendem aos critérios (raciocínio)
- Se não houver uma opção perfeita, decidir se flexibiliza o horário ou o orçamento (tomada de decisão)
- Depois de escolher, chamar a API de reserva (chamada de ferramenta)
- Se a API retornar erro, lidar com a exceção (autocorreção)
Se qualquer etapa falhar, a tarefa falha. Mas, se você só olhar o resultado final — “reservou ou não reservou?” — muita coisa passa batida. Talvez o horário escolhido estivesse errado. Talvez o orçamento tenha sido ultrapassado e o Agent achou que estava tudo bem. Talvez a API tenha dado erro e ele nem tentou de novo.
É por isso que eval-driven development, ou desenvolvimento guiado por avaliações, é tão importante no mundo dos Agents. A recomendação da Anthropic é desenhar as avaliações ainda na fase de desenvolvimento e usar esses resultados para orientar as iterações do Agent, em vez de descobrir os problemas só depois do lançamento.
2. As dimensões centrais para avaliar planejamento de Agents
A avaliação da capacidade de planejamento de um Agent gira em torno de três dimensões: decomposição de tarefas, profundidade de raciocínio e consistência de longo prazo. Parece abstrato, então vamos separar ponto por ponto.
Decomposição de tarefas
Em termos simples, é verificar se o Agent consegue quebrar um objetivo grande em passos menores e executáveis, com uma relação lógica entre eles.
A métrica central aqui é chamada de Plan Graph Coherence, ou coerência do grafo de planejamento. O que isso significa? Você transforma os passos gerados pelo Agent em um grafo direcionado: cada nó é uma subtarefa, e cada aresta representa uma dependência. Depois, verifica duas coisas:
- Validade da ordenação topológica: existe uma ordem de execução razoável? Não pode haver uma situação em que “é preciso fazer B antes de A, mas também é preciso fazer A antes de B”.
- Ausência de dependências circulares: o grafo não pode conter ciclos.
Já encontrei um caso de falha assim: pediram para um Agent escrever um relatório de análise de dados. Ele gerou este plano:
- Coletar dados
- Limpar dados
- Analisar dados
- Gerar relatório
- Complementar a coleta de dados com base nos resultados da análise
Percebeu o problema? A etapa 5 volta para a etapa 1, mas as etapas anteriores já foram executadas. O Agent não percebeu que aquilo era um ciclo. O fluxo inteiro ficou preso, repetindo a execução.

Os modos de falha mais comuns na decomposição de tarefas são três:
- Dependência circular: como no exemplo acima, as etapas formam um ciclo.
- Salto de etapa: o Agent pula direto para a conclusão e deixa de fora passos importantes.
- Subtarefas incompletas: os passos decompostos simplesmente não bastam para atingir o objetivo.
Profundidade de raciocínio
Essa dimensão mede se o Agent consegue lidar com raciocínio de múltiplas etapas. O DeepSeek-V3-0324 teve acurácia de 91% em testes de raciocínio multissalto, segundo seu relatório técnico. Mas o que “multissalto” quer dizer exatamente?
Em termos simples, você parte de um fato conhecido e precisa passar por N inferências até chegar à resposta final. Por exemplo:
- Fato: A é maior que B, e B é maior que C
- Pergunta: quem é maior, A ou C?
- Esse é um problema de raciocínio de 2 saltos
Em cenários reais, o Agent costuma encontrar cadeias de raciocínio com 5 etapas ou mais. Por exemplo, o usuário pergunta: “encontre o produto com maior faturamento no mês passado e analise por que ele vendeu tão bem”. A tarefa exige:
- Consultar os dados de vendas do mês passado
- Ordenar os resultados e encontrar o produto no topo
- Analisar as características desse produto
- Compará-lo com outros produtos
- Resumir os motivos
Cada passo depende do resultado do passo anterior. A métrica para avaliar isso é a acurácia em raciocínio multissalto, mas ela precisa ser segmentada: qual é a acurácia com 2 saltos, 3 saltos, 5 saltos? Muitas vezes, o Agent aguenta bem 3 saltos e quebra em 5.
Consistência de planejamento de longo prazo
Essa é a dimensão que mais costuma dar problema. Em uma tarefa de 50 etapas, quando o Agent chega à etapa 30, ele ainda lembra o contexto inicial?
A métrica se chama State Drift Rate, ou taxa de deriva de estado. O cálculo é: número de vezes em que o estado interno do Agent fica inconsistente com o estado esperado durante a execução de uma tarefa longa, dividido pelo número total de etapas.
Já vi um caso real em um Agent de atendimento. Ele estava lidando com uma solicitação de reembolso. Tudo ia bem até o usuário dizer: “não, estou falando de outro pedido”. O Agent se perdeu. Toda a conversa depois disso passou a girar em torno desse “outro pedido”, embora o reembolso ainda fosse do pedido original. Isso é deriva de estado: no meio de uma conversa longa, o Agent perdeu o ponto de ancoragem inicial.
O State Drift Rate ideal deveria ficar abaixo de 0.05, ou seja, no máximo 5 inconsistências a cada 100 etapas. Em testes reais, porém, muitos Agents open source ficam entre 0.15 e 0.25. A diferença é grande.
3. Comparação aprofundada dos principais benchmarks
Hoje existem vários benchmarks para avaliação de Agents, cada um com um foco diferente. Vou destacar quatro dos mais usados e fechar com uma recomendação de escolha.
AgentBench: o generalista
O AgentBench foi publicado por uma equipe da Tsinghua no ICLR’24 e é um dos benchmarks de cobertura mais ampla. Ele mede a capacidade geral de LLMs atuando como Agents em 8 ambientes:
- Interação com sistema operacional
- Consulta a banco de dados
- Raciocínio em grafo de conhecimento
- Cenários de compra
- Mecanismos de busca
- Planejamento doméstico
- Navegação na web
- Videogames
Esse benchmark testou 29 LLMs populares e oferece dados comparativos bem abrangentes. Se você quer entender rapidamente em que nível está a capacidade agentic de um modelo, rodar uma versão simplificada do AgentBench já resolve muita coisa.
Mas há uma limitação clara: ele não cobre bem a avaliação de autocorreção. Ou seja, mede “consegue acertar na primeira tentativa?”, mas não mede “se errar, consegue perceber e corrigir?”. E autocorreção é justamente uma das capacidades mais importantes de Agents em cenários reais.
ACPBench: especialista em profundidade de raciocínio
O ACPBench, da IBM, foca raciocínio profundo em lógica de planejamento. ACP é a sigla de Action, Change, Planning, e o nome já entrega o objetivo.
Sua principal característica é a validação por raciocínio formal. O que isso significa? Ele não olha apenas se a saída final está correta. Ele verifica se o processo de raciocínio obedece a regras lógicas. Por exemplo, se você pede para o Agent planejar uma viagem, o benchmark valida se as precondições de cada etapa foram satisfeitas e se as relações causais fazem sentido.
É indicado quando você precisa testar a capacidade de raciocínio de planejamento em profundidade, e não só o resultado final. A desvantagem é a cobertura mais estreita: ele se concentra em lógica de planejamento e não aborda dimensões como chamada de ferramentas ou multimodalidade.
ToolBench: específico para uso de ferramentas
O ToolBench mede a capacidade de chamada de ferramentas via API. Se você está desenvolvendo um Agent baseado em ferramentas, por exemplo um assistente capaz de chamar várias APIs externas, esse é o benchmark mais adequado.
Ele oferece cenários de API-planning em larga escala e mede:
- Se o Agent escolhe corretamente qual API chamar
- Se os parâmetros estão corretos
- Se a lógica de encadear várias APIs faz sentido
- Se ele consegue lidar com falhas em chamadas de API
Esse conjunto de testes é muito útil para avaliar o uso de ferramentas por Agents.
DeepPlanning: planejamento de longo prazo
O DeepPlanning é focado em Agentic Planning de longo prazo. Enquanto outros benchmarks costumam testar tarefas de 5 a 10 etapas, o DeepPlanning trabalha com cadeias de 20 a 50 etapas, ou até mais.
Isso é especialmente importante para medir consistência de planejamento de longo prazo. O Agent ainda lembra o objetivo inicial depois de dezenas de passos? Ele se perde no meio? Esses são problemas que o DeepPlanning ajuda a revelar.
Recomendação de escolha
| Cenário | Benchmark recomendado | Motivo |
|---|---|---|
| Validação inicial rápida | Versão simplificada do AgentBench | Cobertura ampla e diagnóstico rápido do nível geral |
| Planejamento especializado | ACPBench | Validação profunda de raciocínio com checagem formal |
| Agent baseado em ferramentas | ToolBench | Testes específicos de chamada de API |
| Aceitação em produção | Uso combinado | Cobertura multidimensional e complementar |
Minha recomendação pessoal: primeiro rode o AgentBench para estabelecer uma baseline e entender em que nível o seu Agent está. Depois, teste em profundidade as dimensões mais críticas para o seu negócio. Se o seu Agent depende principalmente de chamadas de ferramentas, foque no ToolBench. Se o foco é planejamento complexo, use ACPBench e DeepPlanning.

4. Avaliação prática da capacidade de autocorreção
Falando com franqueza, esta talvez seja a parte mais importante do artigo. Por quê? Porque Agents no mundo real não vão acertar sempre. O ponto é: quando erram, conseguem perceber? Conseguem se corrigir?
Por que autocorreção importa tanto?
Os dados ajudam a enxergar. Reflexion é um framework clássico de autorreflexão. Ele elevou a taxa de aprovação no HumanEval de 80% para 91%. Um ganho de 11 pontos percentuais, nada pequeno. No ambiente AlfWorld, Reflexion resolveu 130 de 134 desafios, com taxa de sucesso de 97%.
"Reflexion é um framework de autorreflexão que faz o Agent analisar a causa da falha e ajustar a estratégia após uma tentativa malsucedida. Com isso, elevou a taxa de aprovação no HumanEval de 80% para 91% e chegou a 97% de resolução no AlfWorld (130/134)."
Outro estudo, da equipe da Galileo, mostrou que mecanismos de autorreflexão podem melhorar o desempenho de resolução de problemas entre 9% e 18,5%. A diferença é desse tamanho.
Como a arquitetura Reflexion funciona
O mecanismo central é simples e tem quatro etapas:
- Executar: o Agent tenta concluir a tarefa.
- Refletir: se falhar, o Agent analisa a causa da falha.
- Corrigir: com base na reflexão, ajusta a estratégia.
- Tentar de novo: executa novamente com a nova estratégia.
O ponto-chave está na etapa de “refletir”. Não é só “tente de novo”. O Agent precisa conseguir dizer “por que errei” e “o que devo mudar”. Isso exige metacognição: a capacidade de examinar o próprio processo de pensamento.
Como medir autocorreção?
Aqui vai um roteiro prático:
Primeiro passo: injete erros controlados
No ambiente de teste, crie intencionalmente alguns cenários de erro, como:
- Timeout em chamada de ferramenta
- API retornando código de erro
- Formato de parâmetro incorreto
- Recurso inexistente
Esses erros precisam ser reprodutíveis. Só assim você consegue comparar diferentes Agents sob as mesmas condições.
Segundo passo: observe a reação do Agent
Registre estas informações:
- O Agent consegue identificar que ocorreu um erro?
- Ele tenta analisar a causa?
- Qual estratégia de correção ele usa?
- Depois da correção, a tarefa dá certo?
- Quantas tentativas foram necessárias?
Terceiro passo: calcule as métricas
Há três métricas principais:
- Taxa de recuperação: proporção de erros que o Agent corrige sozinho até chegar ao sucesso.
- Média de tentativas: quantas novas tentativas, em média, são necessárias do erro até o sucesso.
- Taxa final de conclusão: percentual de tarefas concluídas considerando todas as tarefas, inclusive as que exigiram autocorreção.
Uma boa avaliação deve diferenciar “acertou de primeira” de “errou, mas conseguiu corrigir”. A primeira situação mostra força na capacidade básica. A segunda mostra capacidade de autocorreção.
Um exemplo real
Já testei um Agent com a tarefa de consultar informações de usuários em um banco de dados e gerar um relatório.
Na primeira execução, ele escreveu a query errada e o banco retornou um resultado vazio. A partir daí, havia dois comportamentos possíveis:
- Agent sem capacidade de autocorreção: gera o relatório com o resultado vazio, com conteúdo do tipo “nenhum dado encontrado”.
- Agent com capacidade de autocorreção: percebe que o resultado vazio pode indicar problema na condição de consulta, corrige e tenta novamente.
A avaliação precisa capturar essa diferença. No relatório, você pode separar:
- Taxa de sucesso na primeira tentativa: proporção de casos resolvidos de primeira.
- Taxa de sucesso após correção: proporção de casos que exigiram correção, mas terminaram com sucesso.
- Taxa de falha definitiva: proporção de casos que continuaram falhando mesmo depois da correção.
Esses três grupos, juntos, dão uma visão muito mais completa da capacidade real do Agent.
5. Como montar seu sistema de avaliação de Agents
Depois da teoria, vem a parte prática. Abaixo está uma arquitetura de avaliação em três camadas que você pode adaptar diretamente.
Arquitetura de avaliação em três camadas
Primeira camada: capacidades básicas

Mede habilidades pontuais, uma por uma:
- Acurácia de chamadas de ferramentas: a API chamada e os parâmetros estão corretos?
- Acurácia de decomposição de pequenas tarefas: tarefas simples são quebradas em passos razoáveis?
- Acurácia de raciocínio de uma etapa: inferências simples são resolvidas corretamente?
Essa camada segue a lógica de testes unitários: cada teste roda de forma independente.
Segunda camada: tarefas de cenário
Mede simulações de cenários reais de negócio:
- Desenhe alguns fluxos típicos do seu produto ou operação.
- Cada fluxo deve ter de 5 a 15 etapas.
- Inclua fluxos normais e ramificações anormais, ou seja, cenários que exigem autocorreção.
Essa camada mede combinação de capacidades, não habilidades isoladas.
Terceira camada: avaliação integrada
Agrega todos os resultados:
- Resumo de pontuação por dimensão.
- Cálculo ponderado da pontuação geral, ajustando os pesos conforme a importância para o negócio.
- Geração de relatório visual.
Padronização do fluxo de avaliação
Se você quer montar um sistema de avaliação reprodutível, uma boa organização é esta:
# Iniciar o ambiente de avaliação
docker compose -f eval-spec.yml up --build

# Rodar o benchmark especificado, repetir 3 vezes e usar a média
python run_eval.py --benchmark agentbench-v2.1 --num-trials 3

# Exportar o relatório de avaliação
python export_report.py --format markdown --output eval_results.md
O ponto importante é “repetir 3 vezes”. A saída de um Agent tem certa variabilidade. O resultado de uma única execução pode ser instável; rodar várias vezes e usar a média é mais confiável.
Checklist de métricas principais
Organizei a tabela abaixo para servir como padrão de avaliação:
| Métrica | Como calcular | Limite ideal | Minha recomendação |
|---|---|---|---|
| Tool Call F1 | Correspondência de tokens no nível dos parâmetros | >= 0.92 | Métrica central para Agents baseados em ferramentas |
| Plan Coherence | Validade topológica + ausência de ciclos | 1.0 | Precisa ser perfeito; se houver ciclo, o plano quebra |
| State Drift Rate | Inconsistências de estado / total de etapas | < 0.05 | Quanto menor, melhor |
| Recovery Rate | Recuperações bem-sucedidas / total de erros | >= 0.8 | Indicador direto de autocorreção |
| Taxa de sucesso inicial | Proporção de acertos na primeira tentativa | >= 0.85 | Capacidade básica |
| Taxa final de conclusão | Sucesso total após considerar autocorreção | >= 0.95 | Inclui capacidade de correção |
Esses limites são referências baseadas na minha experiência prática. Claro que o padrão exato depende do seu cenário de negócio: alguns casos exigem mais rigor, outros permitem uma margem maior.
Conclusão
Depois de tudo isso, a ideia central é uma só: avaliar Agents não é olhar apenas para o resultado final, é avaliar a qualidade do processo. Métricas tradicionais dizem apenas “acertou ou errou”. Agents exigem uma análise mais granular: como o sistema chegou ao resultado, se tomou atalhos ruins no caminho e se conseguiu se ajustar quando errou.
Eval-driven development deveria virar prática padrão no desenvolvimento de Agents. Não espere o problema aparecer em produção. Monte o sistema de avaliação durante o desenvolvimento e use os dados para orientar cada iteração.
Se você quer começar agora, eu seguiria este caminho:
- Rode primeiro um teste de baseline com AgentBench para entender o nível geral do seu Agent.
- De acordo com o seu cenário de negócio, escolha 2 ou 3 benchmarks especializados para testar em profundidade.
- Monte uma arquitetura de avaliação em três camadas e padronize o fluxo.
- Rode a avaliação a cada iteração e compare as mudanças com dados.
A confiabilidade de um Agent não deve ser julgada por “sensação”. Precisa ser medida. Espero que a metodologia e o roteiro prático deste artigo ajudem você a evitar algumas armadilhas.
Referências
- Anthropic Engineering: Demystifying evals for AI agents - blog oficial de engenharia, 2025
- AgentBench: Evaluating LLMs as Agents (ICLR’24) - benchmark acadêmico da equipe da Tsinghua
- Survey on Evaluation of LLM-based Agents - survey no arXiv, 2026
- Self-Reflection in LLM Agents - artigo sobre Reflexion
- ACPBench: Reasoning about Action, Change, and Planning - pesquisa da IBM
FAQ
Qual é a diferença essencial entre avaliar Agents e avaliar LLMs tradicionais?
Como escolher o benchmark certo para avaliar um Agent?
• Validação inicial rápida: versão simplificada do AgentBench (cobre 8 ambientes e compara 29 LLMs)
• Planejamento especializado: ACPBench (validação por raciocínio formal)
• Agents baseados em ferramentas: ToolBench (focado em chamadas de API)
• Planejamento de longo prazo: DeepPlanning (cadeias de 20 a 50 etapas)
• Aceitação em produção: uso combinado para cobrir várias dimensões
Quais são os principais indicadores para avaliar capacidade de planejamento de Agents?
• Plan Coherence: verifica dependências circulares e saltos de etapa; valor ideal = 1.0
• Acurácia em raciocínio multissalto: mede cadeias de 2 a 5 saltos; DeepSeek-V3-0324 chegou a 91%
• State Drift Rate: mede retenção de contexto em tarefas longas; valor ideal < 0.05
Como avaliar a capacidade de autocorreção?
• Taxa de recuperação: proporção de erros corrigidos autonomamente; deve ser >= 80%
• Média de tentativas: quantas tentativas são necessárias do erro até o sucesso
• Taxa final de conclusão: sucesso total após considerar autocorreção; deve ser >= 95%
O Reflexion elevou a taxa de aprovação no HumanEval de 80% para 91% e alcançou 97% de sucesso no AlfWorld.
Quais são os passos para montar um sistema de avaliação de Agents?
• Camada de capacidades básicas: testes pontuais, como acurácia de chamadas de ferramentas, decomposição de pequenas tarefas e raciocínio de uma etapa
• Camada de tarefas de cenário: simulação de fluxos reais de negócio, com 5 a 15 etapas e ramificações normais e anormais
• Camada de avaliação integrada: agregação de métricas multidimensionais, cálculo ponderado e relatórios visuais
Recomendo repetir cada avaliação 3 vezes e usar a média. Primeiro estabeleça uma baseline com AgentBench e depois adicione benchmarks especializados.
1 min de leitura · Publicado em: 7 mai 2026 · Atualizado em: 14 jul 2026

Guia de engenharia de AI Agents
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Benchmark de avaliação de agentes: guia prático de AgentBench a DeepEval
Guia sobre benchmarks de avaliação e testes de desempenho para agentes, comparando AgentBench, WebArena, τ-Bench e outros, com avaliação por componentes no DeepEval e exemplos de código.
Parte 13 de 22
Próximo
Monitoramento, alertas e recuperação de AI Agent: da arquitetura de logs à máquina de estados
Seu AI Agent falha em produção e você não consegue investigar? Veja uma prática completa, dos logs à máquina de estados, para criar monitoramento e alertas de nível produtivo.
Parte 15 de 22


Comentários
Entre com GitHub para comentar