
Nginx na prática: upstream, balanceamento de carga e health checks
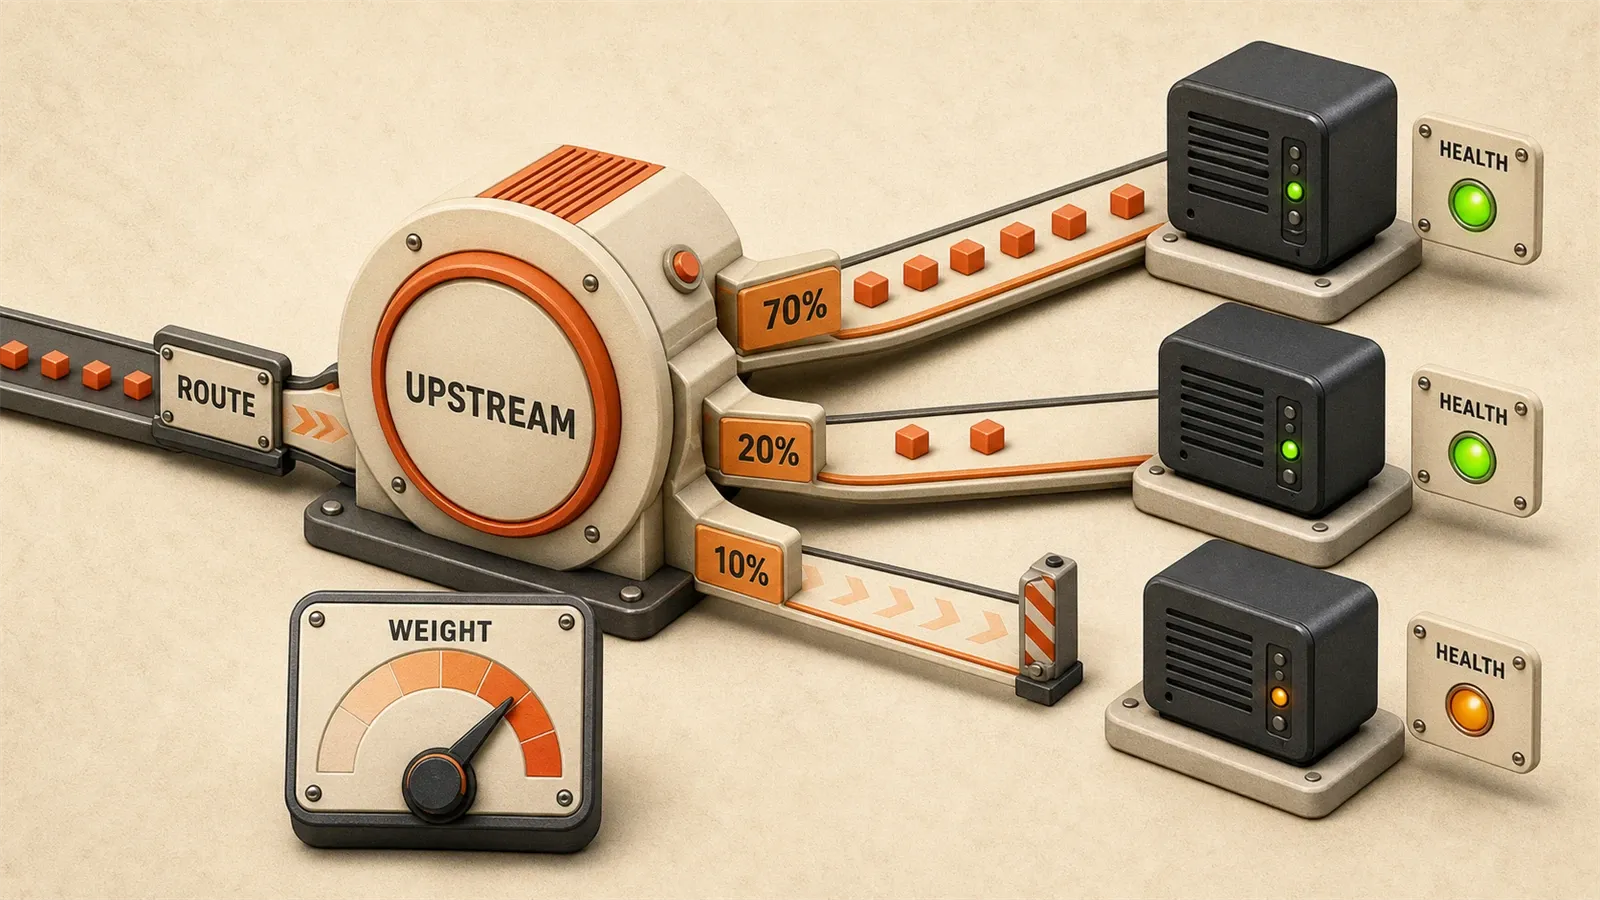
O celular começou a vibrar sem parar. Ao abrir o painel de monitoramento, a barra de status do backend1 estava toda vermelha: um único servidor de aplicação tinha caído.
Naquela promoção de Duplo 11, havia apenas dois servidores backend. A configuração do Nginx era upstream backend { server backend1; server backend2; }, aparentemente bem simétrica. Só que o backend1 recebia 70% do tráfego, porque aparecia primeiro no arquivo de configuração e usávamos o round-robin padrão: sem peso e sem health check.
No momento em que o backend1 caiu, as requisições de pedido dos usuários continuaram indo para aquele servidor morto. O Nginx não sabia que ele estava fora, então seguia encaminhando tráfego para lá. O que o usuário via? Uma página de erro 500. Quando a operação removeu manualmente o backend1 do upstream, 15 minutos já tinham passado.
Depois desse incidente, fui estudar o assunto direito: Nginx upstream não é só listar endereços de servidores. Distribuição por peso, health check e failover são o que produção realmente precisa. Este artigo organiza as armadilhas que encontrei e as configurações que passei a usar, incluindo como implementar health check ativo no Nginx open source.
1. Configuração básica de upstream: de um servidor para um cluster
A função principal do bloco upstream é simples: agrupar vários servidores em um grupo lógico para que o Nginx saiba para onde encaminhar as requisições. Mas os parâmetros disponíveis são mais ricos do que muita gente imagina.
upstream backend {
  zone backend 64k;
  server backend1.example.com weight=3 max_fails=2 fail_timeout=30s;
  server backend2.example.com;
  server backup1.example.com backup;
}
Linha por linha:
zone backend 64k: área de memória compartilhada. Os processos worker do Nginx precisam compartilhar o estado dos servidores backend: quem está vivo, quem caiu. 64k é um ponto de partida; se houver muitos servidores, aumente conforme necessário. Sem essa linha, cada worker cuida do próprio estado, e isso causa problema.
weight=3: peso. O backend1 tem peso 3; o backend2 fica com o padrão 1. Isso significa que, a cada 4 requisições, 3 vão para o backend1 e 1 vai para o backend2. É útil quando os servidores têm capacidades diferentes, por exemplo backend1 com 8 núcleos e 16 GB, e backend2 com 4 núcleos e 8 GB.
max_fails=2: limite de falhas. Dentro da janela definida por fail_timeout, se as requisições para esse servidor falharem 2 vezes, o Nginx marca o servidor como indisponível. O valor padrão é 1, sensível demais: uma oscilação de rede já dispara a remoção. Em produção, prefiro 2 ou 3.
fail_timeout=30s: tem dois sentidos. Primeiro, a janela de contagem de falhas é de 30 segundos. Segundo, depois que o servidor é marcado como indisponível, o Nginx tenta se conectar novamente após 30 segundos. O padrão é 10 segundos, o que pode ser pouco para serviços com inicialização lenta.
backup: servidor reserva. Ele só recebe requisições quando todos os servidores principais estão indisponíveis. Funciona bem como plano de contingência com uma máquina mais simples.
Há também o parâmetro down, usado para marcar manualmente um servidor como offline, comum durante manutenção:
server backend3.example.com down; # Manutenção temporária fora do arNa prática, vi muita gente ignorar a configuração zone. O resultado é que os workers mantêm estados separados: um worker percebe que um servidor caiu, enquanto outros continuam enviando requisições para ele. Depois de adicionar zone, o problema de sincronização de estado desaparece.
2. Cinco estratégias de balanceamento de carga: quando usar cada uma?
O round-robin padrão é suficiente? Depende.

Já vi muitos projetos rodarem por anos com round-robin padrão sem nenhum problema. Mas quando aparecem conexões longas de WebSocket, session de carrinho ou cache penetration, a estratégia padrão começa a ficar menos adequada. A tabela abaixo resume meu critério de escolha:
| Cenário | Estratégia recomendada | Motivo |
|---|---|---|
| API sem estado | round-robin | Distribuição uniforme, sem tratamento especial |
| Serviço WebSocket | least_conn | Monitora conexões dinamicamente e evita sobrecarga em um servidor |
| Carrinho de e-commerce | ip_hash | Requisições do mesmo usuário vão para o mesmo servidor |
| Proxy de cache | hash key=$uri | Reduz invalidação e penetração de cache |
| Ambiente de teste | random | Validação rápida, configuração simples |
round-robin: a rotação padrão
Se você não configurar nada, usa round-robin. As requisições são enviadas sequencialmente para cada servidor:
upstream backend {
  server backend1.example.com;
  server backend2.example.com;
  server backend3.example.com;
}
Serve para serviços sem estado. Cada requisição é independente e não depende do estado de requisições anteriores. A maioria das REST APIs entra aqui.
least_conn: menor número de conexões
Prioriza o servidor que tem menos conexões ativas no momento:
upstream websocket_app {
  least_conn;
  server ws1.example.com:8080;
  server ws2.example.com:8080;
}
Esse é o cenário clássico de WebSocket. Um usuário abre uma conexão longa, e a quantidade de conexões pode variar bastante. Com round-robin, um servidor pode acumular muitas conexões longas e continuar recebendo novas requisições. O least_conn monitora isso em tempo real e envia a próxima requisição para a máquina com menor carga.
ip_hash: hash por IP
Calcula um hash com base no IP do cliente, fazendo com que requisições do mesmo IP sempre caiam no mesmo servidor:
upstream shopping_cart {
  ip_hash;
  server cart1.example.com;
  server cart2.example.com;
}
É útil quando você precisa de consistência de session. Pense em um carrinho de e-commerce: o usuário adiciona um produto no cart1; se a próxima requisição cair no cart2, os dados do carrinho somem, a menos que você use armazenamento de session distribuído. O ip_hash resolve esse problema.
Mas o ip_hash tem uma limitação: se um servidor cai, os usuários que antes eram mapeados para ele são redistribuídos. Essa parte dos usuários perde a session. Por isso, ip_hash é melhor para casos em que a session não é tão crítica, ou quando existe armazenamento compartilhado de session.
hash: hash consistente
Permite definir uma chave de hash personalizada e suporta algoritmo de hash consistente:
upstream cache_proxy {
  hash $uri consistent;
  server cache1.example.com;
  server cache2.example.com;
}
É a melhor opção para proxy de cache. Aqui, $uri usa o caminho da requisição como chave. O parâmetro consistent habilita hash consistente: quando servidores são adicionados ou removidos, apenas uma parte das chaves é remapeada, não o conjunto inteiro. Assim, a taxa de acerto do cache não despenca.
random
Distribuição aleatória simples:
upstream test_backend {
  random;
  server test1.example.com;
  server test2.example.com;
}
Serve para ambiente de teste. Em produção, não recomendo, porque falta controle.
Falando francamente, minha experiência é esta: a maioria das aplicações Web fica bem com round-robin ou least_conn. ip_hash e hash resolvem cenários específicos; não use só para parecer mais sofisticado.
3. Health check passivo: max_fails e fail_timeout
“Passivo” significa que o Nginx não sonda ativamente a saúde dos servidores backend. Ele observa o sucesso ou a falha das requisições reais. É como não bater na porta do vizinho para perguntar “você está bem?”, mas inferir pelo cotidiano: se ele saiu, se recebeu encomenda, se houve movimento.
max_fails e fail_timeout configuram justamente esse mecanismo de observação:
upstream backend {
  server backend1.example.com max_fails=3 fail_timeout=30s;
  server backend2.example.com max_fails=3 fail_timeout=30s;
}

location / {
  proxy_pass http://backend;
  proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
}
proxy_next_upstream define quais situações contam como “falha”. error é erro de conexão, timeout é tempo esgotado, e http_500 até http_504 representam diferentes códigos de erro HTTP. Quando uma dessas situações acontece, o Nginx encaminha a requisição para o próximo servidor e registra uma falha no servidor atual.
Se houver 3 falhas em 30 segundos, o servidor é marcado como indisponível. Nos 30 segundos seguintes, o Nginx para de enviar requisições para ele. Depois disso, tenta uma vez: se funcionar, o servidor volta; se falhar, espera mais 30 segundos.
O problema desse mecanismo é a resposta lenta. O servidor só é removido depois que pelo menos 3 requisições reais de usuários falham. Esses 3 usuários já receberam erro e já tiveram a experiência afetada.
Há um caso ainda mais extremo: o servidor acabou de iniciar e ainda está inicializando, com saúde instável. Uma configuração com max_fails=1 pode marcar o servidor como indisponível por uma única falha durante o boot, deixando-o excluído do pool.
Minha recomendação:

- Use max_fails como 2 ou 3 para tolerar oscilações ocasionais de rede
- Use fail_timeout de 30 segundos ou mais para dar tempo de recuperação ao servidor
- Configure proxy_next_upstream com uma lista completa de tipos de erro, para não deixar falhas escaparem
A vantagem do health check passivo é a simplicidade: o Nginx open source já suporta. A desvantagem é depender de requisições reais, então a experiência do usuário sofre primeiro. Se você precisa detectar falhas mais rápido e sondar o backend de forma ativa, entra o health check ativo.
4. Health check ativo: NGINX Plus e alternativa open source
A lógica do health check ativo é: o Nginx envia periodicamente requisições de sondagem para os servidores backend, por exemplo GET /health, e decide a saúde de cada servidor conforme a resposta. Não é preciso esperar uma requisição de usuário falhar; o próprio Nginx detecta o servidor problemático e o remove com antecedência.
A solução oficial é o NGINX Plus, a edição comercial, com custo anual de $3,675 por instância. Com 10 instâncias, isso dá $36,750 por ano. Sinceramente, para muitas empresas esse valor pesa.
A alternativa open source é o nginx_upstream_check_module, criado pela equipe técnica do Taobao. Ele exige recompilar o Nginx com o módulo, mas entrega um conjunto de recursos bem completo:
| Recurso | NGINX Plus | nginx_upstream_check_module |
|---|---|---|
| Preço | $3,675/ano | Open source e gratuito |
| Check HTTP | Suportado | Suportado |
| Check TCP | Suportado | Suportado |
| Check MySQL | Não suportado | Suportado |
| Check FastCGI | Não suportado | Suportado |
| Página de status | Suportada | Suportada (check_status) |
O módulo open source suporta checks de MySQL e FastCGI, recursos que o NGINX Plus não tem. Se seu backend usa PHP-FPM ou MySQL, esse módulo pode ser mais adequado.
Exemplo de configuração do nginx_upstream_check_module
upstream backend {
  server backend1.example.com:8080;
  server backend2.example.com:8080;

  check interval=3000 rise=2 fall=5 timeout=1000 type=http;
  check_http_send "GET /health HTTP/1.0\r\n\r\n";
  check_http_expect_alive http_2xx http_3xx;
}

server {
  location / {
    proxy_pass http://backend;
  }

  location /upstream_status {
    check_status json;
    allow 127.0.0.1;
    allow 10.0.0.0/8;
    deny all;
  }
}
Explicação dos parâmetros:
- interval=3000: envia uma requisição de sondagem a cada 3 segundos
- rise=2: após 2 sucessos consecutivos, marca o servidor como saudável; servidores recém-iniciados podem oscilar, então convém confirmar
- fall=5: após 5 falhas consecutivas, marca o servidor como indisponível; isso tolera timeouts ocasionais
- timeout=1000: timeout de 1 segundo para a requisição de sondagem
- type=http: usa HTTP para sondagem; também há suporte a tcp, ssl_hello, mysql, ajp e fastcgi
check_http_send define o conteúdo da requisição de sondagem. Aqui ele envia um GET /health simples. O backend precisa implementar o endpoint /health e retornar status 200 ou 3xx.
check_http_expect_alive define quais códigos de status contam como “saudáveis”. http_2xx e http_3xx significam que códigos 200-299 e 300-399 contam como sucesso.
check_status fornece uma página de monitoramento. A saída em json facilita integração com Prometheus ou Zabbix. O bloco allow/deny logo abaixo é controle de acesso: essa página não deve ficar exposta.
Como instalar o módulo
O nginx_upstream_check_module precisa ser instalado por compilação. O fluxo geral é:
# Baixar o código-fonte do módulo
git clone https://github.com/yaoweibin/nginx_upstream_check_module.git

# Baixar o código-fonte do Nginx
wget http://nginx.org/download/nginx-1.24.0.tar.gz
tar -zxvf nginx-1.24.0.tar.gz

# Aplicar o patch conforme a versão do Nginx
cd nginx-1.24.0
patch -p1 < ../nginx_upstream_check_module/check_1.20.1+.patch

# Compilar
./configure --add-module=../nginx_upstream_check_module
make && make install
Se você faz deploy com Docker, pode construir uma imagem própria com o módulo incluído ou procurar uma imagem pronta mantida pela comunidade.
5. Produção na prática: segurança e monitoramento
A configuração de health check em produção tem alguns detalhes fáceis de errar. Eu resumo em três princípios:
Configuração de segurança: três pontos
1. A página check_status precisa de controle de acesso
A página de status expõe a lista de servidores backend e seus estados de saúde. Se for acessível de fora, um atacante consegue ver sua topologia interna e descobrir qual servidor está indisponível naquele momento, justamente a janela perfeita para atacar.
location /upstream_status {
  check_status json;
  allow 127.0.0.1;       # Acesso local
  allow 10.0.0.0/8;      # IPs da rede interna
  deny all;              # Bloqueia o restante
}
Ou, de forma mais rígida, permita apenas o IP de servidores específicos de monitoramento.
2. Use uma porta dedicada para health check
As requisições de health check são frequentes, geralmente a cada 3 a 5 segundos. Se você sondar diretamente a porta de negócio, o backend vai registrar muitas requisições /health. Os arquivos de log incham e podem afetar desempenho.
Recomendo que o serviço backend escute em duas portas: a porta de negócio, como 8080, e a porta de health check, como 8888. A porta de health check retorna apenas um status simples, sem processar lógica de negócio e sem gravar logs.

check interval=5000 rise=2 fall=3 timeout=2000 type=http port=8888;port=8888 define a porta dedicada de sondagem.
3. O endpoint de health check não deve retornar informações sensíveis
O endpoint /health só precisa retornar um código de status. Não devolva versão, configuração, uso de memória ou outros dados internos. Atacantes usam essas informações para localizar vulnerabilidades.
# Exemplo de implementação no backend
@app.route('/health')
def health():
    return '', 200   # Retorna apenas o código de status
Integração com monitoramento: saída JSON
check_status suporta vários formatos. O formato json é adequado para integrar com sistemas de monitoramento:
curl http://127.0.0.1/upstream_statusExemplo de saída:
{
  "servers": {
    "total": 3,
    "generation": 12,
    "server": [
      {"index": 0, "name": "10.0.0.1:8080", "status": "up", "rise": 5, "fall": 0, "type": "http"},
      {"index": 1, "name": "10.0.0.2:8080", "status": "up", "rise": 3, "fall": 0, "type": "http"},
      {"index": 2, "name": "10.0.0.3:8080", "status": "down", "rise": 0, "fall": 5, "type": "http"}
    ]
  }
}
generation é o contador de mudanças de configuração. Cada alteração no upstream seguida de reload aumenta esse valor. Um script de monitoramento pode comparar o contador para confirmar que a configuração entrou em vigor.
Sugestões de ajuste de parâmetros
interval não deve ficar abaixo de 3000ms
Sondagens frequentes demais pressionam o backend. Um intervalo de 3 a 5 segundos já é suficiente; a detecção de falha fica em escala de segundos e não prejudica a experiência do usuário.
Equilíbrio entre rise e fall
- Se rise for pequeno demais, por exemplo 1, um servidor recém-iniciado pode ser classificado incorretamente como saudável antes de terminar a inicialização, depois voltar a falhar e oscilar
- Se fall for pequeno demais, por exemplo 1, uma única oscilação de rede já remove o servidor do pool, sensível demais
Meus valores práticos: rise=2, fall=3 ou fall=5. Eles toleram falhas momentâneas e só removem o servidor depois de confirmar uma falha persistente.
Configuração completa para produção
upstream web_app {
  zone web_app 64k;
  server 10.0.0.1:8080 weight=3;
  server 10.0.0.2:8080;
  server 10.0.0.3:8080 backup;

  check interval=5000 rise=2 fall=3 timeout=2000 type=http port=8888;
  check_http_send "GET /health HTTP/1.1\r\nHost: app.example.com\r\n\r\n";
  check_http_expect_alive http_2xx;
}

server {
  listen 80;
  server_name app.example.com;

  location / {
    proxy_pass http://web_app;
    proxy_set_header Host $host;
    proxy_next_upstream error timeout http_502 http_503 http_504;
  }

  location /upstream_status {
    check_status json;
    allow 127.0.0.1;
    allow 10.0.0.0/8;
    deny all;
  }
}
Essa configuração faz quatro coisas:
- Usa zone com memória compartilhada para sincronizar estado entre workers
- Executa health check ativo a cada 5 segundos em uma porta dedicada
- Limita a página de status ao acesso pela rede interna
- Usa proxy_next_upstream para redirecionar requisições de servidores com falha para backends saudáveis
Conclusão
Voltando ao incidente daquele Duplo 11: depois dele, adicionamos zone ao upstream, configuramos max_fails e fail_timeout e, mais tarde, compilamos o nginx_upstream_check_module para health checks ativos. Quando um servidor cai, o Nginx detecta e remove em até 5 segundos; os usuários quase não recebem respostas de erro.
A escolha da estratégia de balanceamento cabe em uma frase: serviços sem estado usam round-robin ou least_conn; serviços com estado usam ip_hash ou hash. Para health check, produção precisa ter algum mecanismo. No Nginx open source, use nginx_upstream_check_module e não esqueça de proteger a página check_status com controle de acesso.
Se seu Nginx ainda está no round-robin padrão e sem health check, comece pelo passivo: max_fails + fail_timeout. É a menor mudança com efeito imediato. Depois de validar estabilidade, considere evoluir para health check ativo. Teste primeiro em ambiente de homologação, confirme a configuração e só então leve para produção.
FAQ
Para que serve a configuração zone no Nginx upstream?
Qual é a diferença entre health check passivo e ativo?
nginx_upstream_check_module ou NGINX Plus: qual é melhor?
Como escolher entre round-robin e least_conn no balanceamento de carga?
Como configurar os parâmetros rise e fall no health check?
Por que a página check_status precisa de controle de acesso?
13 min de leitura · Publicado em: 27 abr 2026 · Atualizado em: 14 jul 2026

Guia prático Nginx
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Como configurar SSL/TLS no Nginx e obter nota A+
Configure HTTPS no Nginx com certificados Let's Encrypt, TLS 1.3, hardening para nota A+ no SSL Labs, OCSP Stapling e renovação automática pelo Certbot.
Parte 3 de 6
Próximo
Upstream dinâmico no Nginx: descoberta de serviços em tempo real com Lua
Guia do upstream dinâmico com OpenResty: arquitetura em três camadas, comparação de health checks e integração com Consul, Nacos e etcd.
Parte 5 de 6


Comentários
Entre com GitHub para comentar