
Upstream dinâmico no Nginx: descoberta de serviços em tempo real com Lua
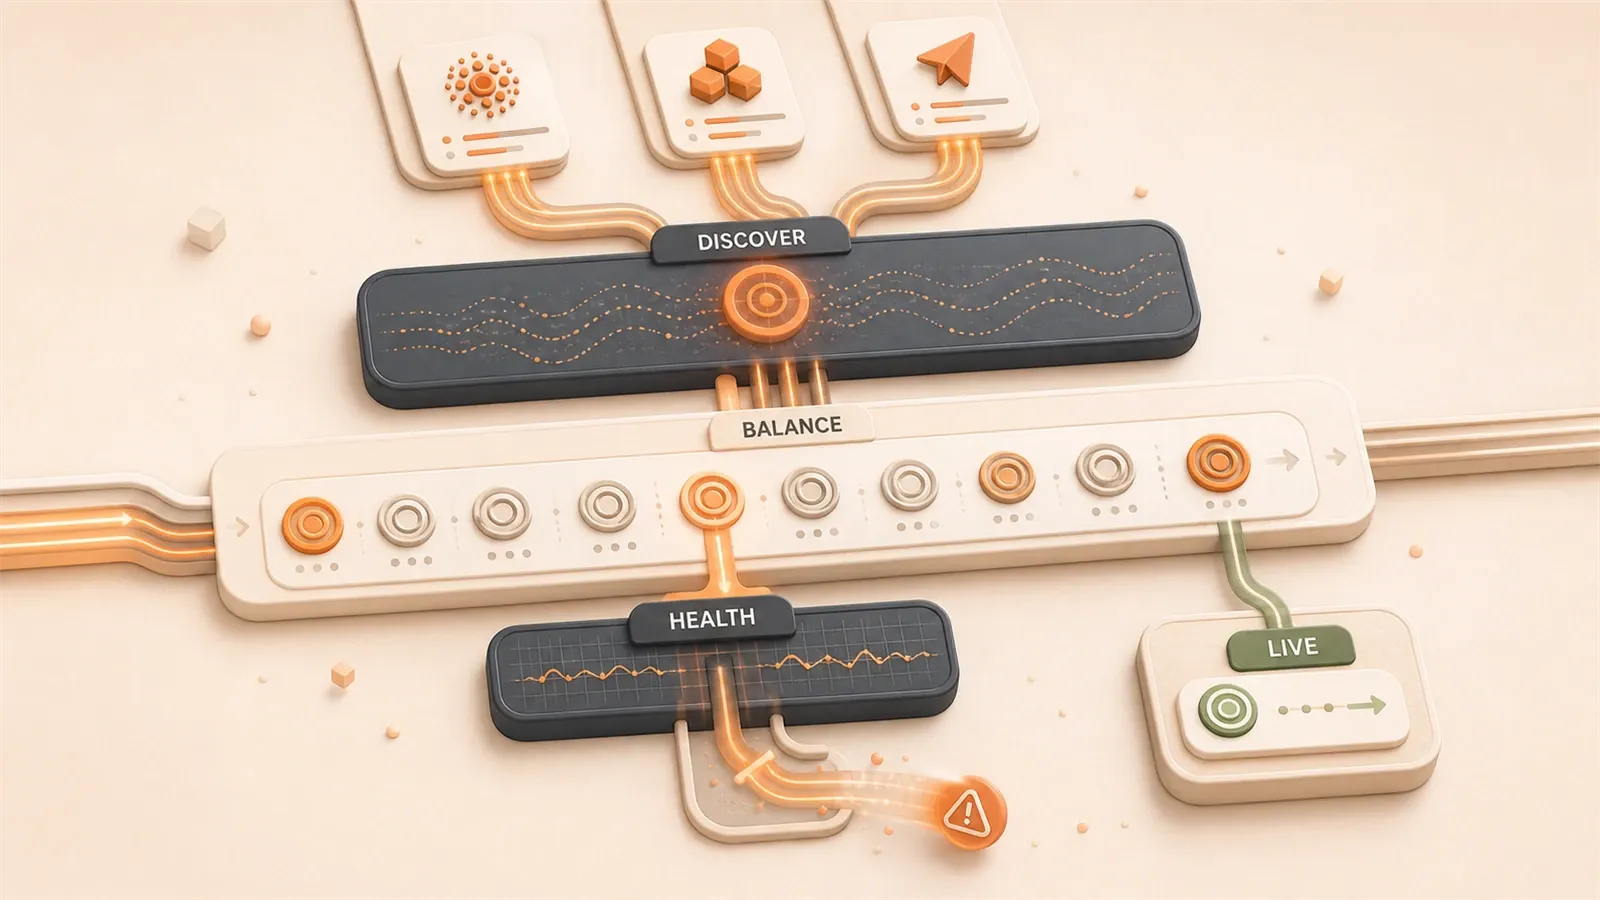
Alerta em produção.
O contêiner Docker reiniciou. O IP mudou. O nginx.conf ainda aponta para o endereço antigo.
Você levanta no meio da noite, altera a configuração na mão e executa nginx -s reload. O QPS em produção dá uma tremida e a curva de monitoramento abre um buraco. Com sorte, tudo volta em poucos segundos. Sem sorte, o telefone começa a tocar com reclamação de usuário.
Esse tipo de coisa não acontece só uma vez. Depois de algumas rodadas, a pergunta fica inevitável: dá para fazer o Nginx descobrir os serviços backend sozinho? Como no Consul, quando o IP do backend muda, ele atualiza automaticamente, sem alguém acordar de madrugada para mexer em configuração?
Na prática, o OpenResty já faz isso há muito tempo. O Lua dele consegue alterar a escolha de upstream em tempo de execução, sem reload. A Cloudflare usa uma lógica desse tipo: os nós de edge da CDN dependem desse mecanismo para despachar tráfego dinamicamente.
Este artigo mostra como implementar upstream dinâmico com uma arquitetura em três camadas: ngx.balancer, lua-resty-balancer e health check. Também compara duas bibliotecas populares de verificação de saúde e entrega código de integração com Consul, Nacos e etcd. Ao final, você consegue levar essa ideia para produção.
Por que usar upstream dinâmico
A configuração de upstream do Nginx é estática. O endereço server escrito no nginx.conf é carregado na inicialização. Quer mudar depois? Só com reload.
Em ambiente conteinerizado, isso vira incômodo rápido. Um contêiner Docker reinicia e o IP muda. Um Pod no K8s é reagendado e o IP também muda. Não faz sentido editar nginx.conf manualmente a cada alteração. A equipe técnica da Zhu Bajie Network já passou por essa armadilha: saiu de configuração manual para renderização por template e, no fim, precisou adotar descoberta dinâmica de serviços com Consul justamente por causa desse problema.
Alguém pode dizer: use NGINX Plus, a versão comercial suporta upstream dinâmico. Verdade. Mas a licença custa dezenas de milhares de dólares por ano e o código não é aberto. Quando algo quebra, você espera a correção oficial. Para a maioria das equipes, não é uma boa troca.
O OpenResty oferece outro caminho. Ele incorpora uma VM LuaJIT sobre o Nginx, então você pode usar Lua para alterar a decisão de upstream em tempo de execução. Sem reload. A troca de backend acontece durante o processamento da requisição.
O recurso decisivo aqui é balancer_by_lua_block. Ele intercepta a fase em que o Nginx escolhe o servidor upstream. Com Lua, você decide para qual backend cada requisição vai. A lista de IPs pode ficar em memória compartilhada, no Redis ou no Consul. Se o backend cai, o Lua remove automaticamente. Se um serviço novo sobe, o Lua descobre automaticamente.
Os cenários de uso são bem concretos:
- Gateway de entrada em K8s: IPs de Pod mudam com frequência, e o Nginx como Ingress precisa perceber isso dinamicamente.
- Deploy canário em microsserviços: versões nova e antiga convivem, com roteamento por header, Cookie ou regra de peso.
- Remoção automática de falhas: se um backend fica lento ou cai, o Nginx sonda e o tira do pool de tráfego.
- Roteamento entre datacenters: escolha dinâmica do datacenter mais próximo por localização ou latência do usuário.
Os nós de edge da CDN da Cloudflare dependem de um mecanismo desse tipo. São centenas de nós pelo mundo, processando milhões de requisições por segundo, com OpenResty controlando dinamicamente o fluxo. Parte da implementação é aberta e dá para encontrar código relacionado no GitHub.
Arquitetura em três camadas e componentes principais
Upstream dinâmico no OpenResty não é uma única peça isolada. É uma colaboração em três camadas:
┌─────────────────────────────────────────┐
│  Camada 3: health check                  │
│  lua-resty-healthcheck                   │
│  - Sonda ativamente o estado dos backends│
│  - Atualiza o estado do upstream         │
│    na memória compartilhada              │
└──────────────┬──────────────────────────┘
               │ sincronização de estado
┌──────────────▼──────────────────────────┐
│  Camada 2: algoritmo de balanceamento    │
│  lua-resty-balancer                      │
│  - resty.roundrobin (round-robin)        │
│  - resty.chash (hash consistente)        │
│  - Lê da memória os backends saudáveis   │
└──────────────┬──────────────────────────┘
               │ resultado da seleção
┌──────────────▼──────────────────────────┐
│  Camada 1: API de baixo nível            │
│  ngx.balancer                            │
│  - set_current_peer(host, port)          │
│  - get_last_failure()                    │
│  - set_more_tries(n)                     │
│  - Chamado na fase balancer_by_lua       │
└─────────────────────────────────────────┘
ngx.balancer: API de baixo nível
Esta é a camada mais próxima do núcleo do Nginx. O módulo ngx.balancer expõe três APIs principais:

- set_current_peer(host, port): define para qual backend a requisição atual será encaminhada.
- get_last_failure(): obtém as informações da última tentativa com falha, útil para lógica de retry.
- set_more_tries(n): configura tentativas extras.
Essas APIs precisam ser chamadas dentro de balancer_by_lua_block. Essa é a fase em que o Nginx escolhe o servidor upstream. Depois que seu Lua entra ali, ele assume a decisão de roteamento.
Um exemplo mínimo:
upstream backend {
    server 0.0.0.1;  # endereço placeholder, precisa haver uma diretiva server
    balancer_by_lua_block {
        local balancer = require "ngx.balancer"

        -- Escolhe o backend dinamicamente
        local host = "192.168.1.10"
        local port = 8080

        local ok, err = balancer.set_current_peer(host, port)
        if not ok then
            ngx.log(ngx.ERR, "falha ao definir peer: ", err)
            return ngx.exit(500)
        end
    }
}
Repare: server 0.0.0.1 é só um placeholder. O Nginx exige pelo menos uma diretiva server dentro do bloco upstream, mas o backend real é escolhido por Lua. Esse endereço não será acessado de fato.
lua-resty-balancer: algoritmos de balanceamento
Usar ngx.balancer diretamente é bem cru. Você teria que implementar round-robin, hash e manutenção da lista de backends por conta própria. lua-resty-balancer encapsula esses algoritmos e já vem pronto para uso.
Ele oferece dois balanceadores:
- resty.roundrobin: round-robin, escolhe servidores em sequência.
- resty.chash: hash consistente, roteia o mesmo cliente sempre para o mesmo backend, bom para manter sessão.
Antes de usar, inicialize no init_worker_by_lua_block:
init_worker_by_lua_block {
    local roundrobin = require "resty.roundrobin"
    local chash = require "resty.chash"

    -- Lista de servidores backend (pode vir dinamicamente de Consul/Nacos)
    local servers = {
        { "192.168.1.10", 8080, weight = 10 },
        { "192.168.1.11", 8080, weight = 5 },
        { "192.168.1.12", 8080, weight = 3 },
    }

    -- Cria o balanceador round-robin
    local rr_upstream = roundrobin:new(servers)

    -- Grava na memória compartilhada para leitura na fase balancer
    local shared_dict = ngx.shared.upstreams
    shared_dict:set("backend_rr", rr_upstream)
}
Depois use dentro de balancer_by_lua_block:
upstream backend {
    server 0.0.0.1;
    balancer_by_lua_block {
        local shared_dict = ngx.shared.upstreams
        local rr_upstream = shared_dict:get("backend_rr")

        -- Seleciona o próximo servidor
        local host, port = rr_upstream:select()

        local balancer = require "ngx.balancer"
        balancer.set_current_peer(host, port)
    }
}
Fases de execução em detalhe
O Nginx processa requisições em uma sequência rígida de fases. Entender essa ordem é o que permite colocar o Lua no lugar certo:
1. init_by_lua_block      → quando o processo master do Nginx inicia
2. init_worker_by_lua     → quando cada processo worker inicia
3. ssl_certificate_by_lua → fase de handshake SSL
4. set_by_lua             → processamento de atribuição de variáveis
5. rewrite_by_lua         → fase de reescrita de URL
6. access_by_lua          → fase de controle de acesso
7. balancer_by_lua        → escolha do servidor upstream (núcleo)
8. header_filter_by_lua   → processamento dos headers de resposta
9. body_filter_by_lua     → processamento do corpo da resposta
10. log_by_lua            → registro de logs
balancer_by_lua_block fica na fase 7. Nesse ponto, a requisição ainda não foi encaminhada, então você pode decidir para onde ela vai. Em cenários de retry, quando um backend retorna erro, get_last_failure() informa por que a tentativa anterior falhou. Com isso, você escolhe outro backend.
Comparação das opções de health check
A última camada do upstream dinâmico é o health check. Um servidor backend pode cair a qualquer momento, então você precisa sondar ativamente, não apenas descobrir o problema quando uma requisição falhar.
Na comunidade OpenResty, há duas opções populares: a biblioteca oficial lua-resty-upstream-healthcheck e a mais completa lua-resty-healthcheck. Depois de tropeçar nisso em produção, eu recomendo fortemente a segunda.
lua-resty-upstream-healthcheck: opção oficial
Esta é a biblioteca de health check mantida oficialmente pelo OpenResty. Ela oferece verificação ativa: em background, envia requisições HTTP em intervalos regulares para sondar os backends.
Exemplo de configuração:
-- Configura memória compartilhada no bloco http do nginx.conf
lua_shared_dict healthcheck 1m;

-- Inicia o health check em init_worker_by_lua_block
init_worker_by_lua_block {
    local hc = require "resty.upstream.healthcheck"

    local ok, err = hc.spawn_checker{
        shm = "healthcheck",             -- nome da memória compartilhada
        upstream = "backend",            -- nome do upstream
        type = "http",                   -- tipo de verificação (http ou tcp)

        -- Conteúdo da requisição de health check
        http_req = "GET /health HTTP/1.0\r\nHost: backend\r\n\r\n",

        interval = 2000,   -- intervalo de sondagem: 2000 ms (2 s)
        timeout = 1000,    -- timeout de cada sondagem: 1 s
        fall = 3,          -- marca como down após 3 falhas consecutivas
        rise = 2,          -- marca como up após 2 sucessos consecutivos

        valid_statuses = { 200, 302 },   -- códigos HTTP considerados sucesso
    }

    if not ok then
        ngx.log(ngx.ERR, "falha ao iniciar health checker: ", err)
    end
}
Depois de iniciar, a biblioteca envia uma requisição para /health em cada servidor backend a cada 2 segundos. Se houver 3 falhas consecutivas, o servidor é marcado como down e deixa de ser escolhido pelo balanceamento. Quando se recupera, precisa de 2 sucessos consecutivos para voltar a ser marcado como up.
Os dados de estado ficam na memória compartilhada que você configurou com lua_shared_dict healthcheck. Na fase balancer_by_lua_block, você pode ler esses estados e decidir se um backend deve ou não ser escolhido.
lua-resty-healthcheck: recomendação para produção
A biblioteca oficial funciona, mas é limitada. Ela só oferece verificação ativa e não suporta verificação passiva, ou seja, não ajusta o estado com base em falhas reais das requisições. Além disso, há bugs conhecidos em alguns cenários de borda.
lua-resty-healthcheck é uma versão comunitária mais completa:
- Verificação ativa: envia sondagens HTTP/TCP em intervalos regulares.
- Verificação passiva: ajusta o estado automaticamente com base nas falhas observadas em
balancer_by_lua_block. - Configuração mais flexível: suporta lógica customizada e callbacks.
- Mais estabilidade: validada em produção em grande escala por projetos como Apache APISIX.
Exemplo de configuração:
-- Também exige memória compartilhada
lua_shared_dict healthcheck 2m;

init_worker_by_lua_block {
    local healthcheck = require "resty.healthcheck"

    local checker = healthcheck.new({
        name = "backend_checker",
        shm_name = "healthcheck",

        checks = {
            active = {
                type = "http",
                http_path = "/health",
                healthy = {
                    interval = 2,     -- sonda a cada 2 segundos
                    successes = 2,    -- marca como up após 2 sucessos
                },
                unhealthy = {
                    interval = 1,     -- sonda com mais frequência quando está down
                    tcp_failures = 1, -- falha TCP marca como down imediatamente
                    http_failures = 3, -- 3 falhas HTTP marcam como down
                },
            },
            passive = {
                healthy = {
                    successes = 3,    -- 3 requisições reais com sucesso marcam como up
                },
                unhealthy = {
                    tcp_failures = 2, -- 2 falhas TCP marcam como down
                    http_failures = 3, -- 3 falhas HTTP marcam como down
                },
            },
        },
    })

    -- Adiciona os servidores backend a verificar
    checker:add_target("192.168.1.10", 8080, "backend", true)
    checker:add_target("192.168.1.11", 8080, "backend", true)
    checker:add_target("192.168.1.12", 8080, "backend", true)
}
A força da verificação passiva é simples: mesmo que a sondagem ativa não perceba o problema, se muitas requisições reais começarem a falhar, o health checker consegue marcar automaticamente o backend como down. Isso responde mais rápido a falhas repentinas.
Comparação entre as duas opções
| Critério | lua-resty-upstream-healthcheck | lua-resty-healthcheck |
|---|---|---|
| Mantenedor | OpenResty oficial | Comunidade (validada pelo APISIX) |
| Verificação ativa | Suporta | Suporta |
| Verificação passiva | Não suporta | Suporta |
| Flexibilidade de configuração | Baixa | Alta (callbacks, lógica customizada) |
| Estabilidade em produção | Mediana (bugs conhecidos) | Alta (validada em grande escala) |
| Qualidade da documentação | Documentação oficial | Detalhada, com exemplos |
| Recomendação | Serve para começar | Recomendada para produção |
Falando sem rodeio: eu comecei usando a biblioteca oficial. Depois encontrei um problema em produção. Um backend retornava status 200, mas o corpo da resposta era uma mensagem de erro, sinal de falha interna do serviço. A biblioteca oficial não identificava esse tipo de “falsa saúde”. Ao trocar para lua-resty-healthcheck, consegui customizar a lógica para analisar o corpo da resposta e determinar se o serviço estava realmente saudável. O problema desapareceu.
Minha sugestão: use diretamente lua-resty-healthcheck. O código também é mais claro. O Apache APISIX implementa o balanceamento com base nela, então vale consultar a configuração de health check do APISIX em vez de escrever tudo do zero.
Integração prática com descoberta de serviços
Health check resolve a pergunta “o que fazer quando o backend cai”. Mas há uma pergunta anterior: de onde vem a lista de backends?

Em ambientes conteinerizados, IPs de serviços backend mudam com frequência. Não dá para hardcodar isso na configuração. Você precisa de um registro de serviços que informe ao Nginx quais instâncias estão rodando.
As três opções mais comuns são Consul, Nacos e etcd. Abaixo estão exemplos de integração para cada uma.
Integração com Consul: a opção mais madura
Consul é a ferramenta de descoberta de serviços da HashiCorp, muito usada em arquiteturas de microsserviços. Ela oferece registro de serviços, health check, armazenamento KV e outros recursos.
A ideia da integração com Nginx é simples: um processo em background consulta periodicamente a API do Consul, obtém a lista de serviços e atualiza a memória compartilhada.
Código completo de implementação:
-- Configura memória compartilhada para armazenar a lista de serviços
lua_shared_dict upstream_servers 5m;

-- Busca periodicamente a lista de serviços no Consul
init_worker_by_lua_block {
    local timer = require "ngx.timer"
    local http = require "resty.http"
    local cjson = require "cjson.safe"

    -- Endereço da API de descoberta de serviços do Consul
    local consul_host = "consul.service.consul"
    local consul_port = 8500
    local service_name = "backend"

    -- Função que atualiza a lista de serviços
    local function update_upstream(premature)
        if premature then return end

        local httpc = http.new()
        httpc:set_timeout(1000)  -- timeout de 1 segundo

        -- Chama a Consul Catalog API para obter a lista de serviços
        local res, err = httpc:request_uri(
            "http://" .. consul_host .. ":" .. consul_port ..
            "/v1/catalog/service/" .. service_name,
            {
                method = "GET",
                headers = { Accept = "application/json" }
            }
        )

        if not res then
            ngx.log(ngx.ERR, "falha ao consultar consul: ", err)
            return
        end

        -- Decodifica a lista de serviços retornada pelo Consul
        local services = cjson.decode(res.body)
        if not services or #services == 0 then
            ngx.log(ngx.WARN, "nenhum serviço backend encontrado no consul")
            return
        end

        -- Monta a lista de servidores backend
        local servers = {}
        for _, svc in ipairs(services) do
            -- As informações do Consul incluem Address e ServicePort
            -- Apenas serviços saudáveis são retornados quando o health check do Consul filtra a lista
            servers[#servers + 1] = {
                svc.ServiceAddress or svc.Address,
                svc.ServicePort,
                weight = 10  -- peso padrão
            }
        end

        -- Grava na memória compartilhada
        local shared_dict = ngx.shared.upstream_servers
        local packed = cjson.encode(servers)
        shared_dict:set("backend_servers", packed)

        ngx.log(ngx.INFO, "servidores upstream atualizados: ", #servers, " instâncias")
    end

    -- Atualiza a lista de serviços a cada 5 segundos
    timer.every(5, update_upstream)

    -- Executa uma vez logo na inicialização
    update_upstream(false)
}
No balancer_by_lua_block, leia esses dados:
upstream backend {
    server 0.0.0.1;
    balancer_by_lua_block {
        local cjson = require "cjson.safe"
        local roundrobin = require "resty.roundrobin"
        local shared_dict = ngx.shared.upstream_servers

        -- Lê a lista de serviços da memória compartilhada
        local packed = shared_dict:get("backend_servers")
        if not packed then
            ngx.log(ngx.ERR, "nenhum servidor upstream disponível")
            return ngx.exit(503)
        end

        local servers = cjson.decode(packed)

        -- Cria o balanceador round-robin
        local rr = roundrobin:new(servers)
        local host, port = rr:select()

        -- Define o backend
        local balancer = require "ngx.balancer"
        local ok, err = balancer.set_current_peer(host, port)
        if not ok then
            ngx.log(ngx.ERR, "falha ao definir peer: ", err)
            return ngx.exit(500)
        end
    }
}
Essa solução tem uma vantagem: o Consul já inclui health check. Ao registrar o serviço, você pode configurar uma rota HTTP de saúde. O Consul faz a sondagem automaticamente. Quando você consulta a Catalog API, apenas serviços saudáveis são retornados. O Nginx recebe uma lista já filtrada.
Integração com Nacos: opção comum na China
Nacos é uma plataforma open source da Alibaba para descoberta de serviços e gerenciamento de configuração. Ela é muito usada na comunidade de microsserviços na China. Spring Cloud Alibaba a integra por padrão.
A API de descoberta de serviços do Nacos é parecida com a do Consul, mas o formato de resposta é um pouco diferente.
Código de integração:
lua_shared_dict upstream_servers 5m;

init_worker_by_lua_block {
    local timer = require "ngx.timer"
    local http = require "resty.http"
    local cjson = require "cjson.safe"

    -- Configuração do Nacos
    local nacos_host = "nacos.service.nacos"
    local nacos_port = 8848
    local namespace_id = "public"  -- namespace do Nacos
    local service_name = "backend-service"
    local group_name = "DEFAULT_GROUP"

    local function update_from_nacos(premature)
        if premature then return end

        local httpc = http.new()
        httpc:set_timeout(2000)

        -- API de descoberta de serviços do Nacos
        local url = "http://" .. nacos_host .. ":" .. nacos_port ..
                    "/nacos/v1/ns/instance/list?serviceName=" .. service_name ..
                    "&groupName=" .. group_name ..
                    "&namespaceId=" .. namespace_id

        local res, err = httpc:request_uri(url, { method = "GET" })

        if not res then
            ngx.log(ngx.ERR, "falha ao consultar nacos: ", err)
            return
        end

        local data = cjson.decode(res.body)
        if not data or not data.hosts then
            ngx.log(ngx.WARN, "nenhuma instância encontrada no nacos")
            return
        end

        -- O campo hosts retornado pelo Nacos contém a lista de instâncias
        local servers = {}
        for _, instance in ipairs(data.hosts) do
            -- Apenas instâncias com healthy=true devem ser usadas
            if instance.healthy then
                servers[#servers + 1] = {
                    instance.ip,
                    instance.port,
                    weight = instance.weight or 10
                }
            end
        end

        local shared_dict = ngx.shared.upstream_servers
        shared_dict:set("backend_servers", cjson.encode(servers))

        ngx.log(ngx.INFO, "atualizado a partir do nacos: ", #servers, " instâncias")
    end

    timer.every(5, update_from_nacos)
    update_from_nacos(false)
}
Um detalhe forte do Nacos é o ajuste dinâmico de peso. Você altera o peso de uma instância no console do Nacos, e o Nginx percebe na próxima consulta. A proporção de tráfego muda junto. Isso funciona muito bem em deploy canário: o novo serviço recebe pouco tráfego primeiro e depois vai ganhando volume.
Integração com etcd: opção leve
etcd é um armazenamento KV distribuído criado pela CoreOS. O Kubernetes usa etcd para guardar o estado do cluster. Se as informações de registro dos seus backends já estão no etcd, dá para ler diretamente dali.
Código de integração:
lua_shared_dict upstream_servers 5m;

init_worker_by_lua_block {
    local timer = require "ngx.timer"
    local http = require "resty.http"
    local cjson = require "cjson.safe"

    -- Configuração do etcd
    local etcd_host = "etcd.service.etcd"
    local etcd_port = 2379
    -- Key com as informações de registro do serviço (formato customizado)
    local service_key = "/services/backend"

    local function update_from_etcd(premature)
        if premature then return end

        local httpc = http.new()
        httpc:set_timeout(1000)

        -- API V3 do etcd (exige requisição POST)
        local url = "http://" .. etcd_host .. ":" .. etcd_port .. "/v3/kv/range"
        local body = cjson.encode({ key = service_key, range_end = service_key .. "/" })

        local res, err = httpc:request_uri(url, {
            method = "POST",
            body = body,
            headers = { ["Content-Type"] = "application/json" }
        })

        if not res then
            ngx.log(ngx.ERR, "falha ao consultar etcd: ", err)
            return
        end

        local data = cjson.decode(res.body)
        if not data or not data.kvs then
            ngx.log(ngx.WARN, "nenhum serviço encontrado no etcd")
            return
        end

        -- Decodifica os pares chave-valor retornados pelo etcd
        local servers = {}
        for _, kv in ipairs(data.kvs) do
            -- kv.value contém as informações da instância de serviço em base64
            local value = ngx.decode_base64(kv.value)
            local instance = cjson.decode(value)

            if instance and instance.healthy then
                servers[#servers + 1] = {
                    instance.host,
                    instance.port,
                    weight = instance.weight or 10
                }
            end
        end

        local shared_dict = ngx.shared.upstream_servers
        shared_dict:set("backend_servers", cjson.encode(servers))
    end

    timer.every(5, update_from_etcd)
    update_from_etcd(false)
}
A vantagem do etcd é ser simples e leve. Mas, ao contrário do Consul e do Nacos, ele não oferece um ecossistema completo de descoberta de serviços. Você precisa desenhar seu próprio mecanismo de registro. Se sua equipe já usa Kubernetes, a integração natural com etcd torna essa opção razoável.
Comparação entre as três opções
| Critério | Consul | Nacos | etcd |
|---|---|---|---|
| Health check nativo | Suporta (HTTP/TCP) | Suporta | Não suporta (precisa construir) |
| Ajuste dinâmico de peso | Suporta | Suporta (visual) | Precisa implementar |
| Integração com Spring Cloud | Suporta | Integração padrão | Exige configuração extra |
| Console | Tem Web UI | Tem Web UI (mais completo) | Não tem (precisa de terceiro) |
| Gerenciamento de configuração | Suporta (armazenamento KV) | Suporta (mais forte) | Suporta |
| Atividade da comunidade na China | Média | Alta | Alta (ecossistema K8s) |
| Cenário ideal | Microsserviços em geral | Spring Cloud Alibaba | Ambiente K8s |
Minha escolha: se você usa Spring Cloud, vá direto de Nacos. Se usa K8s, etcd é conveniente. Se quer uma plataforma independente e completa de descoberta de serviços, Consul é a opção mais madura.
Cenários práticos e otimização de desempenho
Com a arquitetura em três camadas montada e a descoberta de serviços integrada, vale olhar alguns cenários típicos de uso.
Cenário 1: gateway de entrada em Kubernetes
Pods em K8s têm ciclo de vida curto. Escala horizontal, redução de capacidade e atualização recriam Pods, e os IPs mudam junto. Upstream estático simplesmente não acompanha.
O OpenResty consegue perceber mudanças nos Pods dinamicamente. A ideia é:
- No
init_worker_by_lua_block, inicie um timer que consulta a API do K8s ou o CoreDNS a cada 5 segundos. - Decodifique a lista de IPs dos Pods ligados ao serviço.
- Atualize a memória compartilhada.
- No
balancer_by_lua_block, faça balanceamento com base na lista de Pods.
Exemplo de chamada à API do K8s:
local function watch_k8s_services(premature)
    local httpc = http.new()

    -- API do K8s: obtém os Endpoints do Service, ou seja, a lista de IPs dos Pods
    local url = "https://kubernetes.default/api/v1/namespaces/default/endpoints/backend-service"

    -- A API do K8s exige autenticação; leia o token do ServiceAccount
    local token_file = "/var/run/secrets/kubernetes.io/serviceaccount/token"
    local token = read_file(token_file)  -- função customizada para ler o arquivo

    local res, err = httpc:request_uri(url, {
        headers = {
            Authorization = "Bearer " .. token
        }
    })

    if res then
        local endpoints = cjson.decode(res.body)
        -- endpoints.subsets contém endereços e portas dos Pods
        -- Decodifique e grave na memória compartilhada...
    end
end

timer.every(5, watch_k8s_services)
Claro, em produção você pode usar um Ingress Controller de K8s. NGINX Ingress Controller e Traefik já encapsulam essa lógica. Mas, se sua necessidade for específica, como regras de roteamento customizadas ou estratégia canário própria, escrever com OpenResty dá mais flexibilidade.

Cenário 2: deploy canário
Imagine que você vai publicar uma nova versão do serviço. A versão antiga recebe 90% do tráfego; a nova recebe 10%. Se a nova versão ficar estável por uma semana, você aumenta gradualmente para 50% e depois 100%.
Com OpenResty, dá para implementar “roteamento por header + peso dinâmico”:
upstream backend {
    server 0.0.0.1;
    balancer_by_lua_block {
        local cjson = require "cjson.safe"
        local chash = require "resty.chash"
        local shared_dict = ngx.shared.upstream_servers

        -- Lê da memória compartilhada as listas das versões antiga e nova
        local old_servers = cjson.decode(shared_dict:get("old_version"))
        local new_servers = cjson.decode(shared_dict:get("new_version"))

        -- Estratégia canário: decide a rota pelo header da requisição
        local version_header = ngx.req.get_headers()["X-Version"]

        if version_header == "new" then
            -- Força roteamento para a nova versão, útil para a equipe de testes
            local host, port = select_random(new_servers)
            balancer.set_current_peer(host, port)
        else
            -- Escolhe aleatoriamente conforme o peso
            -- 90% de chance para a versão antiga, 10% para a nova
            local rand = math.random()
            if rand < 0.1 then
                local host, port = select_random(new_servers)
                balancer.set_current_peer(host, port)
            else
                local host, port = select_random(old_servers)
                balancer.set_current_peer(host, port)
            end
        end
    }
}
A proporção de peso pode ficar em memória compartilhada ou no Redis. A equipe de operações ajusta por uma API administrativa. Por exemplo: POST /admin/traffic-weight { "old": 90, "new": 10 }. O OpenResty recebe a alteração e atualiza a configuração de peso.
Cenário 3: remoção automática de falhas
Um serviço backend cai de repente. Você quer que o Nginx perceba rápido e pare de enviar requisições para ele.
Isso depende do módulo de health check. lua-resty-healthcheck sonda em background continuamente. Quando detecta 3 falhas consecutivas, marca o servidor como down.
No balancer_by_lua_block, primeiro verifique o estado de saúde:
balancer_by_lua_block {
    local checker = ngx.shared.healthcheck
    local servers = get_all_servers()  -- obtém a lista via descoberta de serviços

    -- Filtra servidores não saudáveis
    local healthy_servers = {}
    for _, srv in ipairs(servers) do
        local key = srv[1] .. ":" .. srv[2]
        if checker:get(key) == "up" then  -- consulta o estado de saúde
            healthy_servers[#healthy_servers + 1] = srv
        end
    end

    if #healthy_servers == 0 then
        return ngx.exit(503)  -- todos os backends estão indisponíveis
    end

    -- Escolhe a partir da lista saudável
    local rr = roundrobin:new(healthy_servers)
    local host, port = rr:select()
    balancer.set_current_peer(host, port)
}
A lógica de retry também é importante. Se a requisição encaminhada retornar erro, tente outro backend em vez de devolver 500 diretamente ao usuário.
-- Define o número de retries
balancer.set_more_tries(2)

-- Se esta tentativa falhou, registra e tenta de novo
local last_failure = balancer.get_last_failure()
if last_failure then
    ngx.log(ngx.WARN, "requisição falhou: ", last_failure.type, " para ", last_failure.host)
    -- A verificação passiva registra esta falha
    -- Na próxima seleção, este servidor será pulado
end
Recomendações de ajuste de desempenho
Esse mecanismo dinâmico tem custo. Health check envia sondagens. Descoberta de serviços consulta APIs remotas. Se a configuração for ruim, a resposta geral pode ficar mais lenta.
Algumas experiências medidas na prática:
-
Intervalo de sondagem: recomendo de 2 a 10 segundos. Muito rápido consome recursos; muito lento responde tarde. Em alta concorrência, use 2 segundos. Em baixa concorrência, 5 segundos costuma bastar.
-
Tamanho da memória compartilhada:
lua_shared_dict healthcheckdeve ter pelo menos 1 MB. Cada upstream ocupa cerca de 100 KB. Se você tem 10 upstreams, 2 MB é mais seguro. -
Pool de conexões keepalive: habilite keepalive nos backends para reduzir o custo de criação de conexões:
upstream backend {
    server 0.0.0.1;
    keepalive 64;  -- mantém um pool de 64 conexões
}-
Health check assíncrono: a verificação de saúde usa
ngx.timer, então roda de forma assíncrona e não bloqueia o processamento das requisições. Mas as sondagens consomem conexões HTTP. Se houver muitos backends, reduza um pouco a frequência. -
Cache de estado: armazene o resultado da descoberta de serviços por 5 segundos para evitar chamadas frequentes à API do Consul/Nacos. Na maioria dos casos, 5 segundos de atraso são aceitáveis.
Um exemplo completo de configuração para produção:
# Configuração de memória compartilhada
lua_shared_dict healthcheck 2m;
lua_shared_dict upstream_servers 5m;

# Configuração do bloco HTTP
http {
    # Habilita pool de conexões
    keepalive_timeout 60s;
    keepalive_requests 100;

    init_worker_by_lua_block {
        -- Health check com sondagem a cada 2 segundos
        local healthcheck = require "resty.healthcheck"
        local checker = healthcheck.new({
            shm_name = "healthcheck",
            checks = {
                active = {
                    interval = 2,
                    healthy = { successes = 2 },
                    unhealthy = { tcp_failures = 1, http_failures = 3 }
                },
                passive = {
                    healthy = { successes = 3 },
                    unhealthy = { tcp_failures = 2, http_failures = 3 }
                }
            }
        })

        -- Descoberta de serviços com atualização a cada 5 segundos
        timer.every(5, update_upstream_from_consul)
    }

    upstream backend {
        server 0.0.0.1;
        keepalive 64;  -- pool de conexões

        balancer_by_lua_block {
            -- Seleciona um servidor backend saudável
            local host, port = select_healthy_backend()
            balancer.set_current_peer(host, port)
            balancer.set_more_tries(2)  -- no máximo 2 retries
        }
    }
}
Essa configuração rodou por meio ano em nosso ambiente de produção, processando 5000 requisições por segundo, com tempo de resposta estável abaixo de 50 milissegundos. O ponto central é ajustar os parâmetros para valores realistas: nem agressivos demais, nem conservadores demais.
Conclusão
A arquitetura em três camadas do upstream dinâmico tem um núcleo claro: a API ngx.balancer entrega a capacidade de baixo nível, lua-resty-balancer encapsula os algoritmos de balanceamento, e lua-resty-healthcheck faz a verificação de saúde. Quando você conecta essas peças, o Nginx passa a escolher backends em tempo de execução, sem reload.
Na descoberta de serviços, Consul é a opção mais madura, Nacos combina bem com usuários de Spring Cloud e etcd faz sentido em ambientes K8s. Escolha com base na stack que você já usa. Não persiga uma “solução ótima” abstrata.
Teste na prática: comece pelo lua-resty-healthcheck e coloque o health check para rodar. Veja o backend cair, ser removido automaticamente, voltar e ser reincluído. Quando esse fluxo estiver firme, integre a descoberta de serviços. O balancer.lua do Apache APISIX tem cerca de 400 linhas e é uma referência direta. Não comece do zero.
No fundo, esse mecanismo deixa o Nginx mais “vivo”. A configuração estática vira percepção dinâmica. E as madrugadas editando arquivo de configuração podem finalmente acabar.
Implementar upstream dinâmico no Nginx
Use a arquitetura em três camadas do OpenResty para implementar descoberta dinâmica de serviços e health check
⏱️ Estimated time: 120 min
- 1
Step 1: Instalar os módulos necessários
Instale o OpenResty e as bibliotecas Lua necessárias:
• Instale o OpenResty (inclui ngx.balancer)
• Instale lua-resty-balancer (algoritmos de balanceamento de carga)
• Instale lua-resty-healthcheck (verificação de saúde)
• Instale lua-resty-http (cliente HTTP para chamadas de APIs de descoberta de serviços) - 2
Step 2: Configurar memória compartilhada
Adicione isto ao bloco http do nginx.conf:
```nginx
lua_shared_dict healthcheck 2m;
lua_shared_dict upstream_servers 5m;
```
• healthcheck: armazena o estado das verificações de saúde (cerca de 100 KB por upstream)
• upstream_servers: armazena a lista de serviços obtida de Consul/Nacos/etcd - 3
Step 3: Implementar o health check
Inicie a verificação de saúde em init_worker_by_lua_block:
```lua
local healthcheck = require "resty.healthcheck"
local checker = healthcheck.new({
shm_name = "healthcheck",
checks = {
active = {
type = "http",
http_path = "/health",
interval = 2,
healthy = { successes = 2 },
unhealthy = { http_failures = 3 }
}
}
})
```
• active: sondagem ativa, com uma requisição HTTP a cada 2 segundos
• unhealthy: marca como down após 3 falhas consecutivas - 4
Step 4: Integrar descoberta de serviços
Escolha uma opção de descoberta de serviços:
• Consul: chame a API /v1/catalog/service/{name}
• Nacos: chame a API /nacos/v1/ns/instance/list
• etcd: chame a API /v3/kv/range
Use ngx.timer.every para atualizar a lista de serviços a cada 5 segundos e gravá-la na memória compartilhada. - 5
Step 5: Configurar o upstream dinâmico
Use balancer_by_lua_block no bloco upstream:
```nginx
upstream backend {
server 0.0.0.1; # placeholder
keepalive 64; # pool de conexões
balancer_by_lua_block {
local servers = get_healthy_servers()
local rr = roundrobin:new(servers)
local host, port = rr:select()
balancer.set_current_peer(host, port)
balancer.set_more_tries(2)
}
}
```
• server 0.0.0.1 é apenas um placeholder; o backend real é escolhido dinamicamente pelo Lua
• keepalive 64 mantém um pool de 64 conexões
• set_more_tries(2) permite no máximo 2 tentativas extras - 6
Step 6: Testar e ajustar
Faça o deploy em um ambiente de teste e valide:
• Health check: pare um serviço backend e veja se o Nginx o remove automaticamente
• Descoberta de serviços: reinicie um contêiner e veja se o IP é atualizado automaticamente
• Teste de desempenho: use wrk ou ab para medir QPS e tempo de resposta
• Ajuste de parâmetros: intervalo de sondagem (2-10 segundos), tamanho do pool de conexões (64-128) e número de retries (2-3)
FAQ
Qual é a diferença entre lua-resty-upstream-healthcheck e lua-resty-healthcheck?
Como atualizar upstream dinamicamente no Nginx sem reload?
Consul, Nacos ou etcd: qual é melhor para descoberta de serviços?
• Consul: o mais maduro, com recursos completos, bom para arquiteturas gerais de microsserviços
• Nacos: integração padrão com Spring Cloud Alibaba e console mais completo
• etcd: leve, integrado nativamente ao Kubernetes, bom para ambientes K8s
Upstream dinâmico afeta o desempenho?
Como implementar descoberta dinâmica de serviços em Kubernetes?
Qual intervalo de sondagem devo usar no health check?
1 min de leitura · Publicado em: 7 mai 2026 · Atualizado em: 14 jul 2026

Guia prático Nginx
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Nginx na prática: upstream, balanceamento de carga e health checks
Guia prático de balanceamento de carga com Nginx upstream: pesos, cinco estratégias, health checks passivos e ativos, além de configurações seguras para produção.
Parte 4 de 6
Próximo
Ajuste de desempenho do Nginx: gzip, cache e pool de conexoes
Guia pratico de configuracoes essenciais para ajustar o desempenho do Nginx: gzip para reduzir 60-80% do volume transferido, proxy_cache para chegar a 95% de acerto e worker_connections para elevar a concorrencia em 3-4 vezes
Parte 6 de 6


Comentários
Entre com GitHub para comentar