
Cloudflare D1 na prática: SQLite no edge e replicação global
0,01 milissegundo.
Esse é o tempo que o SQLite leva para ler uma linha localmente. A mesma consulta no Cloudflare D1 fica por volta de 0,5 milissegundo, enquanto um acesso entre regiões ao PostgreSQL pode levar de 1 a 3 milissegundos. Parece pouca diferença? Mas, se o seu usuário está em Tóquio e o banco está na Virgínia, só a ida e volta da rede já consome mais de 100 milissegundos.
No ano passado, em um projeto com deploy global, fiquei preso exatamente nesse problema. Bancos tradicionais obrigavam a aceitar alta latência ou montar uma separação complexa entre leitura e escrita. Quando a Cloudflare lançou a replicação global do D1 na Developer Week de 2025, a conversa ficou bem mais interessante.
Neste texto, vou destrinchar como o D1 leva SQLite para o edge, como aqueles conceitos que parecem abstratos — Durable Objects, timestamps de Lamport, Sessions API — se comportam na prática, e em que casos ele merece entrar na sua lista ou ficar de fora.
1. O que é D1: SQLite rodando no edge
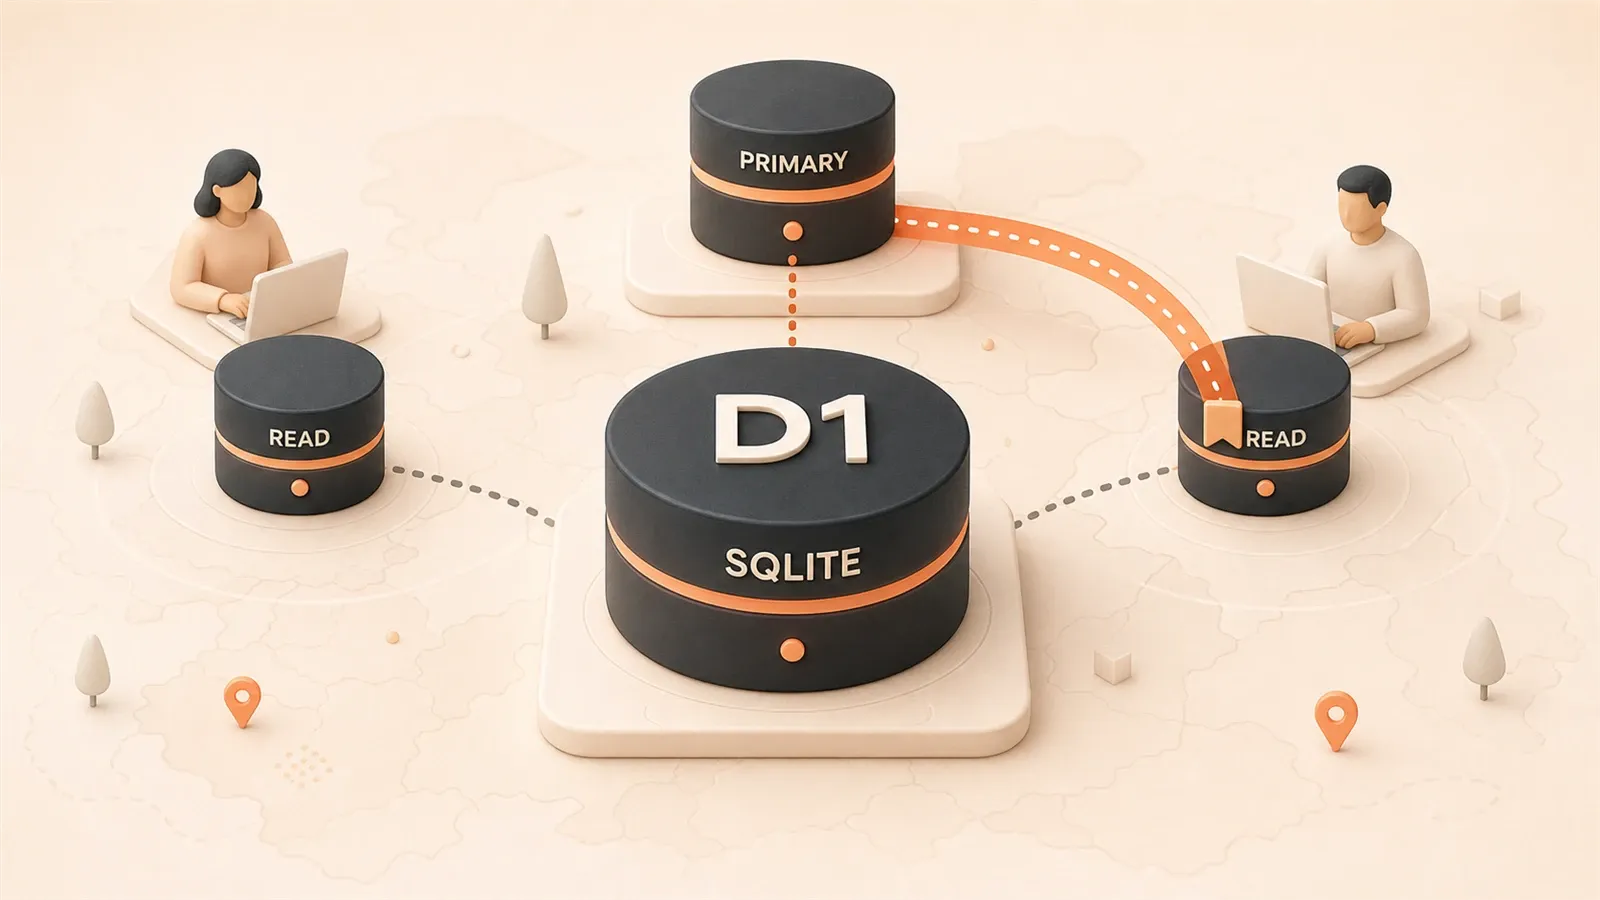
Em termos simples, o D1 é a forma como a Cloudflare levou SQLite para sua rede de edge, permitindo ler e gravar dados a partir de nós distribuídos por mais de 300 cidades no mundo.
Mas, se você acha que é apenas “SQLite + CDN”, está subestimando a ambição do produto. O SQLite tradicional tem alguns problemas pesados para produção distribuída: armazenamento em arquivo único, ausência de recuperação de falhas integrada e escritas que bloqueiam o banco inteiro. O D1 redesenha essas partes.
O que muda em relação ao SQLite tradicional
A primeira diferença é a integração. O D1 roda diretamente dentro do Cloudflare Workers. Você opera o banco quase como chamaria uma função comum:
// wrangler.toml
[[d1_databases]]
binding = "DB"
database_name = "my-database"
database_id = "xxxx-xxxx-xxxx"

// Consulta dentro do Worker
export default {
  async fetch(request, env) {
    const { results } = await env.DB.prepare(
      "SELECT * FROM users WHERE id = ?"
    ).bind(1).all();
    return Response.json(results);
  }
}
A segunda diferença é o Time Travel. O D1 salva automaticamente versões históricas do banco, então você pode restaurar o estado de qualquer ponto no tempo. Para SQLite, isso é quase um luxo. Contas gratuitas mantêm 30 dias; contas pagas podem manter por mais tempo.
A terceira é a replicação global, a grande atualização de 2025. O nó primário do seu banco fica em uma região, mas réplicas de leitura são sincronizadas automaticamente pelo mundo. Se um usuário em Singapura acessa a aplicação, os dados são lidos de uma réplica próxima em Singapura. A latência cai de três dígitos para poucos milissegundos.
Mas ele também tem limites duros
O D1 não resolve tudo. Há alguns limites que você precisa conhecer antes de escolher:
Limite de 10 GB por banco. Passou disso, precisa dividir ou considerar outra solução. Uma conta aceita até 50.000 bancos, o que basta para a maioria dos projetos. Mas, se o seu modelo for “um banco por usuário”, faça a conta com calma.
Arquitetura de escritor único. Só um nó processa escritas por vez. Isso coloca um teto no throughput de escrita. Em testes reais, fica perto de 500 a 2.000 writes/sec, distante dos 10K a 50K do PostgreSQL. Se o seu negócio escreve com frequência alta, como lances em tempo real ou pipeline de logs, o D1 pode não aguentar.
Consistência sequencial, não consistência forte. Vamos detalhar isso depois. A ideia curta é: um dado recém-gravado talvez não apareça na leitura do segundo seguinte. Mas, se você usar bem a Sessions API, esse problema fica bem controlado.
Sendo honesto, o melhor encaixe do D1 são aplicações Web com muito mais leitura do que escrita. A maioria dos sites faz mais de 90% das operações como leitura. A replicação global de leitura do D1 responde esses pedidos a partir de nós próximos, e o ganho de experiência é bem concreto.
2. Arquitetura do D1: Durable Objects e replicação global
Esta parte é mais densa, mas esses conceitos fazem diferença se você quer usar o D1 direito.
Durable Objects: um “zelador” para cada banco
O núcleo do D1 são os Durable Objects. Pense neles como um processo exclusivo, um “zelador”, para cada banco. Esse zelador fica responsável por:

- Garantir unicidade global: todas as escritas passam por ele, evitando conflitos de duas pessoas alterando a mesma linha ao mesmo tempo
- Manter o log de transações: cada escrita é registrada para recuperação de falhas e sincronização de réplicas
- Coordenar réplicas de leitura e escrita: avisar as réplicas espalhadas pelo mundo que “está na hora de atualizar”
Esse desenho é esperto. Bancos distribuídos tradicionais precisam coordenar vários nós, e latência de rede ou falha de nó abrem espaço para vários problemas. O D1 escolhe outro caminho: fixa um nó primário, envia todas as escritas para uma fila lá, processa em ordem e replica de forma assíncrona para as cópias.
Snapshot Isolation: leituras não bloqueiam
Quando você executa um SELECT no D1, ele não entra na fila do primário. Ele lê diretamente um “snapshot” da réplica mais próxima.
O que isso significa? Imagine que o banco tem o primário em Pequim e réplicas em Tóquio, Singapura e Sydney. Quando um usuário em Tóquio faz uma leitura, o D1 roteia para a réplica de Tóquio e devolve o estado dos dados naquele instante. Esse snapshot é definido no começo da consulta. Mesmo que o primário esteja gravando novos dados ao mesmo tempo, sua leitura não bloqueia.
Só que existe uma pegadinha: se você acabou de gravar uma linha e lê logo em seguida, talvez ela ainda não apareça. A réplica pode não ter sincronizado.
É por isso que o D1 oferece a Sessions API.
Timestamps de Lamport: para a ordem fazer sentido
Leslie Lamport propôs, em 1978, um método para ordenar eventos em sistemas distribuídos. Depois ele ficou conhecido como timestamp de Lamport. A ideia central é simples: cada evento recebe um relógio lógico, e eventos posteriores sempre têm timestamp maior do que eventos anteriores.
O D1 usa esse mecanismo para garantir “consistência sequencial”: se você escreve e depois lê dentro de uma sessão, o D1 garante que a leitura veja dados mais recentes do que aquela escrita, não uma réplica antiga que ainda não sincronizou.
Como isso funciona na prática? Depois de cada escrita, o D1 devolve um “marcador” chamado commit token. Esse marcador é como um ponto de referência: “todas as alterações antes deste ponto já entraram em vigor”. Na próxima consulta, você envia esse marcador, e o D1 garante que os dados vistos sejam pelo menos mais novos que esse ponto.
Usuário → grava pedido → recebe commit token "abc123"
Usuário → consulta pedido (com token "abc123") → garante que vê os dados recém-gravados
Como a replicação global funciona
Ao criar um banco D1, ele escolhe uma “região primária” ou primary location. Por padrão, é o data center da Cloudflare mais próximo de você, mas também dá para especificar manualmente.
Fluxo de escrita:
- A requisição de escrita chega ao nó de edge mais próximo
- Ela é roteada para o Durable Object da região primária
- O arquivo principal do banco recebe a escrita
- A alteração é replicada de forma assíncrona para réplicas em regiões globais
Fluxo de leitura:
- A requisição de leitura chega ao nó de edge mais próximo
- A leitura vem da réplica daquela região
- Se for uma leitura com session, o marcador de consistência é respeitado
A Cloudflare diz que a replicação global não cobra extra. Isso é justo, porque transferência de dados não é barata. Mas atenção: escritas ainda são roteadas para a região primária, então a latência depende da distância física entre o usuário e essa região. Se você coloca o primário nos EUA e a maior parte dos usuários está na Ásia, a demora na escrita vai ser perceptível.
3. Sessions API na prática: código para consistência sequencial
Chega de teoria. Vamos ao código.
A Sessions API é um recurso lançado pelo D1 em 2025 para resolver consistência de “ler depois de escrever”. Se você já usou causal consistency no MongoDB ou follower reads no CockroachDB, o conceito é parecido: algum marcador acompanha a relação de causa e efeito.
Uso básico
// Cria uma Session
const session = env.DB.withSession();

// Consulta de leitura comum, roteada para a réplica mais próxima
const { results } = await session.prepare(
  "SELECT * FROM products WHERE category = ?"
).bind("electronics").all();

// Consulta de escrita, roteada automaticamente para o primário
await session.prepare(
  "INSERT INTO orders (user_id, product_id, quantity) VALUES (?, ?, ?)"
).bind(userId, productId, 2).run();

// Obtém o marcador de consistência da Session atual
const bookmark = session.latestCommitToken;
O ponto chave é withSession(). Ele cria um “contexto de sessão”. Todas as operações dentro desse contexto compartilham a mesma visão de consistência.
Três modos de consistência
A Sessions API oferece três modos para cenários diferentes:
1. first-unconstrained (padrão)
const session = env.DB.withSession("first-unconstrained");É o modo mais flexível. Leituras vêm diretamente da réplica mais próxima, sem exigir que ela seja a mais recente. Serve para cenários com baixa exigência de tempo real, como listas de produtos e exibição de posts de blog.
2. first-primary
const session = env.DB.withSession("first-primary");A primeira leitura é roteada para o primário; as seguintes vão para réplicas. Isso garante que você veja dados pelo menos tão recentes quanto o estado no momento em que a Session foi criada. É útil quando você precisa ver “dados recém-gravados”, mas não quer bater no primário em toda consulta.
3. Continuar uma sessão anterior com marcador
// Obtém o marcador anterior pelo cabeçalho da requisição
const previousToken = request.headers.get("x-d1-token") ?? "first-unconstrained";

// Cria a Session e continua a sessão anterior
const session = env.DB.withSession(previousToken);

// Executa operações...

// Retorna o novo marcador
response.headers.set("x-d1-token", session.latestCommitToken);
Esse é o uso mais poderoso. Você pode guardar o marcador no cliente, como em um Cookie do navegador ou em um cabeçalho, e enviá-lo em cada requisição. Assim, a consistência atravessa várias requisições.

Cenário real: sistema de pedidos de e-commerce
Imagine uma plataforma global de e-commerce. Enquanto o usuário navega por produtos, você quer ler da réplica mais próxima para ter a menor latência possível. Mas, depois que ele faz um pedido e abre a página do pedido, ele precisa ver o pedido que acabou de criar.
export default {
  async fetch(request, env) {
    const url = new URL(request.url);

    // Obtém o session token pelo cabeçalho da requisição (na primeira, será null)
    const token = request.headers.get("x-d1-token") ?? "first-unconstrained";
    const session = env.DB.withSession(token);

    // Caso 1: navegar pela lista de produtos (não exige consistência forte)
    if (url.pathname === "/api/products") {
      const { results } = await session.prepare(
        "SELECT * FROM products WHERE status = ?"
      ).bind("active").all();

      return new Response(JSON.stringify(results), {
        headers: {
          "Content-Type": "application/json",
          "x-d1-token": session.latestCommitToken
        }
      });
    }

    // Caso 2: criar pedido (escrita, roteada automaticamente para o primário)
    if (url.pathname === "/api/orders" && request.method === "POST") {
      const body = await request.json();

      await session.prepare(`
        INSERT INTO orders (user_id, total_amount, status)
        VALUES (?, ?, ?)
      `).bind(body.userId, body.total, "pending").run();

      // Consulta logo depois da escrita para garantir que lê os dados recém-gravados
      const order = await session.prepare(`
        SELECT * FROM orders WHERE user_id = ?
        ORDER BY created_at DESC LIMIT 1
      `).bind(body.userId).first();

      return new Response(JSON.stringify(order), {
        headers: {
          "Content-Type": "application/json",
          "x-d1-token": session.latestCommitToken  // Retorna o novo token
        }
      });
    }

    // Caso 3: ver detalhes do pedido (usa o token anterior para garantir consistência)
    if (url.pathname.startsWith("/api/orders/")) {
      const orderId = url.pathname.split("/")[3];

      // Se o usuário acabou de fazer um pedido, o token garante a leitura mais recente
      const order = await session.prepare(
        "SELECT * FROM orders WHERE id = ?"
      ).bind(orderId).first();

      return new Response(JSON.stringify(order), {
        headers: {
          "Content-Type": "application/json",
          "x-d1-token": session.latestCommitToken
        }
      });
    }
  }
}
Esse desenho é bem útil. Na navegação de produtos, first-unconstrained entrega a melhor performance. Depois do pedido, o cliente salva o token e o envia nas próximas consultas de pedido para garantir consistência.
Como o cliente colabora
No frontend, a tarefa é simples: guardar o x-d1-token e enviá-lo em cada requisição.
// Exemplo no frontend
let d1Token = localStorage.getItem('d1-token') ?? 'first-unconstrained';

async function fetchProducts() {
  const response = await fetch('/api/products', {
    headers: { 'x-d1-token': d1Token }
  });
  d1Token = response.headers.get('x-d1-token');
  localStorage.setItem('d1-token', d1Token);
  return response.json();
}

async function createOrder(data) {
  const response = await fetch('/api/orders', {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
      'x-d1-token': d1Token
    },
    body: JSON.stringify(data)
  });
  d1Token = response.headers.get('x-d1-token');
  localStorage.setItem('d1-token', d1Token);
  return response.json();
}
Repare que não é muito código, mas o problema resolvido é grande. Sem esse mecanismo, o usuário poderia finalizar um pedido, abrir a lista de pedidos e ver tudo vazio. Péssima experiência.
4. Benchmarks de performance e comparação com concorrentes
Dados não mentem. Organizei aqui uma comparação entre algumas soluções populares, usando números de documentação oficial e testes da comunidade.
Comparação de latência
| Solução | Latência de leitura (p50) | Latência de leitura (p99) | Latência de escrita (p50) | Observação |
|---|---|---|---|---|
| D1 | ~0,5 ms | ~2-5 ms | ~5-30 ms | Leitura em réplica no edge; escrita no primário |
| Turso | ~0,02 ms | ~0,1 ms | ~15-50 ms | Leitura embarcada, absurdamente rápida |
| PlanetScale | ~3-8 ms | ~10-20 ms | ~3-8 ms | Compatível com MySQL; leitura e escrita passam por proxy |
| PostgreSQL (Neon) | ~3-10 ms | ~20-50 ms | ~1-5 ms | Arquitetura tradicional, cold start mais lento |
Algumas observações:
A latência de leitura do Turso é realmente muito baixa. 0,02 milissegundo é praticamente velocidade de acesso à memória local. Isso acontece porque ele usa SQLite embarcado: o arquivo do banco é copiado diretamente para o seu nó de edge, e a leitura fica totalmente local. Mas há custo: a sincronização de dados exige trabalho extra, e a latência de escrita pode ser maior.
A latência de leitura do D1 também é excelente. 0,5 milissegundo já é nível de ponta para banco no edge. A diferença aparece na escrita, porque toda escrita precisa ir ao primário. A distância física define o piso de latência. Se o primário está na costa oeste dos EUA e o usuário em Singapura, a escrita precisa atravessar o Pacífico. Conte com pelo menos 30 milissegundos.
PlanetScale e Neon combinam melhor com aplicações tradicionais. Os números de latência não brilham tanto quanto D1 e Turso, mas o ecossistema é mais maduro e os recursos são mais completos. Se você precisa de SQL mais complexo, como stored procedures, triggers e tipos ricos de índice, essas duas opções podem fazer mais sentido.
Comparação de throughput
| Solução | Throughput de leitura (QPS) | Throughput de escrita (QPS) | Observação |
|---|---|---|---|
| D1 | 10K-100K | 500-2K | Limite por banco |
| Turso | Ilimitado (leitura local) | Limitado pela sincronização | Leitura independente em cada nó de edge |
| PlanetScale | 10K-50K | 5K-20K | Escala com sharding |
| PostgreSQL | 10K-100K | 10K-50K | Depende do tamanho da instância |
O throughput de escrita é o ponto fraco do D1. A arquitetura de escritor único define o teto. Se a sua aplicação precisa gravar mais de 5.000 linhas por segundo, o D1 pode virar gargalo. Nesse caso, você divide em múltiplos bancos, assumindo a complexidade, ou escolhe outra solução.
Comparação de cotas gratuitas
| Solução | Armazenamento | Cota de leitura | Cota de escrita | Observação |
|---|---|---|---|---|
| D1 | 5 GB | 25 bilhões de linhas/mês | 50 milhões de linhas/mês | Limite de 10 GB por banco |
| Turso | 9 GB | 1 bilhão de linhas/mês | 25 milhões de linhas/mês | Inclui tráfego de replicação |
| PlanetScale | 1 GB | 10 bilhões de linhas/mês | 10 bilhões de linhas/mês | Sem limite específico de escrita |
| Neon | 0,5 GB | 100 milhões de unidades/mês | 100 milhões de unidades/mês | Unidade = leitura ou escrita |
Pela cota gratuita, o D1 é bem generoso. 25 bilhões de linhas lidas são mais que suficientes para projetos pessoais e aplicações pequenas. Mas repare no limite de escrita: 50 milhões de linhas por mês, em média 1,66 milhão por dia. Para coleta de logs ou envio de eventos de tracking, é fácil estourar.
Modelo de cobrança
A cobrança do D1 é simples: por uso, sem consumo mínimo. Depois da cota gratuita, cada milhão de linhas lidas custa US$ 0,001, cada milhão de linhas gravadas custa US$ 0,10, e o armazenamento custa US$ 0,75 por GB ao mês.
A cobrança do Turso é um pouco mais complexa, com “linhas lidas” e “tráfego de replicação” como dimensões. Se os dados mudam com frequência, o custo de replicação pode subir.
O PlanetScale cobra por “linhas lidas” e “linhas gravadas”. A escrita custa menos que no D1, mas a leitura custa um pouco mais.
Minha sugestão: se você já usa bastante o ecossistema Cloudflare, como Workers, KV e R2, a integração do D1 deixa a conta mais clara. Para um projeto independente, teste as três opções e deixe os dados reais decidirem.
5. Árvore de decisão: quando escolher D1
Depois de tudo isso, a pergunta prática é: vale escolher D1? Montei uma árvore de decisão simples.
Cenários em que D1 faz sentido
Sua aplicação é intensiva em leitura. Pense em sites de conteúdo, e-commerce com navegação predominante, blogs e sistemas de documentação. Essas aplicações passam de 90% das operações em leitura. A replicação global do D1 derruba a latência para poucos milissegundos.
Seus usuários estão distribuídos pelo mundo. Com um banco tradicional em uma única região, cada requisição distante cruza oceanos. O D1 leva os dados para perto do usuário, e o ganho de experiência aparece rápido.
Você já usa Cloudflare Workers. A integração entre D1 e Workers é nativa. Algumas linhas de configuração bastam. Não precisa gerenciar pool de conexões separado, não há preocupação com cold start de banco, e a experiência de desenvolvimento é fluida.
Seu banco fica abaixo de 10 GB. O limite por banco do D1 é 10 GB. Acima disso, precisa dividir. Se o seu negócio naturalmente usa “um banco por tenant”, esse limite pode nem incomodar.
Cenários em que D1 não combina
Aplicações com escrita frequente. Sistemas de lances em tempo real, pipelines de logs, coleta de dados de IoT: esses cenários podem gerar dezenas de milhares de escritas por segundo. A arquitetura de escritor único do D1 vira gargalo. PostgreSQL, ClickHouse ou TimescaleDB tendem a ser escolhas melhores.

Necessidade de transações complexas. Hoje o D1 suporta o nível de transação do SQLite. Se você precisa de isolamento SERIALIZABLE, transações entre bancos ou stored procedures complexas, ele não atende.
Dados acima de 10 GB. Dá para dividir, mas isso aumenta a complexidade operacional. Se os seus dados já nascem grandes, como séries temporais ou arquivos de logs, é melhor começar por outra solução.
Exigência de consistência forte. O D1 é um sistema eventualmente consistente. Depois de escrever, uma leitura imediata pode não ver os dados mais recentes, a menos que você use a Sessions API. Se o negócio exige que qualquer lugar leia o dado mais novo a qualquer instante, avalie outras opções.
Cuidados ao migrar de PostgreSQL
Se você quer migrar uma aplicação PostgreSQL existente para D1, pense antes nestes pontos:
1. Diferenças de dialeto SQL
O SQLite não aceita alguns recursos do PostgreSQL:
- Não há cláusula
RETURNING(faça em duas etapas: inserir e depois consultar) - Não há tipo
SERIAL(useINTEGER PRIMARY KEY AUTOINCREMENT) - Não há tipo
JSONB(guarde JSON emTEXTe use a funçãojson_extract()) - Não há tipo
ARRAY(use uma tabela relacionada)
2. Ferramentas de migração
A Cloudflare oferece ferramenta de migração para exportar SQL do PostgreSQL e importar no D1:
# Exporta dados do PostgreSQL
pg_dump --format=insert mydb > dump.sql

# Importa para o D1
npx wrangler d1 execute my-d1-database --file=dump.sql
Schemas mais complexos ainda podem exigir ajustes manuais.
3. Mudança na forma de conexão
Bancos tradicionais usam conexão longa; o D1 usa chamadas stateless em funções. Seu ORM pode precisar de ajustes, ou você pode ir direto para SQL nativo. O Prisma tem adaptador para D1, mas os recursos ainda estão em evolução.
Decisão rápida
Se ainda está em dúvida, use este filtro simples:
Sua aplicação escreve mais de 1000 vezes por segundo?
├─ Sim → não escolha D1
└─ Não
    └─ Precisa de consistência forte?
        ├─ Sim → não escolha D1 (ou combine com a Sessions API)
        └─ Não
            └─ Volume de dados > 10 GB?
                ├─ Sim → avalie com cuidado
                └─ Não → D1 é uma boa opção
Resumo
O valor central do D1 cabe em três frases: deploy no edge reduz a latência para poucos milissegundos; arquitetura serverless tira a operação do seu colo; Sessions API resolve, de forma simples, um dos problemas mais chatos de sistemas distribuídos, a consistência depois da escrita.
Isso não significa que ele sirva para tudo. Escrita frequente, transações complexas e dados em escala muito grande continuam favorecendo PostgreSQL e bancos especializados em séries temporais. Escolha técnica não tem bala de prata; tem troca consciente.
Se você está criando uma aplicação Web global, com muito mais leitura do que escrita, e já usa Cloudflare Workers, o D1 merece um teste. Criar um banco experimental leva poucos minutos:
# Cria o banco
npx wrangler d1 create my-first-db

# Cria a tabela
npx wrangler d1 execute my-first-db --command="CREATE TABLE users (id INTEGER PRIMARY KEY, name TEXT)"

# Insere dados
npx wrangler d1 execute my-first-db --command="INSERT INTO users (name) VALUES ('test')"
Rode na prática, compare a latência entre Tóquio e um banco na costa oeste dos EUA, e você vai perceber rápido se ele combina com o seu projeto.
"O D1 é o banco SQLite no edge da Cloudflare, com replicação global de leitura e experiência serverless. Sua Sessions API usa timestamps de Lamport para implementar consistência sequencial e resolver o problema comum de ler logo depois de escrever em sistemas distribuídos."
Referências
- Building D1: a Global Database — blog oficial da Cloudflare, 2024
- D1 Global Read Replication Beta — blog oficial da Cloudflare, 2025
- D1 Getting Started — documentação oficial da Cloudflare
- The SQLite Renaissance — DEV Community, 2026
- Database Free Tier Comparison 2026 — Agent Deals
Primeiros passos com o banco de dados Cloudflare D1
Fluxo completo, da criação do banco até leituras consistentes com a Sessions API
⏱️ Estimated time: 15 min
- 1
Step 1: Criar um banco D1
Use a CLI do wrangler para criar o banco:
```bash
npx wrangler d1 create my-first-db
```
Depois da criação, o comando retorna um database_id. Configure-o no wrangler.toml:
```toml
[[d1_databases]]
binding = "DB"
database_name = "my-first-db"
database_id = "your-database-id"
``` - 2
Step 2: Criar as tabelas
Execute SQL para criar a estrutura da tabela:
```bash
npx wrangler d1 execute my-first-db --command="CREATE TABLE users (id INTEGER PRIMARY KEY, name TEXT, created_at DATETIME DEFAULT CURRENT_TIMESTAMP)"
```
Também dá para executar um arquivo SQL em lote:
```bash
npx wrangler d1 execute my-first-db --file=./schema.sql
``` - 3
Step 3: Usar a Sessions API dentro de um Worker
Crie uma conexão de banco com sessão para garantir consistência de leitura depois da escrita:
```typescript
export default {
async fetch(request, env) {
// Obtém o session token pelo cabeçalho da requisição
const token = request.headers.get("x-d1-token") ?? "first-unconstrained";
const session = env.DB.withSession(token);
// Grava dados
await session.prepare("INSERT INTO users (name) VALUES (?)")
.bind("test").run();
// Garante consistência na leitura
const { results } = await session.prepare("SELECT * FROM users")
.all();
return new Response(JSON.stringify(results), {
headers: { "x-d1-token": session.latestCommitToken }
});
}
}
``` - 4
Step 4: Configurar replicação global de leitura
Defina a região primária no wrangler.toml:
```toml
[[d1_databases]]
binding = "DB"
database_name = "my-first-db"
database_id = "your-database-id"
primary_location_hint = "apne1" # Região de Tóquio
```
Códigos de região opcionais:
- apne1: Tóquio
- sfo1: São Francisco
- eur3: Frankfurt
FAQ
Qual é a diferença entre Cloudflare D1 e Turso?
• D1: arquitetura de escritor único; escritas são roteadas para o primário, com latência de leitura em torno de 0,5 ms. É indicado para cenários com muito mais leitura do que escrita.
• Turso: leitura embarcada, com latência ainda menor, perto de 0,02 ms, mas a sincronização de dados fica mais complexa.
A vantagem do D1 é a integração nativa com Cloudflare Workers e uma cota gratuita maior, com 25 bilhões de linhas lidas por mês. A vantagem do Turso é a leitura extremamente rápida, útil para cenários muito sensíveis à latência.
Como contornar o limite de 10 GB por banco no D1?
• Estratégia de múltiplos bancos: dividir por módulo de negócio, com um banco para cada módulo.
• Isolamento por tenant: um banco para cada tenant; o D1 aceita até 50.000 bancos.
• Armazenamento híbrido: dados quentes no D1 e dados frios migrados para R2 ou outro armazenamento de objetos.
Se o volume continuar crescendo além de 10 GB, vale avaliar se PlanetScale ou PostgreSQL tradicional fazem mais sentido.
Como escolher entre os três modos da Sessions API?
• first-unconstrained, o padrão: bom para listagens de produtos, blogs e telas que não exigem atualização em tempo real.
• first-primary: bom quando você precisa ver os dados recém-gravados, mas não quer consultar o primário toda vez.
• Modo com commit token: bom para pedidos de e-commerce, consulta de pedidos e cenários que precisam de consistência entre requisições.
Para e-commerce, a recomendação é usar first-unconstrained durante a navegação, salvar o token depois do pedido e enviá-lo nas requisições seguintes.
O D1 serve para cenários de escrita frequente?
Se a sua aplicação tem estas características, considere outra opção:
• Sistema de lances em tempo real
• Pipeline de logs ou envio de eventos de tracking
• Coleta de dados de IoT
• Mais de 1.000 escritas por segundo
Esses cenários costumam combinar melhor com PostgreSQL, ClickHouse ou TimescaleDB.
O que observar ao migrar de PostgreSQL para D1?
• Dialeto SQL: SQLite não aceita RETURNING, SERIAL, JSONB nem ARRAY.
• Forma de conexão: sai a conexão longa e entra a chamada stateless em funções.
• Adaptação de ORM: Prisma tem adaptador para D1, mas os recursos ainda estão amadurecendo.
Etapas de migração:
1. Exporte os dados com pg_dump.
2. Ajuste manualmente a sintaxe SQL incompatível.
3. Importe com wrangler d1 execute.
Comece com um conjunto pequeno de dados, valide as funcionalidades e só depois faça a migração completa.
A replicação global do D1 cobra algo a mais?
Mas há alguns pontos importantes:
• Escritas continuam sendo roteadas para o banco primário, então a latência depende da distância física entre o usuário e o primário.
• Se o primário estiver nos EUA e os usuários estiverem na Ásia, a latência de escrita tende a passar de 30 ms.
• A cota gratuita de leitura é alta, com 25 bilhões de linhas por mês, e a cota de escrita é de 50 milhões de linhas por mês.
O ideal é colocar o primário na região onde seus usuários estão mais concentrados para otimizar a experiência de escrita.
18 min de leitura · Publicado em: 5 mai 2026 · Atualizado em: 14 jul 2026

Cloudflare Full Stack
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Cloudflare Dynamic Workers: o segredo do sandbox de IA 100 vezes mais rápido que contêineres
Cloudflare Dynamic Workers usa V8 Isolates para criar sandboxes de AI Agent com inicialização 100 vezes mais rápida que contêineres e eficiência de memória de 10 a 100 vezes maior. Este guia analisa arquitetura, segurança, API prática e custo-benefício.
Parte 20 de 23
Próximo
Limites do plano gratuito da Cloudflare: CDN, DNS, WAF e Workers ainda bastam?
Lista completa dos limites do plano gratuito da Cloudflare: Workers com 100 mil requisicoes/dia, Pages com 500 builds/mes, DNS com 1000 registros e R2 com 10 GB. Veja se seu projeto pode passar do limite, com tabela de decisao por cenario e sinais de upgrade.
Parte 22 de 23


Comentários
Entre com GitHub para comentar