
LangChain LCEL 실전: 전통적인 Chain에서 스트리밍 응답까지의 현대적 패러다임
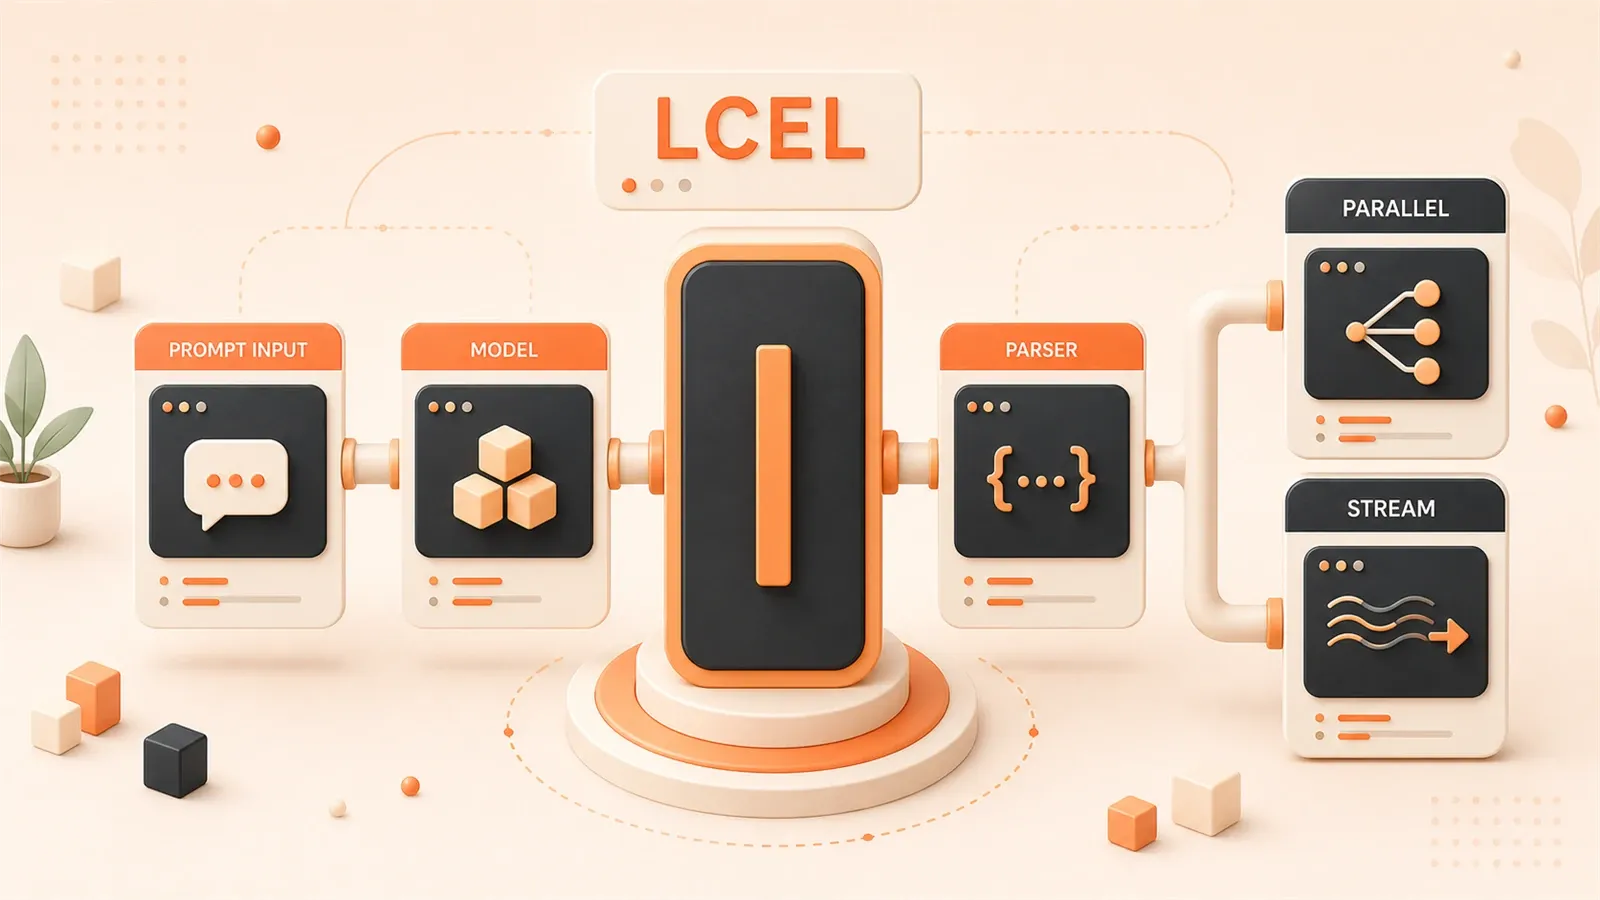
작년에 오래된 프로젝트 하나를 맡았는데, 소스 코드를 여는 순간 잠깐 멈칫했습니다. 단일 대화 Chain 코드가 200줄이 넘게 작성되어 있었기 때문입니다. PromptTemplate을 초기화하고, LLMChain을 설정하고, 입력과 출력 매핑을 수동으로 처리하고, 스트리밍 응답을 처리하려고 콜백 함수까지 직접 작성해야 했습니다. 더 난감했던 것은 팀 안에서 누구도 이 부분의 코드를 건드리려 하지 않았다는 점입니다. “일단 돌아가니까”가 사실상 가장 큰 합의가 되어 있었습니다.
이것은 LangChain 초기 버전이 남긴 전형적인 문제입니다. LLMChain, SequentialChain 같은 오래된 API는 2023년에는 주류였지만, 지금은 공식적으로 deprecated 표시가 붙었습니다. 문제는 인터넷의 많은 튜토리얼이 여전히 그 오래된 작성 방식을 사용한다는 데 있습니다.
이 글은 AI 개발 실전 시리즈의 13번째 글입니다. 실제 코드 비교를 통해 LCEL(LangChain Expression Language)이 어떻게 같은 기능의 코드를 70% 줄이는지, 그리고 원래라면 많은 보일러플레이트 코드가 필요했던 스트리밍 응답과 비동기 실행을 어떻게 자동으로 처리하는지 설명하겠습니다.
참고로 RAG 시스템이나 Agent 애플리케이션을 만들고 있다면, 이 글은 시리즈의 RAG 시스템 최적화 실전, LangGraph 상태 관리와 이어서 보면 좋습니다. 모두 LangChain 생태계에서 피해 가기 어려운 주제입니다.
1장: LCEL이란 무엇이고 왜 써야 할까?
2023년의 튜토리얼로 LangChain을 배우기 시작했다면, 아마 이런 코드를 작성해 본 적이 있을 것입니다.
# 전통적인 LLMChain 작성 방식(deprecated)
from langchain.chains import LLMChain
from langchain.prompts import PromptTemplate
from langchain_openai import OpenAI

# 1. 모델 초기화
llm = OpenAI(temperature=0.7)

# 2. Prompt 템플릿 정의
template = """당신은 숙련된 {role}입니다.
사용자 질문: {question}
전문적인 답변을 작성해 주세요:"""
prompt = PromptTemplate(
    template=template,
    input_variables=["role", "question"]
)

# 3. Chain 생성
chain = LLMChain(llm=llm, prompt=prompt)

# 4. Chain 호출(여기의 인자 전달 방식에 주의)
result = chain.run(role="프론트엔드 엔지니어", question="React와 Vue 중 무엇을 선택해야 하나요?")
print(result)
겉보기에는 괜찮아 보입니다. 하지만 여기에 스트리밍 출력, 배치 처리, 여러 Chain 조합을 추가하려면 코드량이 기하급수적으로 늘어납니다. 전통적인 Chain에는 치명적인 문제가 세 가지 있습니다.
첫째, 스트리밍 응답 지원이 약합니다. LLMChain은 기본적으로 스트리밍 출력을 지원하지 않습니다. token 생성 이벤트를 감지하려면 콜백 함수를 직접 작성해야 합니다. 코드가 장황해질 뿐 아니라 비동기 처리도 쉽게 꼬입니다.
둘째, 조합 방식이 무겁습니다. 두 Chain을 이어 붙이고 싶다면 SequentialChain을 써야 합니다. 병렬로 실행하고 싶다면 또 다른 API를 배워야 합니다. 조합 방식이 바뀔 때마다 새 인터페이스를 익혀야 하니 인지 부담이 큽니다.
셋째, 입력과 출력 매핑이 명시적이고 번거롭습니다. 각 Chain마다 input_variables와 output_variables를 선언해야 하며, 데이터가 Chain 사이를 흐를 때 필드명도 수동으로 맞춰야 합니다.
LCEL은 바로 이런 문제를 해결하기 위해 나왔습니다. 같은 기능을 LCEL로 작성하면 다음과 같습니다.
# LCEL 작성 방식(LangChain v0.3+ 권장)
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

# 1. 모델 정의
model = ChatOpenAI(model="gpt-4o-mini", temperature=0.7)

# 2. Prompt 정의
prompt = ChatPromptTemplate.from_template(
    "당신은 숙련된 {role}입니다.\n사용자 질문: {question}\n전문적인 답변을 작성해 주세요:"
)

# 3. 파이프 연산자로 컴포넌트 연결
chain = prompt | model

# 4. Chain 호출(입력과 출력 매핑 자동 처리)
result = chain.invoke({"role": "프론트엔드 엔지니어", "question": "React와 Vue 중 무엇을 선택해야 하나요?"})
print(result.content)
코드는 15줄에서 9줄로 줄었습니다. 하지만 진짜 강력한 부분은 따로 있습니다.
- 스트리밍 출력을 자동 지원합니다.
invoke를stream으로 바꾸기만 하면 되고, 다른 코드는 건드릴 필요가 없습니다. - 비동기를 자동 지원합니다.
ainvoke또는astream을 사용하면 비동기 실행도 한 줄로 끝납니다. - 배치 처리를 자동 지원합니다.
batch메서드에 리스트를 넘기면 자동으로 병렬 실행됩니다.
Pipe 연산자 |의 설계 영감은 Linux 파이프에서 왔습니다. Linux에서 cat log.txt | grep error | wc -l은 세 명령을 이어 붙여, 앞 명령의 출력을 뒤 명령의 입력으로 바로 넘깁니다. LCEL은 같은 아이디어를 LangChain으로 가져왔습니다. prompt | model | output_parser처럼 데이터가 왼쪽에서 오른쪽으로 흐르며, 코드는 문장처럼 자연스럽게 읽힙니다.
솔직히 처음 이 문법을 봤을 때는 조금 낯설었습니다. Python에서 |는 비트 OR 연산자 아닌가 싶었기 때문입니다. 나중에 알고 보니 Python 3.10 이후의 문법과 __or__ 매직 메서드를 활용해 파이프 의미를 구현한 것이었습니다. 꽤 영리한 설계입니다.
2장: Pipe 연산자의 동작 원리
Pipe 연산자는 겉으로는 단순하지만, 그 뒤에는 완성도 높은 설계가 있습니다. 먼저 간단한 실험을 보겠습니다.
from langchain_core.runnables import RunnableLambda

# 간단한 Runnable 두 개 생성
def add_one(x: int) -> int:
    return x + 1

def multiply_two(x: int) -> int:
    return x * 2

# 일반 함수를 RunnableLambda로 래핑
add_one_runnable = RunnableLambda(add_one)
multiply_two_runnable = RunnableLambda(multiply_two)

# 파이프 연산자로 연결
chain = add_one_runnable | multiply_two_runnable

# 실행
result = chain.invoke(3)  # 3 -> 4 -> 8
print(result)  # 출력: 8
chain = add_one_runnable | multiply_two_runnable 이 줄이 실행될 때 Python은 실제로 add_one_runnable.__or__(multiply_two_runnable)를 호출합니다.

LangChain의 Runnable 클래스는 __or__ 메서드를 구현하고 있으며, 이 메서드는 새로운 RunnableSequence 객체를 반환합니다. 이 객체 안에는 연결된 모든 Runnable이 저장됩니다. invoke를 호출하면 각 컴포넌트를 순서대로 실행하고, 앞 컴포넌트의 출력을 다음 컴포넌트에 넘깁니다.
Runnable은 LCEL의 핵심 추상화입니다. Runnable은 통합 인터페이스를 정의합니다. 아래 네 가지 메서드를 구현한 컴포넌트라면 무엇이든 파이프 조합에 참여할 수 있습니다.
| 메서드 | 역할 | 동기/비동기 |
|---|---|---|
invoke | 단일 호출, 전체 결과 반환 | 동기 |
stream | 단일 호출, 스트리밍 출력 반환 | 동기 |
batch | 배치 호출, 여러 입력을 병렬 처리 | 동기 |
ainvoke | 단일 호출, 전체 결과 반환 | 비동기 |
각 메서드에는 대응하는 비동기 버전도 있습니다. astream, abatch, abatch_as_completed가 그것입니다.
이 인터페이스는 모든 LangChain 컴포넌트의 호출 방식을 통일합니다. PromptTemplate, ChatModel, OutputParser는 물론 직접 작성한 RunnableLambda까지 같은 방식으로 호출할 수 있습니다.
# 통합 호출 방식
chain.invoke({"input": "hello"})        # 단일 호출
chain.stream({"input": "hello"})        # 스트리밍 호출
chain.batch([{"input": "a"}, {"input": "b"}])  # 배치 호출

# 비동기 버전
await chain.ainvoke({"input": "hello"})
async for chunk in chain.astream({"input": "hello"}):
    print(chunk, end="", flush=True)
데이터는 파이프 안에서 어떻게 흐를까요? 조금 더 복잡한 예를 보겠습니다.
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

# 세 컴포넌트
prompt = ChatPromptTemplate.from_template("영어로 번역하세요: {text}")
model = ChatOpenAI(model="gpt-4o-mini")
parser = StrOutputParser()

# 조합
chain = prompt | model | parser

# 호출
result = chain.invoke({"text": "안녕하세요 세계"})
print(result)  # 출력: Hello World
데이터 흐름은 다음과 같습니다.
{"text": "안녕하세요 세계"}
       ↓
   [prompt] → ChatPromptValue(messages=[HumanMessage("영어로 번역하세요: 안녕하세요 세계")])
       ↓
   [model]  → AIMessage(content="Hello World")
       ↓
   [parser] → "Hello World" (str)
각 컴포넌트가 받는 입력 타입과 반환하는 출력 타입에는 약속이 있습니다. Prompt는 dict를 받아 ChatPromptValue를 출력합니다. Model은 PromptValue를 받아 AIMessage를 출력합니다. Parser는 Message를 받아 str을 출력합니다.
이 타입 약속 덕분에 파이프 조합이 안전해집니다. 순서를 잘못 바꿔 model | prompt처럼 작성하면, 런타임에 타입 불일치 오류가 발생합니다. IDE도 타입 힌트를 통해 문제를 더 일찍 발견할 수 있습니다.
3장: 스트리밍 응답 실전
스트리밍 응답은 LCEL에서 가장 인상적이었던 기능입니다.
고객지원 봇을 만들고 있다고 상상해 보겠습니다. 사용자가 “이 제품의 장단점을 분석하고 경쟁 제품과도 비교해 주세요”처럼 복잡한 질문을 던집니다. GPT-4o-mini가 전체 답변을 생성하는 데는 대략 5~8초가 걸릴 수 있습니다.
스트리밍 출력이 없다면 사용자는 빈 화면을 보며 8초를 기다려야 합니다. 그 8초 동안 사용자는 시스템이 멈춘 건지, 네트워크가 끊긴 건지, 새로고침을 해야 하는지 고민하게 됩니다. 불안감이 빠르게 올라갑니다.
스트리밍 출력은 이 경험을 바꿉니다. 사용자가 질문을 마치면 화면에 곧바로 첫 글자가 나타나고, 단어가 하나씩 이어집니다. 누군가 실시간으로 타이핑하며 답하는 것처럼 보입니다. 심리적으로는 기다림이 사라집니다.
전통적인 LangChain으로 스트리밍 출력을 구현하려면 많은 코드를 작성해야 했습니다.
# 전통적인 스트리밍 구현(LLMChain 시절)
from langchain.chains import LLMChain
from langchain.callbacks.streaming_stdout import StreamingStdOutCallbackHandler

llm = OpenAI(
    temperature=0.7,
    streaming=True,
    callbacks=[StreamingStdOutCallbackHandler()]
)
chain = LLMChain(llm=llm, prompt=prompt)
chain.run(role="고객지원", question="...")
이 방식에는 몇 가지 문제가 있습니다.
- 콜백 함수 작성이 번거롭습니다. token을 프론트엔드로 보내는 등 커스텀 처리를 하려면
BaseCallbackHandler를 상속해 직접 콜백 클래스를 작성해야 합니다. - 스트리밍과 비스트리밍 전환에 코드 수정이 필요합니다.
streaming=True/False는 초기화 인자라 런타임에 바꾸기 어렵습니다. - 비동기 스트리밍은 더 복잡합니다.
AsyncCallbackHandler와 함께 써야 하며 코드량이 두 배로 늘어납니다.
LCEL은 스트리밍 처리를 내장 기능으로 바꿉니다.
# LCEL 스트리밍 구현
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

model = ChatOpenAI(model="gpt-4o-mini")
prompt = ChatPromptTemplate.from_template(
    "당신은 전문 {role}입니다. 사용자 질문에 답해 주세요: {question}"
)
chain = prompt | model

# 비스트리밍 호출
result = chain.invoke({"role": "고객지원", "question": "이 제품의 장단점을 분석해 주세요"})
print(result.content)

# 스트리밍 호출(메서드 이름 하나만 변경)
for chunk in chain.stream({"role": "고객지원", "question": "이 제품의 장단점을 분석해 주세요"}):
    print(chunk.content, end="", flush=True)
정말 이게 전부입니다. invoke를 stream으로 바꾸면 되고, 다른 코드는 전혀 건드리지 않습니다.
실시간 채팅 애플리케이션의 전체 예시는 다음과 같습니다.
import asyncio
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableWithMessageHistory
from langchain_community.chat_message_histories import ChatMessageHistory

# 1. 모델과 Prompt 정의
model = ChatOpenAI(model="gpt-4o-mini", temperature=0.7)
prompt = ChatPromptTemplate.from_messages([
    ("system", "당신은 기술 질문에 능숙하게 답하는 친절한 AI 어시스턴트입니다."),
    ("human", "{input}")
])
parser = StrOutputParser()

# 2. 기본 Chain 구성
chain = prompt | model | parser

# 3. 대화 이력 추가(사용자별 독립 메모리)
memory = ChatMessageHistory()

chain_with_history = RunnableWithMessageHistory(
    chain,
    get_session_history=lambda session_id: memory,
    input_messages_key="input",
    history_messages_key="chat_history"
)

# 4. 스트리밍 대화 함수
async def chat_stream(user_input: str):
    """대화 응답을 스트리밍으로 출력합니다."""
    print("AI: ", end="", flush=True)

    async for chunk in chain_with_history.astream(
        {"input": user_input},
        config={"configurable": {"session_id": "demo"}}
    ):
        print(chunk, end="", flush=True)

    print("\n")  # 줄바꿈

# 5. 대화 실행
async def main():
    print("=== AI 어시스턴트(스트리밍 응답 데모) ===")

    await chat_stream("LangChain이 무엇인가요?")
    await chat_stream("무엇을 만드는 데 쓸 수 있나요?")
    await chat_stream("LCEL과는 어떤 관계가 있나요?")

if __name__ == "__main__":
    asyncio.run(main())
실행 결과는 다음과 같습니다.
=== AI 어시스턴트(스트리밍 응답 데모) ===
AI: LangChain은 대규모 언어 모델 기반 애플리케이션을 구축하기 위한 오픈소스 프레임워크입니다...
AI: 챗봇, RAG 시스템, Agent 애플리케이션 등을 만드는 데 사용할 수 있습니다...
AI: LCEL은 LangChain Expression Language이며, LangChain의 핵심 컴포넌트입니다...
각 글자가 실시간으로 나타나므로 사용자는 기다릴 필요가 없습니다.
스트리밍과 비스트리밍의 사용자 경험 차이를 실제 데이터로 비교해 본 적이 있습니다.
| 시나리오 | 비스트리밍 첫 글자 지연 | 스트리밍 첫 글자 지연 | 사용자가 느끼는 대기감 |
|---|---|---|---|
| 간단한 질의응답(50자) | 1.2s | 0.3s | ”조금 느리다” vs “괜찮다” |
| 중간 규모 분석(200자) | 3.5s | 0.4s | ”멈췄나?” vs “정상이다” |
| 복잡한 생성(500자) | 8.0s | 0.5s | ”새로고침하고 싶다” vs “매끄럽다” |
비스트리밍 환경에서는 첫 글자 지연 시간이 전체 생성 시간과 같습니다. 사용자는 8초를 기다려야 어떤 피드백이라도 볼 수 있습니다. 스트리밍 환경에서는 첫 글자 지연 시간이 첫 token 생성 시간에 불과하며, 보통 1초 미만입니다.
LCEL의 스트리밍 메커니즘은 어떻게 구현될까요? 핵심은 Runnable의 stream 메서드가 파이프 안의 각 컴포넌트의 stream을 재귀적으로 호출한다는 점입니다. 모델 컴포넌트는 OpenAI API의 스트리밍 인터페이스를 직접 호출합니다. Prompt와 Parser는 보통 스트리밍이 필요 없기 때문에 전체 결과를 바로 반환합니다. 전체 파이프의 스트리밍 동작은 각 컴포넌트가 자동으로 조율합니다.

즉 어떤 컴포넌트가 스트리밍을 지원하고 어떤 컴포넌트가 지원하지 않는지 신경 쓸 필요가 없습니다. LCEL이 자동으로 처리합니다. 어떤 컴포넌트가 스트리밍을 지원하지 않으면, 스트리밍 파이프 안에서 “한 번에 반환”하는 컴포넌트로 취급될 뿐 전체 스트리밍 출력에는 영향을 주지 않습니다.
4장: Runnable 컴포넌트 자세히 보기
Pipe 연산자는 컴포넌트를 직렬로 연결하는 문제를 해결합니다. 하지만 실제 프로젝트에는 더 복잡한 시나리오가 많습니다. 여러 분기를 병렬 실행하거나, 중간 결과를 전달하거나, 커스텀 데이터 변환을 넣어야 할 때가 있습니다. LangChain은 이런 요구를 처리하기 위해 Runnable 컴포넌트 묶음을 제공합니다.
RunnableParallel: 병렬 실행
RAG 시스템에서 흔한 요구는 여러 데이터 소스를 동시에 검색하는 것입니다. 예를 들어 벡터 데이터베이스, 키워드 검색, 지식 그래프를 함께 조회할 수 있습니다. RunnableParallel을 사용하면 이런 검색을 병렬로 실행할 수 있습니다.
from langchain_core.runnables import RunnableParallel

# 세 검색기 정의(예시는 RunnableLambda로 시뮬레이션)
def vector_search(query: str) -> str:
    return f"벡터 검색 결과: {query} 관련 문서 3개"

def keyword_search(query: str) -> str:
    return f"키워드 검색 결과: {query} 매칭 기록 5건"

def graph_search(query: str) -> str:
    return f"그래프 검색 결과: {query} 관련 엔티티 2개"

# 병렬 검색 Chain 생성
retrievers = RunnableParallel(
    vector=RunnableLambda(vector_search),
    keyword=RunnableLambda(keyword_search),
    graph=RunnableLambda(graph_search)
)

# 실행(세 검색이 동시에 진행됨)
results = retrievers.invoke("LangChain LCEL")
print(results)
# 출력: {
#   'vector': '벡터 검색 결과: LangChain LCEL 관련 문서 3개',
#   'keyword': '키워드 검색 결과: LangChain LCEL 매칭 기록 5건',
#   'graph': '그래프 검색 결과: LangChain LCEL 관련 엔티티 2개'
# }
RunnableParallel은 딕셔너리를 반환합니다. 키는 정의할 때 붙인 이름이고, 값은 각 분기의 실행 결과입니다. 이 결과는 후속 컴포넌트에 전달해 합쳐서 처리할 수 있습니다.
RunnablePassthrough: 입력 전달
파이프 안에서 원본 입력을 보존해 뒤쪽 컴포넌트로 넘겨야 할 때가 있습니다. 예를 들어 RAG 시스템에서는 검색기가 원본 질의를 필요로 하고, 생성기는 검색 결과와 원본 질의를 함께 필요로 합니다.
from langchain_core.runnables import RunnablePassthrough

# 검색기 시뮬레이션
def retrieve(query: dict) -> str:
    return "검색된 문서 내용..."

# Chain 구성: 원본 query를 보존하면서 동시에 검색
chain = RunnableParallel(
    retrieved_docs=RunnableLambda(retrieve),
    original_query=RunnablePassthrough()
)

result = chain.invoke({"query": "LCEL이 무엇인가요?"})
print(result)
# 출력: {
#   'retrieved_docs': '검색된 문서 내용...',
#   'original_query': {'query': 'LCEL이 무엇인가요?'}
# }
RunnablePassthrough는 아무 일도 하지 않습니다. 입력을 그대로 내보낼 뿐입니다. 별 쓸모 없어 보이지만, 복잡한 파이프에서는 매우 중요합니다.
RunnableLambda: 커스텀 함수 변환
LangChain은 많은 기본 컴포넌트를 제공하지만, 항상 커스텀 로직이 필요한 상황이 생깁니다. RunnableLambda는 일반 Python 함수를 Runnable로 감싸 파이프 조합에 참여할 수 있게 합니다.
from langchain_core.runnables import RunnableLambda

# 포맷 함수 정의
def format_output(result: dict) -> str:
    """검색 결과를 Prompt 입력으로 포맷합니다."""
    docs = result["retrieved_docs"]
    query = result["original_query"]["query"]
    return f"참고 자료: {docs}\n사용자 질문: {query}\n자료를 바탕으로 답해 주세요:"

# 사용
chain = RunnableParallel(
    retrieved_docs=RunnableLambda(retrieve),
    original_query=RunnablePassthrough()
) | RunnableLambda(format_output)

formatted = chain.invoke({"query": "LCEL이 무엇인가요?"})
print(formatted)
# 출력: 참고 자료: 검색된 문서 내용...
#       사용자 질문: LCEL이 무엇인가요?
#       자료를 바탕으로 답해 주세요:
RunnableLambda의 유연성 덕분에 파이프 안의 “만능 접착제”처럼 사용할 수 있습니다. 어떤 Python 함수든 파이프 안에 넣을 수 있습니다.
RAG 파이프의 전체 구현
이 컴포넌트들을 조합하면 완성된 RAG 파이프는 다음과 같습니다.
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough, RunnableParallel, RunnableLambda
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings

# 1. 벡터 데이터베이스 초기화(예시)
embeddings = OpenAIEmbeddings()
# 실제 프로젝트에서는 여기서 실제 문서 벡터를 로드합니다.
vectorstore = FAISS.from_texts(
    ["LCEL은 LangChain의 표현식 언어입니다",
     "Pipe 연산자는 컴포넌트를 직렬로 연결하는 데 사용됩니다",
     "Runnable은 LCEL의 핵심 추상화입니다"],
    embeddings
)
retriever = vectorstore.as_retriever()

# 2. Prompt 정의
rag_prompt = ChatPromptTemplate.from_template(
    """아래 참고 자료를 바탕으로 사용자 질문에 답하세요.

참고 자료:
{context}

사용자 질문: {question}

정확하고 자세한 답변을 작성해 주세요:"""
)

# 3. 포맷 함수 정의(검색 결과를 문자열로 변환)
def format_docs(docs) -> str:
    return "\n".join(doc.page_content for doc in docs)

# 4. 완전한 RAG Chain 구성
rag_chain = (
    # 병렬 실행: 검색 + 원본 질문 전달
    RunnableParallel(
        context=retriever | RunnableLambda(format_docs),
        question=RunnablePassthrough()
    )
    # Prompt 조립
    | rag_prompt
    # 모델 호출
    | ChatOpenAI(model="gpt-4o-mini")
    # 출력 파싱
    | StrOutputParser()
)

# 5. 사용
answer = rag_chain.invoke("LCEL이 무엇인가요?")
print(answer)
# 출력: LCEL은 LangChain Expression Language이며, LangChain의 표현식 언어입니다...
이 RAG Chain의 구조를 흐름도로 그리면 다음과 같습니다.
{"question": "LCEL이 무엇인가요?"}
              ↓
    ┌─────────┴─────────┐
    ↓                   ↓
[retriever]        [Passthrough]
    ↓                   ↓
format_docs        question
    ↓                   ↓
    └─────────┬─────────┘
              ↓
        {"context": "...", "question": "..."}
              ↓
         [rag_prompt]
              ↓
           [model]
              ↓
          [parser]
              ↓
        "답변 내용..."
이 RAG 구현은 시리즈의 RAG 시스템 최적화 실전과 맞닿아 있습니다. 그 글을 함께 읽으면 검색 재정렬, 다중 경로 검색 같은 기법을 이 LCEL 구조에 바로 적용할 수 있다는 점을 알 수 있습니다.
5장: 기존 Chain에서 마이그레이션하기
프로젝트가 아직 LLMChain을 사용하고 있다면 LCEL로의 마이그레이션은 생각보다 어렵지 않습니다. 작년에 한 이커머스 프로젝트를 마이그레이션한 적이 있는데, 전체 고객지원 봇 모듈을 옮기는 데 이틀이 걸렸습니다. 여기서는 자주 쓰는 마이그레이션 패턴 몇 가지를 정리합니다.
LLMChain → Pipe 문법
가장 기본적인 마이그레이션입니다. LLMChain의 핵심은 Prompt + Model이므로, 마이그레이션 후에는 파이프로 직접 연결하면 됩니다.
# 기존 코드(LLMChain)
from langchain.chains import LLMChain
from langchain.prompts import PromptTemplate
from langchain_openai import OpenAI

llm = OpenAI(temperature=0.7)
prompt = PromptTemplate(
    template="사용자 질문: {question}\n답변해 주세요:",
    input_variables=["question"]
)
chain = LLMChain(llm=llm, prompt=prompt)
result = chain.run(question="...")

# 새 코드(LCEL)
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate

model = ChatOpenAI(temperature=0.7)
prompt = ChatPromptTemplate.from_template("사용자 질문: {question}\n답변해 주세요:")
chain = prompt | model
result = chain.invoke({"question": "..."})
주의할 점이 몇 가지 있습니다.
- 모델 클래스가 바뀝니다. 기존 코드는
OpenAI(Completion API)를 사용했지만, 새 코드는ChatOpenAI(Chat API)를 권장합니다. Chat API는 OpenAI의 주류 방향이고, Completion API는 점차 주변부로 밀려나고 있습니다. - Prompt 클래스가 바뀝니다.
PromptTemplate도 계속 쓸 수 있지만,ChatPromptTemplate은 system message와 다중 역할 대화 등 더 풍부한 형식을 지원합니다. - 호출 메서드가 바뀝니다.
chain.run()은chain.invoke()로 바뀌며, 반환값은 문자열에서 Message 객체로 바뀝니다. 텍스트를 얻으려면.content를 사용해야 합니다.
SequentialChain → RunnableParallel
기존 코드에서 SequentialChain으로 여러 단계를 직렬 연결했다면, LCEL에서는 파이프로 직접 이어 붙이면 됩니다.
# 기존 코드(SequentialChain)
from langchain.chains import SequentialChain, LLMChain

# 1단계: 제목 생성
title_chain = LLMChain(
    llm=llm, prompt=title_prompt,
    output_key="title"
)

# 2단계: 본문 생성
content_chain = LLMChain(
    llm=llm, prompt=content_prompt,
    output_key="content"
)

# 직렬 연결
full_chain = SequentialChain(
    chains=[title_chain, content_chain],
    input_variables=["topic"],
    output_variables=["title", "content"]
)
result = full_chain({"topic": "AI 개발"})
print(result["title"], result["content"])

# 새 코드(LCEL)
from langchain_core.runnables import RunnableParallel

# 두 분기 정의
title_chain = title_prompt | model
content_chain = content_prompt | model

# 병렬 실행(직렬이 필요하면 | 로 연결)
full_chain = RunnableParallel(
    title=title_chain,
    content=content_chain
)
result = full_chain.invoke({"topic": "AI 개발"})
print(result["title"].content, result["content"].content)
SequentialChain은 기본적으로 직렬 실행이며, 각 Chain이 이전 Chain이 끝나기를 기다립니다. LCEL의 RunnableParallel은 병렬 실행이어서 더 빠릅니다. 실제로 직렬 실행이 필요하다면, 예를 들어 두 번째 단계가 첫 번째 단계의 출력에 의존한다면 파이프로 연결하면 됩니다.
# 직렬: 첫 번째 단계 출력이 두 번째 단계로 전달됨
chain = (
    title_prompt | model | StrOutputParser()
    | (lambda title: {"topic": topic, "title": title})  # 중간 결과 전달
    | content_prompt | model
)
TransformChain → RunnableLambda
TransformChain은 Chain 안에 커스텀 처리 로직을 삽입할 때 사용했습니다. LCEL에서는 RunnableLambda로 이전합니다.
# 기존 코드(TransformChain)
from langchain.chains import TransformChain

def transform_func(inputs: dict) -> dict:
    text = inputs["text"]
    processed = text.upper()  # 어떤 처리
    return {"processed_text": processed}

transform_chain = TransformChain(
    input_variables=["text"],
    output_variables=["processed_text"],
    transform=transform_func
)

# 새 코드(RunnableLambda)
from langchain_core.runnables import RunnableLambda

def transform_func(inputs: dict) -> dict:
    text = inputs["text"]
    processed = text.upper()
    return {"processed_text": processed}

transform_chain = RunnableLambda(transform_func)
RunnableLambda는 더 유연합니다. input_variables와 output_variables를 명시적으로 선언하지 않아도 되고, 바로 파이프에 참여할 수 있습니다.
흔한 마이그레이션 함정
마이그레이션 과정에서 몇 가지 함정을 밟아 봤습니다.
함정 1: 반환값 타입이 바뀝니다

LLMChain의 run()은 문자열을 반환하지만, LCEL의 invoke()는 Message 객체를 반환합니다.
# 기존: 문자열을 바로 얻음
result = chain.run(...)  # str

# 새 방식: content를 꺼내야 함
result = chain.invoke(...)  # AIMessage
text = result.content  # str
해결 방법은 파이프 끝에 StrOutputParser를 추가해 Message를 자동으로 문자열로 바꾸는 것입니다.
chain = prompt | model | StrOutputParser()
result = chain.invoke(...)  # 바로 str 반환
함정 2: 메모리 컴포넌트 마이그레이션
기존 코드는 ConversationChain이 자체 메모리 기능을 가지고 있었습니다.
# 기존 코드
from langchain.chains import ConversationChain

chain = ConversationChain(llm=llm, memory=memory)
새 코드는 RunnableWithMessageHistory를 사용합니다.
from langchain_core.runnables import RunnableWithMessageHistory

chain = prompt | model
chain_with_memory = RunnableWithMessageHistory(
    chain,
    get_session_history=get_history,
    input_messages_key="input",
    history_messages_key="chat_history"
)
인자가 조금 많고, 입력 필드명과 이력 필드명을 명시적으로 지정해야 합니다. 자세한 사용법은 시리즈의 Agent 도구 호출 실전을 참고할 수 있습니다. 그 글에는 완성된 대화 시스템 예제가 있습니다.
함정 3: LangChain v0.3의 import 경로가 바뀌었습니다
많은 컴포넌트의 import 경로가 langchain에서 langchain_core 또는 langchain_community로 이동했습니다.
# 기존 import
from langchain.chains import LLMChain
from langchain.prompts import PromptTemplate

# 새 import
from langchain_core.runnables import RunnableLambda, RunnableParallel
from langchain_core.output_parsers import StrOutputParser
from langchain_community.chat_message_histories import ChatMessageHistory
IDE가 import 오류를 알려 주면, 안내를 따라 수정하면 됩니다.
프로덕션 마이그레이션 사례
작년에 마이그레이션한 이커머스 고객지원 봇은 원본 코드가 약 300줄이었고, LLMChain + SequentialChain + TransformChain을 사용하고 있었습니다. 마이그레이션 후 핵심 로직은 다음과 같았습니다.
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough, RunnableLambda

# 초기화
model = ChatOpenAI(model="gpt-4o-mini", temperature=0.5)

# Intent 분류 Prompt
intent_prompt = ChatPromptTemplate.from_template(
    """사용자 의도를 분석하고 다음 범주 중 하나를 반환하세요:
    - product_query(상품 상담)
    - order_status(주문 조회)
    - complaint(불만 및 제안)
    - other(기타)

    사용자 메시지: {message}
    의도 범주:"""
)

# 각 의도의 처리 Prompt
product_prompt = ChatPromptTemplate.from_template(
    "사용자가 상품을 문의했습니다: {message}\n상품 데이터베이스에서 검색해 답변하세요:"
)
order_prompt = ChatPromptTemplate.from_template(
    "사용자가 주문을 조회했습니다: {message}\n주문 상태를 조회해 답변하세요:"
)

# 분기 처리 로직 구성
def route_by_intent(result):
    intent = result.content.strip().lower()
    if "product" in intent:
        return "product"
    elif "order" in intent:
        return "order"
    else:
        return "default"

# 전체 Chain
intent_chain = intent_prompt | model | StrOutputParser() | RunnableLambda(route_by_intent)

# 분기 라우팅(의사 코드, 실제로는 RunnableBranch 필요)
full_chain = (
    {"message": RunnablePassthrough()}
    | RunnableParallel(
        intent=intent_chain,
        original=RunnablePassthrough()
    )
    # intent에 따라 다른 처리 분기 선택
    # ... 실제 코드에서는 RunnableBranch로 구현
)

# 스트리밍 출력
async for chunk in full_chain.astream({"message": "주문 12345 상태를 확인하고 싶습니다"}):
    print(chunk, end="", flush=True)
마이그레이션 후 코드는 150줄이 되었고 절반으로 줄었습니다. 더 중요한 점은 스트리밍 출력과 비동기 처리처럼 원래라면 추가 개발이 필요했던 기능을 이제 한 줄로 처리할 수 있다는 것입니다.
정리
LCEL은 LangChain v0.3+의 공식 권장 아키텍처입니다. Pipe 연산자로 코드를 단순화하고, Runnable 인터페이스로 호출 방식을 통일하며, 내장 스트리밍 지원으로 사용자 경험을 개선합니다.
마이그레이션 과정에서 가장 큰 도전은 문법 변환이 아니라 사고방식의 전환이었습니다. 전통적인 Chain은 “명시적 선언”을 강조해 각 Chain의 입력과 출력 필드를 모두 써야 했습니다. LCEL은 “암묵적 흐름”을 강조합니다. 데이터가 파이프 안에서 자동으로 전달되고, 타입 약속은 컴포넌트 내부에 숨어 있습니다.
기존 프로젝트가 아직 LLMChain을 사용하고 있다면 단계적으로 마이그레이션하는 것을 권합니다. 먼저 간단한 대화 Chain부터 옮기고, 그다음 복잡한 조합 로직을 처리하세요. 마이그레이션 중 LangSmith로 디버깅하면 타입 불일치 같은 문제를 빠르게 찾을 수 있습니다.
다음 단계로는 시리즈의 LangGraph 상태 관리 실전을 읽어 볼 수 있습니다. LangGraph는 LangChain 팀이 내놓은 차세대 Agent 프레임워크이며, LCEL과 함께 사용하면 더 복잡한 Agent 애플리케이션을 만들 수 있습니다. 단순한 Chain형 작업에는 LCEL을, 복잡한 상태 관리에는 LangGraph를 쓰는 조합이 현재로서는 꽤 성숙한 패턴입니다.
AI 개발 실전 시리즈 내비게이션
- 1편: Claude API 입문: 인증부터 멀티턴 대화까지
- 2편: Prompt Engineering 고급 실전
- 8편: RAG 시스템 최적화 실전: 검색 정확도와 생성 품질의 균형
- 11편: LangGraph 상태 관리 실전: 2026년 Agent 아키텍처 모범 사례
- 13편: LangChain LCEL 실전: 전통적인 Chain에서 스트리밍 응답까지의 현대적 패러다임(이 글)
- 14편: Agent 도구 호출 실전: AI가 외부 API와 서비스를 호출하게 만들기
LLMChain에서 LCEL로 마이그레이션하기
전통적인 LangChain 코드를 LCEL 파이프 문법으로 이전합니다.
⏱️ Estimated time: 2 hr
- 1
Step 1: 마이그레이션 대상 모듈 식별
프로젝트에서 LLMChain, SequentialChain, TransformChain을 사용하는 코드를 스캔합니다.
• grep으로 "from langchain.chains import" 검색
• 각 Chain의 입력 및 출력 변수 표시
• 메모리 컴포넌트나 콜백 함수 사용 여부 기록 - 2
Step 2: import 경로 업데이트
기존 import를 v0.3 경로로 교체합니다.
• from langchain.chains → from langchain_core.runnables
• from langchain.prompts import PromptTemplate → from langchain.prompts import ChatPromptTemplate
• from langchain_openai import OpenAI → from langchain_openai import ChatOpenAI - 3
Step 3: 기본 Chain 변환
파이프 연산자로 Prompt와 Model을 연결합니다.
• chain = LLMChain(llm=llm, prompt=prompt) → chain = prompt | model
• result = chain.run(...) → result = chain.invoke(...)
• 반환값 타입 변화를 처리하기 위해 StrOutputParser 추가 - 4
Step 4: 조합 Chain 처리
RunnableParallel 또는 파이프 연결로 여러 단계를 구성합니다.
• SequentialChain → RunnableParallel(병렬) 또는 | 연결(직렬)
• TransformChain → RunnableLambda로 커스텀 함수 래핑
• 중간 결과 전달에는 RunnablePassthrough 사용 - 5
Step 5: 메모리 컴포넌트 마이그레이션
ConversationChain 대신 RunnableWithMessageHistory를 사용합니다.
• input_messages_key와 history_messages_key를 명시적으로 지정해야 함
• get_session_history 함수로 세션 이력 관리 - 6
Step 6: 스트리밍 출력 활성화
invoke를 stream으로 바꾸기만 하면 스트리밍 기능을 얻을 수 있습니다.
• result = chain.invoke(...) → for chunk in chain.stream(...)
• 비동기 시나리오에서는 astream 사용
• Chain 정의는 수정할 필요 없음
FAQ
LCEL과 전통적인 LLMChain의 가장 큰 차이는 무엇인가요?
Runnable 인터페이스의 invoke/stream/batch는 어떻게 다른가요?
• invoke — 단일 호출, 전체 결과 반환(간단한 질의응답에 적합)
• stream — 스트리밍 호출, token을 하나씩 반환(실시간 채팅에 적합)
• batch — 배치 호출, 여러 입력을 병렬 처리(대량 작업에 적합)
각 메서드에는 ainvoke, astream, abatch라는 비동기 버전도 있습니다.
스트리밍 응답은 왜 사용자 경험을 개선하나요?
RunnableParallel과 파이프 연산자는 어떻게 다른가요?
기존 코드를 LCEL로 마이그레이션할 때 무엇을 주의해야 하나요?
• 반환값 타입 변화: LLMChain.run()은 문자열을 반환하지만 LCEL.invoke()는 Message 객체를 반환하므로 StrOutputParser가 필요합니다.
• 메모리 컴포넌트 이전: ConversationChain을 RunnableWithMessageHistory로 바꿀 때 필드명을 명시적으로 지정해야 합니다.
• import 경로 변화: 많은 컴포넌트가 langchain에서 langchain_core 또는 langchain_community로 이동했습니다.
LCEL은 어떤 상황에 적합하고, LangGraph는 어떤 상황에 적합한가요?
6분 읽기 · 게시일: 2026년 5월 4일 · 수정일: 2026년 10월 21일

AI 개발
검색으로 들어왔다면 같은 시리즈의 이전 글이나 다음 글로 이동하는 것이 가장 빠릅니다.
이전
멀티모달 AI 애플리케이션 개발 실전: 3개 모달리티 융합 완벽 가이드
GPT-4V, Gemini, Claude 세 플랫폼을 비교하고 텍스트, 이미지, 음성을 융합하는 전체 코드 예제와 시스템 아키텍처 설계 원칙, 비용 관리 방법을 소개해 멀티모달 개발의 핵심 역량을 빠르게 익힐 수 있도록 돕습니다.
8편 중 3편
다음
LLM 평가 프레임워크 비교: LangSmith vs W&B vs MLflow
LangSmith, Weights & Biases, MLflow 세 가지 주요 LLM 평가 프레임워크를 추적 기능, 평가 방식, 프로덕션 배포, 실제 비용 관점에서 깊이 비교해 최적의 선택을 돕습니다.
8편 중 5편


댓글
GitHub로 로그인하여 댓글을 남기세요