
Llama 70B 로컬 실행: 5700XT, Mac M4, CUDA 세 가지 선택지 비교 가이드
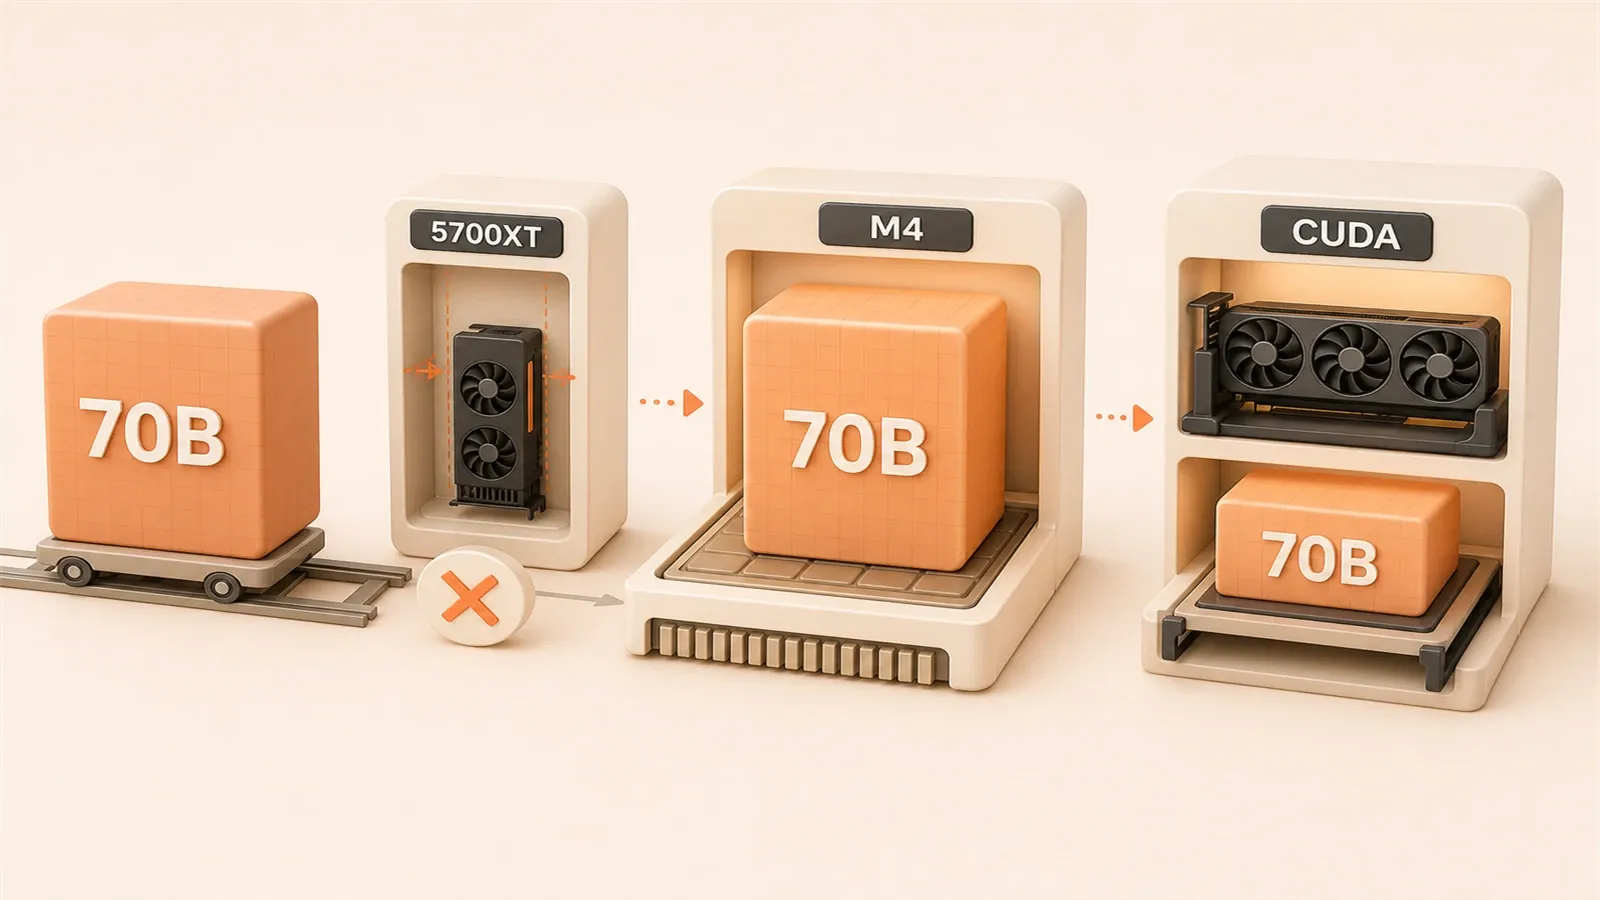
Llama 70B를 로컬에서 돌리고 싶으신가요? 손에 있는 AMD 5700XT의 8GB VRAM으로 충분할까요? Mac M4에서도 실행할 수 있을까요?
답은 조금 의외일 수 있습니다. 70B 모델의 FP16 전체 버전은 140GB VRAM이 필요합니다. 소비자용 하드웨어 입장에서는 사실상 불가능에 가깝습니다. 하지만 양자화 기술 덕분에 요구량이 40GB 안팎까지 내려오면서, 이야기가 갑자기 흥미로워집니다.
이 글에서는 흔히 고민하는 세 가지 선택지를 실측 데이터로 비교합니다. AMD 5700XT, 즉 이것저것 시도해 보는 사용자가 좋아할 만한 카드, 통합 메모리가 강점인 Mac M4, 그리고 오래된 강자인 NVIDIA CUDA입니다. 읽고 나면 대략 5분 안에 어떤 방식이 자신에게 맞는지 판단할 수 있을 것입니다.
Llama 70B의 VRAM 요구량, 실제로는 어느 정도일까
양자화는 간단히 말해 모델을 압축하는 일입니다. 원본 FP16 버전은 파라미터 하나가 2바이트를 차지합니다. 700억 개 파라미터를 곱하면 140GB VRAM이 필요합니다. RTX 4090의 24GB VRAM이 있어도 턱없이 부족합니다.
그렇다면 방법이 없을까요? 여기서 GGUF 형식의 양자화 버전이 등장합니다.
어떤 양자화 수준을 선택해야 할까?
양자화 수준에 따라 VRAM 사용량은 크게 달라집니다.
| 양자화 수준 | VRAM 요구량 | 정확도 손실 | 적합한 사용 시나리오 |
|---|---|---|---|
| Q8_0 | ~75GB | 매우 작음 | 정확도를 중시하는 연구와 실험 |
| Q6_K | ~55GB | 비교적 작음 | 64GB+ 메모리 보유 환경 |
| Q5_K_M | ~45GB | 수용 가능 | Mac 64GB 메모리 |
| Q4_K_M | ~35-40GB | 균형점 | 대부분의 소비자용 하드웨어 |
| Q3_K_M | ~30GB | 뚜렷함 | VRAM을 극단적으로 줄여야 하는 경우 |
저는 Q4_K_M을 추천합니다. 이유는 간단합니다. 이 수준이 정확도와 VRAM 사이에서 꽤 괜찮은 균형을 잡아 주기 때문입니다. Q3도 실행은 가능하다고 들어 보셨을 수 있지만, 정확도 손실이 제법 뚜렷합니다. 답변 품질이 떨어지고 논리 추론 능력도 손해를 봅니다. Q5 이상은 물론 더 좋지만, 그만큼 메모리 요구량이 다시 올라갑니다.
또 하나 잊지 말아야 할 것이 있습니다. 바로 KV Cache입니다. 추론 과정에서 모델은 컨텍스트 정보를 저장해야 하는데, 이 부분이 추가로 약 5GB를 차지합니다. 그래서 Q4_K_M 버전을 실제로 실행하려면 대략 40-45GB의 사용 가능한 메모리 공간이 필요합니다.

세 가지 하드웨어 선택지 실측 비교
먼저 표로 보겠습니다. 데이터는 Reddit LocalLLaMA 포럼과 여러 기술 블로그의 실측 보고를 기반으로 합니다.
| 선택지 | VRAM/메모리 | 실행 가능한 모델 | 70B Q4 성능 | 가격대 | 설정 난이도 |
|---|---|---|---|---|---|
| AMD 5700XT | 8GB VRAM | 7B 전체, 12B 일부 | 권장하지 않음 | 중고 $150-200 | 어려움 |
| Mac M4 Max | 128GB 통합 메모리 | 70B Q4/Q5 | 20-28 tok/s | $3500+ | 쉬움 |
| NVIDIA RTX 4090 | 24GB VRAM | 32B 전체, 70B offload | 18 tok/s (offload) | $1500-2000 | 보통 |
| NVIDIA RTX 5090 | 32GB VRAM | 70B Q4 단일 카드 | 예상 25+ tok/s | $2000+ | 쉬움 |
AMD 5700XT: 시도는 가능하지만 꽤 고된 선택
솔직히 말하면, 5700XT로 70B 모델을 돌리는 것은 거의 무리해서 밀어붙이는 선택에 가깝습니다. 8GB VRAM은 7B Q4도 겨우 넣는 수준이고, 70B는 현실적으로 어렵습니다. 그런데도 끝까지 해 보고 싶은 사람이 있습니다. 저도 ROCm workaround 방식을 직접 시도해 본 적이 있습니다.
결과는 어땠을까요? 안정적이지 않았습니다. 실행은 될 수 있지만 언제든 중단될 수 있습니다. AMD는 RDNA1 아키텍처의 ROCm을 공식 지원하지 않습니다. 5700XT가 바로 여기에 해당합니다. 그래서 커뮤니티에서 만든 환경 변수 우회 방식에 기대게 됩니다.
HSA_OVERRIDE_GFX_VERSION=10.1.0이 방법은 ROCm을 속여 실행하게 만들 수는 있지만, 성능은 평범하고 안정성도 낮습니다. 원리를 배우고 실험해 보고 싶은 목적이라면 시도해 볼 만합니다. 하지만 진지하게 매일 쓰려는 용도라면 권하기 어렵습니다.
Mac M4: 통합 메모리가 핵심 장점
Apple Silicon의 통합 메모리 구조는 대형 모델을 실행할 때 거의 결정적인 장점이 됩니다. 128GB M4 Max에서는 시스템 메모리와 GPU 메모리가 같은 풀을 공유합니다. 따라서 VRAM이 부족해서 시스템 메모리로 offload해야 하는 문제를 크게 신경 쓰지 않아도 됩니다.
실측 결과도 인상적입니다. 20-28 tok/s 수준입니다. 로컬 추론 환경에서는 꽤 쾌적한 속도입니다. 설정도 간단합니다. Ollama를 설치하거나 MLX를 바로 사용하면 몇 줄의 명령으로 실행할 수 있습니다.
유일한 문제는 가격입니다. M4 Max는 시작가가 $3500 이상이라 부담이 작지 않습니다. 다만 원래 다른 작업 때문에 Mac이 필요했다면, 대형 모델 실행까지 함께 고려했을 때 계산이 아주 나쁘지는 않습니다.
NVIDIA CUDA: 생태계는 성숙하지만 대형 모델은 offload가 필요
RTX 4090의 24GB VRAM은 32B 모델을 실행하기에는 충분합니다. 그렇다면 70B는 어떨까요? 부족합니다. 결국 offload 방식을 써야 합니다. 일부 레이어는 GPU에 올리고, 나머지는 시스템 메모리로 넘기는 방식입니다.
이 방식으로 실행은 가능하지만 속도는 떨어집니다. 실측 기준 약 18 tok/s 정도로, Mac M4 Max보다 조금 느립니다. CPU와 GPU 사이에서 데이터를 계속 옮기는 데 시간이 들기 때문입니다.
RTX 5090의 32GB VRAM은 상황이 조금 낫습니다. 70B Q4를 단일 카드에서 실행할 수 있을 것으로 보입니다. 다만 이 카드는 아직 정식 출시 전이며, 가격은 $2000부터 시작할 가능성이 큽니다.
CUDA의 강점은 생태계입니다. 모델을 파인튜닝하고 싶다면 NVIDIA의 도구 체인이 가장 완성도가 높습니다. PyTorch와 Hugging Face 모두 CUDA를 우선 지원합니다. 이 부분은 Apple Silicon이나 AMD가 따라가기 어렵습니다.
나에게 맞는 선택지는 어떻게 판단할까
복잡하게 고민할 필요는 없습니다. 아래 흐름대로 하나씩 확인하면 됩니다.

1단계: 지금 가지고 있는 하드웨어 확인하기
이미 5700XT가 있다면?
- ROCm workaround를 시도해 볼 수는 있지만, 꽤 많은 시행착오를 각오해야 합니다
- 실제로 실행 가능한 것은 7B 모델 정도입니다. 12B도 일부 offload가 필요합니다
- ROCm 원리를 배우고 문제를 직접 해결해 보고 싶은 사람에게 맞습니다
이미 Mac이 있다면?
- 메모리 용량을 확인하세요. 64GB면 70B Q5도 가능하고, 128GB면 더 여유롭습니다
- M4 Pro/Max가 더 좋지만, 기본형 M4도 활용할 수 있습니다
- 일단 직접 시도해 보세요. 성공률이 꽤 높습니다
아무것도 없다면?
- 다음의 예산 기준을 보세요
2단계: 예산으로 선택 좁히기
| 예산 범위 | 추천 선택지 | 설명 |
|---|---|---|
| <$500 | 중고 5700XT 또는 Mac Mini M4 입문형 | 5700XT는 위험 부담이 크고, M4 입문형 16GB 메모리는 작은 모델 위주입니다 |
| $500-2000 | RTX 4090 또는 Mac Mini M4 Pro | RTX 4090은 offload가 필요하고, M4 Pro 24GB 메모리는 70B 실행에 충분합니다 |
| $2000+ | RTX 5090 또는 Mac Studio M4 Max | 파인튜닝과 학습이 필요하면 NVIDIA, 순수 추론이면 Mac을 선택하세요 |
3단계: 무엇을 하려는지 정하기
그냥 테스트하고 체험해 보고 싶다면?
- 7B를 실행할 수 있는 하드웨어면 충분합니다. 굳이 70B부터 시작할 필요는 없습니다. 작은 모델만으로도 로컬 추론의 감각을 충분히 경험할 수 있습니다.
일상적으로 안정적으로 쓰고 싶다면?
- Mac M4 계열이 가장 편합니다. 소프트웨어만 설치하면 사용할 수 있고, CUDA 버전이나 ROCm 설정을 신경 쓸 일이 적습니다.
파인튜닝과 학습이 필요하다면?
- NVIDIA CUDA가 사실상 선택지입니다. 생태계 지원이 가장 좋고, 자료도 많으며, 문제 해결 사례도 가장 풍부합니다.
극한의 추론 속도를 원한다면?
- Mac M4 Max의 MLX 가속은 llama.cpp보다 30-50% 빠릅니다. 이 부분은 아래에서 조금 더 설명하겠습니다.
대부분의 사용자는 사실 두 번째 유형에 가깝습니다. 일상적으로 안정적인 환경을 원합니다. 이 면에서는 Mac의 장점이 분명합니다. 그래픽 드라이버를 붙잡고 시간을 쓰지 않아도 되고, 호환성 문제로 고생할 가능성도 낮습니다. 거의 바로 사용할 수 있습니다.
Mac 사용자의 MLX vs llama.cpp 선택
Mac 사용자에게는 추가로 고민할 지점이 하나 있습니다. MLX를 쓸지, llama.cpp를 쓸지입니다.
성능 비교
Compute Market의 실측 데이터에 따르면 다음과 같습니다.
| 시나리오 | MLX | llama.cpp | 차이 |
|---|---|---|---|
| 짧은 prompt (<512 tokens) | 더 빠름 | 기준 | MLX가 30-50% 빠름 |
| 긴 prompt (>2048 tokens) | 기준 | 더 빠름 | llama.cpp가 약간 유리 |
| 전체 추론 속도 | ~25 tok/s | ~20 tok/s | MLX 우세 |
MLX는 Apple이 Silicon 칩에 맞춰 최적화한 프레임워크이며, Metal GPU 가속을 직접 활용할 수 있습니다. llama.cpp는 크로스 플랫폼 방식입니다. Metal도 지원하지만 최적화 수준은 MLX만큼은 아닙니다.

무엇을 고르면 좋을까?
순수 추론이 목적이고 속도가 중요하다면?
- MLX를 쓰세요.
mlx_lm.generate명령으로 바로 실행할 수 있고, 설정이 간단하며 속도도 빠릅니다.
llama.cpp 도구 체인과의 호환성이 필요하다면?
- 예를 들어 llama.cpp에 의존하는 서드파티 도구를 쓰고 싶거나, 같은 GGUF 파일을 여러 장치 사이에서 옮겨 쓰고 싶다면 llama.cpp가 낫습니다. 호환성이 더 좋고 거의 모든 플랫폼에서 실행됩니다.
확신이 없다면?
- 둘 다 시도해 보세요. 설치가 크게 어렵지 않으므로 실제로 한 번 돌려 보면 자신의 사용 습관에 어느 쪽이 더 맞는지 금방 알 수 있습니다.
개인적으로는 MLX 쪽을 선호합니다. 제 주된 사용 시나리오가 로컬 추론이라면, 충분히 빠른 속도가 가장 중요하기 때문입니다. 도구 체인 호환성은 제게 필수 조건은 아닙니다.
정리
마지막으로 빠른 의사결정 표를 정리해 보겠습니다.
| 현재 상황 | 추천 선택지 | 이유 |
|---|---|---|
| 이미 Mac이 있고 메모리가 64GB 이상 | 그대로 사용하고 MLX 선택 | 가장 편하고 속도도 좋음 |
| 하드웨어가 없고 예산이 <$500 | Mac Mini M4 입문형 | 5700XT보다 안정적이고 위험이 낮음 |
| 예산이 $500-2000이고 안정성이 중요함 | Mac Mini M4 Pro | 24GB 메모리로 70B 실행 가능 |
| 예산이 $2000+이고 파인튜닝이 필요함 | RTX 4090/5090 | CUDA 생태계가 성숙함 |
| ROCm을 배우며 실험하고 싶음 | 중고 5700XT | 저렴하지만 시행착오를 각오해야 함 |
핵심 결론은 한 문장으로 정리할 수 있습니다. Mac은 편하고 안정적이며, CUDA는 생태계가 넓고, AMD는 가성비가 있지만 손이 많이 갑니다.
목적이 진지한 사용이고 설정에 시간을 쓰고 싶지 않다면 Mac을 고르세요. 예산이 빠듯하고 직접 문제를 해결하는 과정을 감수할 수 있다면 5700XT도 시도해 볼 수 있지만, 70B에 대해서는 기대치를 낮추는 편이 좋습니다. 모델 파인튜닝을 해야 한다면 NVIDIA CUDA가 사실상 정답입니다.
직접 해 보고 싶다면 Mac 사용자는 Ollama나 MLX를 설치해 7B 모델부터 실행해 보세요. Mac이 없다면 먼저 현재 하드웨어로 작은 모델을 실행할 수 있는지 확인하는 것이 좋습니다. 70B는 출발점이 아닙니다. 일단 실행해 보고, 그다음에 확장해도 늦지 않습니다.
FAQ
Llama 70B를 실행하려면 VRAM이 얼마나 필요한가요?
Mac M4와 NVIDIA 중 어느 쪽이 대형 모델 실행에 더 적합한가요?
예산이 제한적이라면 어떤 하드웨어를 고르면 좋나요?
AMD 5700XT로 Llama 70B를 실행할 수 있나요?
Mac에서는 MLX와 llama.cpp 중 무엇을 써야 하나요?
2분 읽기 · 게시일: 2026년 5월 28일 · 수정일: 2026년 10월 21일

Ollama 로컬 LLM 가이드
검색으로 들어왔다면 같은 시리즈의 이전 글이나 다음 글로 이동하는 것이 가장 빠릅니다.
이전
Ollama Modelfile 매개변수 완벽 해설: 나만의 커스텀 모델 만들기
Ollama Modelfile의 핵심 매개변수 10개와 temperature, num_ctx 등의 튜닝 방법을 자세히 설명하고, 바로 사용할 수 있는 실전 템플릿 4개로 나만의 커스텀 모델을 만드는 방법을 안내합니다.
18편 중 4편
다음
Ollama 하드웨어 선택표: VRAM, 양자화, GPU 대조 가이드(2026)
완전한 Ollama 하드웨어 선택 대조표입니다. 7B/13B/70B 모델의 VRAM 요구량, Q4/Q8 양자화 비교, NVIDIA CUDA/AMD ROCm/Apple Metal 3대 가속 기술을 정리했습니다. RTX 3060부터 5090까지 단계별 추천으로 GPU와 모델을 빠르게 맞춰 보세요.
18편 중 6편


댓글
GitHub로 로그인하여 댓글을 남기세요