
Llama 70B local: guia para comparar 5700XT, Mac M4 e CUDA
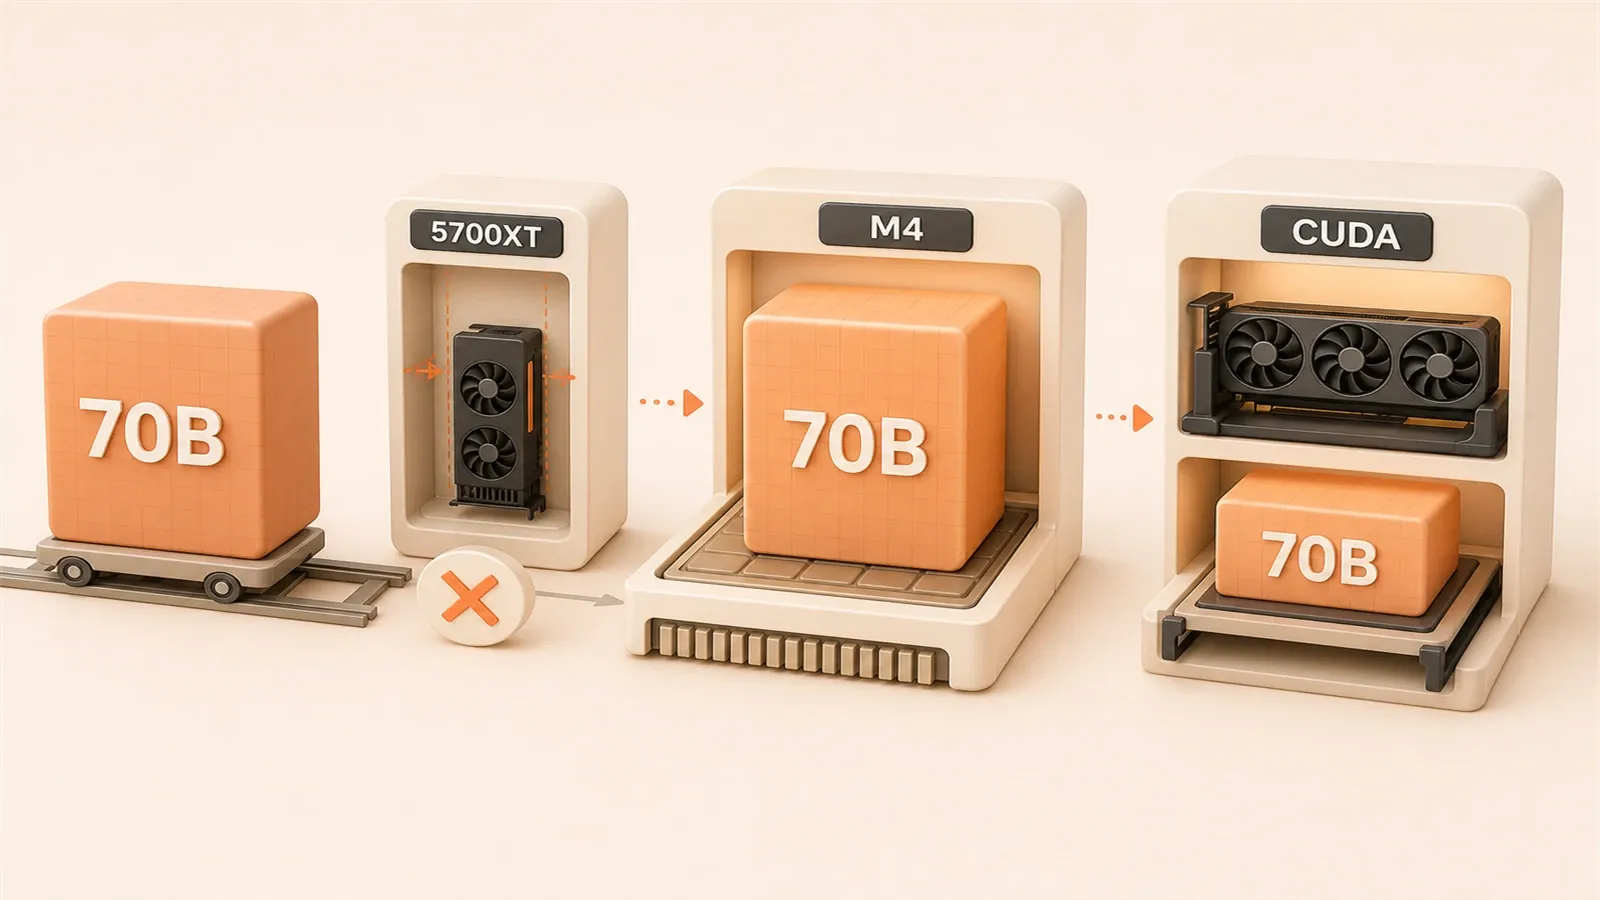
Quer rodar o Llama 70B localmente? A AMD 5700XT com 8GB de VRAM que você tem na máquina dá conta? E um Mac M4, consegue?
A resposta talvez surpreenda. A versão FP16 completa de um modelo 70B precisa de 140GB de VRAM. Para hardware de consumo, isso basicamente significa: sem chance. Mas a quantização derrubou a barreira para algo perto de 40GB, e aí a conversa ficou bem mais interessante.
Este guia compara três caminhos comuns com dados práticos: AMD 5700XT, a queridinha de quem gosta de se virar com hardware barato; Mac M4, com a vantagem enorme da memória unificada; e NVIDIA CUDA, o ecossistema clássico e mais maduro. Em uns 5 minutos, você deve conseguir decidir qual caminho faz sentido para o seu caso.
A verdade sobre a VRAM necessária para o Llama 70B
Quantização, em termos simples, é uma forma de comprimir o modelo. Na versão FP16 original, cada parâmetro ocupa 2 bytes. Multiplique isso por 70 bilhões de parâmetros e chegamos a cerca de 140GB de VRAM. Mesmo uma RTX 4090 com 24GB ainda fica muito longe disso.
Então o que fazer? Entram as versões quantizadas em formato GGUF.
Como escolher o nível de quantização?
Cada nível de quantização muda bastante o consumo de memória:
| Nível de quantização | VRAM necessária | Perda de precisão | Cenário indicado |
|---|---|---|---|
| Q8_0 | ~75GB | Mínima | Pesquisa e experimentos que priorizam precisão |
| Q6_K | ~55GB | Pequena | Máquinas com 64GB+ de memória |
| Q5_K_M | ~45GB | Aceitável | Mac com 64GB de memória |
| Q4_K_M | ~35-40GB | Ponto de equilíbrio | Maioria dos hardwares de consumo |
| Q3_K_M | ~30GB | Visível | Compressão extrema de VRAM |
Minha recomendação é Q4_K_M. Por quê? Esse nível encontra um bom equilíbrio entre precisão e uso de memória. Talvez você já tenha ouvido que Q3 também roda, mas a perda de qualidade começa a aparecer: as respostas pioram e a capacidade de raciocínio lógico cai. Q5 ou superior é melhor, claro, mas a exigência de memória sobe junto.
Também não esqueça o KV Cache. Durante a inferência, o modelo precisa armazenar informações de contexto, e isso adiciona mais uns 5GB. Na prática, para rodar a versão Q4_K_M, você deve contar com algo entre 40GB e 45GB de memória disponível.

Comparativo prático de três opções de hardware
Vamos direto à tabela. Os dados vêm do fórum Reddit LocalLLaMA e de testes publicados por alguns blogs técnicos.
| Opção | VRAM/memória | Modelos viáveis | Desempenho em 70B Q4 | Faixa de preço | Dificuldade de configuração |
|---|---|---|---|---|---|
| AMD 5700XT | 8GB VRAM | 7B completo, 12B parcial | Não recomendado | Usada por $150-200 | Difícil |
| Mac M4 Max | 128GB de memória unificada | 70B Q4/Q5 | 20-28 tok/s | $3500+ | Simples |
| NVIDIA RTX 4090 | 24GB VRAM | 32B completo, 70B com offload | 18 tok/s (offload) | $1500-2000 | Média |
| NVIDIA RTX 5090 | 32GB VRAM | Tentativa de 70B Q4 em placa única / offload | Depende do contexto | $2000+ | Média |
AMD 5700XT: o pesadelo de quem gosta de mexer em tudo
Falando sem rodeios, rodar um modelo 70B na 5700XT é basicamente insistir contra a realidade. Com 8GB de VRAM, até um 7B Q4 entra apertado; 70B, nem pensar. Mesmo assim, sempre tem gente que tenta. Eu mesmo já testei o workaround com ROCm.
O resultado? Instável. Dá para fazer rodar, mas pode quebrar a qualquer momento. A AMD não oferece suporte oficial a ROCm para a arquitetura RDNA1, que é o caso da 5700XT. O que funciona depende de uma variável de ambiente criada pela comunidade:
HSA_OVERRIDE_GFX_VERSION=10.1.0Esse truque engana o ROCm e permite executar algumas coisas, mas o desempenho é mediano e a estabilidade é ruim. Se a sua ideia é aprender mexendo e aceitar as armadilhas, vale experimentar. Para uso sério? Melhor deixar pra lá.
Mac M4: memória unificada é o diferencial real
A arquitetura de memória unificada do Apple Silicon é quase feita sob medida para rodar modelos grandes. Em um M4 Max com 128GB, a memória do sistema e a memória usada pela GPU fazem parte do mesmo espaço. Você não precisa se preocupar com o clássico problema de faltar VRAM e jogar camadas para a RAM via offload.
Os testes são bem fortes: 20-28 tok/s. Para inferência local, é uma velocidade bastante confortável. A configuração também é simples: instale o Ollama ou use MLX diretamente, e alguns comandos já colocam tudo para rodar.
O único problema é o preço. Um M4 Max parte de algo na casa de $3500+, o que não é pouco. Mas se você já precisa de um Mac para outro trabalho e quer rodar modelos grandes como bônus, a conta começa a fazer mais sentido.
NVIDIA CUDA: ecossistema maduro, mas modelos grandes dependem de offload
A RTX 4090 tem 24GB de VRAM e roda modelos 32B com bastante folga. E 70B? Não cabe. Você precisa usar offload: parte das camadas fica na GPU e o restante vai para a memória do sistema.
Funciona, mas a velocidade cai. Nos testes, fica por volta de 18 tok/s, um pouco atrás do Mac M4 Max. O motivo é simples: mover dados entre CPU e GPU custa tempo.
A RTX 5090 já foi lançada com 32GB de GDDR7. Ela é uma candidata melhor que a RTX 4090 para tentar 70B Q4 em uma única placa, mas contextos longos e overhead de execução ainda podem exigir offload. Preço e disponibilidade também variam.
A grande vantagem do CUDA é o ecossistema. Quer fazer fine-tuning? A cadeia de ferramentas da NVIDIA é a mais completa. PyTorch e Hugging Face priorizam CUDA. Nesse ponto, Apple Silicon e AMD ainda ficam atrás.
Como decidir qual opção faz sentido para você
Não precisa transformar isso em uma dúvida eterna. Siga o fluxo abaixo.

Passo 1: veja o que você já tem
Já tem uma 5700XT?
- Dá para testar o workaround do ROCm, mas vá preparado para lutar com configuração
- Na prática, o que roda mesmo é modelo 7B; até 12B tende a precisar de offload parcial
- Faz sentido para quem quer entender ROCm e aceita cair em algumas armadilhas
Já tem um Mac?
- Confira a memória: 64GB roda 70B Q5; 128GB é bem mais confortável
- M4 Pro/Max entrega desempenho melhor, mas o M4 básico também serve para começar
- Vale testar direto, porque a chance de funcionar é alta
Não tem nada disso?
- Então olhe primeiro para o orçamento
Passo 2: deixe o orçamento decidir
| Faixa de orçamento | Opção recomendada | Observação |
|---|---|---|
| <$500 | 5700XT usada ou Mac Mini M4 de entrada | A 5700XT tem risco alto; o M4 de entrada, com 16GB, só roda modelos pequenos |
| $500-2000 | RTX 4090 ou Mac Mini M4 Pro | A RTX 4090 depende de offload para 70B; o M4 Pro com 24GB combina melhor com 7B/13B e parte dos 32B |
| $2000+ | RTX 5090 ou Mac Studio M4 Max | Se precisa de fine-tuning, escolha NVIDIA; para inferência pura, escolha Mac |
Passo 3: o que você quer fazer?
Só quer testar e brincar?
- Qualquer hardware capaz de rodar 7B já basta. Não precisa começar se desgastando com 70B; modelos menores já dão uma boa noção de inferência local.
Uso diário, com estabilidade?
- A linha Mac M4 é a opção mais tranquila. Instale o software e use, sem gastar tempo com versão de CUDA ou configuração de ROCm.
Vai fazer fine-tuning?
- NVIDIA CUDA é praticamente a escolha óbvia. O suporte do ecossistema é o mais completo, há mais tutoriais, e as armadilhas são menores.
Busca a maior velocidade de inferência possível?
- O MLX no Mac M4 Max pode ser 30-50% mais rápido que llama.cpp. Vamos detalhar isso abaixo.
Na prática, a maioria das pessoas cai no segundo caso: uso diário e estabilidade. O Mac tem uma vantagem clara aqui. Você não precisa mexer em driver de GPU, nem ficar pensando em compatibilidade. É bem mais perto de ligar e usar.
MLX vs llama.cpp para usuários de Mac
Quem usa Mac ainda precisa escolher entre MLX e llama.cpp.
Comparativo de desempenho
Segundo dados de teste da Compute Market:
| Cenário | MLX | llama.cpp | Diferença |
|---|---|---|---|
| Prompt curto (<512 tokens) | Mais rápido | Base de comparação | MLX 30-50% mais rápido |
| Prompt longo (>2048 tokens) | Base de comparação | Mais rápido | llama.cpp tem leve vantagem |
| Velocidade geral de inferência | ~25 tok/s | ~20 tok/s | MLX lidera |
MLX é o framework que a Apple otimizou especificamente para chips Silicon e consegue chamar a aceleração via Metal GPU diretamente. Já o llama.cpp é uma solução multiplataforma. Ele também suporta Metal, mas não no mesmo nível de integração do MLX.

Como escolher?
Inferência pura e foco em velocidade?
- Use MLX. O comando
mlx_lm.generatejá resolve, a configuração é simples e a velocidade é boa.
Precisa ser compatível com a cadeia de ferramentas do llama.cpp?
- Se você usa ferramentas de terceiros que dependem de llama.cpp, ou quer migrar o mesmo arquivo GGUF entre dispositivos diferentes, escolha llama.cpp. A compatibilidade é melhor, e ele roda em quase qualquer plataforma.
Ainda não tem certeza?
- Teste os dois. A instalação não é tão complicada, e alguns testes práticos mostram rapidamente qual combina melhor com seu uso.
Eu, pessoalmente, prefiro MLX. Meu cenário principal é inferência local, então velocidade suficiente pesa mais do que compatibilidade com toda a cadeia de ferramentas.
Resumo
Depois de tudo isso, dá para fechar com uma tabela de decisão rápida:
| Sua situação | Opção recomendada | Motivo |
|---|---|---|
| Já tem Mac com 64GB+ de memória | Use direto, preferindo MLX | É o caminho mais tranquilo e com boa velocidade |
| Não tem hardware e o orçamento é <$500 | Mac Mini M4 de entrada | Mais estável que a 5700XT e com menos risco |
| Orçamento de $500-2000 e quer estabilidade | Mac Mini M4 Pro ou RTX 4090 | 24GB combina melhor com 7B/13B; 70B exige 64GB+ ou offload |
| Orçamento de $2000+ e quer fine-tuning | RTX 4090/5090 | Ecossistema CUDA maduro |
| Quer aprender mexendo com ROCm | 5700XT usada | Barata, mas prepare-se para armadilhas |
A conclusão central é simples: Mac é estável e exige menos trabalho, CUDA tem o ecossistema mais completo, e AMD pode sair barato, mas cobra em tempo e paciência.
Se a sua necessidade é uso sério e você não quer perder horas brigando com configuração, escolha Mac. Se o orçamento está apertado e você aceita cair em algumas armadilhas, a 5700XT pode servir para experimentar, mas não crie grandes expectativas para 70B. Se o objetivo é fine-tuning de modelos, NVIDIA CUDA segue sendo a escolha natural.
Quer colocar a mão na massa? Quem tem Mac pode instalar Ollama ou MLX e começar por um modelo 7B. Quem não tem Mac deve primeiro ver se o hardware atual roda algum modelo menor. 70B não precisa ser o ponto de partida: comece rodando algo menor e evolua a partir daí.
FAQ
Quanta VRAM é necessária para rodar o Llama 70B?
Mac M4 ou NVIDIA: qual é melhor para rodar modelos grandes?
Qual hardware escolher com orçamento limitado?
A AMD 5700XT roda Llama 70B?
No Mac, é melhor usar MLX ou llama.cpp?
9 min de leitura · Publicado em: 28 mai 2026 · Atualizado em: 14 jul 2026

Guia Ollama LLM local
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Ollama Modelfile: parâmetros e modelos personalizados
Entenda os 10 principais parâmetros do Ollama Modelfile, ajuste temperature e num_ctx e use quatro modelos prontos para criar versões personalizadas.
Parte 4 de 18
Próximo
Tabela de hardware para Ollama: VRAM, quantização e guia de GPU (2026)
Uma tabela completa para escolher hardware para Ollama: requisitos de VRAM para modelos 7B/13B/70B, comparativo de quantização Q4/Q8 e detalhes de NVIDIA CUDA, AMD ROCm e Apple Metal. Da RTX 3060 a 5090, veja como combinar GPU e modelo.
Parte 6 de 18


Comentários
Entre com GitHub para comentar