
Nginx 로드 밸런싱 실전: upstream 설정과 헬스 체크
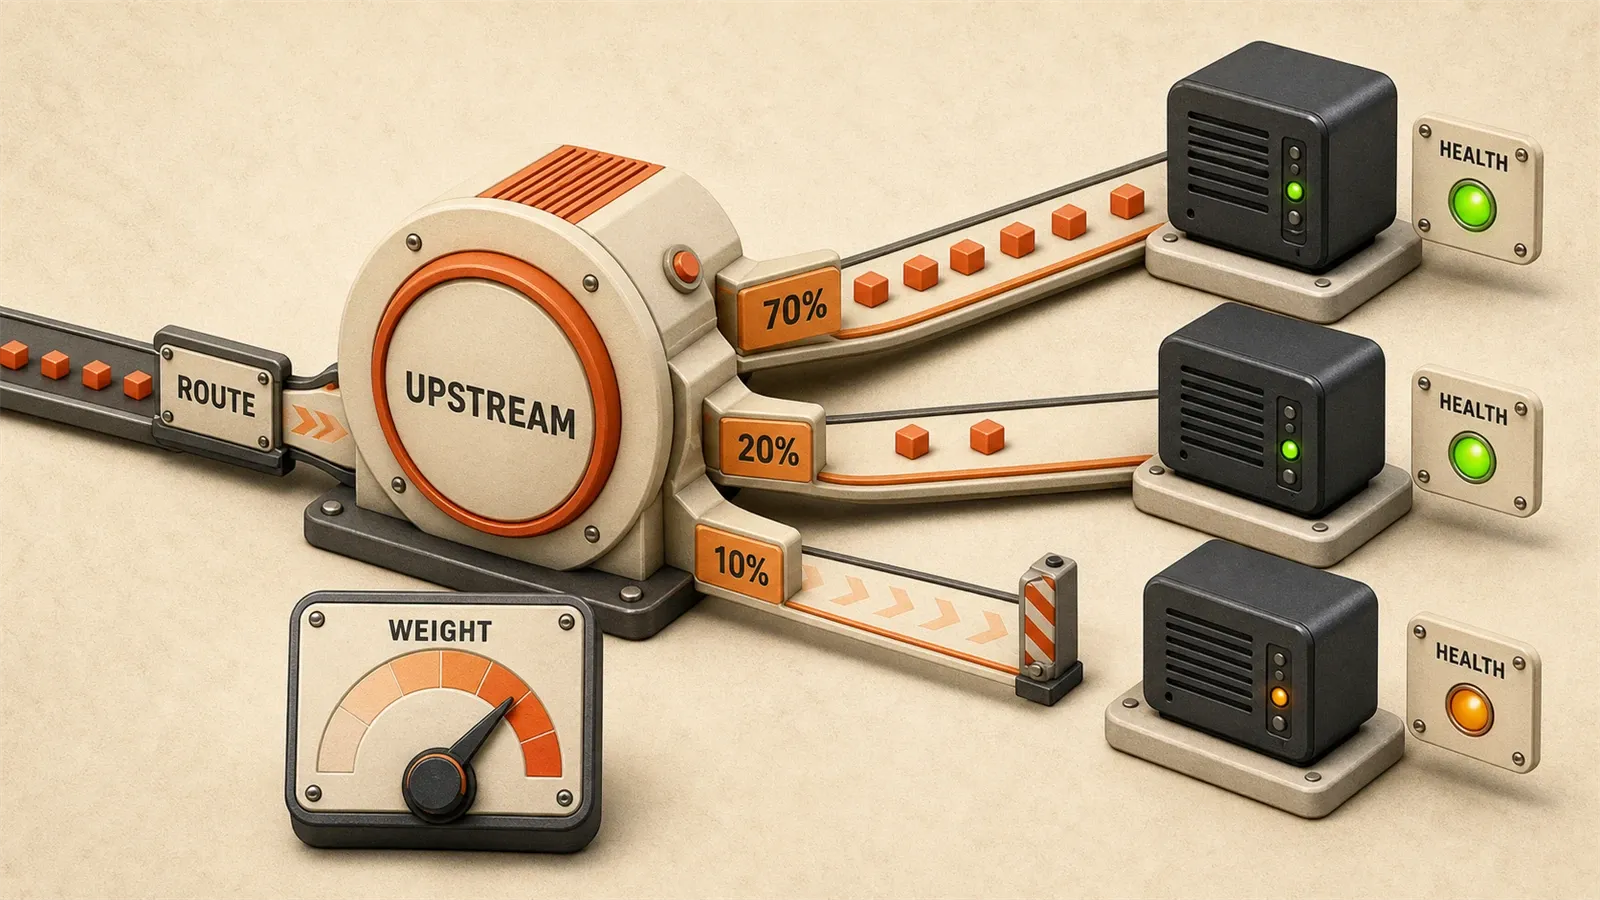
휴대폰이 계속 진동했습니다. 모니터링 패널을 열어 보니 backend1 상태가 온통 빨간색이었습니다. 단일 애플리케이션 서버 하나가 죽은 겁니다.
그해 Double 11 (중국의 대형 쇼핑 행사) 프로모션 때 백엔드 서버는 두 대뿐이었습니다. Nginx 설정에는 upstream backend { server backend1; server backend2; }라고 적혀 있었고, 겉보기에는 균형 잡혀 보였습니다. 하지만 backend1이 트래픽의 70%를 받고 있었습니다. 설정 파일에서 첫 번째에 있었고, 기본 라운드 로빈을 쓰면서 가중치도 헬스 체크도 설정하지 않았기 때문입니다.
backend1이 죽는 순간에도 사용자의 주문 요청은 계속 그 죽은 서버로 향했습니다. Nginx는 서버가 죽었다는 사실을 몰랐고 계속 요청을 넘겼습니다. 사용자가 본 것은 500 오류 페이지였습니다. 운영팀이 수동으로 backend1을 upstream에서 제거했을 때는 이미 15분이 지나 있었습니다.
그 일을 겪고 나서야 제대로 공부했습니다. Nginx upstream은 서버 주소를 나열하는 것만으로 끝나지 않습니다. 가중치 분배, 헬스 체크, 장애 조치가 운영 환경에서 진짜 필요한 부분입니다. 이 글에서는 제가 겪은 함정과 이후 정리한 설정 방법을 다룹니다. 오픈소스 Nginx에서 능동 헬스 체크를 구현하는 방법도 포함합니다.
1. upstream 기본 설정: 단일 서버에서 클러스터로
upstream 블록의 핵심 역할은 단순합니다. 여러 서버를 하나의 논리 그룹으로 묶고, Nginx가 요청을 어디로 보낼지 알게 하는 것입니다. 다만 파라미터는 많은 사람이 생각하는 것보다 훨씬 풍부합니다.
upstream backend {
  zone backend 64k;
  server backend1.example.com weight=3 max_fails=2 fail_timeout=30s;
  server backend2.example.com;
  server backup1.example.com backup;
}
한 줄씩 보면 이렇습니다.
zone backend 64k: 공유 메모리 영역입니다. Nginx의 worker 프로세스들은 백엔드 서버 상태 정보, 즉 누가 살아 있고 누가 죽었는지를 공유해야 합니다. 64k는 시작값으로 충분하고, 서버 수가 많으면 적절히 키우면 됩니다. 이 설정이 없으면 worker마다 상태를 따로 관리하므로 문제가 생길 수 있습니다.
weight=3: 가중치입니다. backend1의 가중치는 3이고 backend2는 기본값 1입니다. 즉 요청 4개 중 3개는 backend1로, 1개는 backend2로 갑니다. 백엔드 서버 사양이 서로 다를 때 적합합니다. 예를 들어 backend1은 8코어 16GB이고 backend2는 4코어 8GB인 상황입니다.
max_fails=2: 실패 횟수 임계값입니다. fail_timeout 시간 창 안에서 이 서버에 대한 요청이 2번 실패하면 Nginx는 해당 서버를 사용할 수 없는 상태로 표시합니다. 기본값은 1회인데, 너무 민감합니다. 네트워크가 한 번 흔들린 것만으로도 트리거되므로 운영 환경에는 맞지 않습니다. 운영 환경에서는 2 또는 3을 권장합니다.
fail_timeout=30s: 두 가지 의미가 있습니다. 첫째, 실패 횟수를 세는 시간 창이 30초입니다. 둘째, 서버가 사용할 수 없는 상태로 표시된 뒤 Nginx는 30초 후 다시 연결을 시도합니다. 기본값은 10초인데, 느리게 시작하는 일부 서비스에는 부족할 수 있습니다.
backup: 예비 서버입니다. 모든 주 서버를 사용할 수 없을 때만 backup 서버가 요청을 받습니다. 낮은 사양의 서버를 최후의 보호 장치로 둘 때 적합합니다.
또 하나의 파라미터로 down이 있습니다. 서버를 수동으로 오프라인 표시할 때 사용하며, 유지보수에 자주 씁니다.
server backend3.example.com down; # 임시 오프라인 유지보수실제로 써 보면서 많은 사람이 zone 설정을 놓친다는 것을 알게 됐습니다. 결과적으로 worker 프로세스가 각자 상태를 관리하고, 어떤 worker는 서버 장애를 발견했는데 다른 worker는 여전히 그 서버로 요청을 보냅니다. zone을 추가하면 상태 동기화 문제가 해결됩니다.
2. 다섯 가지 로드 밸런싱 전략: 언제 무엇을 써야 할까?
기본 round-robin 라운드 로빈 전략만으로 충분할까요? 상황에 따라 다릅니다.

많은 프로젝트가 기본 라운드 로빈으로 몇 년씩 문제없이 운영되는 것도 봤습니다. 하지만 WebSocket 긴 연결, 장바구니 session, 캐시 관통 같은 상황을 만나면 기본 전략이 잘 맞지 않는다는 것을 알게 됩니다. 아래 표는 제가 정리한 선택 가이드입니다.
| 상황 | 추천 전략 | 이유 |
|---|---|---|
| 무상태 API | round-robin | 균등 분배, 별도 처리 불필요 |
| WebSocket 서비스 | least_conn | 연결 수를 동적으로 감시해 특정 서버 과부하 방지 |
| 이커머스 장바구니 | ip_hash | 같은 사용자의 요청을 같은 서버로 보냄 |
| 캐시 프록시 | hash key=$uri | 캐시 무효화와 관통 감소 |
| 테스트 환경 | random | 빠른 검증, 간단한 설정 |
round-robin(기본 라운드 로빈)
아무것도 설정하지 않으면 라운드 로빈입니다. 요청은 순서대로 각 서버에 전달됩니다.
upstream backend {
  server backend1.example.com;
  server backend2.example.com;
  server backend3.example.com;
}
무상태 서비스에 적합합니다. 각 요청이 독립적이고 이전 요청 상태에 의존하지 않는 경우입니다. 대부분의 REST API가 여기에 해당합니다.
least_conn(최소 연결)
현재 연결 수가 가장 적은 서버에 우선 요청을 보냅니다.
upstream websocket_app {
  least_conn;
  server ws1.example.com:8080;
  server ws2.example.com:8080;
}
WebSocket 서비스가 대표적인 상황입니다. 사용자 하나가 긴 연결 하나를 만들고, 연결 수 변동이 큽니다. 라운드 로빈을 쓰면 어떤 서버에는 긴 연결이 많이 쌓였는데 새 요청도 계속 그 서버로 갈 수 있습니다. least_conn은 연결 수를 실시간으로 감시해 새 요청을 부하가 가장 낮은 서버로 보냅니다.
ip_hash(IP 해시)
클라이언트 IP 주소로 해시값을 계산하고, 같은 IP의 요청은 항상 같은 서버로 보냅니다.
upstream shopping_cart {
  ip_hash;
  server cart1.example.com;
  server cart2.example.com;
}
session 일관성이 필요한 상황에 적합합니다. 예를 들어 이커머스 장바구니에서 사용자가 cart1에 상품을 담았는데 다음 요청이 라운드 로빈으로 cart2에 가면 장바구니 데이터를 찾지 못합니다. 분산 session 저장소를 쓰지 않는다면 말입니다. ip_hash는 이 문제를 해결합니다.
다만 ip_hash에는 한계가 있습니다. 어떤 서버가 죽으면 원래 그 서버로 해시되던 사용자는 다시 배정됩니다. 이 사용자들의 session은 사라질 수 있습니다. 그래서 ip_hash는 session 데이터가 그리 중요하지 않은 상황이나 session 공유 저장소와 함께 쓸 때 적합합니다.
hash(일관성 해시)
사용자 정의 해시 키를 사용하고 일관성 해시 알고리즘을 지원합니다.
upstream cache_proxy {
  hash $uri consistent;
  server cache1.example.com;
  server cache2.example.com;
}
캐시 프록시에 가장 먼저 고려할 전략입니다. $uri는 요청 경로를 해시 키로 씁니다. consistent 파라미터는 일관성 해시를 활성화합니다. 서버가 늘거나 줄어도 일부 key만 다시 매핑되고 전체가 섞이지 않습니다. 그래서 캐시 적중률이 크게 떨어지지 않습니다.
random
단순히 무작위로 분배합니다.
upstream test_backend {
  random;
  server test1.example.com;
  server test2.example.com;
}
테스트 환경에는 충분합니다. 운영 환경에서는 제어력이 부족하므로 권장하지 않습니다.
솔직히 제 경험으로는 대부분의 Web 애플리케이션은 round-robin 또는 least_conn이면 충분합니다. ip_hash와 hash는 특정 상황을 위한 해법입니다. 단지 더 고급스러워 보이려고 억지로 쓸 필요는 없습니다.
3. 수동 헬스 체크: max_fails와 fail_timeout
수동이라는 뜻은 Nginx가 백엔드 서버 상태를 능동적으로 탐지하지 않고, 실제 요청의 성공과 실패를 관찰해 판단한다는 의미입니다. 직접 문을 두드리며 괜찮은지 묻는 대신, 일상적인 행동을 보고 간접적으로 상태를 판단하는 것과 비슷합니다.
max_fails와 fail_timeout 두 파라미터는 이런 관찰 메커니즘을 설정합니다.
upstream backend {
  server backend1.example.com max_fails=3 fail_timeout=30s;
  server backend2.example.com max_fails=3 fail_timeout=30s;
}

location / {
  proxy_pass http://backend;
  proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
}
proxy_next_upstream은 어떤 상황을 실패로 볼지 지정합니다. error는 연결 오류, timeout은 타임아웃, http_500부터 http_504까지는 여러 HTTP 오류 상태 코드입니다. 이런 상황이 발생하면 Nginx는 요청을 다음 서버로 전달하고, 현재 서버에는 실패를 한 번 기록합니다.
30초 안에 3번 실패하면 서버는 사용할 수 없는 상태로 표시됩니다. 이후 30초 동안 Nginx는 이 서버로 요청을 보내지 않습니다. 30초가 지난 뒤 한 번 시도합니다. 성공하면 서버가 복구되고, 실패하면 다시 30초를 기다립니다.
이 메커니즘의 문제는 장애 대응이 느리다는 점입니다. 실제 사용자 요청이 적어도 3번 실패해야 서버가 제외됩니다. 그 3명의 사용자는 이미 오류 응답을 받았고 경험은 손상됐습니다.
더 극단적인 상황도 있습니다. 서버가 막 시작되어 초기화 중이고 헬스 상태가 불안정할 수 있습니다. max_fails=1 설정은 시작 중 한 번의 실패만으로 서버를 사용할 수 없는 상태로 표시해 계속 제외되게 만들 수 있습니다.
제 권장안은 이렇습니다.

- max_fails는 2 또는 3으로 설정해 가끔 있는 네트워크 흔들림을 허용합니다
- fail_timeout은 30초 이상으로 설정해 서버가 복구할 시간을 줍니다
- proxy_next_upstream에는 오류 유형 목록을 충분히 넣어 일부 실패 상황이 빠지지 않게 합니다
수동 체크의 장점은 설정이 단순하고 오픈소스 Nginx가 바로 지원한다는 점입니다. 단점은 사용자 요청에 의존하므로 사용자 경험이 먼저 손상된다는 점입니다. 장애를 더 빨리 발견하고 백엔드 상태를 능동적으로 탐지해야 한다면 능동 헬스 체크가 필요합니다.
4. 능동 헬스 체크: NGINX Plus와 오픈소스 대안
능동 헬스 체크의 로직은 이렇습니다. Nginx가 주기적으로 백엔드 서버에 탐지 요청을 보냅니다. 예를 들면 GET /health입니다. 응답 상태에 따라 서버가 건강한지 판단합니다. 사용자 요청이 실패할 때까지 기다릴 필요가 없고, Nginx가 스스로 장애 서버를 발견해 미리 제외할 수 있습니다.
공식 해법은 상용 버전인 NGINX Plus입니다. 연간 비용은 인스턴스당 $3,675입니다. 인스턴스 10개면 1년에 $36,750입니다. 솔직히 이 가격은 많은 회사에 부담스럽습니다.
오픈소스 해법은 Taobao 기술팀이 개발한 nginx_upstream_check_module입니다. Nginx를 다시 컴파일해 이 모듈을 추가해야 하지만 기능은 꽤 완성도가 높습니다.
| 기능 | NGINX Plus | nginx_upstream_check_module |
|---|---|---|
| 가격 | 연 $3,675 | 오픈소스 무료 |
| HTTP 체크 | 지원 | 지원 |
| TCP 체크 | 지원 | 지원 |
| MySQL 체크 | 미지원 | 지원 |
| FastCGI 체크 | 미지원 | 지원 |
| 상태 페이지 | 지원 | 지원(check_status) |
오픈소스 모듈은 MySQL과 FastCGI 체크를 지원합니다. 이는 NGINX Plus에는 없는 기능입니다. 백엔드가 PHP-FPM 또는 MySQL이라면 이 모듈이 더 적합합니다.
nginx_upstream_check_module 설정 예시
upstream backend {
  server backend1.example.com:8080;
  server backend2.example.com:8080;

  check interval=3000 rise=2 fall=5 timeout=1000 type=http;
  check_http_send "GET /health HTTP/1.0\r\n\r\n";
  check_http_expect_alive http_2xx http_3xx;
}

server {
  location / {
    proxy_pass http://backend;
  }

  location /upstream_status {
    check_status json;
    allow 127.0.0.1;
    allow 10.0.0.0/8;
    deny all;
  }
}
파라미터 설명:
- interval=3000: 3초마다 탐지 요청을 보냅니다
- rise=2: 연속 2번 성공하면 서버를 건강한 상태로 표시합니다. 막 시작한 서버는 불안정할 수 있으므로 연속 성공 확인이 필요합니다
- fall=5: 연속 5번 실패하면 서버를 사용할 수 없는 상태로 표시합니다. 가끔 있는 타임아웃은 허용합니다
- timeout=1000: 탐지 요청 타임아웃은 1초입니다
- type=http: HTTP 프로토콜로 탐지합니다. tcp, ssl_hello, mysql, ajp, fastcgi도 지원합니다
check_http_send는 탐지 요청 내용을 정의합니다. 여기서는 간단한 GET /health 요청을 보냅니다. 백엔드는 /health 인터페이스를 구현하고 200 또는 3xx 상태 코드를 반환해야 합니다.
check_http_expect_alive는 어떤 상태 코드를 건강한 상태로 볼지 지정합니다. http_2xx와 http_3xx는 200-299 및 300-399 상태 코드를 성공으로 본다는 뜻입니다.
check_status는 상태 모니터링 페이지를 제공합니다. json 형식으로 출력하므로 Prometheus나 Zabbix와 연동하기 좋습니다. 뒤쪽의 allow/deny는 접근 제어입니다. 이 페이지는 함부로 노출하면 안 됩니다.
모듈 설치 방법
nginx_upstream_check_module은 컴파일 설치가 필요합니다. 대략적인 절차는 다음과 같습니다.
# 모듈 소스 다운로드
git clone https://github.com/yaoweibin/nginx_upstream_check_module.git

# Nginx 소스 다운로드
wget http://nginx.org/download/nginx-1.24.0.tar.gz
tar -zxvf nginx-1.24.0.tar.gz

# 패치 적용(Nginx 버전에 맞게 선택)
cd nginx-1.24.0
patch -p1 < ../nginx_upstream_check_module/check_1.20.1+.patch

# 컴파일
./configure --add-module=../nginx_upstream_check_module
make && make install
Docker로 배포한다면 모듈을 포함한 이미지를 직접 빌드하거나, 커뮤니티에서 제공하는 기존 이미지를 사용할 수 있습니다.
5. 운영 환경 실전: 보안과 모니터링
운영 환경에서 헬스 체크 설정은 몇 가지 세부 사항에서 실수하기 쉽습니다. 저는 세 가지 원칙으로 정리합니다.
보안 설정: 세 가지 핵심
1. check_status 페이지에는 반드시 접근 제어를 걸어야 합니다
상태 페이지는 백엔드 서버 목록과 헬스 상태를 노출합니다. 외부에서 접근할 수 있으면 공격자는 내부 토폴로지 정보를 볼 수 있고, 현재 어떤 서버가 사용할 수 없는지도 알 수 있습니다. 이는 공격하기 좋은 타이밍을 알려주는 셈입니다.
location /upstream_status {
  check_status json;
  allow 127.0.0.1;       # 로컬 접근
  allow 10.0.0.0/8;      # 사내망 IP
  deny all;              # 나머지 거부
}
더 엄격하게는 특정 모니터링 서버의 IP만 허용해도 됩니다.
2. 별도 헬스 체크 포트를 사용합니다
헬스 체크 요청은 빈도가 높습니다. 보통 3-5초마다 한 번입니다. 비즈니스 포트를 직접 탐지하면 백엔드 로그에 /health 요청이 대량으로 기록됩니다. 로그 파일이 커지고 성능에도 영향을 줍니다.
백엔드 서비스가 두 포트를 listen하도록 권장합니다. 하나는 비즈니스 포트, 예를 들어 8080이고, 다른 하나는 헬스 체크 포트, 예를 들어 8888입니다. 헬스 체크 포트는 단순한 상태 코드만 반환하고 비즈니스 로직도 처리하지 않으며 로그도 쓰지 않습니다.

check interval=5000 rise=2 fall=3 timeout=2000 type=http port=8888;port=8888은 탐지 전용 포트를 지정합니다.
3. 헬스 체크 인터페이스는 민감 정보를 반환하지 않습니다
/health 인터페이스는 상태 코드만 반환하면 됩니다. 버전 번호, 설정 정보, 메모리 사용량 같은 내부 데이터를 반환하지 마세요. 공격자는 이런 정보를 이용해 취약점을 찾습니다.
# 백엔드 구현 예시
@app.route('/health')
def health():
    return '', 200   # 상태 코드만 반환
모니터링 연동: JSON 출력
check_status는 여러 형식을 지원합니다. json 형식은 모니터링 시스템 연동에 적합합니다.
curl http://127.0.0.1/upstream_status출력 예시는 다음과 같습니다.
{
  "servers": {
    "total": 3,
    "generation": 12,
    "server": [
      {"index": 0, "name": "10.0.0.1:8080", "status": "up", "rise": 5, "fall": 0, "type": "http"},
      {"index": 1, "name": "10.0.0.2:8080", "status": "up", "rise": 3, "fall": 0, "type": "http"},
      {"index": 2, "name": "10.0.0.3:8080", "status": "down", "rise": 0, "fall": 5, "type": "http"}
    ]
  }
}generation은 설정 변경 카운터입니다. upstream 설정을 수정하고 reload할 때마다 generation 값이 증가합니다. 모니터링 스크립트는 이 값을 비교해 설정이 적용됐는지 확인할 수 있습니다.
파라미터 튜닝 권장안
interval은 3000ms보다 낮게 두지 않습니다
탐지 빈도가 너무 높으면 백엔드에 부담을 줍니다. 3-5초 간격이면 충분합니다. 장애 발견 지연은 초 단위이고 사용자 경험에 큰 영향을 주지 않습니다.
rise와 fall 임계값의 균형
- rise 값이 너무 작으면, 예를 들어 1이면, 서버가 막 시작되어 초기화가 끝나지 않았을 때 건강하지 않다고 오판한 뒤 빠르게 복구되며 상태가 반복적으로 흔들릴 수 있습니다
- fall 값이 너무 작으면, 예를 들어 1이면, 한 번의 네트워크 흔들림만으로도 서버가 제외되어 지나치게 민감해집니다
제 경험값은 rise=2, fall=3 또는 fall=5입니다. 순간적인 장애는 허용하고, 지속적인 장애가 확인된 뒤 제외합니다.
완성된 운영 설정
upstream web_app {
  zone web_app 64k;
  server 10.0.0.1:8080 weight=3;
  server 10.0.0.2:8080;
  server 10.0.0.3:8080 backup;

  check interval=5000 rise=2 fall=3 timeout=2000 type=http port=8888;
  check_http_send "GET /health HTTP/1.1\r\nHost: app.example.com\r\n\r\n";
  check_http_expect_alive http_2xx;
}

server {
  listen 80;
  server_name app.example.com;

  location / {
    proxy_pass http://web_app;
    proxy_set_header Host $host;
    proxy_next_upstream error timeout http_502 http_503 http_504;
  }

  location /upstream_status {
    check_status json;
    allow 127.0.0.1;
    allow 10.0.0.0/8;
    deny all;
  }
}
이 설정은 다음을 보장합니다.
- zone 공유 메모리로 worker 상태를 동기화합니다
- 능동 헬스 체크가 5초마다 전용 포트를 탐지합니다
- 상태 페이지는 사내망 접근만 허용합니다
- proxy_next_upstream으로 장애 서버에 걸린 요청을 건강한 백엔드로 전달합니다
결론
다시 그해 Double 11 사고로 돌아가 보겠습니다. 이후 우리는 upstream에 zone 공유 메모리를 추가하고 max_fails와 fail_timeout을 설정했습니다. 그 뒤에는 nginx_upstream_check_module을 컴파일 설치해 능동 헬스 체크를 붙였습니다. 서버가 죽어도 Nginx는 5초 안에 발견하고 제외할 수 있게 됐고, 사용자는 거의 오류 응답을 받지 않게 됐습니다.
로드 밸런싱 전략 선택은 사실 한 문장으로 정리할 수 있습니다. 무상태 서비스는 round-robin 또는 least_conn, 상태가 필요한 서비스는 ip_hash 또는 hash를 사용합니다. 헬스 체크는 운영 환경에서 반드시 필요합니다. 오픈소스 해법으로는 nginx_upstream_check_module을 쓰고, check_status 페이지에 접근 제어를 거는 것을 잊지 마세요.
아직 Nginx가 기본 라운드 로빈만 쓰고 있고 헬스 체크가 없다면, 먼저 수동 체크인 max_fails + fail_timeout부터 시작하는 것을 권장합니다. 변경 폭은 작고 효과는 바로 나타납니다. 안정적으로 검증한 뒤 능동 헬스 체크로 업그레이드해도 됩니다. 테스트 환경에서 먼저 한 번 돌려 보고, 설정에 문제가 없는지 확인한 뒤 운영에 올리세요.
FAQ
Nginx upstream의 zone 설정은 어떤 역할을 하나요?
수동 헬스 체크와 능동 헬스 체크는 무엇이 다른가요?
nginx_upstream_check_module과 NGINX Plus 중 어느 쪽이 더 나은가요?
로드 밸런싱 전략은 round-robin과 least_conn 중 어떻게 선택하나요?
헬스 체크의 rise와 fall 파라미터는 어떻게 설정해야 하나요?
check_status 페이지에 반드시 접근 제어를 걸어야 하는 이유는 무엇인가요?
3분 읽기 · 게시일: 2026년 4월 27일 · 수정일: 2026년 10월 21일

Nginx 실전 가이드
검색으로 들어왔다면 같은 시리즈의 이전 글이나 다음 글로 이동하는 것이 가장 빠릅니다.
이전
Nginx SSL/TLS 설정 실전: HTTPS 인증서부터 A+ 보안 강화까지
Nginx HTTPS를 처음부터 설정하는 방법을 알아봅니다. Let's Encrypt 인증서 발급, TLS 1.3 보안 강화, SSL Labs A+ 등급 설정 템플릿, OCSP Stapling 성능 최적화를 다루는 2026년 최신 완전 가이드입니다.
6편 중 3편
다음
Nginx 동적 upstream: Lua로 실시간 서비스 디스커버리 구현하기
OpenResty 동적 upstream 3계층 아키텍처를 자세히 설명하고, 헬스 체크 방식의 장단점을 비교하며, Consul/Nacos/etcd 연동 코드로 컨테이너 환경의 실시간 서비스 디스커버리를 구현합니다.
6편 중 5편


댓글
GitHub로 로그인하여 댓글을 남기세요