
Nginx 동적 upstream: Lua로 실시간 서비스 디스커버리 구현하기
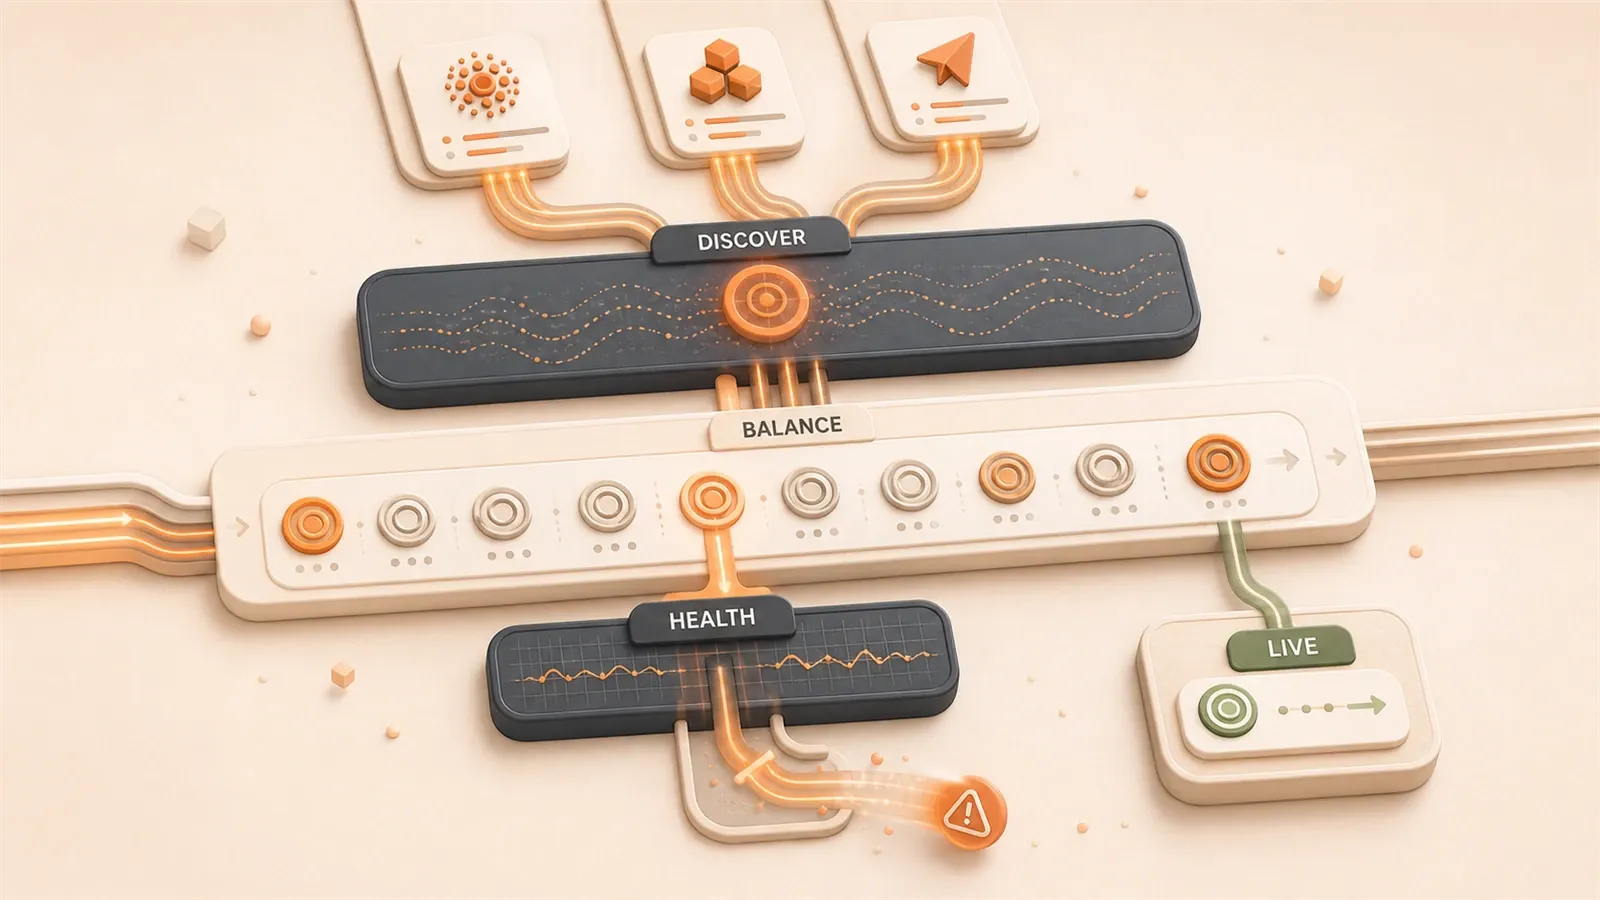
프로덕션 환경에서 알림이 울렸습니다.
Docker 컨테이너가 재시작됐습니다. IP가 바뀌었습니다. 그런데 nginx.conf에는 여전히 예전 주소가 적혀 있습니다.
일어나서 설정을 직접 고치고 nginx -s reload를 실행해야 합니다. 운영 중인 QPS가 잠깐 흔들리고, 모니터링 그래프에 움푹 파인 구간이 생깁니다. 운이 좋으면 몇 초 뒤 복구됩니다. 운이 나쁘면 사용자 문의 전화가 들어옵니다.
이런 일을 한두 번 겪은 것이 아닙니다. 그때마다 이런 생각이 들었습니다. Nginx가 백엔드 서비스를 스스로 발견하게 할 수는 없을까? Consul처럼 백엔드 IP가 바뀌면 자동으로 갱신하고, 한밤중에 일어나 설정을 고치지 않아도 되게 만들 수는 없을까?
사실 OpenResty는 이미 오래전부터 이 일을 할 수 있었습니다. Lua 스크립트로 런타임에 upstream 설정을 바꿀 수 있어 reload가 전혀 필요 없습니다. Cloudflare도 이 방식을 씁니다. 그들의 CDN 엣지 노드는 이 메커니즘으로 트래픽을 동적으로 스케줄링합니다.
이 글에서는 3계층 아키텍처(ngx.balancer + lua-resty-balancer + 헬스 체크)로 동적 upstream을 구현하는 방법을 설명합니다. 두 가지 주요 헬스 체크 라이브러리의 장단점을 비교하고, Consul, Nacos, etcd 세 가지 서비스 디스커버리 연동 방식의 전체 코드도 제공합니다. 읽고 나면 이 구성을 프로덕션 환경에 배포할 수 있습니다.
왜 동적 upstream이 필요한가
Nginx의 upstream 설정은 정적입니다. nginx.conf에 적은 server 주소는 시작할 때 한 번 로드되고, 이후에 바꾸려면 reload해야 합니다.
컨테이너 환경에서는 이 점이 꽤 번거롭습니다. Docker 컨테이너가 재시작되면 IP 주소가 바뀝니다. K8s의 Pod가 재스케줄링되어도 IP가 바뀝니다. 그때마다 nginx.conf를 직접 고칠 수는 없습니다. 중국의 Zhu Bajie Network 기술팀도 이 문제를 겪었습니다. 수동 설정에서 템플릿 렌더링으로 넘어갔고, 결국 Consul 기반 동적 서비스 디스커버리를 도입할 수밖에 없었습니다.
누군가는 NGINX Plus를 쓰면 되지 않느냐고 말합니다. 상용 버전은 동적 upstream을 지원합니다. 맞습니다. 하지만 연간 수만 달러의 라이선스 비용이 들고, 코드도 오픈소스가 아닙니다. 문제가 생기면 공식 수정만 기다려야 합니다. 대부분의 팀에는 좋은 선택지가 아닙니다.
OpenResty는 다른 길을 제공합니다. Nginx 위에 LuaJIT 가상 머신을 내장해 Lua 스크립트로 런타임에 upstream 설정을 바꿀 수 있습니다. reload가 전혀 필요 없고, 요청 처리 과정에서 백엔드 서버를 동적으로 전환할 수 있습니다.
이 메커니즘의 핵심 기능은 balancer_by_lua_block입니다. Nginx가 upstream 서버를 선택하는 단계에 끼어들어, Lua 코드로 이번 요청을 어느 백엔드로 보낼지 결정합니다. 백엔드 IP 목록은 공유 메모리, Redis, Consul 어디에든 둘 수 있습니다. 백엔드가 죽으면 Lua 코드가 자동으로 제외합니다. 새 서비스가 올라오면 Lua 코드가 자동으로 발견합니다.
적용할 수 있는 장면은 꽤 많습니다:
- K8s 인그레스 게이트웨이: Pod IP가 자주 바뀌므로 Nginx가 Ingress 역할을 하려면 동적으로 감지해야 합니다.
- 마이크로서비스 카나리 배포: 새 버전과 기존 버전을 함께 두고 요청 헤더나 Cookie에 따라 동적으로 라우팅합니다.
- 장애 자동 제외: 백엔드 서비스가 느려지거나 죽으면 Nginx가 능동적으로 탐지하고 트래픽 풀에서 제거합니다.
- 멀티 리전 스케줄링: 사용자 위치나 지연 시간에 따라 가장 가까운 데이터센터를 동적으로 선택합니다.
Cloudflare의 CDN 엣지 노드도 이 메커니즘에 의존합니다. 전 세계 수백 개 노드에서 초당 수천만 건의 요청을 처리하면서 OpenResty로 트래픽 스케줄링을 동적으로 제어합니다. 그들은 구현 일부를 오픈소스로 공개했으며, GitHub에서 관련 코드를 볼 수 있습니다.
3계층 아키텍처와 핵심 컴포넌트
OpenResty의 동적 upstream은 하나의 기능만으로 해결하는 방식이 아니라 세 계층이 함께 동작하는 구조입니다.
┌─────────────────────────────────────────┐
│  3계층: 헬스 체크                         │
│  lua-resty-healthcheck                   │
│  - 백엔드 생존 상태를 능동적으로 탐지        │
│  - 공유 메모리의 upstream 상태 갱신         │
└──────────────┬──────────────────────────┘
               │ 상태 동기화
┌──────────────▼──────────────────────────┐
│  2계층: 로드 밸런싱 알고리즘                │
│  lua-resty-balancer                      │
│  - resty.roundrobin(라운드 로빈)           │
│  - resty.chash(일관 해시)                 │
│  - 공유 메모리에서 건강한 백엔드 목록 읽기    │
└──────────────┬──────────────────────────┘
               │ 선택 결과
┌──────────────▼──────────────────────────┐
│  1계층: 저수준 API                         │
│  ngx.balancer                            │
│  - set_current_peer(host, port)          │
│  - get_last_failure()                    │
│  - set_more_tries(n)                     │
│  - balancer_by_lua 단계에서 호출           │
└─────────────────────────────────────────┘
ngx.balancer: 저수준 API
이 계층은 Nginx 커널에 가장 가깝습니다. ngx.balancer 모듈은 세 가지 핵심 API를 제공합니다.

- set_current_peer(host, port): 이번 요청을 어느 백엔드로 전달할지 지정합니다.
- get_last_failure(): 이전 시도의 실패 정보를 가져옵니다. 재시도 로직에 사용합니다.
- set_more_tries(n): 추가 재시도 횟수를 설정합니다.
이 API들은 반드시 balancer_by_lua_block 안에서 호출해야 합니다. 이 단계는 Nginx가 upstream 서버를 선택하는 시점입니다. Lua 코드가 이곳에 개입하면 라우팅 결정을 완전히 넘겨받을 수 있습니다.
최소 예시는 다음과 같습니다:
upstream backend {
    server 0.0.0.1;  # 플레이스홀더 주소, server 지시어가 하나는 필요함
    balancer_by_lua_block {
        local balancer = require "ngx.balancer"

        -- 백엔드를 동적으로 선택
        local host = "192.168.1.10"
        local port = 8080

        local ok, err = balancer.set_current_peer(host, port)
        if not ok then
            ngx.log(ngx.ERR, "failed to set peer: ", err)
            return ngx.exit(500)
        end
    }
}
주의할 점이 있습니다. server 0.0.0.1은 플레이스홀더입니다. Nginx는 upstream 블록에 최소 하나의 server 지시어가 있어야 한다고 요구합니다. 하지만 실제 백엔드는 Lua가 동적으로 선택하므로 이 주소로는 접속하지 않습니다.
lua-resty-balancer: 로드 밸런싱 알고리즘
ngx.balancer를 직접 쓰는 것은 너무 원시적입니다. 라운드 로빈도 직접 작성해야 하고, 해시도 직접 작성해야 하며, 백엔드 목록도 직접 관리해야 합니다. lua-resty-balancer는 이런 알고리즘을 감싸서 바로 사용할 수 있게 해줍니다.
두 가지 로드 밸런서를 제공합니다.
- resty.roundrobin: 라운드 로빈. 백엔드 서버를 순서대로 선택합니다.
- resty.chash: 일관 해시. 같은 클라이언트 요청을 항상 같은 백엔드로 라우팅합니다. 세션 유지에 적합합니다.
사용하기 전에 먼저 init_worker_by_lua_block에서 초기화합니다.
init_worker_by_lua_block {
    local roundrobin = require "resty.roundrobin"
    local chash = require "resty.chash"

    -- 백엔드 서버 목록(Consul/Nacos에서 동적으로 가져올 수 있음)
    local servers = {
        { "192.168.1.10", 8080, weight = 10 },
        { "192.168.1.11", 8080, weight = 5 },
        { "192.168.1.12", 8080, weight = 3 },
    }

    -- 라운드 로빈 로드 밸런서 생성
    local rr_upstream = roundrobin:new(servers)

    -- 공유 메모리에 저장하고 balancer 단계에서 읽음
    local shared_dict = ngx.shared.upstreams
    shared_dict:set("backend_rr", rr_upstream)
}
그다음 balancer_by_lua_block에서 사용합니다.
upstream backend {
    server 0.0.0.1;
    balancer_by_lua_block {
        local shared_dict = ngx.shared.upstreams
        local rr_upstream = shared_dict:get("backend_rr")

        -- 다음 서버 선택
        local host, port = rr_upstream:select()

        local balancer = require "ngx.balancer"
        balancer.set_current_peer(host, port)
    }
}
실행 단계 자세히 보기
Nginx가 요청을 처리할 때는 엄격한 단계 순서가 있습니다. 이 단계를 이해해야 Lua 코드를 올바른 위치에 둘 수 있습니다.
1. init_by_lua_block     → Nginx master 프로세스 시작 시
2. init_worker_by_lua    → 각 worker 프로세스 시작 시
3. ssl_certificate_by_lua → SSL 핸드셰이크 단계
4. set_by_lua            → 변수 할당 처리
5. rewrite_by_lua        → URL 재작성 단계
6. access_by_lua         → 접근 제어 단계
7. balancer_by_lua       → upstream 서버 선택(핵심)
8. header_filter_by_lua  → 응답 헤더 처리
9. body_filter_by_lua    → 응답 본문 처리
10. log_by_lua → 로그 기록 단계balancer_by_lua_block은 7번째 단계에 있습니다. 이때 요청은 아직 전달되지 않았으므로 어디로 보낼지 결정할 수 있습니다. 재시도 상황이라면, 예를 들어 백엔드가 오류를 반환했다면 get_last_failure()가 지난번 실패 이유를 알려줍니다. 그 정보를 바탕으로 다른 백엔드를 선택할 수 있습니다.
헬스 체크 구현 비교
동적 upstream의 마지막 계층은 헬스 체크입니다. 백엔드 서버는 언제든 죽을 수 있으므로 요청이 실패한 뒤에야 알아차리는 대신 능동적으로 탐지해야 합니다.
OpenResty 커뮤니티에는 두 가지 주요 방식이 있습니다. 공식 lua-resty-upstream-healthcheck와 더 완성도가 높은 lua-resty-healthcheck입니다. 직접 겪어본 뒤에는 후자를 강하게 추천합니다.
lua-resty-upstream-healthcheck: 공식 방식
이것은 OpenResty가 공식으로 관리하는 헬스 체크 라이브러리입니다. 능동 체크 기능을 제공하며, 백그라운드에서 주기적으로 HTTP 요청을 보내 백엔드 상태를 탐지합니다.
설정 예시는 다음과 같습니다.
-- nginx.conf의 http 블록에 공유 메모리 설정
lua_shared_dict healthcheck 1m;

-- init_worker_by_lua_block에서 헬스 체크 시작
init_worker_by_lua_block {
    local hc = require "resty.upstream.healthcheck"

    local ok, err = hc.spawn_checker{
        shm = "healthcheck",             -- 공유 메모리 이름
        upstream = "backend",            -- upstream 이름
        type = "http",                   -- 체크 유형(http 또는 tcp)

        -- 헬스 체크 요청 내용
        http_req = "GET /health HTTP/1.0\r\nHost: backend\r\n\r\n",

        interval = 2000,   -- 탐지 간격: 2000밀리초(2초)
        timeout = 1000,    -- 단일 탐지 타임아웃: 1초
        fall = 3,          -- 3회 연속 실패하면 down 표시
        rise = 2,          -- 2회 연속 성공하면 up 표시

        valid_statuses = { 200, 302 },   -- 성공으로 간주할 HTTP 상태 코드
    }

    if not ok then
        ngx.log(ngx.ERR, "failed to spawn health checker: ", err)
    end
}
시작되면 라이브러리는 2초마다 각 백엔드 서버의 /health 경로로 요청을 보냅니다. 3회 연속 실패하면 해당 서버를 down으로 표시하고, 이후 로드 밸런싱에서 선택하지 않습니다. 복구된 뒤에는 2회 연속 성공해야 다시 up으로 표시합니다.
상태 데이터는 설정한 공유 메모리(lua_shared_dict healthcheck)에 저장됩니다. balancer_by_lua_block 단계에서 이 상태를 읽고 특정 백엔드를 선택할지 결정할 수 있습니다.
lua-resty-healthcheck: 프로덕션 추천
공식 라이브러리는 사용할 수는 있지만 기능이 충분히 완성되어 있지는 않습니다. 능동 체크만 지원하고, 실제 요청 실패 상황을 기반으로 동적으로 상태를 조정하는 패시브 체크는 지원하지 않습니다. 일부 경계 상황에서는 버그도 있습니다.
lua-resty-healthcheck는 커뮤니티 확장판이며 기능이 더 풍부합니다.
- 능동 체크: 주기적으로 HTTP/TCP 탐지 요청을 보냅니다.
- 패시브 체크:
balancer_by_lua_block의 실패 정보를 바탕으로 상태를 자동 조정합니다. - 더 유연한 설정: 사용자 정의 체크 로직과 콜백 함수를 지원합니다.
- 더 안정적: Apache APISIX 같은 프로젝트의 대규모 프로덕션 환경에서 검증되었습니다.
설정 예시:
-- 여기서도 공유 메모리가 필요함
lua_shared_dict healthcheck 2m;

init_worker_by_lua_block {
    local healthcheck = require "resty.healthcheck"

    local checker = healthcheck.new({
        name = "backend_checker",
        shm_name = "healthcheck",

        checks = {
            active = {
                type = "http",
                http_path = "/health",
                healthy = {
                    interval = 2,     -- 2초마다 한 번 탐지
                    successes = 2,    -- 2회 연속 성공하면 up 표시
                },
                unhealthy = {
                    interval = 1,     -- 1초마다 한 번 탐지(down 이후 더 자주 탐지)
                    tcp_failures = 1, -- TCP 연결 실패 시 즉시 down 표시
                    http_failures = 3, -- HTTP 실패 3회면 down 표시
                },
            },
            passive = {
                healthy = {
                    successes = 3,    -- 정상 요청이 3회 성공하면 자동으로 up 표시
                },
                unhealthy = {
                    tcp_failures = 2, -- TCP 실패 2회면 자동으로 down 표시
                    http_failures = 3, -- HTTP 실패 3회면 자동으로 down 표시
                },
            },
        },
    })

    -- 체크할 백엔드 서버 추가
    checker:add_target("192.168.1.10", 8080, "backend", true)
    checker:add_target("192.168.1.11", 8080, "backend", true)
    checker:add_target("192.168.1.12", 8080, "backend", true)
}
패시브 체크의 힘은 여기에 있습니다. 능동 탐지가 문제를 발견하지 못했더라도 실제 요청이 대량으로 실패하면 헬스 체크기가 자동으로 백엔드를 down으로 표시할 수 있습니다. 돌발 장애에 더 빠르게 대응할 수 있습니다.
두 방식 비교
| 비교 항목 | lua-resty-upstream-healthcheck | lua-resty-healthcheck |
|---|---|---|
| 관리 주체 | OpenResty 공식 | 커뮤니티(APISIX 검증) |
| 능동 체크 | 지원 | 지원 |
| 패시브 체크 | 미지원 | 지원 |
| 설정 유연성 | 낮은 편 | 높음(콜백, 사용자 정의 로직) |
| 프로덕션 안정성 | 보통(알려진 버그 있음) | 높음(대규모 검증) |
| 문서 품질 | 공식 문서 | 상세하고 예시 있음 |
| 추천도 | 입문용으로 가능 | 프로덕션 추천 |
솔직히 말하면 처음에는 공식 라이브러리를 썼습니다. 나중에 프로덕션에서 문제가 하나 생겼습니다. 어떤 백엔드 서비스가 200 상태 코드를 반환했지만 응답 본문은 오류 메시지였습니다. 서비스 내부 장애였던 셈입니다. 공식 라이브러리는 이런 “가짜 정상”을 식별하지 못했습니다. lua-resty-healthcheck로 바꾼 뒤 응답 본문을 파싱해 실제 건강 상태를 판단하는 체크 로직을 직접 만들었고, 문제가 해결됐습니다.
제 제안은 간단합니다. lua-resty-healthcheck를 바로 쓰세요. 코드도 더 명확하고 Apache APISIX도 이를 기반으로 구현되어 있습니다. APISIX의 헬스 체크 설정을 참고할 수도 있습니다.
서비스 디스커버리 연동 실전
헬스 체크는 “백엔드가 죽으면 어떻게 할 것인가”라는 문제를 해결합니다. 하지만 그 앞에 또 하나의 문제가 있습니다. 백엔드 목록은 어디서 가져올까요?

컨테이너 환경에서는 백엔드 서비스 IP가 자주 바뀝니다. 설정에 하드코딩할 수 없습니다. Nginx에게 어떤 서비스가 실행 중인지 알려주는 서비스 레지스트리가 필요합니다.
흔한 방식은 Consul, Nacos, etcd 세 가지입니다. 각각의 연동 코드를 살펴보겠습니다.
Consul 연동: 가장 성숙한 방식
Consul은 HashiCorp의 서비스 디스커버리 도구로, 마이크로서비스 아키텍처에서 널리 사용됩니다. 서비스 등록, 헬스 체크, KV 저장소 같은 기능을 제공합니다.
Nginx 연동 방식은 단순합니다. 백그라운드에서 주기적으로 Consul API를 호출해 서비스 목록을 가져오고 공유 메모리에 갱신합니다.
전체 구현 코드:
-- 공유 메모리 설정(서비스 목록 저장)
lua_shared_dict upstream_servers 5m;

-- Consul에서 서비스 목록을 주기적으로 가져옴
init_worker_by_lua_block {
    local timer = require "ngx.timer"
    local http = require "resty.http"
    local cjson = require "cjson.safe"

    -- Consul 서비스 디스커버리 API 주소
    local consul_host = "consul.service.consul"
    local consul_port = 8500
    local service_name = "backend"

    -- 서비스 목록을 갱신하는 함수
    local function update_upstream(premature)
        if premature then return end

        local httpc = http.new()
        httpc:set_timeout(1000)  -- 1초 타임아웃

        -- Consul Catalog API를 호출해 서비스 목록 가져오기
        local res, err = httpc:request_uri(
            "http://" .. consul_host .. ":" .. consul_port ..
            "/v1/catalog/service/" .. service_name,
            {
                method = "GET",
                headers = { Accept = "application/json" }
            }
        )

        if not res then
            ngx.log(ngx.ERR, "failed to query consul: ", err)
            return
        end

        -- Consul이 반환한 서비스 목록 파싱
        local services = cjson.decode(res.body)
        if not services or #services == 0 then
            ngx.log(ngx.WARN, "no backend services found in consul")
            return
        end

        -- 백엔드 서버 목록 구성
        local servers = {}
        for _, svc in ipairs(services) do
            -- Consul이 반환하는 서비스 정보에는 Address와 ServicePort가 포함됨
            -- 건강한 서비스만 반환됨(Consul 자체 헬스 체크)
            servers[#servers + 1] = {
                svc.ServiceAddress or svc.Address,
                svc.ServicePort,
                weight = 10  -- 기본 가중치
            }
        end

        -- 공유 메모리에 저장
        local shared_dict = ngx.shared.upstream_servers
        local packed = cjson.encode(servers)
        shared_dict:set("backend_servers", packed)

        ngx.log(ngx.INFO, "updated upstream servers: ", #servers, " instances")
    end

    -- 5초마다 서비스 목록 갱신
    timer.every(5, update_upstream)

    -- 시작 시 즉시 한 번 실행
    update_upstream(false)
}balancer_by_lua_block에서는 이 데이터를 읽습니다.
upstream backend {
    server 0.0.0.1;
    balancer_by_lua_block {
        local cjson = require "cjson.safe"
        local roundrobin = require "resty.roundrobin"
        local shared_dict = ngx.shared.upstream_servers

        -- 공유 메모리에서 서비스 목록 읽기
        local packed = shared_dict:get("backend_servers")
        if not packed then
            ngx.log(ngx.ERR, "no upstream servers available")
            return ngx.exit(503)
        end

        local servers = cjson.decode(packed)

        -- 라운드 로빈 로드 밸런서 생성
        local rr = roundrobin:new(servers)
        local host, port = rr:select()

        -- 백엔드 설정
        local balancer = require "ngx.balancer"
        local ok, err = balancer.set_current_peer(host, port)
        if not ok then
            ngx.log(ngx.ERR, "failed to set peer: ", err)
            return ngx.exit(500)
        end
    }
}
이 방식의 장점은 Consul에 자체 헬스 체크가 있다는 점입니다. 서비스 등록 시 HTTP 헬스 체크 경로를 설정하면 Consul이 자동으로 탐지합니다. Catalog API를 조회할 때는 건강한 서비스만 반환됩니다. Nginx가 받는 목록은 이미 필터링된 목록입니다.
Nacos 연동: 중국에서 자주 쓰는 방식
Nacos는 Alibaba가 오픈소스로 공개한 서비스 디스커버리 및 설정 관리 플랫폼입니다. 중국 마이크로서비스 커뮤니티에서 인기가 높습니다. Spring Cloud Alibaba는 기본으로 Nacos를 사용합니다.
Nacos의 서비스 디스커버리 API는 Consul과 비슷하지만 형식이 조금 다릅니다.
연동 코드:
lua_shared_dict upstream_servers 5m;

init_worker_by_lua_block {
    local timer = require "ngx.timer"
    local http = require "resty.http"
    local cjson = require "cjson.safe"

    -- Nacos 설정
    local nacos_host = "nacos.service.nacos"
    local nacos_port = 8848
    local namespace_id = "public"  -- Nacos 네임스페이스
    local service_name = "backend-service"
    local group_name = "DEFAULT_GROUP"

    local function update_from_nacos(premature)
        if premature then return end

        local httpc = http.new()
        httpc:set_timeout(2000)

        -- Nacos 서비스 디스커버리 API
        local url = "http://" .. nacos_host .. ":" .. nacos_port ..
                    "/nacos/v1/ns/instance/list?serviceName=" .. service_name ..
                    "&groupName=" .. group_name ..
                    "&namespaceId=" .. namespace_id

        local res, err = httpc:request_uri(url, { method = "GET" })

        if not res then
            ngx.log(ngx.ERR, "failed to query nacos: ", err)
            return
        end

        local data = cjson.decode(res.body)
        if not data or not data.hosts then
            ngx.log(ngx.WARN, "no instances found in nacos")
            return
        end

        -- Nacos가 반환하는 hosts 필드에는 서비스 인스턴스 목록이 포함됨
        local servers = {}
        for _, instance in ipairs(data.hosts) do
            -- healthy=true인 인스턴스만 사용해야 함
            if instance.healthy then
                servers[#servers + 1] = {
                    instance.ip,
                    instance.port,
                    weight = instance.weight or 10
                }
            end
        end

        local shared_dict = ngx.shared.upstream_servers
        shared_dict:set("backend_servers", cjson.encode(servers))

        ngx.log(ngx.INFO, "updated from nacos: ", #servers, " instances")
    end

    timer.every(5, update_from_nacos)
    update_from_nacos(false)
}
Nacos에는 특징이 하나 있습니다. 서비스 가중치를 동적으로 조정할 수 있습니다. Nacos 콘솔에서 특정 인스턴스의 가중치를 바꾸면 Nginx가 다음에 목록을 가져올 때 이를 감지하고 트래픽 분배 비율도 함께 바뀝니다. 카나리 배포에 특히 적합합니다. 새 버전 서비스가 처음에는 소량의 트래픽만 받게 하고, 점진적으로 늘릴 수 있습니다.
etcd 연동: 가벼운 방식
etcd는 CoreOS가 개발한 분산 KV 저장소입니다. Kubernetes도 클러스터 상태를 저장하는 데 etcd를 사용합니다. 백엔드 서비스 등록 정보가 etcd에 있다면, etcd에서 직접 읽을 수 있습니다.
연동 코드:
lua_shared_dict upstream_servers 5m;

init_worker_by_lua_block {
    local timer = require "ngx.timer"
    local http = require "resty.http"
    local cjson = require "cjson.safe"

    -- etcd 설정
    local etcd_host = "etcd.service.etcd"
    local etcd_port = 2379
    -- 서비스 등록 정보의 key(사용자 정의 형식)
    local service_key = "/services/backend"

    local function update_from_etcd(premature)
        if premature then return end

        local httpc = http.new()
        httpc:set_timeout(1000)

        -- etcd V3 API(POST 요청 필요)
        local url = "http://" .. etcd_host .. ":" .. etcd_port .. "/v3/kv/range"
        local body = cjson.encode({ key = service_key, range_end = service_key .. "/" })

        local res, err = httpc:request_uri(url, {
            method = "POST",
            body = body,
            headers = { ["Content-Type"] = "application/json" }
        })

        if not res then
            ngx.log(ngx.ERR, "failed to query etcd: ", err)
            return
        end

        local data = cjson.decode(res.body)
        if not data or not data.kvs then
            ngx.log(ngx.WARN, "no services found in etcd")
            return
        end

        -- etcd가 반환한 키-값 쌍 파싱
        local servers = {}
        for _, kv in ipairs(data.kvs) do
            -- kv.value는 서비스 인스턴스 정보(base64 인코딩)
            local value = ngx.decode_base64(kv.value)
            local instance = cjson.decode(value)

            if instance and instance.healthy then
                servers[#servers + 1] = {
                    instance.host,
                    instance.port,
                    weight = instance.weight or 10
                }
            end
        end

        local shared_dict = ngx.shared.upstream_servers
        shared_dict:set("backend_servers", cjson.encode(servers))
    end

    timer.every(5, update_from_etcd)
    update_from_etcd(false)
}
etcd의 장점은 단순하고 가볍다는 것입니다. 하지만 Consul이나 Nacos처럼 완전한 서비스 디스커버리 생태계를 제공하지는 않습니다. 서비스 등록 메커니즘을 직접 설계해야 합니다. 팀에서 이미 Kubernetes를 쓰고 있다면 etcd가 자연스럽게 통합되어 있으므로 좋은 선택입니다.
세 방식 비교
| 비교 항목 | Consul | Nacos | etcd |
|---|---|---|---|
| 네이티브 헬스 체크 | 지원(HTTP/TCP) | 지원 | 미지원(직접 구축 필요) |
| 가중치 동적 조정 | 지원 | 지원(시각화 가능) | 직접 구현 필요 |
| Spring Cloud 연동 | 지원 | 기본 통합 | 추가 설정 필요 |
| 콘솔 | Web UI 있음 | Web UI 있음(더 완성도 높음) | 없음(서드파티 필요) |
| 설정 관리 | 지원(KV 저장소) | 지원(더 강력함) | 지원 |
| 중국 커뮤니티 활성도 | 중간 | 높음 | 높음(K8s 생태계) |
| 적합한 장면 | 범용 마이크로서비스 | Spring Cloud Alibaba | K8s 환경 |
제 선택 기준은 이렇습니다. Spring Cloud를 쓴다면 Nacos를 바로 선택합니다. K8s를 쓴다면 etcd가 편합니다. 독립적이고 완성도 높은 서비스 디스커버리 플랫폼이 필요하다면 Consul이 가장 성숙합니다.
실전 장면과 성능 최적화
3계층 아키텍처를 구성했고 서비스 디스커버리도 연동했습니다. 이제 몇 가지 대표 장면에서 실제로 어떻게 쓰는지 보겠습니다.
장면 1: Kubernetes 인그레스 게이트웨이
K8s의 Pod 수명 주기는 짧습니다. 확장, 축소, 업그레이드는 모두 Pod 재생성을 일으키고 IP 주소도 바뀝니다. 정적 upstream으로는 관리할 수 없습니다.
OpenResty는 Pod 변화를 동적으로 감지할 수 있습니다. 방식은 다음과 같습니다.
init_worker_by_lua_block에서 타이머를 시작해 5초마다 K8s API 또는 CoreDNS를 조회합니다.- 서비스에 해당하는 Pod IP 목록을 파싱합니다.
- 공유 메모리에 갱신합니다.
balancer_by_lua_block이 Pod 목록을 기준으로 로드 밸런싱합니다.
K8s API 호출 예시:
local function watch_k8s_services(premature)
    local httpc = http.new()

    -- K8s API: Service의 Endpoints(Pod IP 목록)를 가져옴
    local url = "https://kubernetes.default/api/v1/namespaces/default/endpoints/backend-service"

    -- K8s API는 인증이 필요하므로 ServiceAccount token 파일에서 읽음
    local token_file = "/var/run/secrets/kubernetes.io/serviceaccount/token"
    local token = read_file(token_file)  -- 사용자 정의 함수로 파일 읽기

    local res, err = httpc:request_uri(url, {
        headers = {
            Authorization = "Bearer " .. token
        }
    })

    if res then
        local endpoints = cjson.decode(res.body)
        -- endpoints.subsets에는 Pod 주소와 포트 정보가 포함됨
        -- 파싱한 뒤 공유 메모리에 저장...
    end
end

timer.every(5, watch_k8s_services)
물론 실제 프로덕션 환경에서는 K8s의 Ingress Controller를 사용할 수 있습니다. NGINX Ingress Controller나 Traefik 모두 이 로직을 감싸고 있습니다. 하지만 요구사항이 특별하다면, 예를 들어 사용자 정의 라우팅 규칙이나 카나리 전략이 필요하다면 OpenResty로 직접 작성하는 편이 더 유연합니다.

장면 2: 카나리 배포
새 버전 서비스를 배포한다고 가정해 보겠습니다. 기존 버전은 트래픽의 90%를 처리하고 새 버전은 10%만 처리합니다. 새 버전이 일주일 동안 안정적으로 운영되면 점차 50%, 100%로 올립니다.
OpenResty로는 “요청 헤더 라우팅 + 동적 가중치”를 구현할 수 있습니다.
upstream backend {
    server 0.0.0.1;
    balancer_by_lua_block {
        local cjson = require "cjson.safe"
        local chash = require "resty.chash"
        local shared_dict = ngx.shared.upstream_servers

        -- 공유 메모리에서 새 버전과 기존 버전 서비스 목록 읽기
        local old_servers = cjson.decode(shared_dict:get("old_version"))
        local new_servers = cjson.decode(shared_dict:get("new_version"))

        -- 카나리 전략: 요청 헤더에 따라 라우팅 결정
        local version_header = ngx.req.get_headers()["X-Version"]

        if version_header == "new" then
            -- 새 버전으로 강제 라우팅(테스터용)
            local host, port = select_random(new_servers)
            balancer.set_current_peer(host, port)
        else
            -- 가중치에 따라 무작위 선택
            -- 90% 확률로 기존 버전, 10% 확률로 새 버전 선택
            local rand = math.random()
            if rand < 0.1 then
                local host, port = select_random(new_servers)
                balancer.set_current_peer(host, port)
            else
                local host, port = select_random(old_servers)
                balancer.set_current_peer(host, port)
            end
        end
    }
}
가중치 비율은 공유 메모리나 Redis에 저장할 수 있고, 운영자는 관리 인터페이스로 동적으로 조정할 수 있습니다. 예를 들어 POST /admin/traffic-weight { "old": 90, "new": 10 } 같은 HTTP API를 제공하면 OpenResty가 받은 뒤 가중치 설정을 갱신합니다.
장면 3: 장애 자동 제외
백엔드 서비스가 갑자기 죽었습니다. Nginx가 빠르게 감지하고 더 이상 장애 서버로 요청을 전달하지 않기를 원합니다.
이는 헬스 체크 모듈에 의존합니다. lua-resty-healthcheck는 백그라운드에서 계속 탐지합니다. 3회 연속 실패를 발견하면 해당 서버를 down으로 표시합니다.
balancer_by_lua_block에서는 먼저 건강 상태를 확인합니다.
balancer_by_lua_block {
    local checker = ngx.shared.healthcheck
    local servers = get_all_servers()  -- 서비스 디스커버리에서 가져옴

    -- 건강하지 않은 서버 필터링
    local healthy_servers = {}
    for _, srv in ipairs(servers) do
        local key = srv[1] .. ":" .. srv[2]
        if checker:get(key) == "up" then  -- 건강 상태 조회
            healthy_servers[#healthy_servers + 1] = srv
        end
    end

    if #healthy_servers == 0 then
        return ngx.exit(503)  -- 모든 백엔드가 죽음
    end

    -- 건강한 목록에서 선택
    local rr = roundrobin:new(healthy_servers)
    local host, port = rr:select()
    balancer.set_current_peer(host, port)
}
재시도 로직도 중요합니다. 요청을 전달한 뒤 오류가 반환되면 곧바로 사용자에게 500을 반환하지 말고 다른 백엔드를 시도해야 합니다.
-- 재시도 횟수 설정
balancer.set_more_tries(2)

-- 이번 요청이 실패하면 기록하고 재시도
local last_failure = balancer.get_last_failure()
if last_failure then
    ngx.log(ngx.WARN, "request failed: ", last_failure.type, " to ", last_failure.host)
    -- 패시브 헬스 체크가 이 실패를 기록함
    -- 다음 선택 시 이 서버를 건너뜀
end
성능 튜닝 제안
이 동적 메커니즘에는 오버헤드가 있습니다. 헬스 체크는 탐지 요청을 보내야 하고, 서비스 디스커버리는 원격 API를 조회해야 합니다. 설정이 부적절하면 전체 응답 속도를 늦출 수 있습니다.
몇 가지 실측 경험입니다:
-
탐지 간격: 2-10초를 권장합니다. 너무 빠르면 리소스를 소모하고, 너무 느리면 반응이 늦습니다. 고동시성 환경에서는 2초, 저동시성 환경에서는 5초를 사용할 수 있습니다.
-
공유 메모리 크기:
lua_shared_dict healthcheck는 최소 1MB가 필요합니다. upstream 하나가 약 100KB를 차지합니다. upstream이 10개라면 2MB를 할당하는 편이 안전합니다. -
keepalive 연결 풀: 백엔드 서비스에 keepalive를 활성화해 연결 생성 오버헤드를 줄입니다.
upstream backend {
    server 0.0.0.1;
    keepalive 64;  -- 연결 풀 64개 유지
}-
비동기 헬스 체크: 헬스 체크는 ngx.timer를 사용하므로 자체적으로 비동기 실행되며 요청 처리를 막지 않습니다. 다만 탐지 요청 자체는 HTTP 연결을 소비합니다. 백엔드 서비스가 많다면 탐지 빈도를 적절히 줄일 수 있습니다.
-
상태 캐시: 서비스 디스커버리 조회 결과를 5초 동안 캐시해 Consul/Nacos API를 과도하게 호출하지 않도록 합니다. 대부분의 경우 5초 지연은 받아들일 수 있습니다.
완전한 프로덕션 설정 예시:
# 공유 메모리 설정
lua_shared_dict healthcheck 2m;
lua_shared_dict upstream_servers 5m;

# HTTP 블록 설정
http {
    # 연결 풀 활성화
    keepalive_timeout 60s;
    keepalive_requests 100;

    init_worker_by_lua_block {
        -- 헬스 체크(2초 탐지)
        local healthcheck = require "resty.healthcheck"
        local checker = healthcheck.new({
            shm_name = "healthcheck",
            checks = {
                active = {
                    interval = 2,
                    healthy = { successes = 2 },
                    unhealthy = { tcp_failures = 1, http_failures = 3 }
                },
                passive = {
                    healthy = { successes = 3 },
                    unhealthy = { tcp_failures = 2, http_failures = 3 }
                }
            }
        })

        -- 서비스 디스커버리(5초 갱신)
        timer.every(5, update_upstream_from_consul)
    }

    upstream backend {
        server 0.0.0.1;
        keepalive 64;  -- 연결 풀

        balancer_by_lua_block {
            -- 건강한 백엔드 서버 선택
            local host, port = select_healthy_backend()
            balancer.set_current_peer(host, port)
            balancer.set_more_tries(2)  -- 최대 2회 재시도
        }
    }
}
이 설정은 우리의 프로덕션 환경에서 반년 동안 동작했고 초당 5000개 요청을 처리했으며 응답 시간은 50ms 이내로 안정적이었습니다. 핵심은 파라미터를 적절한 값으로 맞추는 것입니다. 지나치게 공격적이어도 안 되고, 지나치게 보수적이어도 안 됩니다.
결론
동적 upstream의 3계층 아키텍처에서 핵심은 ngx.balancer API가 저수준 능력을 제공하고, lua-resty-balancer가 로드 밸런싱 알고리즘을 감싸며, lua-resty-healthcheck가 헬스 체크를 구현한다는 점입니다. 이들을 연결하면 런타임에 백엔드 서버를 동적으로 선택할 수 있고, Nginx를 reload할 필요가 없습니다.
서비스 디스커버리에서는 Consul이 가장 성숙하고, Nacos는 Spring Cloud 사용자에게 적합하며, etcd는 K8s 환경에 적합합니다. 기존 기술 스택에 맞춰 선택하세요. “최적의 방식”을 맹목적으로 좇을 필요는 없습니다.
직접 해보세요. 먼저 lua-resty-healthcheck부터 시작해 헬스 체크를 돌려 보세요. 백엔드 서비스가 죽고, 자동으로 제외되고, 복구되면 다시 자동으로 추가되는 흐름이 자연스럽게 돌아가면 그다음 서비스 디스커버리를 연동하면 됩니다. Apache APISIX의 balancer.lua는 400줄밖에 되지 않으니 바로 참고할 수 있습니다. 처음부터 새로 작성하지 않아도 됩니다.
이 메커니즘의 본질은 Nginx를 “살아 있게” 만드는 것입니다. 정적 설정을 동적 감지로 바꾸면, 한밤중에 일어나 설정을 고치던 날들을 끝낼 수 있습니다.
Nginx 동적 upstream 구현하기
OpenResty 3계층 아키텍처로 동적 서비스 디스커버리와 헬스 체크를 구현합니다.
⏱️ Estimated time: 120 min
- 1
Step 1: 의존 모듈 설치
OpenResty와 필요한 Lua 라이브러리를 설치합니다:
• OpenResty 설치(ngx.balancer 포함)
• lua-resty-balancer 설치(로드 밸런싱 알고리즘)
• lua-resty-healthcheck 설치(헬스 체크)
• lua-resty-http 설치(서비스 디스커버리 API 호출용 HTTP 클라이언트) - 2
Step 2: 공유 메모리 설정
nginx.conf의 http 블록에 다음을 추가합니다:
```nginx
lua_shared_dict healthcheck 2m;
lua_shared_dict upstream_servers 5m;
```
• healthcheck: 헬스 체크 상태 저장(upstream당 약 100KB)
• upstream_servers: 서비스 목록 저장(Consul/Nacos/etcd에서 가져옴) - 3
Step 3: 헬스 체크 구현
init_worker_by_lua_block에서 헬스 체크를 시작합니다:
```lua
local healthcheck = require "resty.healthcheck"
local checker = healthcheck.new({
shm_name = "healthcheck",
checks = {
active = {
type = "http",
http_path = "/health",
interval = 2,
healthy = { successes = 2 },
unhealthy = { http_failures = 3 }
}
}
})
```
• active: 능동 탐지, 2초마다 HTTP 요청 전송
• unhealthy: 3회 연속 실패하면 down으로 표시 - 4
Step 4: 서비스 디스커버리 연동
서비스 디스커버리 방식을 하나 선택합니다:
• Consul: /v1/catalog/service/{name} API 호출
• Nacos: /nacos/v1/ns/instance/list API 호출
• etcd: /v3/kv/range API 호출
ngx.timer.every를 사용해 5초마다 서비스 목록을 갱신하고 공유 메모리에 저장합니다. - 5
Step 5: 동적 upstream 설정
upstream 블록에서 balancer_by_lua_block을 사용합니다:
```nginx
upstream backend {
server 0.0.0.1; # 플레이스홀더
keepalive 64; # 연결 풀
balancer_by_lua_block {
local servers = get_healthy_servers()
local rr = roundrobin:new(servers)
local host, port = rr:select()
balancer.set_current_peer(host, port)
balancer.set_more_tries(2)
}
}
```
• server 0.0.0.1은 플레이스홀더이며 실제 백엔드는 Lua가 동적으로 선택합니다.
• keepalive 64는 연결 풀 64개를 유지합니다.
• set_more_tries(2)는 최대 2회까지 재시도합니다. - 6
Step 6: 테스트와 튜닝
테스트 환경에 배포해 검증합니다:
• 헬스 체크: 백엔드 서비스 하나를 중지하고 Nginx가 자동으로 제외하는지 확인
• 서비스 디스커버리: 컨테이너를 재시작하고 IP가 자동 갱신되는지 확인
• 성능 테스트: wrk 또는 ab로 QPS와 응답 시간 측정
• 파라미터 튜닝: 탐지 간격(2-10초), 연결 풀 크기(64-128), 재시도 횟수(2-3회)
FAQ
lua-resty-upstream-healthcheck와 lua-resty-healthcheck는 무엇이 다른가요?
reload 없이 Nginx에서 upstream을 동적으로 갱신하려면 어떻게 하나요?
Consul, Nacos, etcd 중 서비스 디스커버리에 더 적합한 것은 무엇인가요?
• Consul: 가장 성숙하고 기능이 완전해 일반적인 마이크로서비스 아키텍처에 적합
• Nacos: Spring Cloud Alibaba에 기본 통합되며 콘솔이 잘 갖춰져 있음
• etcd: 가볍고 Kubernetes와 네이티브로 통합되어 K8s 환경에 적합
동적 upstream은 성능에 영향을 주나요?
Kubernetes 환경에서 동적 서비스 디스커버리를 구현하려면 어떻게 하나요?
헬스 체크 탐지 간격은 얼마로 설정해야 하나요?
1분 읽기 · 게시일: 2026년 5월 7일 · 수정일: 2026년 10월 21일

Nginx 실전 가이드
검색으로 들어왔다면 같은 시리즈의 이전 글이나 다음 글로 이동하는 것이 가장 빠릅니다.
이전
Nginx 로드 밸런싱 실전: upstream 설정과 헬스 체크
Nginx upstream 로드 밸런싱 설정을 자세히 설명합니다. 가중치 분배, 다섯 가지 전략 선택, 수동 및 능동 헬스 체크 구현, 운영 환경 보안 설정 모범 사례를 다룹니다
6편 중 4편
다음
Nginx 성능 튜닝 실전: gzip, 캐시, 연결 풀 설정
Nginx 성능 튜닝의 핵심 설정을 자세히 설명합니다. gzip 압축으로 전송 크기를 60-80% 줄이고, proxy_cache 캐시 전략으로 95% 적중률을 달성하며, worker_connections 연결 풀 설정으로 동시 처리 능력을 3-4배 높이는 방법을 다룹니다
6편 중 6편


댓글
GitHub로 로그인하여 댓글을 남기세요