
Cloudflare D1 데이터베이스 실전: SQLite 엣지 데이터베이스와 글로벌 복제
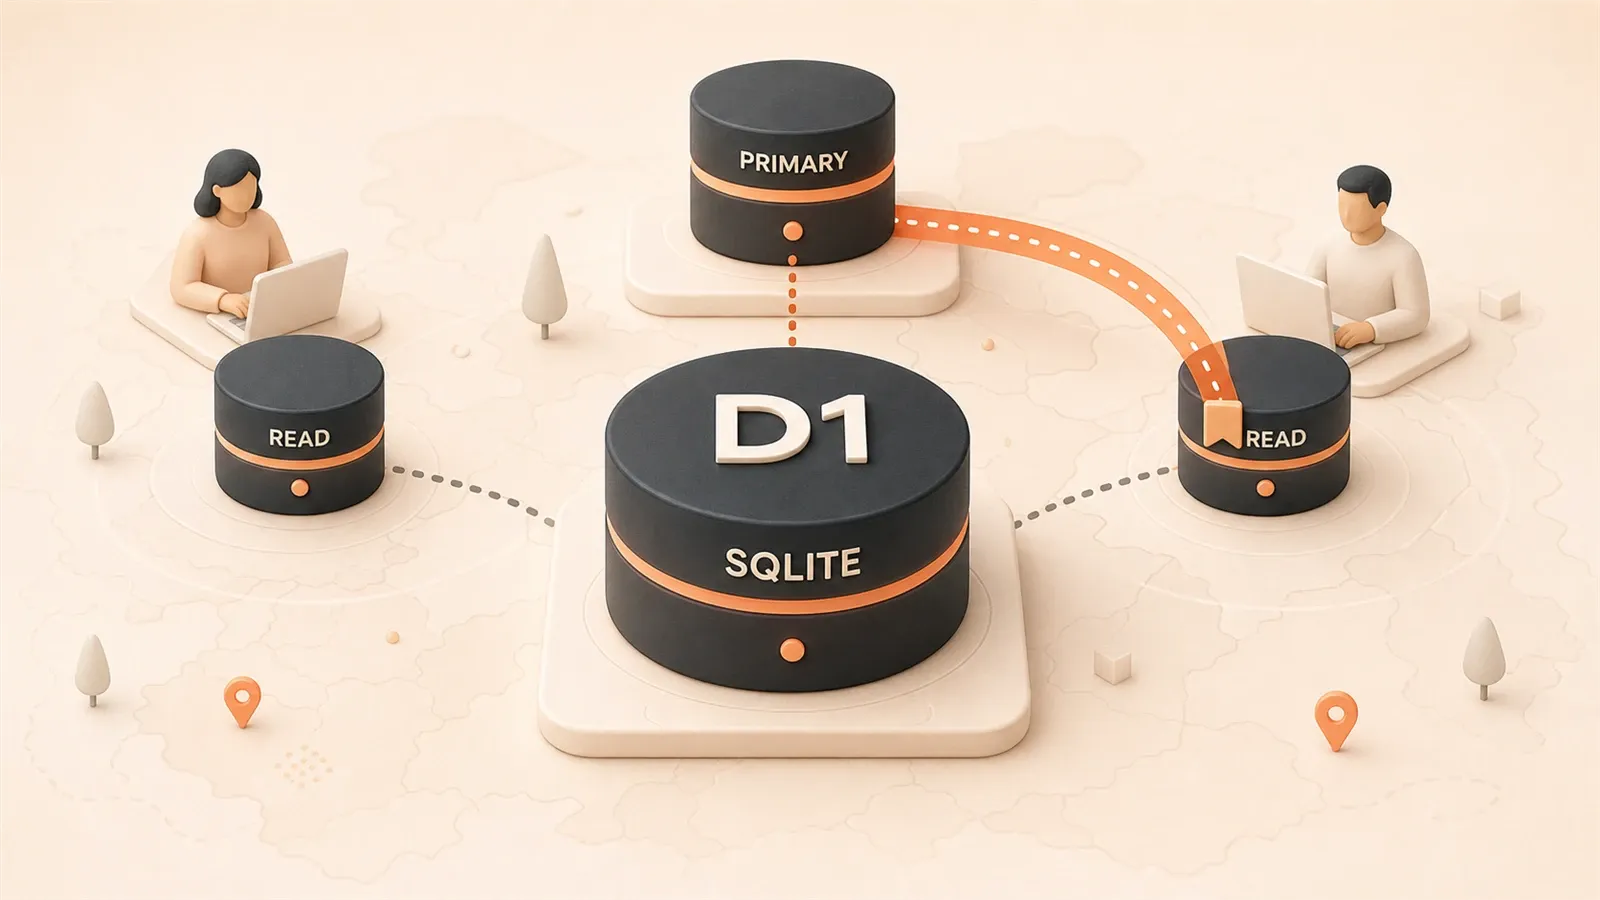
0.01밀리초.
SQLite가 로컬에서 한 행의 데이터를 읽는 데 걸리는 시간입니다. 같은 쿼리를 Cloudflare D1에서 실행하면 약 0.5밀리초가 걸리고, PostgreSQL을 리전 간으로 접근하면 1-3밀리초가 걸릴 수 있습니다. 차이가 별로 없어 보이나요? 하지만 사용자가 도쿄에 있고 데이터베이스가 버지니아에 있다면 네트워크 왕복만으로 100밀리초 이상을 써버립니다.
작년에 글로벌 배포 프로젝트를 하다가 바로 이 문제에 걸렸습니다. 전통적인 데이터베이스를 쓰면 높은 지연 시간을 감수하거나, 복잡한 읽기/쓰기 분리 구조를 만들어야 했습니다. 그러다 Cloudflare가 2025 Developer Week에서 D1의 글로벌 복제 기능을 발표하면서 상황이 꽤 흥미로워졌습니다.
이 글에서는 D1이 SQLite를 어떻게 엣지로 옮기는지, Durable Objects, Lamport 타임스탬프, Sessions API처럼 이름만 들으면 다소 난해한 개념이 실제로는 어떤 사용감을 주는지, 그리고 언제 선택하고 언제 피해야 하는지를 살펴보겠습니다.
1. D1이란 무엇인가: 엣지에서 실행되는 SQLite 데이터베이스
간단히 말해 D1은 Cloudflare가 SQLite를 자사의 엣지 네트워크 위로 옮긴 것입니다. 전 세계 300개가 넘는 도시의 노드에서 데이터베이스를 읽고 쓸 수 있게 해줍니다.
하지만 이것을 단순히 “SQLite + CDN” 정도로 생각한다면 D1의 의도를 과소평가하는 셈입니다. 전통적인 SQLite에는 프로덕션 환경에서 쓰기 어렵게 만드는 치명적인 문제가 몇 가지 있습니다. 단일 파일 저장 구조라 분산 배포가 어렵고, 내장 장애 복구가 없으며, 쓰기 작업이 전체 데이터베이스를 잠글 수 있습니다. D1은 이 부분을 다시 설계했습니다.
전통적인 SQLite와 무엇이 다른가
먼저 통합 방식이 다릅니다. D1은 Cloudflare Workers 안에서 직접 실행되므로 일반 함수를 호출하듯 데이터베이스를 다룰 수 있습니다.
// wrangler.toml
[[d1_databases]]
binding = "DB"
database_name = "my-database"
database_id = "xxxx-xxxx-xxxx"

// Worker 안에서 쿼리
export default {
  async fetch(request, env) {
    const { results } = await env.DB.prepare(
      "SELECT * FROM users WHERE id = ?"
    ).bind(1).all();
    return Response.json(results);
  }
}
두 번째는 Time Travel입니다. D1은 데이터베이스의 과거 버전을 자동으로 저장하므로 원하는 시점으로 롤백할 수 있습니다. SQLite 입장에서는 꽤 호화로운 기능입니다. 무료 계정은 30일 동안 보관되고, 유료 계정은 더 길게 보관할 수 있습니다.
세 번째는 글로벌 복제입니다. 이것이 2025년의 핵심 업데이트입니다. 데이터베이스의 주 노드는 한 리전에 있지만, 읽기 복제본은 전 세계로 자동 동기화됩니다. 사용자가 싱가포르에서 접근하면 싱가포르 근처 복제본에서 데이터를 읽기 때문에 지연 시간이 세 자릿수에서 한 자릿수로 내려갑니다.
하지만 단단한 제한도 있다
D1은 만능이 아닙니다. 선택하기 전에 반드시 알아야 할 제한이 몇 가지 있습니다.
단일 데이터베이스 10GB 상한. 이를 넘으면 분리하거나 다른 선택지를 고려해야 합니다. 한 계정에서 최대 50,000개의 데이터베이스를 만들 수 있습니다. 대부분의 프로젝트에는 충분하지만, 비즈니스 모델이 “사용자마다 데이터베이스 하나”라면 계산을 꼼꼼히 해야 합니다.
단일 작성자 아키텍처. 같은 시점에 하나의 노드만 쓰기 작업을 처리할 수 있습니다. 즉 쓰기 처리량에 상한이 있습니다. 실제 측정치는 대략 500-2000 writes/sec 수준이며, PostgreSQL의 10K-50K와 비교하기 어렵습니다. 비즈니스가 고빈도 쓰기, 예를 들어 실시간 입찰이나 로그 파이프라인이라면 D1은 버티기 어려울 수 있습니다.
순차 일관성이지 강한 일관성은 아닙니다. 뒤에서 자세히 설명하겠지만, 간단히 말하면 방금 쓴 데이터가 바로 다음 읽기에서 보이지 않을 수 있습니다. 다만 Sessions API를 제대로 쓰면 이 문제는 깔끔하게 해결할 수 있습니다.
솔직히 말해 D1에 가장 잘 맞는 시나리오는 읽기가 많고 쓰기가 적은 Web 애플리케이션입니다. 대부분의 웹사이트는 90% 이상이 읽기 작업입니다. D1의 글로벌 읽기 복제는 이런 요청을 가까운 노드에서 응답하게 만들고, 체감 성능 개선도 분명합니다.
2. D1 아키텍처 분석: Durable Objects와 글로벌 복제
이 장은 조금 더 깊게 들어갑니다. 하지만 D1을 제대로 쓰고 싶다면 이 개념들은 피해가기 어렵습니다.
Durable Objects: 데이터베이스마다 하나의 “관리자”
D1의 핵심은 Durable Objects입니다. 각 데이터베이스마다 전담 “관리자 프로세스”가 하나 있다고 생각하면 됩니다. 이 관리자는 다음을 담당합니다.

- 전역 유일성 보장: 모든 쓰기 작업은 반드시 이 관리자를 거칩니다. 두 사람이 동시에 같은 데이터를 수정해 충돌하는 일을 막습니다.
- 트랜잭션 로그 유지: 모든 쓰기를 기록해 장애 복구와 복제본 동기화에 사용합니다.
- 읽기/쓰기 복제본 조율: 전 세계 복제본에 “이제 업데이트해야 한다”고 알려줍니다.
이 설계는 꽤 영리합니다. 전통적인 분산 데이터베이스는 여러 노드 사이에서 조율해야 하고, 네트워크 지연이나 노드 장애가 여러 문제를 일으킵니다. D1의 방식은 하나의 주 노드를 정하고, 모든 쓰기 작업을 그곳에 줄 세워 순서대로 처리한 다음, 복제본에는 비동기로 동기화하는 것입니다.
Snapshot Isolation: 읽기 작업은 막히지 않는다
D1에서 SELECT 쿼리를 실행하면 주 노드에서 줄을 서지 않습니다. 대신 가까운 복제본에서 직접 하나의 “스냅샷”을 읽습니다.
무슨 뜻일까요? 데이터베이스의 주 노드가 베이징에 있고, 도쿄, 싱가포르, 시드니에 복제본이 있다고 가정해 보겠습니다. 도쿄 사용자가 읽기 요청을 보내면 D1은 도쿄 복제본으로 라우팅하고, 그 시점의 데이터 상태를 반환합니다. 이 스냅샷은 쿼리가 시작되는 순간에 정해지므로, 같은 순간 주 노드가 새 데이터를 쓰고 있어도 읽기 작업은 막히지 않습니다.
다만 여기에는 문제가 하나 있습니다. 방금 데이터를 쓴 뒤 바로 읽으면 보이지 않을 수 있습니다. 복제본이 아직 동기화되지 않았기 때문입니다.
그래서 D1은 Sessions API를 제공합니다.
Lamport 타임스탬프: 순서에 의미를 부여하기
Leslie Lamport는 1978년에 분산 시스템의 이벤트 순서를 정하는 방법을 제안했고, 이것이 나중에 Lamport 타임스탬프라고 불리게 되었습니다. 핵심 아이디어는 단순합니다. 각 이벤트에는 논리 시계가 있고, 이후 이벤트의 타임스탬프는 앞선 이벤트보다 반드시 큽니다.
D1은 이 메커니즘으로 “순차 일관성”을 보장합니다. 한 세션 안에서 먼저 쓰고 나중에 읽는다면, D1은 아직 동기화되지 않은 오래된 복제본이 아니라 쓰기 이후의 최신 데이터를 읽도록 보장합니다.
구체적으로는 어떻게 할까요? 쓰기가 끝날 때마다 D1은 하나의 “북마크”(commit token)를 반환합니다. 이 북마크는 “이 지점 이전의 모든 변경은 이미 유효하다”는 표시점과 같습니다. 다음 쿼리에 이 북마크를 함께 보내면, D1은 적어도 이 지점보다 새로운 데이터를 보게 해줍니다.
사용자 → 주문 쓰기 → commit token "abc123" 획득
사용자 → 주문 조회(token "abc123" 포함) → 방금 쓴 데이터를 보도록 보장
글로벌 복제의 구현 방식
D1 데이터베이스를 만들면 하나의 “주 리전”(primary location)을 선택합니다. 기본값은 사용자와 가장 가까운 Cloudflare 데이터 센터이며, 수동으로 지정할 수도 있습니다.
쓰기 흐름:
- 쓰기 요청이 가까운 엣지 노드에 도착합니다.
- 주 리전의 Durable Object로 라우팅됩니다.
- 주 데이터베이스 파일에 기록합니다.
- 전 세계 각 리전의 복제본으로 비동기 복제합니다.
읽기 흐름:
- 읽기 요청이 가까운 엣지 노드에 도착합니다.
- 해당 리전의 복제본에서 읽습니다.
- session이 포함된 읽기라면 일관성 북마크가 적용되도록 보장합니다.
Cloudflare 공식 설명에 따르면 글로벌 복제에는 추가 요금이 없습니다. 데이터 전송 비용이 원래 작지 않다는 점을 생각하면 꽤 합리적인 결정입니다. 다만 쓰기 작업은 여전히 주 리전으로 라우팅되고, 지연 시간은 사용자와 주 리전 사이의 물리적 거리에 좌우됩니다. 그래서 주 리전을 미국에 두고 대부분의 사용자가 아시아에 있다면, 쓰기할 때 지연이 확실히 느껴질 수 있습니다.
3. Sessions API 실전: 순차 일관성을 코드로 구현하기
이론은 여기까지 하고, 이제 코드를 보겠습니다.
Sessions API는 D1이 2025년에 출시한 새 기능으로, “쓰기 후 읽기” 일관성 문제를 해결하기 위해 만들어졌습니다. MongoDB의 causal consistency나 CockroachDB의 follower reads를 써본 적이 있다면 개념은 비슷합니다. 어떤 표시를 사용해 인과관계를 추적하는 방식입니다.
가장 기본적인 사용법
// Session 생성
const session = env.DB.withSession();

// 일반 읽기 쿼리, 가까운 복제본으로 라우팅됨
const { results } = await session.prepare(
  "SELECT * FROM products WHERE category = ?"
).bind("electronics").all();

// 쓰기 쿼리, 자동으로 주 데이터베이스로 라우팅됨
await session.prepare(
  "INSERT INTO orders (user_id, product_id, quantity) VALUES (?, ?, ?)"
).bind(userId, productId, 2).run();

// 현재 Session의 일관성 북마크 가져오기
const bookmark = session.latestCommitToken;
여기서 핵심은 withSession()입니다. 이것은 하나의 “세션 컨텍스트”를 만들고, 이 컨텍스트 안의 모든 작업은 같은 일관성 뷰를 공유합니다.
세 가지 일관성 모드
Sessions API는 서로 다른 사용 시나리오에 맞춰 세 가지 모드를 제공합니다.
1. first-unconstrained(기본값)
const session = env.DB.withSession("first-unconstrained");가장 느슨한 모드입니다. 읽기 작업은 해당 복제본이 최신인지와 관계없이 가까운 복제본에서 바로 읽습니다. 상품 목록이나 블로그 글 표시처럼 실시간성이 크게 중요하지 않은 시나리오에 적합합니다.
2. first-primary
const session = env.DB.withSession("first-primary");첫 번째 읽기 작업은 주 데이터베이스로 라우팅되고, 이후 읽기 작업은 복제본을 사용합니다. 이렇게 하면 Session을 만든 시점의 최신 상태 이상을 읽는다고 보장할 수 있습니다. “방금 쓴 데이터”를 봐야 하지만 매번 주 데이터베이스를 조회하고 싶지는 않은 시나리오에 적합합니다.
3. 북마크로 이전 세션 이어가기
// 요청 헤더에서 이전 북마크 가져오기
const previousToken = request.headers.get("x-d1-token") ?? "first-unconstrained";

// Session 생성, 이전 세션 이어가기
const session = env.DB.withSession(previousToken);

// 작업 실행...

// 새 북마크 반환
response.headers.set("x-d1-token", session.latestCommitToken);
가장 강력한 사용법입니다. 북마크를 클라이언트, 예를 들어 브라우저 Cookie나 요청 헤더에 저장하고 매 요청마다 함께 보내면 여러 요청을 넘어 일관성을 유지할 수 있습니다.

실전 시나리오: 이커머스 주문 시스템
글로벌 이커머스 플랫폼을 만든다고 가정해 보겠습니다. 사용자가 상품을 탐색할 때는 가까운 복제본에서 읽어 지연 시간을 최소화하고 싶습니다. 하지만 사용자가 주문한 뒤 주문을 조회할 때는 방금 만든 주문이 반드시 보여야 합니다.
export default {
  async fetch(request, env) {
    const url = new URL(request.url);

    // 요청 헤더에서 session token 가져오기(첫 요청은 null)
    const token = request.headers.get("x-d1-token") ?? "first-unconstrained";
    const session = env.DB.withSession(token);

    // 경우 1: 상품 목록 탐색(강한 일관성 불필요)
    if (url.pathname === "/api/products") {
      const { results } = await session.prepare(
        "SELECT * FROM products WHERE status = ?"
      ).bind("active").all();

      return new Response(JSON.stringify(results), {
        headers: {
          "Content-Type": "application/json",
          "x-d1-token": session.latestCommitToken
        }
      });
    }

    // 경우 2: 주문 생성(쓰기 작업, 자동으로 주 데이터베이스로 라우팅)
    if (url.pathname === "/api/orders" && request.method === "POST") {
      const body = await request.json();

      await session.prepare(`
        INSERT INTO orders (user_id, total_amount, status)
        VALUES (?, ?, ?)
      `).bind(body.userId, body.total, "pending").run();

      // 쓰기 직후 즉시 조회해 방금 쓴 데이터를 읽도록 보장
      const order = await session.prepare(`
        SELECT * FROM orders WHERE user_id = ?
        ORDER BY created_at DESC LIMIT 1
      `).bind(body.userId).first();

      return new Response(JSON.stringify(order), {
        headers: {
          "Content-Type": "application/json",
          "x-d1-token": session.latestCommitToken  // 새 token 반환
        }
      });
    }

    // 경우 3: 주문 상세 조회(이전 token을 사용해 일관성 보장)
    if (url.pathname.startsWith("/api/orders/")) {
      const orderId = url.pathname.split("/")[3];

      // 사용자가 방금 주문했다면 token이 최신 데이터를 읽도록 보장함
      const order = await session.prepare(
        "SELECT * FROM orders WHERE id = ?"
      ).bind(orderId).first();

      return new Response(JSON.stringify(order), {
        headers: {
          "Content-Type": "application/json",
          "x-d1-token": session.latestCommitToken
        }
      });
    }
  }
}
이 설계는 실용적입니다. 상품을 탐색할 때는 first-unconstrained를 사용해 성능을 최대로 끌어올립니다. 주문 후에는 클라이언트가 token을 저장하고, 이후 주문을 볼 때 함께 보내 일관성을 보장합니다.
클라이언트는 어떻게 맞춰야 하나
프론트엔드가 해야 할 일은 단순합니다. x-d1-token을 저장해 두고 매 요청마다 함께 보내면 됩니다.
// 프론트엔드 예시
let d1Token = localStorage.getItem('d1-token') ?? 'first-unconstrained';

async function fetchProducts() {
  const response = await fetch('/api/products', {
    headers: { 'x-d1-token': d1Token }
  });
  d1Token = response.headers.get('x-d1-token');
  localStorage.setItem('d1-token', d1Token);
  return response.json();
}

async function createOrder(data) {
  const response = await fetch('/api/orders', {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
      'x-d1-token': d1Token
    },
    body: JSON.stringify(data)
  });
  d1Token = response.headers.get('x-d1-token');
  localStorage.setItem('d1-token', d1Token);
  return response.json();
}
보면 코드 양은 많지 않지만 해결하는 문제는 큽니다. 이 메커니즘이 없으면 사용자가 주문 직후 주문 목록을 보러 갔을 때 아무것도 표시되지 않을 수 있고, 사용자 경험은 상당히 나빠집니다.
4. 성능 벤치마크와 경쟁 제품 비교
데이터는 거짓말을 하지 않습니다. 여기서는 주요 선택지를 비교해 정리했습니다. 데이터는 공식 문서와 커뮤니티 실측을 바탕으로 합니다.
지연 시간 비교
| 선택지 | 읽기 지연 시간 (p50) | 읽기 지연 시간 (p99) | 쓰기 지연 시간 (p50) | 설명 |
|---|---|---|---|---|
| D1 | ~0.5ms | ~2-5ms | ~5-30ms | 읽기는 엣지 복제본, 쓰기는 주 데이터베이스 |
| Turso | ~0.02ms | ~0.1ms | ~15-50ms | 임베디드 읽기, 말도 안 되게 빠름 |
| PlanetScale | ~3-8ms | ~10-20ms | ~3-8ms | MySQL 호환, 읽기와 쓰기 모두 프록시 사용 |
| PostgreSQL (Neon) | ~3-10ms | ~20-50ms | ~1-5ms | 전통적인 아키텍처, 콜드 스타트가 느림 |
몇 가지 관찰이 있습니다.
Turso의 읽기 지연 시간은 정말 빠릅니다. 0.02밀리초면 사실상 로컬 메모리 접근에 가까운 속도입니다. 임베디드 SQLite를 사용해 데이터베이스 파일을 엣지 노드에 직접 복제하고, 읽기를 완전히 로컬화하기 때문입니다. 하지만 대가가 있습니다. 데이터 동기화를 추가로 처리해야 하고, 쓰기 지연 시간은 오히려 더 높습니다.
D1의 읽기 지연 시간도 매우 좋습니다. 엣지 데이터베이스에서 0.5밀리초는 이미 최상위 수준입니다. 하지만 쓰기 지연 시간의 차이는 분명합니다. 쓰기 작업은 반드시 주 데이터베이스로 라우팅되어야 하며, 물리적 거리가 지연 시간의 하한을 결정하기 때문입니다. 주 데이터베이스가 미국 서부에 있고 사용자가 싱가포르에 있다면 쓰기 작업은 최소한 태평양을 건너야 하므로 30밀리초 정도는 기본으로 들어갑니다.
PlanetScale과 Neon은 전통적인 애플리케이션에 더 잘 맞습니다. 지연 시간 데이터만 보면 D1이나 Turso만큼 눈에 띄지는 않습니다. 하지만 생태계가 성숙하고 기능이 완전하다는 장점이 있습니다. 복잡한 SQL 기능, 예를 들어 저장 프로시저, 트리거, 다양한 인덱스 타입이 필요하다면 이 둘이 더 적합합니다.
처리량 비교
| 선택지 | 읽기 처리량 (QPS) | 쓰기 처리량 (QPS) | 설명 |
|---|---|---|---|
| D1 | 10K-100K | 500-2K | 단일 데이터베이스 제한 |
| Turso | 무제한(로컬 읽기) | 동기화 제한을 받음 | 각 엣지 노드가 독립적으로 읽음 |
| PlanetScale | 10K-50K | 5K-20K | 샤딩 후 확장 가능 |
| PostgreSQL | 10K-100K | 10K-50K | 인스턴스 사양에 따라 다름 |
D1의 쓰기 처리량은 약점입니다. 단일 작성자 아키텍처 자체가 상한을 결정합니다. 애플리케이션이 초당 5000건 이상의 데이터를 써야 한다면 D1이 병목이 될 수 있습니다. 이때는 데이터베이스를 나누거나, 복잡도가 올라가는 것을 감수하기 싫다면 다른 선택지로 바꾸는 편이 낫습니다.
무료 한도 비교
| 선택지 | 저장 공간 | 읽기 한도 | 쓰기 한도 | 비고 |
|---|---|---|---|---|
| D1 | 5GB | 월 250억 행 | 월 5000만 행 | 데이터베이스당 10GB 상한 |
| Turso | 9GB | 월 10억 행 | 월 2500만 행 | 복제 트래픽 포함 |
| PlanetScale | 1GB | 월 100억 행 | 월 100억 행 | 쓰기 제한 없음 |
| Neon | 0.5GB | 월 1억 단위 | 월 1억 단위 | 단위=읽기 또는 쓰기 |
무료 한도만 보면 D1은 꽤 넉넉합니다. 월 250억 행 읽기는 개인 프로젝트와 소형 애플리케이션에는 충분하고도 남습니다. 다만 D1의 쓰기 제한은 주의해야 합니다. 월 5000만 행이면 하루 평균 166만 행입니다. 로그 수집이나 이벤트 추적 업로드처럼 고빈도 쓰기 시나리오라면 쉽게 초과할 수 있습니다.
과금 방식
D1의 유료 과금 방식은 단순합니다. 사용량 기반이며 최소 과금은 없습니다. 무료 한도를 초과하면 백만 행 읽기당 $0.001, 백만 행 쓰기당 $0.10입니다. 저장 공간은 GB당 월 $0.75입니다.
Turso의 과금은 조금 복잡합니다. “행 읽기”와 “복제 트래픽”이라는 두 축이 있고, 데이터가 자주 업데이트되면 복제 비용이 높아질 수 있습니다.
PlanetScale은 “행 읽기”와 “행 쓰기”를 기준으로 과금합니다. 쓰기 비용은 D1보다 낮지만 읽기 비용은 조금 더 높습니다.
제 의견은 이렇습니다. 이미 Cloudflare 생태계(Workers, KV, R2)를 깊게 쓰고 있다면 D1의 과금 통합 덕분에 청구서를 더 명확하게 볼 수 있습니다. 독립 프로젝트라면 세 가지를 모두 시험해 보고 실제 데이터로 결정하는 편이 좋습니다.
5. 선택 의사결정 트리: 언제 D1을 선택할까
이렇게 많이 이야기했지만 결국 질문은 하나입니다. D1을 선택해야 할까요? 간단한 의사결정 트리를 그려보겠습니다.
D1에 적합한 시나리오
애플리케이션이 읽기 집약적입니다. 예를 들어 콘텐츠 사이트, 이커머스 플랫폼(탐색이 중심), 블로그, 문서 시스템입니다. 이런 애플리케이션은 90% 이상의 작업이 읽기입니다. D1의 글로벌 읽기 복제는 지연 시간을 한 자릿수 밀리초까지 낮출 수 있습니다.
사용자가 전 세계에 분포합니다. 전통적인 단일 리전 데이터베이스는 먼 지역의 사용자가 매 요청마다 바다를 건너야 합니다. D1은 데이터를 “사용자 가까이” 가져오고, 경험 개선은 바로 체감됩니다.
이미 Cloudflare Workers를 사용하고 있습니다. D1과 Workers의 통합은 네이티브입니다. 몇 줄의 설정만으로 사용할 수 있습니다. 별도의 데이터베이스 연결 풀도 필요 없고, 콜드 스타트를 걱정할 필요도 없으며, 개발 경험도 매끄럽습니다.
데이터베이스 규모가 10GB 이하입니다. D1의 단일 데이터베이스 제한은 10GB이며, 초과하면 분리해야 합니다. 하지만 비즈니스 구조가 원래 “테넌트마다 데이터베이스 하나”라면 이 제한이 오히려 크게 문제가 되지 않을 수 있습니다.
D1에 적합하지 않은 시나리오
고빈도 쓰기 애플리케이션. 실시간 입찰 시스템, 로그 파이프라인, IoT 데이터 수집처럼 초당 수만 번의 쓰기가 발생할 수 있는 시나리오에서는 D1의 단일 작성자 아키텍처가 병목이 됩니다. PostgreSQL, ClickHouse, TimescaleDB가 더 적합합니다.

복잡한 트랜잭션이 필요합니다. D1은 현재 SQLite의 트랜잭션 수준을 지원합니다. SERIALIZABLE 격리, 데이터베이스 간 트랜잭션, 복잡한 저장 프로시저가 필요하다면 요구사항을 만족시키기 어렵습니다.
데이터가 10GB를 넘습니다. 분리는 가능하지만 운영 복잡도가 늘어납니다. 데이터가 태생적으로 큰 경우, 예를 들어 시계열 데이터나 로그 아카이브라면 처음부터 다른 선택지를 고르는 편이 낫습니다.
강한 일관성이 필요합니다. D1은 최종 일관성 시스템입니다. 쓰기 직후 바로 읽으면 최신 데이터를 보지 못할 수 있습니다(Sessions API를 쓰지 않는다면). 비즈니스가 어느 시점, 어느 지역에서도 반드시 최신 데이터를 읽어야 한다면 다른 선택지를 고려해야 합니다.
PostgreSQL에서 마이그레이션할 때의 주의사항
기존 PostgreSQL 애플리케이션을 D1으로 옮기고 싶다면 미리 고려해야 할 점이 몇 가지 있습니다.
1. SQL 방언 차이
SQLite는 PostgreSQL의 일부 기능을 지원하지 않습니다.
RETURNING절이 없습니다(두 단계 필요: 삽입 후 조회).SERIAL타입이 없습니다(INTEGER PRIMARY KEY AUTOINCREMENT사용).JSONB타입이 없습니다(TEXT에 JSON을 저장하고json_extract()함수 사용).ARRAY타입이 없습니다(연관 테이블 필요).
2. 데이터 마이그레이션 도구
Cloudflare는 PostgreSQL에서 SQL을 내보낸 뒤 D1으로 가져오는 마이그레이션 도구를 공식으로 제공합니다.
# PostgreSQL 데이터 내보내기
pg_dump --format=insert mydb > dump.sql

# D1으로 가져오기
npx wrangler d1 execute my-d1-database --file=dump.sql
다만 복잡한 schema는 수동 조정이 필요할 수 있습니다.
3. 연결 방식 변화
전통적인 데이터베이스는 장기 연결을 사용하지만 D1은 상태 없는 함수 호출 방식입니다. ORM을 조정해야 할 수도 있고, 원시 SQL을 직접 쓰는 편이 나을 수도 있습니다. Prisma에는 D1 어댑터가 있지만 기능은 아직 개선 중입니다.
빠른 판단
아직도 확신이 없다면 다음의 간단한 기준을 써보세요.
애플리케이션의 쓰기 빈도 > 1000회/초?
├─ 예 → D1을 선택하지 않음
└─ 아니오
    └─ 강한 일관성이 필요한가?
        ├─ 예 → D1을 선택하지 않음(또는 Sessions API와 함께 사용)
        └─ 아니오
            └─ 데이터 규모 > 10GB?
                ├─ 예 → 신중하게 검토
                └─ 아니오 → D1이 잘 맞음
정리
D1의 핵심 가치는 세 문장으로 요약할 수 있습니다. 엣지 배포가 지연 시간을 한 자릿수 밀리초로 낮추고, 서버리스 아키텍처가 운영 부담을 줄이며, Sessions API가 분산 시스템에서 가장 골치 아픈 일관성 문제를 단순한 방식으로 해결합니다.
하지만 모든 시나리오에 맞는다는 뜻은 아닙니다. 고빈도 쓰기, 복잡한 트랜잭션, 초대규모 데이터에서는 PostgreSQL과 전용 시계열 데이터베이스가 여전히 더 적합합니다. 선택에는 은탄환이 없고, 결국 트레이드오프만 있습니다.
전 세계 사용자를 대상으로 하고, 읽기가 많고 쓰기가 적은 Web 애플리케이션을 만들고 있으며, 이미 Cloudflare Workers를 사용한다면 D1은 시도해 볼 가치가 있습니다. 테스트 데이터베이스를 만드는 데는 몇 분이면 충분합니다.
# 데이터베이스 생성
npx wrangler d1 create my-first-db

# 테이블 생성
npx wrangler d1 execute my-first-db --command="CREATE TABLE users (id INTEGER PRIMARY KEY, name TEXT)"

# 데이터 삽입
npx wrangler d1 execute my-first-db --command="INSERT INTO users (name) VALUES ('test')"
직접 실행해 보고 도쿄에서 미국 서부 데이터베이스까지의 지연 시간 차이를 느껴보면, 이 선택지가 자신의 프로젝트에 맞는지 금방 알 수 있습니다.
"D1은 Cloudflare의 SQLite 엣지 데이터베이스로, 글로벌 읽기 복제와 서버리스 경험을 제공합니다. Sessions API는 Lamport 타임스탬프로 순차 일관성을 구현해, 분산 시스템에서 흔히 발생하는 쓰기 후 읽기 일관성 문제를 해결합니다."
참고 자료
- Building D1: a Global Database — Cloudflare 공식 블로그, 2024
- D1 Global Read Replication Beta — Cloudflare 공식 블로그, 2025
- D1 Getting Started — Cloudflare 공식 문서
- The SQLite Renaissance — DEV Community, 2026
- Database Free Tier Comparison 2026 — Agent Deals
Cloudflare D1 데이터베이스 빠르게 시작하기
데이터베이스 생성부터 Sessions API로 일관성 있는 읽기를 구현하는 전체 흐름
⏱️ Estimated time: 15 min
- 1
Step 1: D1 데이터베이스 생성
wrangler CLI로 데이터베이스를 생성합니다.
```bash
npx wrangler d1 create my-first-db
```
생성 후 반환되는 database_id를 wrangler.toml에 설정합니다.
```toml
[[d1_databases]]
binding = "DB"
database_name = "my-first-db"
database_id = "your-database-id"
``` - 2
Step 2: 데이터 테이블 생성
SQL을 실행해 테이블 구조를 만듭니다.
```bash
npx wrangler d1 execute my-first-db --command="CREATE TABLE users (id INTEGER PRIMARY KEY, name TEXT, created_at DATETIME DEFAULT CURRENT_TIMESTAMP)"
```
SQL 파일로 일괄 실행할 수도 있습니다.
```bash
npx wrangler d1 execute my-first-db --file=./schema.sql
``` - 3
Step 3: Worker에서 Sessions API 사용
세션이 포함된 데이터베이스 연결을 만들어 쓰기 후 읽기 일관성을 구현합니다.
```typescript
export default {
async fetch(request, env) {
// 요청 헤더에서 session token 가져오기
const token = request.headers.get("x-d1-token") ?? "first-unconstrained";
const session = env.DB.withSession(token);
// 데이터 쓰기
await session.prepare("INSERT INTO users (name) VALUES (?)")
.bind("test").run();
// 읽을 때 일관성 보장
const { results } = await session.prepare("SELECT * FROM users")
.all();
return new Response(JSON.stringify(results), {
headers: { "x-d1-token": session.latestCommitToken }
});
}
}
``` - 4
Step 4: 글로벌 읽기 복제 설정
wrangler.toml에서 주 리전을 지정합니다.
```toml
[[d1_databases]]
binding = "DB"
database_name = "my-first-db"
database_id = "your-database-id"
primary_location_hint = "apne1" # 도쿄 리전
```
선택 가능한 리전 코드:
- apne1: 도쿄
- sfo1: 샌프란시스코
- eur3: 프랑크푸르트
FAQ
Cloudflare D1과 Turso는 무엇이 다른가요?
• D1: 단일 작성자 아키텍처입니다. 쓰기는 주 데이터베이스로 라우팅되고, 읽기 지연 시간은 약 0.5ms이며, 읽기가 많고 쓰기가 적은 시나리오에 적합합니다.
• Turso: 임베디드 읽기 방식이라 지연 시간이 더 낮지만(약 0.02ms), 데이터 동기화가 더 복잡합니다.
D1의 장점은 Cloudflare Workers와 네이티브로 통합되고 무료 한도가 더 크다는 점입니다(월 250억 행 읽기). Turso의 장점은 극단적으로 낮은 읽기 지연 시간으로, 지연 시간에 민감한 시나리오에 적합합니다.
D1의 단일 데이터베이스 10GB 제한은 어떻게 넘을 수 있나요?
• 데이터베이스 분리 전략: 비즈니스 모듈별로 나누고, 각 모듈에 하나의 데이터베이스를 둡니다.
• 테넌트 격리: 테넌트마다 하나의 데이터베이스를 둡니다. D1은 최대 50,000개의 데이터베이스를 지원합니다.
• 하이브리드 저장소: 핫 데이터는 D1에 두고, 콜드 데이터는 R2나 다른 객체 스토리지로 옮깁니다.
데이터가 계속 증가해 10GB를 넘는다면 PlanetScale이나 전통적인 PostgreSQL 같은 다른 선택지를 평가하는 편이 좋습니다.
Sessions API의 세 가지 모드는 어떻게 선택해야 하나요?
• first-unconstrained(기본값): 상품 목록, 블로그 표시처럼 실시간성이 크게 중요하지 않은 시나리오에 적합합니다.
• first-primary: 방금 쓴 데이터를 봐야 하지만 매번 주 데이터베이스를 조회하고 싶지는 않은 시나리오에 적합합니다.
• commit token 모드: 이커머스 주문, 주문 조회처럼 요청을 넘어서도 일관성이 필요한 시나리오에 적합합니다.
이커머스 시스템이라면 탐색 중에는 first-unconstrained를 쓰고, 주문 후 token을 저장해 이후 요청에 함께 보내는 방식을 추천합니다.
D1은 고빈도 쓰기 시나리오에 적합한가요?
애플리케이션에 다음과 같은 특성이 있다면 다른 선택지를 권장합니다.
• 실시간 입찰 시스템
• 로그 파이프라인, 이벤트 추적 업로드
• IoT 데이터 수집
• 초당 1000회 이상의 쓰기
이런 시나리오에는 PostgreSQL, ClickHouse, TimescaleDB가 더 잘 맞습니다.
PostgreSQL에서 D1으로 마이그레이션할 때 무엇을 주의해야 하나요?
• SQL 방언: SQLite는 RETURNING, SERIAL, JSONB, ARRAY 타입을 지원하지 않습니다.
• 연결 방식: 장기 연결에서 상태 없는 함수 호출 방식으로 바뀝니다.
• ORM 적응: Prisma에는 D1 어댑터가 있지만 기능은 아직 개선 중입니다.
마이그레이션 단계:
1. pg_dump로 데이터 내보내기
2. 호환되지 않는 SQL 문법을 수동 조정하기
3. wrangler d1 execute로 가져오기
먼저 작은 규모의 데이터로 테스트해 기능이 정상인지 확인한 뒤 전체 마이그레이션을 진행하는 편이 좋습니다.
D1의 글로벌 복제에는 추가 요금이 있나요?
다만 다음 사항은 주의해야 합니다.
• 쓰기 작업은 여전히 주 데이터베이스로 라우팅되며, 지연 시간은 사용자와 주 데이터베이스 사이의 물리적 거리에 좌우됩니다.
• 주 데이터베이스가 미국에 있고 사용자가 아시아에 있다면 쓰기 지연 시간은 약 30ms 이상이 될 수 있습니다.
• 읽기 무료 한도는 높고(월 250억 행), 쓰기 한도는 월 5000만 행입니다.
쓰기 경험을 최적화하려면 주 데이터베이스를 사용자가 가장 많이 몰려 있는 리전에 배치하는 것을 권장합니다.
4분 읽기 · 게시일: 2026년 5월 5일 · 수정일: 2026년 10월 21일

Cloudflare 풀스택
검색으로 들어왔다면 같은 시리즈의 이전 글이나 다음 글로 이동하는 것이 가장 빠릅니다.
이전
Cloudflare Dynamic Workers: AI Agent 샌드박스가 컨테이너보다 100배 빠른 이유
Cloudflare Dynamic Workers는 V8 Isolates로 AI Agent 샌드박스를 구현해 컨테이너보다 시작 속도를 100배 높이고 메모리 효율을 10-100배 개선합니다. 이 글에서는 기술 원리, 보안 메커니즘, API 실전, 비용 대비 효과를 깊이 있게 분석하고 기술 선택 기준을 제시합니다.
23편 중 20편
다음
Cloudflare 무료 플랜 제한 목록: CDN, DNS, WAF, Workers 어디까지 충분할까?
Cloudflare 무료 플랜 제한 전체 정리: Workers 일 10만 요청, Pages 월 500회 빌드, DNS 1000개 레코드, R2 10GB 저장소. 내 프로젝트가 한도를 넘는지 판단할 수 있도록 시나리오별 결정표와 업그레이드 기준을 함께 정리했습니다.
23편 중 22편


댓글
GitHub로 로그인하여 댓글을 남기세요