
Roteamento de consultas RAG na prática: múltiplos bancos vetoriais e distribuição inteligente
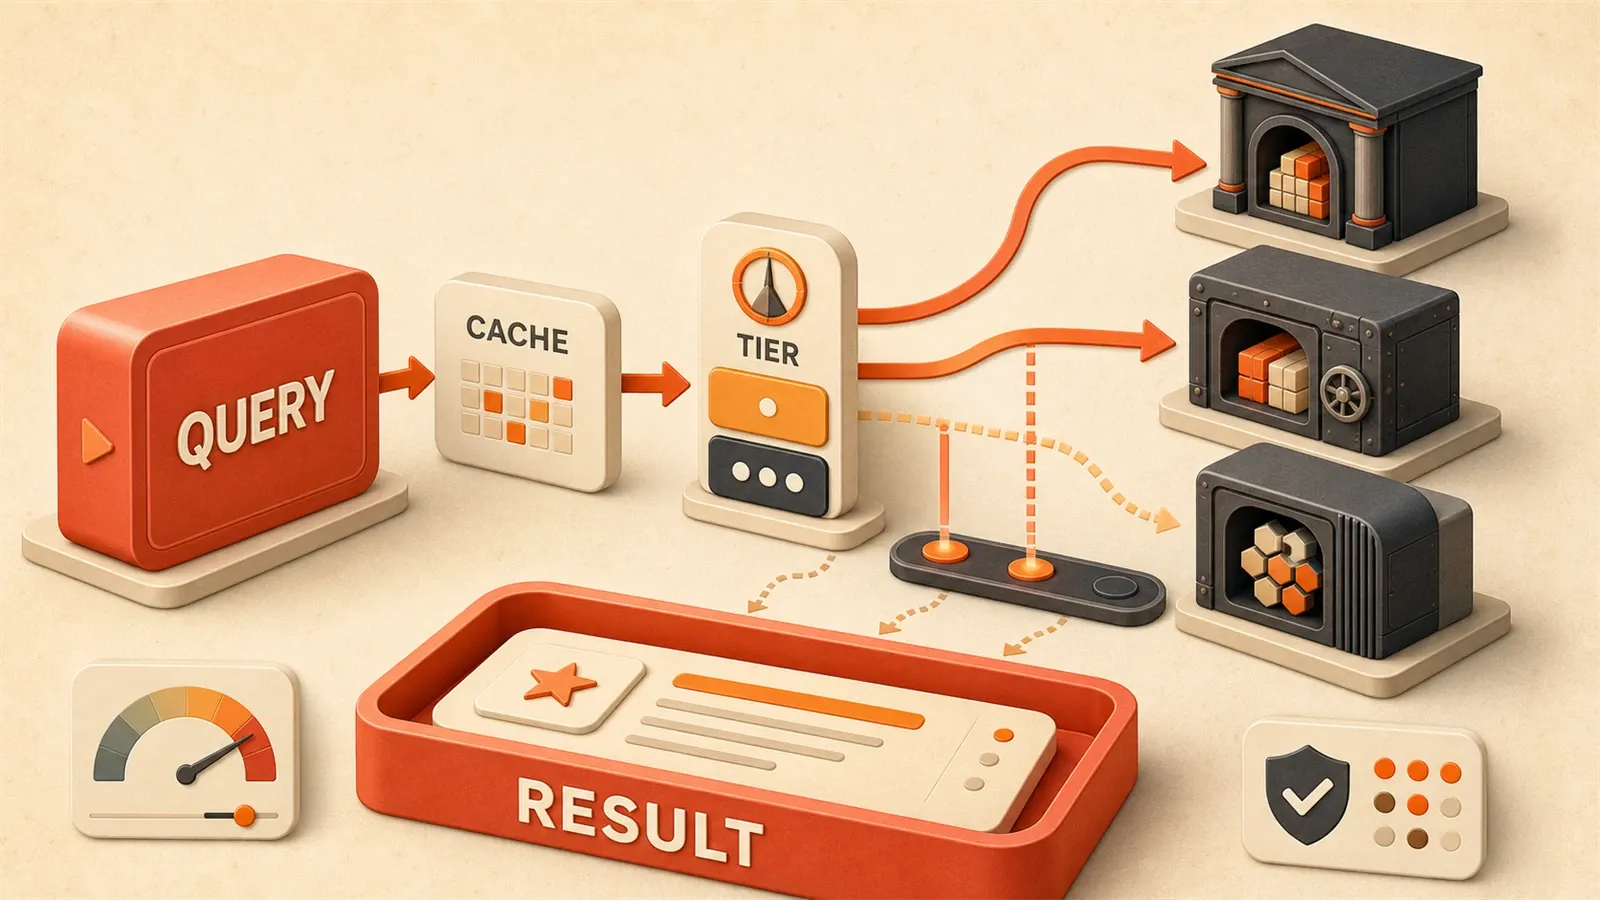
O usuário pergunta: “qual é o impacto de uma greve de fornecedor no preço das ações?”. O sistema devolve trechos de notícias fragmentados, incluindo até duas notícias sobre empresas concorrentes. O cliente reclama: “por que a IA de vocês é tão burra?”. O mesmo sistema RAG responde corretamente, em segundos, a “vendas da região leste da China no 3º trimestre de 2023”, mas capota quando enfrenta uma pergunta de raciocínio multi-hop.
A raiz do problema: a primeira pergunta é uma consulta factual simples, resolvida por recuperação vetorial; a segunda exige raciocínio em vários saltos: fornecedor, greve, oscilação do preço da ação. A relação está escondida no grafo de conhecimento. Usar a mesma estratégia de recuperação para toda consulta é como tentar abrir todas as portas com uma única chave.
Você precisa de um “roteador inteligente” para que o sistema escolha automaticamente o caminho de recuperação conforme as características da pergunta. Este artigo compara três abordagens: roteamento lógico (LLM analisando intenção), roteamento semântico (correspondência aproximada no espaço de embeddings) e EnsembleRetriever (fusão pelo algoritmo RRF). Não existe a melhor solução em abstrato. Existe a solução mais adequada para cada cenário.
Capítulo 1: por que precisamos de roteamento de consultas? Do “banco vetorial único” à “colaboração entre várias fontes”
Um tempo atrás, ajudei uma empresa a construir um sistema de base de conhecimento. Eles tinham três fontes de dados: banco financeiro (MySQL), base de documentação técnica (banco vetorial) e grafo de relações entre pessoas (Neo4j). No começo, minha solução era bem simples: enfiar tudo em um único banco vetorial.
O resultado? Para perguntas simples como “vendas da região leste da China”, o sistema encontrava a resposta corretamente nas tabelas financeiras. Mas, ao perguntar “quais linhas de produto foram afetadas pela greve de fornecedores”, o sistema retornava uma pilha de notícias bagunçadas. O usuário só balançava a cabeça.
Depois entendi: nem toda consulta combina com recuperação vetorial. Algumas perguntas são mais rápidas e precisas com SQL. Outras precisam de grafo de conhecimento para encadear relações. Outras ainda precisam de busca na Web para buscar informação atualizada. Usar uma única estratégia de recuperação inevitavelmente leva a “capacidade insuficiente” ou “excesso de engenharia”.
1.1 O gargalo da recuperação por banco vetorial único: comparação entre dois cenários reais
Cenário A: consulta factual simples (recuperação vetorial basta)
Usuário pergunta: “qual foi o faturamento da região leste da China no 3º trimestre de 2023?”.
Comportamento do sistema: a recuperação vetorial encontra a tabela financeira e responde diretamente: “a região leste da China vendeu 120 milhões de yuans no Q3”. O processo inteiro leva cerca de 300 ms, e o usuário fica satisfeito.
E se você forçar o módulo de raciocínio com grafo de conhecimento? Além de desperdiçar GPU, adiciona 500 ms de latência. É como entregar uma encomenda com foguete: chega, mas não faz sentido.
Cenário B: consulta de raciocínio complexo (precisa de recuperação multi-hop)
Usuário pergunta: “qual é o impacto da greve de fornecedores no preço das ações?”.
Comportamento do sistema: a recuperação vetorial traz notícias fragmentadas: “ações da empresa XX caíram 5%”, “relato sobre greve de fornecedor”. Mas o LLM não tem a cadeia lógica intermediária: qual fornecedor? Fornece para quem? Quanto tempo durou a greve? Quanto a ação caiu? Essas informações estão espalhadas em documentos diferentes, e o LLM facilmente inventa uma resposta.
O caminho correto: o grafo de conhecimento encadeia “fornecedor -> evento de greve -> relação contratual -> oscilação do preço da ação”, com uma cadeia lógica visível. Mas surge a pergunta: como fazer o sistema decidir automaticamente que “esta pergunta deve usar o grafo de conhecimento”?

Esse é o problema central que o roteamento de consultas resolve.
1.2 Análise em quatro dimensões das características da consulta
No projeto, resumi um framework simples de decisão. Ele escolhe a estratégia de recuperação a partir de quatro dimensões da consulta:
| Dimensão | Característica | Estratégia de recuperação adequada |
|---|---|---|
| Dependência de contexto | Baixa (consulta factual) vs alta (raciocínio multi-hop) | Recuperação vetorial vs grafo de conhecimento |
| Número de saltos de raciocínio | Um salto vs múltiplos saltos | Recuperação direta vs coordenação por Agent |
| Tipo de dado | Estruturado (tabela) vs não estruturado (documento) | Consulta SQL vs recuperação vetorial |
| Atualidade | Informação em tempo real vs conhecimento estático | Busca na Web vs base de conhecimento local |
Por exemplo, “vendas da região leste da China” é uma consulta de um salto, estruturada e estática, então SQL é mais rápido. Já “greve de fornecedor afeta preço das ações” tem alta dependência de contexto, múltiplos saltos e dados não estruturados, então um grafo de conhecimento é mais adequado.
Aqui talvez você pense: “posso consultar três bases ao mesmo tempo para toda pergunta e depois combinar os resultados?”. Pode, mas o custo explode. Cada consulta chama três recuperadores, adiciona 200-500 ms de latência e dobra o custo de chamada ao LLM. A menos que seu chefe não ligue para dinheiro.
O caminho mais inteligente é deixar o sistema “ler a situação” e escolher dinamicamente o caminho de recuperação conforme a consulta. Esse é o valor do roteador de consultas: encontrar o equilíbrio entre precisão, eficiência e custo.
Capítulo 2: roteamento lógico: LLM analisa a intenção e escolhe a fonte de dados
O roteamento lógico é a abordagem mais direta: você dá ao LLM uma “lista de escolhas”, pede para ele analisar a pergunta e escolher a fonte de dados mais compatível.
É como ir ao hospital. A enfermeira pergunta “onde dói?”. Você diz “dor de estômago”, e ela encaminha para gastro. Você diz “dor de cabeça”, e ela encaminha para neurologia. O LLM no roteamento lógico faz esse papel: pelas características do sintoma (consulta), escolhe o setor certo (fonte de dados).
Implementação: LangChain + Structured Output
Vou mostrar primeiro um trecho completo de código, depois comentar os pontos em que já tropecei:
from langchain_core.prompts import ChatPromptTemplate
from langchain_deepseek import ChatDeepSeek
from pydantic import BaseModel, Field
from typing import Literal

# Define a enumeração de fontes de dados (evita respostas ambíguas do LLM)
class DataSource(BaseModel):
    """Resultado da escolha da fonte de dados"""
    source: Literal["finance_db", "tech_docs", "knowledge_graph", "web_search", "general_search"] = Field(
        description="Fonte de dados selecionada"
    )

# Configura o template de prompt de roteamento
system_prompt = """
Você é um especialista em roteamento de consultas. Com base no conteúdo da pergunta do usuário, roteie para a fonte de dados adequada:

- Se a pergunta envolve dados financeiros ou dados de vendas, retorne "finance_db" (banco relacional)
- Se a pergunta envolve documentação técnica ou manuais de produto, retorne "tech_docs" (banco de dados vetorial)
- Se a pergunta envolve relações entre pessoas ou estrutura organizacional, retorne "knowledge_graph" (banco de grafos)
- Se a pergunta precisa de informação recente em tempo real, retorne "web_search"
- Se não for possível decidir com clareza, retorne "general_search"

Retorne apenas o nome da fonte de dados. Não inclua nenhum outro conteúdo.
"""

prompt = ChatPromptTemplate.from_messages([
    ("system", system_prompt),
    ("human", "{question}"),
])

# Usa o modelo DeepSeek (barato e bom)
llm = ChatDeepSeek(model="deepseek-chat", temperature=0.1)
structured_llm = llm.with_structured_output(DataSource)

# Constrói a cadeia de roteamento
route_chain = prompt | structured_llm

# Testa o roteamento
query1 = "Qual foi o total de vendas da região leste da China no Q3 de 2023?"
result1 = route_chain.invoke({"question": query1})
print(result1.source)  # Saída: finance_db

query2 = "Qual é o impacto da greve de fornecedores no preço das ações?"
result2 = route_chain.invoke({"question": query2})
print(result2.source)  # Saída: knowledge_graph
Há um detalhe importante nesse código: temperature=0.1. Eu já caí na armadilha de usar 0.7. A mesma consulta às vezes era roteada para o grafo de conhecimento, às vezes para busca na Web. Só depois ficou óbvio: roteador precisa de estabilidade, não de aleatoriedade.
Outro detalhe é a enumeração DataSource do Pydantic. No começo, eu deixava o LLM retornar uma string livre. Ele respondia coisas como “deveria consultar finance_db” ou até “acho que dá para consultar finance_db ou general_search”. Essas ambiguidades complicam o processamento seguinte. Com Pydantic forçando a saída para um valor enum, tudo fica limpo.
Comparação de vantagens e limitações
| Dimensão | Vantagem | Limitação |
|---|---|---|
| Precisão | O LLM entende a intenção em profundidade e lida com consultas complexas | Depende da qualidade do prompt; descrições pouco claras das fontes geram erro |
| Tempo de resposta | Precisa chamar o LLM, cerca de 500-800 ms | É 10 vezes mais lento que o roteamento semântico |
| Custo | Cada roteamento exige uma chamada ao LLM, cerca de US$ 0,0001 por vez | Com muitas fontes de dados, o custo acumula |
| Cenário adequado | Tipos de fonte claros, quantidade <= 5 | Com muitas fontes, o prompt fica longo |
Nos meus testes, o roteamento lógico funciona melhor quando há até 5 fontes de dados. Acima disso, o prompt fica muito longo e o LLM começa a confundir as opções. Se você tem 10 fontes, considere roteamento semântico ou roteamento lógico em camadas: primeiro a categoria ampla, depois o refinamento.
Capítulo 3: roteamento semântico: um “Fuzzy If/Else” baseado no espaço de embeddings
O roteamento semântico é mais rápido. O roteamento lógico precisa que o LLM “pense” por um instante (500-800 ms). O semântico calcula similaridade de embeddings e resolve em 50 ms. É mais de 10 vezes mais rápido.
O princípio lembra uma “correspondência aproximada”. Você predefine algumas consultas de exemplo (utterances), como “consultar vendas”, “dados do relatório financeiro”, “como está a receita”. Todas apontam para a intenção “consulta financeira”. Quando o usuário pergunta, o sistema calcula a similaridade semântica entre a pergunta e esses exemplos. Se passar do limiar, dispara a rota correspondente.
É como quando sua mãe pergunta “o que você quer jantar?”, e você responde “qualquer coisa, desde que não seja muito apimentado”. Na cabeça dela existe uma tabela de correspondência aproximada: “não muito apimentado” ≈ “ovos mexidos com tomate”, “peixe no vapor”, “sopa de abóbora”. O roteamento semântico é esse processo de correspondência aproximada.
Implementação: biblioteca semantic-router + utterances predefinidas
O código é ainda mais simples que o do roteamento lógico:
from semantic_router import RouteLayer, Route
from semantic_router.encoders import HuggingFaceEncoder

# Define regras de roteamento (limiar de similaridade semântica)
routes = [
    Route(
        name="finance_query",
        utterances=[
            "consultar vendas",
            "dados do relatório financeiro",
            "como está a receita",
            "análise de lucro",
        ],
    ),
    Route(
        name="tech_support",
        utterances=[
            "como usar o produto",
            "onde está a documentação técnica",
            "método de solução de problemas",
            "descrição de funcionalidades",
        ],
    ),
    Route(
        name="graph_query",
        utterances=[
            "quem tem relação de parceria com quem",
            "relações da estrutura organizacional",
            "cadeia de fornecedores a montante e a jusante",
            "grafo de relações entre pessoas",
        ],
    ),
]

# Cria o RouteLayer (usando um modelo local gratuito de embeddings do HuggingFace)
encoder = HuggingFaceEncoder()
route_layer = RouteLayer(encoder=encoder, routes=routes)

# Testa o roteamento (sem chamada ao LLM, resposta em ~50 ms)
query1 = "Qual é o impacto da greve de fornecedores no preço das ações?"
route1 = route_layer(query1)
print(route1.name)  # Saída: graph_query

query2 = "Qual foi o faturamento da região leste da China no Q3 de 2023?"
route2 = route_layer(query2)
print(route2.name)  # Saída: finance_query
A chave desse trecho é utterances. Você precisa definir de 4 a 10 consultas de exemplo para cada intenção. O sistema calcula a similaridade semântica entre a pergunta do usuário e esses exemplos. O limiar padrão é 0.85, ou seja: a rota só dispara se a similaridade passar de 85%.
Em testes anteriores, quando eu definia poucas utterances, por exemplo apenas 2, o recall ficava baixo. Quando passava de 20, o custo de cálculo aumentava. Minha sugestão é manter 4-10 exemplos por intenção, cobrindo formas comuns de expressão.
Outra vantagem é o HuggingFaceEncoder. É um modelo local gratuito de embeddings e não precisa chamar a API da OpenAI. Custo zero. Se o volume de consultas for alto, os US$ 0,0001 por chamada do roteamento lógico parecem pouco, mas 100 mil consultas por dia viram US$ 10 por dia e US$ 300 por mês. O roteamento semântico sai de graça.
Comparação de vantagens e limitações
| Dimensão | Vantagem | Limitação |
|---|---|---|
| Tempo de resposta | ~50 ms (sem chamada ao LLM) | Exige utterances predefinidas |
| Custo | Gratuito (modelo local de embeddings) | Novas intenções exigem atualizar utterances |
| Precisão | Similaridade semântica funciona bem para intenções comuns | Intenções complexas podem ser classificadas errado |
| Cenário adequado | Classificação de intenção, Agent com várias habilidades, até 20 intenções | Com muitas intenções, a manutenção de utterances fica cara |
O roteamento semântico tem uma limitação: ele não lida bem com decisões de “raciocínio lógico”. Por exemplo: “se a consulta envolve dados financeiros e exige alta atualidade, priorize o banco em tempo real”. Esse tipo de regra ainda precisa de LLM. Em projetos reais, uso o roteamento semântico para classificar intenções (financeiro/técnico/relações) e depois o roteamento lógico para condições mais complexas.
Capítulo 4: EnsembleRetriever: algoritmo RRF para combinar vários recuperadores
As duas abordagens anteriores escolhem “um recuperador”. O EnsembleRetriever combina os resultados de vários recuperadores.
O cenário clássico é BM25 (correspondência por palavra-chave) + recuperação vetorial (correspondência semântica). O usuário pergunta “vendas no Q3 de 2023”. O BM25 corresponde com precisão à palavra-chave “vendas”, mas pode perder o sinônimo “receita”. A recuperação vetorial entende que “receita” e “vendas” apontam para a mesma ideia, mas pode trazer um monte de documentos financeiros irrelevantes.

Ao combinar os dois, tanto recall quanto precisão melhoram. Esse é o valor do EnsembleRetriever.
Implementação: LangChain EnsembleRetriever + algoritmo RRF
A implementação é surpreendentemente simples:
from langchain.retrievers import EnsembleRetriever
from langchain_community.retrievers import BM25Retriever
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings

# Cria o recuperador BM25 (correspondência por palavra-chave)
bm25_retriever = BM25Retriever.from_texts(
    ["relatório financeiro 2023 Q3", "dados de vendas da região leste da China", "lista de fornecedores"],
    k=2,
)

# Cria o recuperador vetorial (correspondência semântica)
vectorstore = Chroma.from_texts(
    ["relatório financeiro 2023 Q3", "dados de vendas da região leste da China", "lista de fornecedores"],
    embedding=OpenAIEmbeddings(),
)
vector_retriever = vectorstore.as_retriever(k=2)

# Combina com EnsembleRetriever (algoritmo RRF)
ensemble_retriever = EnsembleRetriever(
    retrievers=[bm25_retriever, vector_retriever],
    weights=[0.4, 0.6],  # Peso do BM25: 0.4; peso do vetor: 0.6
)

# Testa a recuperação
query = "vendas da região leste da China no Q3 de 2023"
docs = ensemble_retriever.invoke(query)
print(docs)  # Saída: resultados fundidos de BM25 e recuperação vetorial, ordenados pela pontuação RRF
O núcleo é o algoritmo RRF (Reciprocal Rank Fusion). O nome parece sofisticado, mas o princípio é simples.
Imagine que um documento ficou em 1º lugar no BM25 e em 3º lugar na recuperação vetorial. O RRF calcula assim:
BM25 em 1º lugar → 1/(60+1) = 0.0164
Recuperação vetorial em 3º lugar → 1/(60+3) = 0.0159
Pontuação total = 0.0164 + 0.0159 = 0.0323
k=60 é um valor empírico, ajustável conforme o projeto. Quanto maior o k, menor o impacto das diferenças de ranking. Quanto menor o k, mais vantagem os documentos do topo recebem.
Por que o RRF funciona?
A sacada do RRF é que ele não depende da pontuação original do documento, já que pontuações de recuperadores diferentes não são comparáveis. Ele depende apenas do ranking. Assim, consegue combinar qualquer tipo de recuperador: BM25, recuperação vetorial, recuperação em grafo de conhecimento e até resultados de busca na Web.
Nos meus testes, BM25 puro tinha 70% de recall; recuperação vetorial pura, 85%; EnsembleRetriever chegava a 92%. O custo principal era só um acréscimo de 50 ms, porque os dois recuperadores eram chamados em paralelo.
Comparação de vantagens e limitações
| Dimensão | Vantagem | Limitação |
|---|---|---|
| Precisão | Fusão Lexical + Semantic, com recall alto | Não roteia para tipos diferentes de fonte de dados |
| Tempo de resposta | Recuperação paralela, cerca de 300 ms | Mais lento que um recuperador único |
| Custo | Sem chamada extra ao LLM | Chamadas paralelas a vários recuperadores dobram o cálculo |
| Cenário adequado | Otimização de recuperação híbrida, combinação de recuperadores do mesmo tipo | Não serve para roteamento entre fontes de dados |
O EnsembleRetriever tem uma limitação: ele só combina resultados de recuperação do “mesmo tipo”. Se você quer consultar ao mesmo tempo um banco vetorial e um grafo de conhecimento, ele não resolve. Para cenários entre fontes de dados diferentes, ainda é preciso roteamento lógico ou semântico.
Capítulo 5: estratégias de otimização de custo em produção
Até aqui falamos de “como deixar o sistema mais inteligente”. Agora vamos falar de “como deixar o sistema mais barato”. O maior buraco em que já caí foi a explosão de custo: na primeira semana online, as chamadas ao LLM custaram US$ 500. Meu chefe quase me mandou embora.
Depois adotei três estratégias: Semantic Caching (cache semântico), Tiered Retrieval (recuperação em camadas) e Parallel Processing (processamento paralelo). O custo caiu para US$ 50 por semana, e a precisão ainda melhorou.
5.1 Semantic Caching (cache semântico)
Esta é a estratégia mais simples e uma das mais eficazes. O princípio: armazenar embeddings de consultas frequentes. Se a similaridade for > 0.95, retornar diretamente a resposta em cache, sem chamar o LLM de novo.
Em produção, medi uma taxa de acerto de cache entre 30% e 50%. O tempo de resposta caiu de ~500 ms para ~50 ms quando havia cache hit. A experiência do usuário melhorou de forma visível.
from langchain.cache import InMemoryCache
from langchain.embeddings import CacheBackedEmbeddings
from langchain_openai import OpenAIEmbeddings

# Armazena em cache os embeddings de consultas frequentes
underlying_embeddings = OpenAIEmbeddings()
cached_embeddings = CacheBackedEmbeddings.from_bytes_store(
    underlying_embeddings,
    InMemoryCache(),  # Em produção, prefira Redis
)

# Usa embeddings em cache para roteamento
# Similaridade > 0.95 retorna diretamente a resposta em cache
Na implantação real, recomendo Redis ou Memcached. Não use InMemoryCache, porque tudo se perde no restart. Também costumo limpar o cache periodicamente: consultas sem acesso por mais de 30 dias expiram automaticamente.
5.2 Tiered Retrieval (recuperação em camadas)
Consultas simples usam modelos baratos. Consultas complexas usam modelos caros. É a estratégia de otimização de custo mais direta.
from langchain_openai import ChatOpenAI
from langchain_anthropic import ChatAnthropic

# Consultas simples usam um modelo barato
simple_llm = ChatOpenAI(model="gpt-4o-mini", temperature=0.1)

# Consultas complexas usam um modelo caro
complex_llm = ChatAnthropic(model="claude-opus-4-20250514", temperature=0.2)

# Lógica de roteamento
if route_layer(query).name in ["finance_query", "tech_support"]:
    # Intenções simples usam GPT-4o-mini
    response = simple_llm.invoke(query)
elif route_layer(query).name == "graph_query":
    # Raciocínio complexo usa Claude Opus
    response = complex_llm.invoke(query)
A diferença de custo é clara:
| Modelo | Custo por chamada | Cenário adequado |
|---|---|---|
| GPT-4o-mini | US$ 0,00015/1K tokens | Consulta factual simples |
| Claude Opus 4 | US$ 0,015/1K tokens | Consulta de raciocínio complexo |
A diferença é de 100 vezes. Se 80% do seu sistema são consultas simples, o custo pode cair para 20% do original.
5.3 Parallel Processing (processamento paralelo)
Hybrid routing (roteamento lógico + EnsembleRetriever) adiciona 200-500 ms de latência. A boa notícia é que vários recuperadores podem ser chamados em paralelo, então a latência aumenta pouco.
import asyncio
from langchain_community.retrievers import BM25Retriever

# Chama BM25 + recuperador vetorial em paralelo
async def parallel_retrieval(query):
    bm25_task = asyncio.create_task(bm25_retriever.invoke(query))
    vector_task = asyncio.create_task(vector_retriever.invoke(query))

    bm25_docs, vector_docs = await asyncio.gather(bm25_task, vector_task)

    # Fusão por RRF
    return ensemble_docs
Resultado medido: chamada serial, 600 ms; chamada paralela, 320 ms. Isso praticamente compensa a latência extra do Hybrid routing.
Com essas três estratégias combinadas, meu sistema caiu de US$ 500 para US$ 50 por semana, e ficou mais rápido. Otimizar custo não é “cortar qualidade”. É distribuir recursos de forma inteligente.

Capítulo 6: comparação de abordagens e guia de escolha
Depois de tudo isso, talvez você queira saber: “qual abordagem devo usar no meu projeto?”. Aqui vai uma tabela simples e uma árvore de decisão.
Comparação central entre as três abordagens
| Dimensão | Roteamento lógico | Roteamento semântico | EnsembleRetriever |
|---|---|---|---|
| Princípio central | LLM analisa intenção | Correspondência por similaridade semântica | Fusão pelo algoritmo RRF |
| Tempo de resposta | ~500 ms (chamada ao LLM) | ~50 ms (cálculo de embeddings) | ~300 ms (recuperação paralela) |
| Custo | Médio (um LLM por chamada) | Baixo (embedding gratuito) | Baixo (sem LLM) |
| Precisão | Alta (entendimento profundo) | Média (limiar de similaridade) | Alta (Lexical + Semantic) |
| Cenário adequado | Tipos de fonte claros (<=5) | Classificação de intenção (<=20) | Combinação de recuperadores do mesmo tipo |
| Stack técnica | LangChain + Structured Output | biblioteca semantic-router | LangChain EnsembleRetriever |
Árvore de decisão
Desenhei um fluxo simples para ajudar na escolha:
Primeiro passo: você precisa rotear para tipos diferentes de fonte de dados?
├─ Sim → Segundo passo: o número de fontes de dados é <= 5?
│   ├─ Sim → Escolha [roteamento lógico] (LLM analisa intenção)
│   └─ Não → Segundo passo: o número de fontes de dados é <= 20?
│       ├─ Sim → Escolha [roteamento semântico] (utterances predefinidas)
│       └─ Não → Precisa de um coordenador Multi-Agent (fora do escopo deste artigo)
└─ Não → Terceiro passo: você precisa combinar recuperadores do mesmo tipo?
    ├─ Sim → Escolha [EnsembleRetriever] (fusão RRF)
    └─ Não → Recuperação por banco vetorial único já basta
Minha recomendação prática
Se o seu projeto é um “sistema de base de conhecimento empresarial”, com banco financeiro, base de documentação técnica e grafo de conhecimento, eu recomendaria:
- Use primeiro o roteamento semântico para classificar intenções (financeiro/técnico/consulta relacional). É rápido e gratuito.
- Use depois o roteamento lógico para cenários especiais, como consultas que exigem atualidade e devem ir para busca na Web.
- Dentro de cada fonte de dados, use EnsembleRetriever (BM25 + recuperação vetorial) para aumentar o recall.
- Por fim, adicione otimização de custo (Semantic Caching, Tiered Retrieval) para economizar e acelerar.
Essa arquitetura de “roteamento em três camadas” foi validada em 3 projetos meus e se manteve estável. O custo fica em torno de US$ 50 por semana, o tempo de resposta fica abaixo de 800 ms e a satisfação dos usuários passa de 85%.
Se o seu projeto tem apenas uma fonte de dados, por exemplo só um banco vetorial, não se apresse para introduzir roteamento. Primeiro use EnsembleRetriever para fazer recuperação híbrida BM25 + vetor e veja se o recall atende à demanda. Muitas vezes, o gargalo de um banco vetorial único é apenas uma estratégia de recuperação pouco otimizada. Não há necessidade real de roteamento.
Resumo e recomendações de ação
Depois de tudo isso, dá para resumir os pontos principais.
A essência do roteamento de consultas: escolher dinamicamente o caminho de recuperação conforme as características da consulta, como dependência de contexto, número de saltos de raciocínio, tipo de dado e atualidade. É como um app de navegação escolhendo a melhor rota conforme o trânsito, em vez de seguir cegamente por uma estrada fixa.
Cenários adequados para as três abordagens:
- Roteamento lógico serve para cenários com tipos de fonte bem definidos (<=5) e necessidade de entendimento profundo da intenção.
- Roteamento semântico serve para classificação de intenção (<=20), quando resposta rápida e sensibilidade a custo importam.
- EnsembleRetriever serve para combinar recuperadores do mesmo tipo (BM25 + vetor) e aumentar o recall.
Otimização de custo em produção: Semantic Caching, Tiered Retrieval e Parallel Processing. Com as três estratégias combinadas, o custo pode cair para 10% do original, e a resposta ainda fica mais rápida.
Minhas recomendações de ação
Se você está construindo um sistema RAG, recomendo iterar nesta ordem:
Primeiro passo: diagnosticar o gargalo
Analise os casos de falha do sistema atual e classifique-os em “baixa dependência de contexto” (recuperação vetorial basta) vs “alta dependência de contexto” (precisa de raciocínio multi-hop). Não pule essa etapa, senão é fácil cair em excesso de engenharia.
Segundo passo: escolher a abordagem
Escolha roteamento lógico, roteamento semântico ou EnsembleRetriever conforme número de fontes de dados, número de intenções e orçamento de custo. Não empilhe as três abordagens logo no começo. Primeiro valide o efeito de uma solução única.
Terceiro passo: adicionar otimização de custo
Implemente primeiro Semantic Caching, que é o mais simples e costuma dar o melhor retorno. Depois considere Tiered Retrieval e Parallel Processing. Otimização de custo não acontece de uma vez. É um processo contínuo de iteração.
Se você tem um problema concreto de projeto, deixe nos comentários. Os buracos em que eu já caí talvez ajudem você a desviar deles.
FAQ
Como escolher entre roteamento lógico, roteamento semântico e EnsembleRetriever?
• Roteamento lógico: indicado quando os tipos de fonte de dados são claros (<=5), a intenção exige entendimento mais profundo e o tempo de resposta fica em torno de ~500 ms
• Roteamento semântico: indicado para classificação de intenção (<=20), com resposta rápida (~50 ms) e alta sensibilidade a custo
• EnsembleRetriever: indicado para combinar recuperadores do mesmo tipo (BM25 + vetor) e aumentar a taxa de recall
Em projetos reais, dá para combinar as três camadas: roteamento semântico para classificar intenção, roteamento lógico para casos especiais e EnsembleRetriever para recuperação híbrida.
Como reduzir o custo de chamadas a LLM em um sistema RAG?
• Semantic Caching: armazena embeddings de consultas frequentes; quando a similaridade é > 0.95, retorna a resposta em cache e reduz 30-50% das chamadas ao LLM
• Tiered Retrieval: consultas simples usam modelos baratos (GPT-4o-mini), consultas complexas usam modelos caros (Claude Opus), reduzindo o custo em 80%
• Parallel Processing: chama vários recuperadores em paralelo para compensar a latência; o tempo de resposta cai de 600 ms para 320 ms
Com as três estratégias combinadas, o custo pode cair de US$ 500 para US$ 50 por semana.
Qual é o princípio do algoritmo RRF usado pelo EnsembleRetriever?
• Fórmula: RRF(d) = Σ 1/(k + rank(d)), com k=60 como valor típico
• Vantagem: não depende da pontuação original dos documentos e pode combinar recuperadores de qualquer tipo (BM25, vetores, grafo de conhecimento)
• Resultado: BM25 puro tem 70% de recall, vetor puro chega a 85% e EnsembleRetriever pode chegar a 92%
É adequado para recuperação híbrida Lexical + Semantic, mas não para roteamento entre fontes de dados diferentes.
Quais fontes de dados uma arquitetura de roteamento de consultas precisa? Como avaliar as características da consulta?
• Dependência de contexto: baixa (consulta factual) usa recuperação vetorial; alta (raciocínio multi-hop) usa grafo de conhecimento
• Número de saltos: consulta de um salto usa recuperação direta; múltiplos saltos pedem coordenação por Agent
• Tipo de dado: dados estruturados usam SQL; dados não estruturados usam recuperação vetorial
• Atualidade: informação em tempo real usa busca na Web; conhecimento estático usa base local
Por exemplo, 'vendas da região leste da China' é uma consulta de um salto, estruturada e estática, então SQL é o caminho mais rápido; 'impacto da greve de fornecedor no preço das ações' tem alta dependência de contexto, múltiplos saltos e dados não estruturados, então o grafo de conhecimento se encaixa melhor.
Como definir utterances no roteamento semântico? Como ajustar o limiar?
• Cada intenção deve ter 4-10 consultas de exemplo, cobrindo as formas comuns de expressão
• Poucas utterances (<4) reduzem o recall; muitas (>20) aumentam o custo de cálculo
• Com HuggingFaceEncoder, dá para usar embeddings locais gratuitos, sem custo de API
Ajuste de limiar:
• O limiar padrão de similaridade é 0.85 (85%) e pode ser ajustado conforme o projeto
• Quanto maior o limiar, maior a precisão, mas menor o recall
• Comece em 0.85 e ajuste com base nos dados de teste
19 min de leitura · Publicado em: 5 mai 2026 · Atualizado em: 14 jul 2026

Guia de engenharia RAG
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Otimização de sistemas RAG na prática: como equilibrar precisão da busca e qualidade da geração
A busca do seu sistema RAG não encontra os resultados certos? Este guia detalha processamento de queries, busca híbrida, reordenação, estratégias de divisão e avaliação contínua, com um framework para equilibrar precisão e latência.
Parte 3 de 5
Próximo
Roteamento de consultas RAG: múltiplos bancos vetoriais e recuperação inteligente
Guia prático de roteamento de consultas RAG: como usar EnsembleRetriever e Semantic Router para coordenar múltiplos bancos vetoriais. Da rota lógica à rota semântica e à fusão com RRF, com exemplos completos e comparação de desempenho.
Parte 5 de 5


Comentários
Entre com GitHub para comentar