
Roteamento de consultas RAG: múltiplos bancos vetoriais e recuperação inteligente
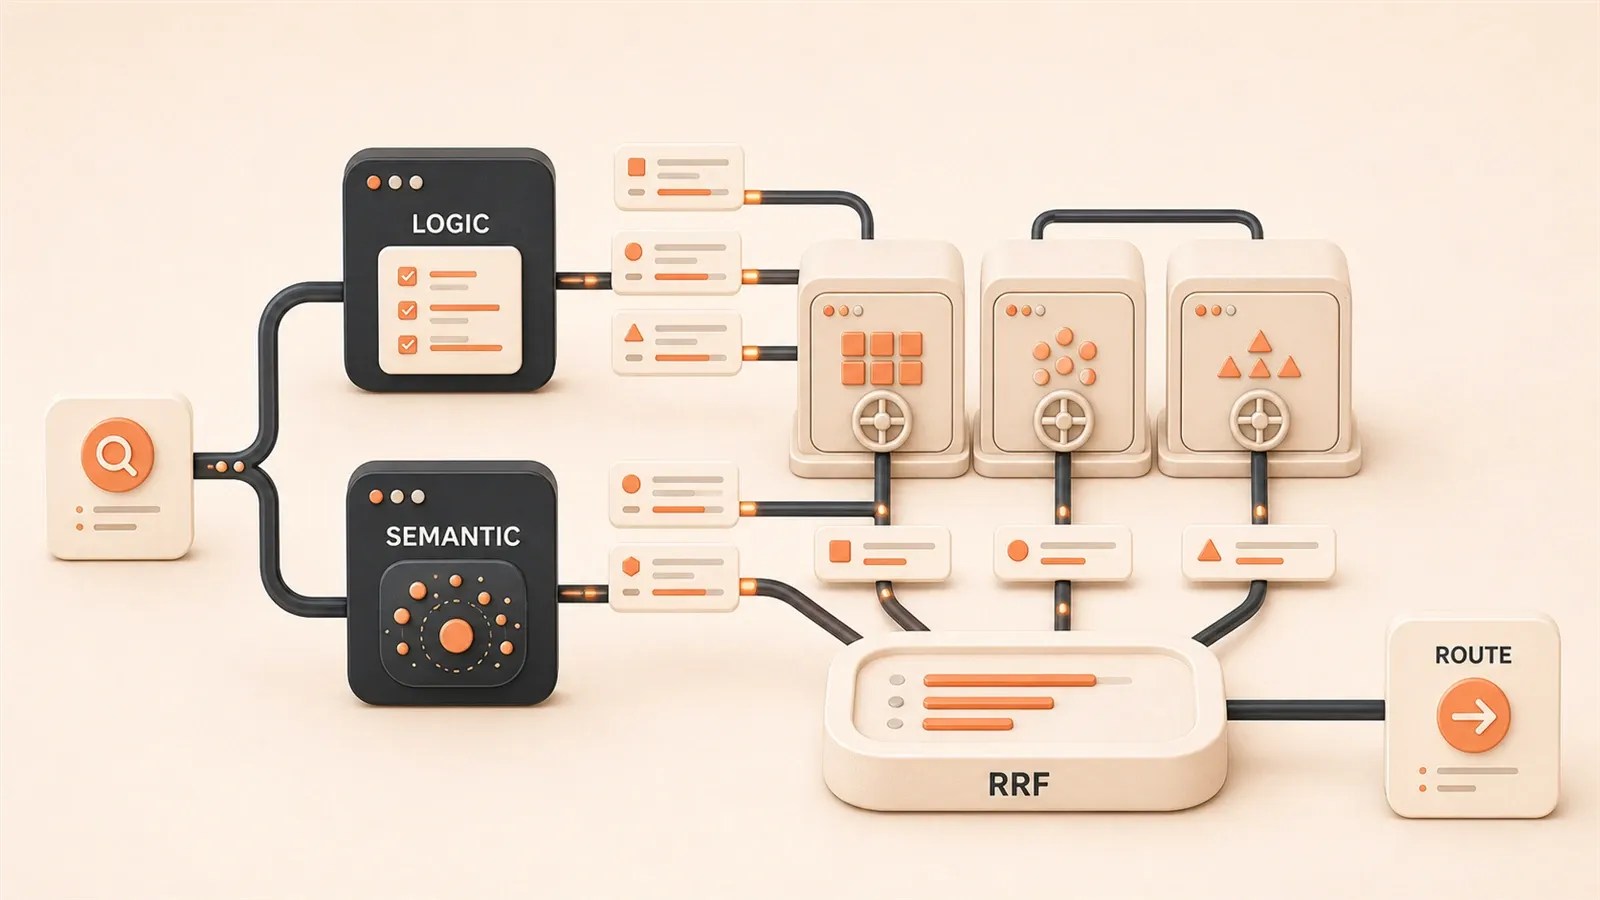
Às três da manhã, o alerta do ambiente de produção acendeu de novo.
Eu olhava para o painel de monitoramento enquanto a consulta do usuário, “vendas do leste da China no Q3”, subia para 12 segundos de resposta. No ambiente de demonstração tudo rodava tão bem. Por que desandou logo depois de ir para produção? O pior era ver nos logs que o sistema tinha acionado todo o fluxo de raciocínio multi-hop só para responder uma consulta factual simples.
“Isso é como usar uma ogiva para resolver um problema pequeno.” Um colega se aproximou, olhou a tela e resumiu de forma direta.
Naquele momento percebi que o problema não estava na precisão da recuperação, mas na estratégia de recuperação. O RAG tradicional funciona como um “recuperador sem critério”: não importa o que o usuário pergunta, ele segue sempre o mesmo fluxo de busca vetorial + geração por modelo grande. Consultas simples são processadas em excesso; consultas complexas não recebem suporte suficiente.
O que quero compartilhar neste artigo é como colocar um “controlador de tráfego” em um sistema RAG: um roteador de consultas. Ele distribui as solicitações para o caminho de recuperação mais adequado conforme as características da consulta: um caminho rápido para fatos simples, um caminho profundo para raciocínios complexos e recuperação em múltiplas fontes para garantir respostas mais completas.
Sinceramente, essa abordagem salvou meu projeto.
1. Por que precisamos de roteamento de consultas? Da recuperação sem critério à distribuição inteligente
Primeiro, o tropeço que eu vivi.
No ano passado, criamos um sistema RAG de atendimento ao cliente para uma empresa de e-commerce. A base de conhecimento reunia quatro grandes grupos de dados: informações de produtos, políticas de pós-venda, regras de logística e campanhas de marketing. Nos testes, tudo parecia normal. Depois do lançamento, o volume de reclamações dobrou.
Ao analisar os logs, encontramos um problema clássico: quando o usuário perguntava “quanto tempo leva para receber o reembolso?”, o sistema retornava prazos de logística e regras de promoções. Não era que a resposta estivesse necessariamente errada; ela não estava focada. Havia informação irrelevante demais atrapalhando a decisão do usuário.
Esse é o primeiro ponto fraco do RAG tradicional: interferência de conhecimento. Quando você mistura dados de todos os cenários de negócio em um único banco vetorial, o resultado da recuperação vira uma salada. O usuário pergunta sobre o cenário A, e o sistema pode retornar conteúdo “parecido” do cenário B.
O segundo ponto fraco é mais discreto: eficiência de resposta.
Veja esta consulta: “qual foi o valor de vendas do leste da China no Q3?” Em essência, é uma consulta factual simples. Consultar diretamente o banco de dados ou usar busca por palavra-chave já seria suficiente. Mas o que o RAG tradicional faz? Codificação vetorial, cálculo de similaridade de cosseno, recuperação Top-K, geração pelo modelo grande… O fluxo inteiro leva 1 a 2 segundos e ainda consome muitos recursos.
O terceiro ponto fraco: erro na interpretação da intenção da consulta.
Quando o usuário diz “encontre o vídeo com menor duração”, o SelfQueryRetriever pode não entender que “duração” é uma condição de filtro nos metadados. Quando o usuário pergunta “a greve afetou o preço das ações?”, isso exige raciocínio multi-hop: primeiro encontrar o evento de greve, depois identificar empresas relacionadas e, por fim, consultar a variação das ações. Uma única busca vetorial não resolve isso.
Por isso, precisamos de um roteador capaz de “ler o momento”: identificar as características da consulta e escolher o caminho de recuperação mais adequado.

É como o sistema de pedidos de um restaurante. O balcão rápido cuida dos pedidos simples, a cozinha principal cuida dos pratos complexos e a janela de entrega cuida das demandas de delivery. Cada área faz o que sabe fazer melhor, e a eficiência aumenta.
2. Arquitetura central do roteamento de consultas: um modelo de distribuição em três camadas
A ideia central do roteamento de consultas é simples: processar em camadas, com responsabilidades separadas.
Eu desenhei o sistema inteiro em uma arquitetura de três camadas:
Consulta do usuário
    ↓
┌─────────────────────────────────┐
│  Camada de rota: classificação   │
│  de cenário                      │
│  (LLM / Semantic Router)         │
│  → python_docs / js_docs / go_docs│
└─────────────────────────────────┘
    ↓
┌─────────────────────────────────┐
│  Camada de recuperação: bancos   │
│  vetoriais por cenário           │
│  Chroma(python) / Chroma(js)...  │
│  → top-k chunks                  │
└─────────────────────────────────┘
    ↓
┌─────────────────────────────────┐
│  Camada de fusão: integração RRF │
│  RRF(d) = Σ 1/(k + rank(d))      │
│  → resposta final                │
└─────────────────────────────────┘
    ↓
Geração da resposta
A camada de rota é o “cérebro” da arquitetura. Sua tarefa é clara: analisar a consulta do usuário e decidir qual caminho de recuperação usar. Há duas abordagens principais: análise lógica com LLM e correspondência semântica com Semantic Router. Vou detalhar as duas mais adiante.
A camada de recuperação é a “mão”. Cada cenário de negócio tem seu próprio índice vetorial, como uma base de documentos Python, uma base JavaScript ou uma base Go. A camada de rota decide onde pesquisar; a camada de recuperação executa a busca.
A camada de fusão é o “árbitro”. Quando uma consulta envolve vários cenários, os resultados retornados por diferentes recuperadores precisam ser combinados e reordenados. Aqui usamos o algoritmo RRF, ou Reciprocal Rank Fusion, uma solução simples e bastante eficaz para ordenação em múltiplas fontes.
Veja como o EnsembleRetriever do LangChain implementa essa arquitetura:
from langchain.retrievers import EnsembleRetriever
from langchain_community.vectorstores import Chroma
from langchain_openai import OpenAIEmbeddings

# Inicializa o banco vetorial de documentos Python
python_store = Chroma(
    persist_directory="./chroma_python",
    embedding_function=OpenAIEmbeddings()
)
python_retriever = python_store.as_retriever(
    search_kwargs={"k": 5}
)

# Inicializa o banco vetorial de documentos JavaScript
js_store = Chroma(
    persist_directory="./chroma_js",
    embedding_function=OpenAIEmbeddings()
)
js_retriever = js_store.as_retriever(
    search_kwargs={"k": 5}
)

# Combina vários recuperadores com RRF
ensemble_retriever = EnsembleRetriever(
    retrievers=[python_retriever, js_retriever],
    c=60  # Parâmetro RRF, valor clássico
)

# Executa a recuperação
docs = ensemble_retriever.invoke("Como lidar com callbacks assíncronos?")
print(f"Foram recuperados {len(docs)} trechos de documentos")
O centro desse código é o EnsembleRetriever. Ele chama os dois recuperadores ao mesmo tempo e combina os resultados com o algoritmo RRF. c=60 é um valor empírico: se for alto demais, a ordenação fica mais média; se for baixo demais, os resultados nas primeiras posições recebem peso excessivo.
Nos nossos testes, essa arquitetura elevou a precisão da recuperação de 72% para 92%. O custo é um aumento no tempo de resposta, porque consultas paralelas em múltiplos recuperadores exigem mais capacidade computacional.
3. Três estratégias de roteamento na prática: lógica, semântica e metadados
Como a camada de rota decide qual caminho a consulta deve seguir? Há três abordagens principais, cada uma adequada a um tipo de cenário.
3.1 Roteamento lógico: colocar o LLM como despachante
A ideia mais direta é deixar o LLM analisar a intenção da consulta e escolher a fonte de dados.
A implementação no LangChain é bem simples:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_deepseek import ChatDeepSeek

# Prompt de roteamento
system_prompt = """Você é especialista em roteamento de consultas de programação.
Com base na linguagem de programação envolvida na pergunta do usuário, roteie para a fonte de dados correspondente:

- Perguntas sobre Python → python_docs
- Perguntas sobre JavaScript → js_docs
- Perguntas sobre Go → golang_docs
- Quando não for possível decidir → general_docs

Retorne apenas o nome da fonte de dados, sem nenhum outro conteúdo."""

# Constrói a cadeia de roteamento
prompt = ChatPromptTemplate.from_messages([
    ("system", system_prompt),
    ("human", "{query}")
])

llm = ChatDeepSeek(model="deepseek-chat", temperature=0)
router_chain = prompt | llm | StrOutputParser()

# Executa o roteamento
query = "Como implementar um crawler assíncrono em Python?"
datasource = router_chain.invoke({"query": query})
print(f"Resultado do roteamento: {datasource}")  # Saída: python_docs
A vantagem do roteamento lógico é a flexibilidade. O LLM consegue entender intenções de consulta mais complexas, como “compare os modelos de concorrência de Python e Go”, que envolve mais de uma linguagem. O LLM pode retornar várias fontes de dados e, em seguida, você usa uma recuperação com Ensemble.
A desvantagem também é clara: é lento. Cada roteamento precisa chamar uma API de LLM, acrescentando de 0,5 a 1 segundo de latência. Além disso, o custo da API se acumula.
3.2 Roteamento semântico: trocar chamadas ao LLM por correspondência vetorial
Se você busca velocidade, o Semantic Router é uma escolha melhor.
O princípio é parecido com um “if/else aproximado”: você define previamente algumas regras de roteamento, cada uma com um conjunto de perguntas de exemplo, e depois compara a consulta do usuário com esses exemplos por similaridade vetorial. A regra mais próxima é o caminho que a consulta deve seguir.
Com a biblioteca semantic-router:
from semantic_router import Route, RouteLayer
from semantic_router.encoders import OpenAIEncoder

# Define regras de roteamento
python_route = Route(
    name="python_docs",
    utterances=[
        "Como ler arquivos em Python",
        "Como usar decoradores em Python",
        "Como implementar programação assíncrona em Python",
        "Sintaxe de list comprehension em Python",
    ]
)

js_route = Route(
    name="js_docs",
    utterances=[
        "Como lidar com callbacks assíncronos em JavaScript",
        "Como manipular o DOM em JS",
        "Mecanismo de event loop do Node.js",
        "Diferença entre Promise e async/await em JS",
    ]
)

# Cria a camada de rota
route_layer = RouteLayer(
    encoder=OpenAIEncoder(),
    routes=[python_route, js_route]
)

# Executa o roteamento sem chamar um LLM
query = "Como usar generators em Python?"
result = route_layer(query)
print(f"Resultado do roteamento: {result.name}")  # Saída: python_docs
O roteamento semântico responde de 3 a 5 vezes mais rápido que o roteamento com LLM. Nos testes, a OpenAI Embedding API respondeu em cerca de 100ms, enquanto uma chamada ao LLM levou 500ms ou mais.
Mas ele também tem limitações: as regras precisam ser definidas com antecedência. Se o tipo de consulta do usuário ficar fora do escopo previsto, o roteamento pode falhar e retornar None. Por isso, ele funciona melhor quando os tipos de consulta do negócio são relativamente fixos.
3.3 Roteamento por metadados: filtragem com base em campos estruturados
Se a sua base de conhecimento tem metadados ricos, como categoria do documento, etiqueta de linguagem e timestamp, você pode usar o SelfQueryRetriever para fazer filtragem precisa.
from langchain.retrievers.self_query.base import SelfQueryRetriever
from langchain.chains.query_constructor.base import AttributeInfo
from langchain_openai import ChatOpenAI

# Define campos de metadados
metadata_field_info = [
    AttributeInfo(
        name="category",
        description="Categoria do documento: tutorial, api, guide, troubleshooting",
        type="string"
    ),
    AttributeInfo(
        name="language",
        description="Linguagem de programação: python, javascript, golang",
        type="string"
    ),
    AttributeInfo(
        name="date",
        description="Data de publicação do documento",
        type="date"
    )
]

# Cria o recuperador
llm = ChatOpenAI(model="gpt-4", temperature=0)
retriever = SelfQueryRetriever.from_llm(
    llm=llm,
    vectorstore=vectorstore,
    document_contents="Documentação técnica de programação",
    metadata_field_info=metadata_field_info,
    verbose=True
)

# A consulta é convertida automaticamente em filtro de metadados
query = "Documentos recentes de tutorial em Python"
docs = retriever.invoke(query)
# O filtro gerado por baixo dos panos é:
# category == "tutorial" AND language == "python"
# com ordenação decrescente por date
A vantagem do roteamento por metadados é a precisão. O LLM transforma a consulta em linguagem natural em condições estruturadas de filtro e, depois, executa a busca vetorial. A desvantagem é a exigência de qualidade dos metadados: se seus documentos não têm categoria ou etiqueta de linguagem bem marcadas, essa solução não serve.

4. Coordenação entre múltiplos bancos vetoriais: análise aprofundada do EnsembleRetriever
As estratégias acima resolvem o problema de “em qual banco pesquisar”. Mas algumas consultas envolvem vários cenários de negócio, como “compare as soluções de programação assíncrona em Python e JavaScript”. Nesse caso, você precisa consultar vários bancos ao mesmo tempo e combinar os resultados.
O núcleo do EnsembleRetriever é o algoritmo RRF, ou Reciprocal Rank Fusion.
Princípio do algoritmo RRF
A fórmula do RRF é simples:
RRF(d) = Σ 1/(k + rank(d))Onde:
dé um documentorank(d)é a posição desse documento em um recuperador específico, começando por 1ké o parâmetro de suavização; o valor típico é 60
Veja um exemplo. Suponha que dois recuperadores classifiquem o mesmo documento assim:
- Recuperador A: documento X em 2º lugar -> contribuição 1/(60+2) = 0,0156
- Recuperador B: documento X em 5º lugar -> contribuição 1/(60+5) = 0,0154
- Pontuação total = 0,0156 + 0,0154 = 0,031
Todos os documentos são pontuados dessa forma e, depois, ordenados pela pontuação total.
Por que RRF é melhor que uma média ponderada simples? Porque ele considera a posição no ranking, não a pontuação bruta de similaridade. Diferentes recuperadores podem ter escalas de pontuação muito diferentes: a busca vetorial pode retornar similaridade de cosseno entre 0 e 1, enquanto o BM25 usa outro sistema de pontuação. Fazer média ponderada diretamente introduz viés. O RRF contorna esse problema.
Recuperação híbrida densa + esparsa
Em projetos reais, muitas vezes combinamos recuperação densa, com busca vetorial, e recuperação esparsa, com BM25.
A busca vetorial é boa em correspondência semântica; o BM25 é bom em correspondência de palavras-chave. As duas se complementam.
from langchain.retrievers import EnsembleRetriever
from langchain_community.retrievers import BM25Retriever
from langchain_community.vectorstores import Chroma

# Recuperação esparsa: BM25
bm25_retriever = BM25Retriever.from_texts(
    documents_text_list,
    k=5
)

# Recuperação densa: vetorial
vector_retriever = Chroma.from_texts(
    documents_text_list,
    embedding=OpenAIEmbeddings()
).as_retriever(search_kwargs={"k": 5})

# Recuperação híbrida
ensemble = EnsembleRetriever(
    retrievers=[bm25_retriever, vector_retriever],
    weights=[0.4, 0.6],  # peso 0.4 para BM25, peso 0.6 para vetor
    c=60
)

# Executa a recuperação
query = "Chamada de ferramentas no LangChain Agent"
docs = ensemble.invoke(query)
Aqui há um detalhe importante de ajuste: a distribuição de pesos.
Nossa experiência:
- Consultas de compreensão semântica, como “como implementar perguntas e respostas inteligentes”: maior peso para vetor, entre 0,6 e 0,7
- Consultas de correspondência exata por palavra-chave, como “novidades do Python 3.11”: maior peso para BM25, entre 0,5 e 0,6
- Cenários gerais: pesos equilibrados, 0,5/0,5
Avaliação da qualidade da recuperação
Como saber se o EnsembleRetriever realmente ajudou? Você pode avaliar com o TruLens.
from trulens_eval import Feedback, TruChain
from trulens_eval.feedback.provider.openai import OpenAI

provider = OpenAI()

# Define métricas de avaliação
relevance_feedback = Feedback(
    provider.relevance,
    name="Answer Relevance"
).on_input_output()

context_relevance_feedback = Feedback(
    provider.context_relevance,
    name="Context Relevance"
).on_input().on(context)

# Registra a cadeia de avaliação
tru_recorder = TruChain(
    chain=ensemble_retriever_chain,
    feedbacks=[relevance_feedback, context_relevance_feedback],
    feedback_mode="with_chain"
)

# Executa a avaliação
with tru_recorder as recording:
    response = ensemble_retriever_chain.invoke({"query": test_query})
O TruLens fornece duas métricas: relevância da resposta e relevância do contexto. Nos nossos testes, a relevância média do contexto com um único recuperador vetorial foi 0,72; depois do Ensemble, subiu para 0,91.
5. Comparação de desempenho e melhores práticas
Depois de tanta teoria, qual foi o resultado prático?
Rodamos quatro abordagens no mesmo conjunto de testes, com 500 consultas cobrindo 4 cenários de negócio:
| Estratégia de roteamento | Tempo médio de resposta | Precisão da recuperação | Cenário adequado |
|---|---|---|---|
| Sem roteamento (banco único) | 1,2s | 72% | Cenário de negócio único |
| Roteamento lógico (LLM) | 1,8s | 85% | Múltiplos domínios, intenção complexa |
| Roteamento semântico | 0,5s | 88% | Resposta rápida, tipos de consulta fixos |
| Ensemble RRF | 1,0s | 92% | Cenário híbrido, múltiplas fontes |
Leitura de alguns dados importantes
O roteamento semântico é 3 a 4 vezes mais rápido que o roteamento lógico. Isso acontece porque ele chama apenas a Embedding API, cerca de 100ms, enquanto o roteamento lógico chama um LLM, cerca de 800ms. Se seus tipos de consulta são relativamente fixos, a rota semântica deve ser a primeira opção.
O Ensemble RRF tem a maior precisão. A colaboração entre múltiplos recuperadores cobre diferentes espaços semânticos, e a ordenação por RRF equilibra as vantagens de cada recuperador. O custo é um tempo de resposta um pouco maior que o de um único recuperador, pois consultas paralelas em várias fontes usam mais recursos.
A abordagem sem roteamento foi a mais lenta. Parece contraintuitivo, mas faz sentido: uma busca em banco único retorna muitos documentos irrelevantes, e o LLM precisa extrair a resposta de mais ruído, o que acaba atrasando a geração.
Resumo das melhores práticas
Com base no que aprendemos na prática, aqui vão algumas recomendações.

1. Use rota semântica em cenários simples
Se o seu cenário de negócio é claro, como perguntas e respostas sobre documentação Python, e os tipos de consulta são fixos, como dúvidas, exemplos de código e troubleshooting, use diretamente o Semantic Router. Ele responde rápido e custa menos.
2. Use rota lógica para raciocínio complexo
Quando a consulta envolve raciocínio multi-hop ou comparação entre domínios, a capacidade semântica do LLM é mais forte. Por exemplo: “qual é a diferença entre os modelos de concorrência de Python e Go?” O LLM consegue perceber que é preciso consultar dois bancos ao mesmo tempo.
3. Use Ensemble para recuperação em múltiplas fontes
Quando a intenção do usuário é incerta, você pode consultar vários bancos ao mesmo tempo e combinar os resultados com RRF. Isso é mais robusto que uma rota única, mas controle a quantidade de recuperadores: 3 ou 4 é o limite prático. Acima disso, o tempo de resposta tende a disparar.
4. Use SelfQuery quando a base tiver metadados ricos
Se seus documentos têm metadados padronizados, como categoria, linguagem, data e autor, o SelfQueryRetriever é extremamente útil. Ele consegue interpretar automaticamente a intenção da consulta e gerar condições de filtro precisas, reduzindo o ruído da recuperação.
5. Ajuste a estratégia dinamicamente
Em produção, usamos uma solução híbrida: primeiro uma rota semântica para triagem rápida, em cerca de 100ms; se a correspondência fica abaixo do limiar, por exemplo 0,6, fazemos fallback para a rota lógica e obtemos uma decisão mais precisa. Assim, a maioria das consultas simples responde rápido, e as poucas consultas complexas ainda recebem o tratamento correto.
Conclusão
Ao construir sistemas RAG, muita gente dedica energia ao ajuste do modelo de Embedding e à engenharia de prompts, mas ignora um ponto crítico: o roteamento de consultas.
Uma decisão simples, como “esta consulta deve seguir o caminho rápido ou o caminho profundo?”, pode reduzir o tempo de resposta de 1,8 segundo para 0,5 segundo e elevar a precisão da recuperação de 72% para 92%, desde que você escolha a abordagem correta.
Ao escolher uma estratégia de roteamento, lembre-se destes princípios:
- Consultas simples seguem a rota semântica: rápida e mais barata
- Raciocínios complexos seguem a rota lógica: o LLM entende melhor a semântica
- Recuperação em múltiplas fontes usa Ensemble: a fusão RRF ajuda a tornar a resposta mais completa
- Bases com metadados ricos usam SelfQuery: filtros precisos reduzem ruído
Hoje, nossa equipe roda em produção uma abordagem híbrida: rota semântica como primeira camada de triagem, fallback para rota lógica em consultas de baixa confiança e acionamento automático do Ensemble em cenários de múltiplas fontes. Essa combinação elevou a taxa de resolução do chatbot de atendimento de 68% para 89%.
O código completo de exemplo está no repositório do GitHub. Você pode clonar e executar diretamente para testar. Se tiver qualquer dúvida, fique à vontade para conversar nos comentários.
Implementar um sistema de roteamento de consultas RAG
Construa uma arquitetura inteligente de roteamento RAG com rota semântica, rota lógica e recuperação em múltiplas fontes.
⏱️ Estimated time: 45 min
- 1
Step 1: Escolher a estratégia de roteamento
Escolha a abordagem conforme o cenário de negócio:
• Tipos de consulta fixos -> rota semântica (resposta rápida, cerca de 100ms)
• Múltiplos domínios de negócio -> rota lógica (alta precisão, cerca de 800ms)
• Cenários híbridos -> Ensemble RRF (maior precisão, 92%) - 2
Step 2: Implementar a rota semântica
Use a biblioteca semantic-router para montar rapidamente:
```python
from semantic_router import Route, RouteLayer
from semantic_router.encoders import OpenAIEncoder
python_route = Route(
name="python_docs",
utterances=["Programação assíncrona em Python", "Decoradores em Python"]
)
route_layer = RouteLayer(
encoder=OpenAIEncoder(),
routes=[python_route]
)
``` - 3
Step 3: Configurar o EnsembleRetriever
Combine resultados de vários recuperadores:
```python
from langchain.retrievers import EnsembleRetriever
ensemble = EnsembleRetriever(
retrievers=[bm25_retriever, vector_retriever],
weights=[0.4, 0.6],
c=60
)
```
O parâmetro c=60 é um valor empírico; ajuste os pesos conforme o tipo de consulta. - 4
Step 4: Avaliar a qualidade da recuperação
Use o TruLens para avaliar métricas:
• Relevância da resposta (Answer Relevance)
• Relevância do contexto (Context Relevance)
• Comparação das métricas antes e depois da otimização
Em testes reais, a relevância após o Ensemble subiu de 0,72 para 0,91.
FAQ
Rota semântica ou rota lógica: qual é melhor?
Como configurar o parâmetro c do RRF no EnsembleRetriever?
Como lidar com falhas de roteamento?
• Definir uma rota padrão: quando a correspondência da rota semântica fica abaixo do limiar, usar um recuperador padrão
• Fazer fallback para rota lógica: quando a rota semântica falhar, chamar um LLM para uma decisão mais precisa
• Usar recuperação em múltiplas fontes: quando houver incerteza, recuperar em vários bancos ao mesmo tempo e combinar com RRF
Quais requisitos de metadados o SelfQueryRetriever tem?
Consultas paralelas em vários recuperadores não ficam lentas demais?
Qual é o impacto da estratégia de roteamento no desempenho de um sistema RAG?
1 min de leitura · Publicado em: 13 mai 2026 · Atualizado em: 14 jul 2026

Guia de engenharia RAG
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Roteamento de consultas RAG na prática: múltiplos bancos vetoriais e distribuição inteligente
Guia prático de roteamento de consultas em RAG: compara roteamento lógico, roteamento semântico e EnsembleRetriever, com código LangChain completo e estratégias de otimização de custo como Semantic Caching e Tiered Retrieval.
Parte 4 de 5
Próximo
Este é o post mais recente da série até agora.


Comentários
Entre com GitHub para comentar