
LangGraph multi-agent na prática: modo Supervisor e distribuição de tarefas
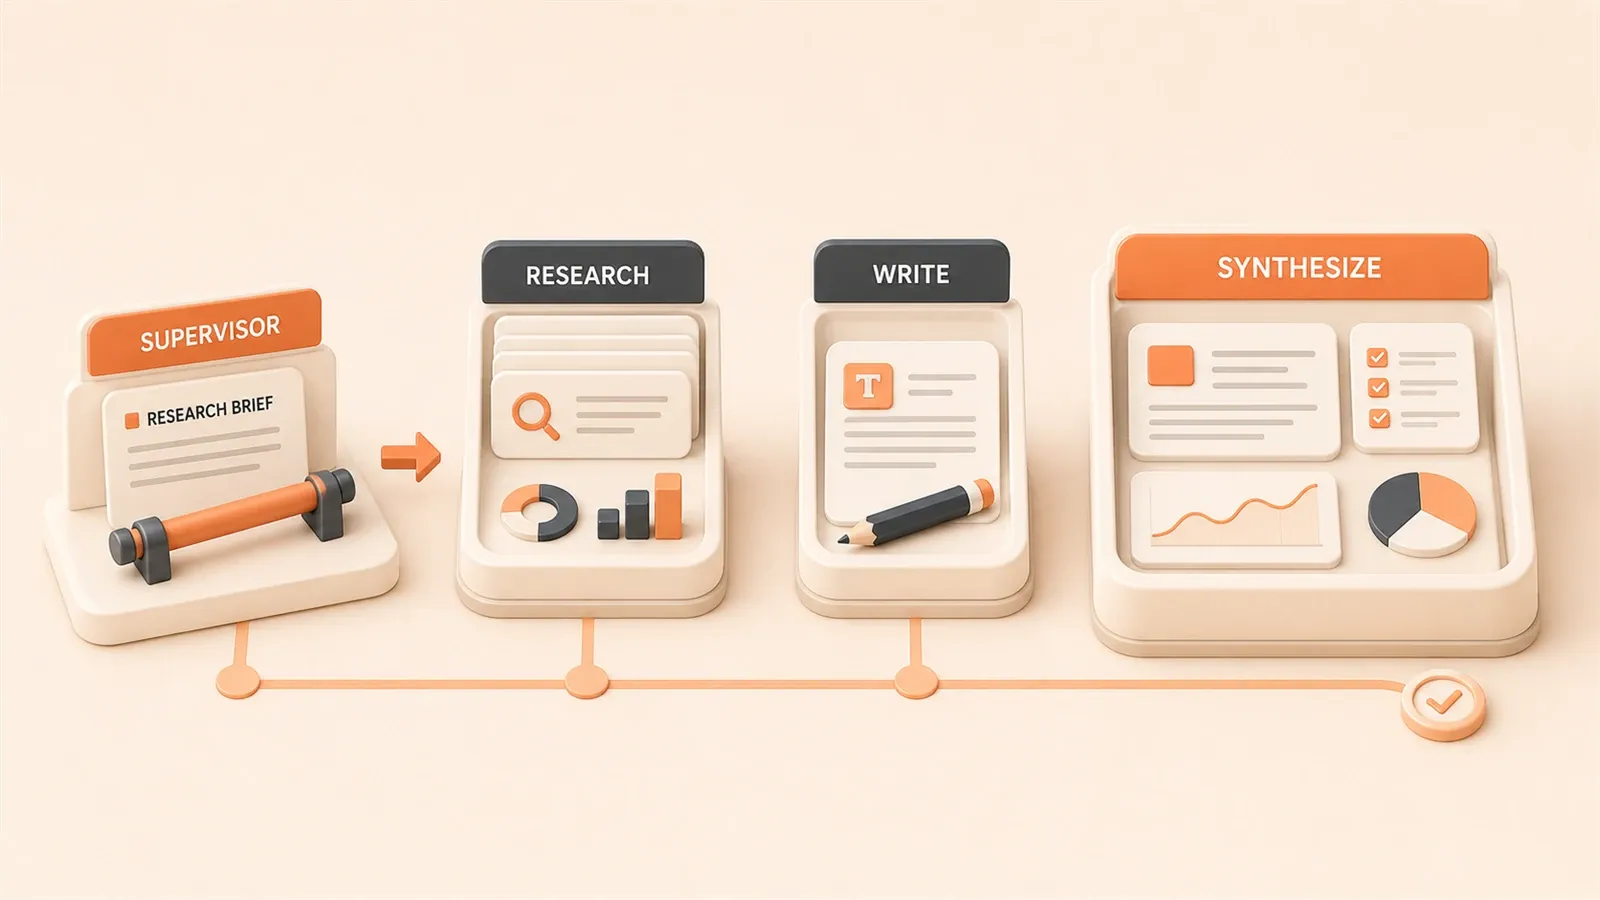
No mês passado, ajudei uma equipe a refatorar um sistema de Agent que tinha um único Agent pendurado em 12 ferramentas: busca, execução de código, geração de documentos, envio de e-mails… O resultado? O LLM vivia travando na escolha entre ferramentas e às vezes usava o executor de código em cenários que pediam busca. Na hora de depurar, os logs não deixavam claro qual chamada tinha dado errado. O sistema inteiro parecia uma caixa-preta.
Depois, quebramos a arquitetura no modelo Supervisor + Workers: um Agent central fazia o roteamento, e três Agents especialistas cuidavam de partes diferentes. A taxa de erro na escolha de ferramentas caiu para um terço do valor anterior, e a depuração ficou muito mais clara, com trace em cada camada.
Resumindo: quando seu Agent carrega mais de 10 ferramentas, a arquitetura de Agent único começa a dar sinais de problema. Este artigo vai do princípio arquitetural do modo Supervisor ao uso completo da API create_supervisor, fechando com um caso prático de uma equipe Research + Writing. O código roda direto, e o link do repositório no GitHub está no final.
1. Por que precisamos de sistemas multi-agent?
As três falhas fatais de um único Agent
As armadilhas em que eu caí talvez sejam as mesmas em que você está caindo agora. Um sistema com um único Agent parece simples, mas na prática tem três problemas sérios.
Primeira: ferramentas demais, escolha difícil.
Não é exagero. Quando um único Agent passa de 10 ferramentas, a taxa de erro na escolha da ferramenta sobe de forma visível. Você pode pensar: os modelos não estão ficando cada vez mais inteligentes? Estão, mas o problema é outro. As descrições das ferramentas ficam empilhadas no prompt, e o modelo precisa escolher a ferramenta certa entre mais de 10 opções. Essa carga cognitiva não é pequena.
No sistema que mencionei, a ferramenta de busca e a ferramenta de execução de código tinham descrições parcialmente sobrepostas, porque ambas pareciam conseguir “procurar informações”. O modelo ficava pulando entre as duas e desperdiçava várias rodadas de conversa.
Segunda: acúmulo de contexto, janela explodindo.
Todo o histórico das subtarefas fica comprimido na mesma context window. Depois de algumas rodadas, a janela é soterrada por chamadas de ferramentas, e as instruções principais ficam diluídas. O modelo começa a “esquecer coisas” e às vezes perde até o pedido inicial do usuário.
Passei por isso de perto. Em uma depuração de um Agent que rodou por 20 etapas, o contexto estava cheio de registros de chamadas de função. No fim, a resposta do modelo já não tinha quase nada a ver com a necessidade original do usuário.
Terceira: difícil de depurar.
Quando algo quebra, você não sabe de qual ferramenta veio o problema. Um Agent único vira uma caixa-preta. Os logs são uma lista corrida de tool calls, e localizar a causa exige ler linha por linha.
O modo Supervisor resolve esses pontos ao usar um “Agent central” para coordenar vários “Agents especialistas”, com responsabilidades separadas e cada um fazendo sua parte.

A ideia central do modo Supervisor
A ideia é simples: dividir o trabalho.
Imagine uma equipe. Há uma pessoa gerenciando o projeto, alguém focado em pesquisa, outra pessoa cuidando da implementação e uma especialista em documentação escrevendo o relatório. Cada um tem sua especialidade. A pessoa que gerencia o projeto não precisa saber tudo; precisa saber “para quem essa tarefa deve ir”.
O modo Supervisor segue essa lógica:
- Supervisor (Agent central): não faz o trabalho específico; cuida de roteamento, coordenação e consolidação dos resultados.
- Worker Agents (Agents especialistas): cada um foca em um domínio, com um conjunto enxuto de ferramentas e responsabilidades claras.
O ganho é direto.
O número de ferramentas fica distribuído entre os Workers. Cada Agent só escolhe dentro do seu próprio conjunto de ferramentas. O contexto também fica distribuído: cada Agent mantém apenas a parte da conversa que importa para sua função. Na depuração, dá para fazer trace camada por camada: o Supervisor enviou a tarefa para qual Worker, e o Worker executou quais ações. Fica visível de cara.
2. Como funciona a arquitetura do modo Supervisor
Veja primeiro um diagrama da arquitetura:
                    ┌─────────────────┐
                    │ Pedido do       │
                    │ usuário         │
                    └────────┬────────┘
                             │
                             ▼
                    ┌─────────────────┐
                    │   Supervisor    │
                    │ (Agent central) │
                    │                 │
                    │ Roteamento +    │
                    │ coordenação +   │
                    │ consolidação    │
                    └────────┬────────┘
                             │
              ┌──────────────┼──────────────┐
              │              │              │
              ▼              ▼              ▼
       ┌──────────┐   ┌──────────┐   ┌──────────┐
       │ Research │   │   Math   │   │ Writing  │
       │  Agent   │   │  Agent   │   │  Agent   │
       │          │   │          │   │          │
       │ Ferram.  │   │ Ferram.  │   │ Ferram.  │
       │ de busca │   │ de calc. │   │ de ger.  │
       └────┬─────┘   └────┬─────┘   └────┬─────┘
            │              │              │
            │ Resultado    │ Resultado    │ Resultado
            │ do Worker    │ do Worker    │ do Worker
            │              │              │
            └──────────────┴──────────────┘
                           │
                           ▼
                    ┌─────────────────┐
                    │   Supervisor    │
                    │ Consolida       │
                    │ resultados      │
                    └────────┬────────┘
                             │
                             ▼
                    ┌─────────────────┐
                    │ Resposta final  │
                    └─────────────────┘
Responsabilidades dos componentes principais
O Supervisor faz três coisas:
- Roteamento: analisa o pedido do usuário e decide qual Worker deve receber a tarefa.
- Coordenação: gerencia o fluxo de tarefas entre os Workers.
- Consolidação: reúne os resultados dos Workers e gera a resposta final.
Cada Worker Agent faz sua parte:
Cada Worker tem apenas seu conjunto próprio de ferramentas. Um Research Agent, por exemplo, pode ter só ferramentas de busca e captura de páginas. Um Math Agent pode ter apenas calculadoras de soma, subtração, multiplicação e divisão. Com menos ferramentas, a precisão da escolha sobe naturalmente.
Mecanismo de troca de mensagens
Aqui existe um ponto importante: o estado global do grafo, ou Global Graph State.
Todos os Agents compartilham o mesmo objeto de estado. Quando um Worker termina uma tarefa, ele adiciona o resultado ao campo messages do estado. O Supervisor vê a nova mensagem e decide quem deve agir em seguida.
É um mecanismo append-only: as mensagens só aumentam, não são removidas. Isso preserva a integridade do histórico da conversa.
Fan-out / Fan-in
Tarefas complexas podem exigir vários Workers rodando em paralelo. Se o usuário pergunta “compare os dados de mercado dos produtos A e B”, o Supervisor pode disparar duas tarefas de pesquisa ao mesmo tempo: uma para A e outra para B. Isso é fan-out.
Quando os dois Workers retornam, o Supervisor junta os resultados. Isso é fan-in.
O LangGraph suporta esse modo paralelo, mas não vamos aprofundar aqui. Na seção de técnicas avançadas, voltamos a ele.
"O LangGraph oferece uma forma de criar sistemas multi-agent em que cada Agent tem seu próprio conjunto de ferramentas e escopo de responsabilidade, com coordenação e distribuição de tarefas feitas por um Supervisor."
3. API create_supervisor em detalhes
Terminada a teoria, vamos ao código.
Instalação e imports
pip install langgraph-supervisor langchain-openaifrom langchain_openai import ChatOpenAI
from langgraph_supervisor import create_supervisor
from langgraph.prebuilt import create_react_agentDefinindo ferramentas
Primeiro, prepare as ferramentas de cada Worker:
from typing import Annotated

# Ferramenta de cálculo matemático
def add(
    a: Annotated[float, "primeiro número"],
    b: Annotated[float, "segundo número"]
) -> float:
    """Soma dois números."""
    return a + b

def multiply(
    a: Annotated[float, "primeiro número"],
    b: Annotated[float, "segundo número"]
) -> float:
    """Multiplica dois números."""
    return a * b

# Ferramenta de busca simulada
def web_search(query: str) -> str:
    """Busca informações na web."""
    # Em um projeto real, você pode integrar Tavily, Serper etc.
    if "population" in query.lower():
        return "A população de Pequim é de cerca de 21,89 milhões (dados de 2023)"
    elif "weather" in query.lower():
        return "Hoje em Pequim o tempo está ensolarado, com temperatura entre 15 e 25°C"
    else:
        return f"Resultado da busca: {query}"
Aqui usamos a dica de tipo Annotated do Python para deixar mais claro para o modelo o significado de cada parâmetro. A docstring das funções também é importante: o modelo usa esse texto para entender o que cada ferramenta faz.

Criando os Worker Agents
model = ChatOpenAI(model="gpt-4o")

# Agent especialista em matemática
math_agent = create_react_agent(
    model=model,
    tools=[add, multiply],
    name="math_expert",
    prompt="Você é especialista em matemática e foca em cálculos numéricos. Quando o usuário precisar de operações matemáticas, use suas ferramentas para concluir a tarefa."
)

# Agent especialista em pesquisa
research_agent = create_react_agent(
    model=model,
    tools=[web_search],
    name="research_expert",
    prompt="Você é um pesquisador experiente, bom em buscar e organizar informações. Quando o usuário precisar consultar dados, use a ferramenta de busca para obter a resposta."
)
Alguns pontos merecem atenção:
- O campo name é importante: o Supervisor usa esse nome para identificar e chamar o Worker.
- O prompt define o papel: ele diz qual é a especialidade do Agent.
- Conjunto de ferramentas enxuto: cada Agent tem apenas as ferramentas necessárias, nem mais nem menos.
Criando o Supervisor
# Cria o sistema Supervisor
supervisor = create_supervisor(
    agents=[math_agent, research_agent],
    model=model,
    prompt="""Você é o líder da equipe e coordena Agents especialistas.

Com base no pedido do usuário, decida para quem a tarefa deve ir:
- Precisa de cálculo matemático → math_expert
- Precisa buscar informações → research_expert
- Tarefa concluída → responda diretamente ao usuário

Se vários especialistas precisarem colaborar, chame-os em uma ordem razoável."""
)

# Compila em uma aplicação executável
app = supervisor.compile()
create_supervisor recebe três parâmetros principais:
agents: lista de Worker Agents.model: o modelo usado pelo próprio Supervisor.prompt: instruções sobre como o Supervisor deve distribuir tarefas.
Exemplo de execução
from langchain_core.messages import HumanMessage

# Teste com uma pergunta matemática
result = app.invoke({
    "messages": [HumanMessage(content="Calcule quanto é 123 mais 456")]
})
print(result["messages"][-1].content)
# Saída: 123 mais 456 é igual a 579

# Teste com uma pergunta de busca
result = app.invoke({
    "messages": [HumanMessage(content="Qual é a população de Pequim?")]
})
print(result["messages"][-1].content)
# Saída: Segundo o resultado da busca, a população de Pequim é de cerca de 21,89 milhões
O Supervisor identifica automaticamente o tipo de pedido e roteia para o Worker correto. Para o usuário, tudo é transparente; ele nem precisa saber que vários Agents estão trabalhando nos bastidores.
4. Caso prático: criando uma equipe Research + Writing
O exemplo acima é o mais básico. Agora vamos montar um sistema mais completo: uma equipe capaz de pesquisar automaticamente e gerar um artigo técnico.
Cenário
O usuário informa um tema técnico, e o sistema conclui automaticamente:
- Pesquisa de materiais relacionados.
- Geração do outline do artigo.
- Escrita do conteúdo completo.
- Revisão e checagem.
Isso exige a colaboração de três Agents especializados.
Definindo o conjunto completo de ferramentas
from typing import TypedDict, List
import json

# Ferramenta de busca simulada
def tech_search(query: str) -> str:
    """Busca materiais técnicos e documentação."""
    # Em um projeto real, integre Tavily ou Serper
    database = {
        "langgraph": "LangGraph é um framework de Agent lançado pela LangChain, com suporte a gerenciamento de estado e estruturas de grafo com ciclos.",
        "supervisor": "O modo Supervisor é uma arquitetura central em sistemas Multi-Agent, na qual um Agent central coordena vários Agents especialistas.",
        "multi-agent": "Sistemas multi-agent usam distribuição de tarefas e colaboração para resolver problemas de excesso de ferramentas e explosão de contexto em um único Agent."
    }

    results = []
    for key, value in database.items():
        if key in query.lower():
            results.append(value)

    return json.dumps(results) if results else "Nenhum material relacionado encontrado; considere ampliar o escopo da busca"

# Ferramenta de geração de outline
def generate_outline(topic: str) -> str:
    """Gera o outline de um artigo a partir de um tema."""
    return json.dumps({
        "title": f"Guia completo de {topic}",
        "sections": [
            "1. Visão geral e contexto",
            "2. Conceitos principais",
            "3. Caso prático",
            "4. Boas práticas",
            "5. Conclusão"
        ]
    }, ensure_ascii=False)

# Ferramenta de geração de conteúdo
def write_section(section_title: str, context: str) -> str:
    """Gera o conteúdo de uma seção com base no título e no contexto."""
    # Em um projeto real, aqui você poderia chamar um modelo de linguagem
    return f"## {section_title}\n\nCom base nos materiais pesquisados, os principais pontos de {section_title} são...\n\n"

# Ferramenta de revisão
def review_content(content: str) -> str:
    """Revisa a precisão e a legibilidade do conteúdo."""
    issues = []
    if len(content) < 100:
        issues.append("Conteúdo curto demais; recomenda-se expandir")
    if "TODO" in content:
        issues.append("Há marcadores TODO pendentes")

    return json.dumps({
        "passed": len(issues) == 0,
        "issues": issues,
        "suggestion": "A qualidade do conteúdo está boa e ele pode ser publicado" if not issues else "Ajuste o conteúdo conforme os problemas antes de reenviar"
    }, ensure_ascii=False)
Criando os Worker Agents
# Agent pesquisador
researcher = create_react_agent(
    model=model,
    tools=[tech_search],
    name="researcher",
    prompt="""Você é um pesquisador técnico experiente, bom em pesquisar e entender tecnologias novas rapidamente.

Responsabilidades:
1. Receber o tema de pesquisa
2. Usar a ferramenta de busca para encontrar materiais relacionados
3. Organizar os resultados em um relatório estruturado

Atenção: faça apenas a pesquisa, não escreva o artigo. Entregue os resultados ao writer."""
)

# Agent escritor
writer = create_react_agent(
    model=model,
    tools=[generate_outline, write_section],
    name="writer",
    prompt="""Você é especialista em escrita técnica e sabe transformar conceitos complexos em artigos claros.

Responsabilidades:
1. Receber o relatório de pesquisa
2. Gerar o outline do artigo
3. Escrever o conteúdo de cada seção

Atenção: depois de concluir o rascunho, envie para o reviewer revisar."""
)

# Agent revisor
reviewer = create_react_agent(
    model=model,
    tools=[review_content],
    name="reviewer",
    prompt="""Você é um revisor rigoroso e garante a qualidade e a precisão do artigo.

Responsabilidades:
1. Verificar a completude e a precisão do conteúdo
2. Avaliar a legibilidade e a lógica do artigo
3. Sugerir ajustes ou confirmar que pode publicar

Atenção: se encontrar problemas, devolva ao writer para correção."""
)
Construindo a lógica do Supervisor
# Usa StateGraph para criar um Supervisor personalizado
from langgraph.graph import StateGraph, END
from typing import Annotated, Sequence
from langchain_core.messages import BaseMessage
from langgraph.graph.message import add_messages

# Define o estado
class AgentState(TypedDict):
    messages: Annotated[Sequence[BaseMessage], add_messages]
    next_agent: str

# Lógica de decisão do Supervisor
def supervisor_node(state: AgentState) -> dict:
    """Decide qual Agent deve executar a próxima etapa com base no progresso atual."""
    messages = state["messages"]

    # Chama o modelo para tomar a decisão
    decision = model.invoke([
        {"role": "system", "content": """Você é o líder da equipe. Com base no histórico da conversa, decida a próxima etapa:

- Se ainda não houver materiais de pesquisa → retorne 'researcher'
- Se houver materiais de pesquisa, mas ainda não houver artigo → retorne 'writer'
- Se houver artigo, mas ainda não houver revisão → retorne 'reviewer'
- Se a revisão tiver sido aprovada → retorne 'FINISH'

Retorne apenas o nome do Agent, sem nenhum outro conteúdo."""},
        *messages
    ])

    next_agent = decision.content.strip()

    # Mapeia para o nome correto do Agent
    agent_map = {
        "researcher": "researcher",
        "writer": "writer",
        "reviewer": "reviewer",
        "FINISH": END
    }

    return {"next_agent": agent_map.get(next_agent, "researcher")}

# Constrói o grafo
workflow = StateGraph(AgentState)

# Adiciona os nós
workflow.add_node("supervisor", supervisor_node)
workflow.add_node("researcher", researcher)
workflow.add_node("writer", writer)
workflow.add_node("reviewer", reviewer)

# Adiciona arestas condicionais com a lógica de roteamento do Supervisor
workflow.add_conditional_edges(
    "supervisor",
    lambda state: state["next_agent"],
    {
        "researcher": "researcher",
        "writer": "writer",
        "reviewer": "reviewer",
        END: END
    }
)

# Depois que cada Agent conclui, todos voltam ao Supervisor
for agent in ["researcher", "writer", "reviewer"]:
    workflow.add_edge(agent, "supervisor")

# Define o ponto de entrada
workflow.set_entry_point("supervisor")

# Compila
app = workflow.compile()
Essa arquitetura tem um mecanismo de loop: depois que qualquer Worker conclui sua tarefa, o fluxo volta ao Supervisor. O Supervisor decide se envia a próxima etapa para outro Worker ou encerra.
Fluxo de execução
result = app.invoke({
    "messages": [HumanMessage(content="Escreva um artigo técnico sobre o modo Supervisor do LangGraph")]
})

# Visualiza o resultado final
print(result["messages"][-1].content)

# Visualiza o trace de execução
for i, msg in enumerate(result["messages"]):
    print(f"{i+1}. {msg.__class__.__name__}: {msg.content[:100]}...")
O fluxo fica mais ou menos assim:
Pedido do usuário → Supervisor analisa → envia para Researcher →
Researcher pesquisa → retorna ao Supervisor → envia para Writer →
Writer escreve → retorna ao Supervisor → envia para Reviewer →
Reviewer revisa → retorna ao Supervisor → confirma conclusão → gera o resultado
Cada camada pode ser rastreada. A depuração fica bem mais clara.
5. Técnicas avançadas
Otimização de encaminhamento de mensagens: create_forward_message_tool
Talvez você já tenha percebido um problema: depois que um Worker conclui a tarefa, a resposta dele é recebida pelo Supervisor e pode acabar sendo resumida de novo. Isso desperdiça tokens e pode diluir a informação.
O LangGraph oferece create_forward_message_tool para resolver isso:
from langgraph_supervisor.handoff import create_forward_message_tool

# Cria a ferramenta de encaminhamento
forward_tool = create_forward_message_tool("supervisor")

# Passa a ferramenta ao criar o Supervisor
supervisor = create_supervisor(
    agents=[researcher, writer, reviewer],
    model=model,
    tools=[forward_tool]  # Adiciona a ferramenta de encaminhamento
)
Essa ferramenta permite que o Supervisor encaminhe diretamente a resposta do Worker ao usuário, sem precisar resumir de novo. Economiza tokens e melhora a eficiência.
Arquitetura de equipes hierárquicas
Se o projeto for mais complexo, você também pode criar Supervisors em múltiplas camadas:
                    ┌──────────────┐
                    │ Top Supervisor│
                    └──────┬───────┘
                           │
           ┌───────────────┼───────────────┐
           │               │               │
           ▼               ▼               ▼
    ┌────────────┐  ┌────────────┐  ┌────────────┐
    │Research    │  │ Writing    │  │ QA         │
    │Team        │  │ Team       │  │ Team       │
    │Supervisor  │  │ Supervisor │  │ Supervisor │
    └─────┬──────┘  └─────┬──────┘  └─────┬──────┘
          │               │               │
     ┌────┼────┐    ┌────┼────┐    ┌────┼────┐
     │    │    │    │    │    │    │    │    │
   Web  Doc  API   Out  Cont Rev   Test Code Audit
 Search Scrp Parse line ent  iew
Cada subequipe tem seu próprio Supervisor, e acima delas existe um Supervisor geral coordenando tudo. Essa arquitetura é adequada para projetos grandes, com responsabilidades mais bem segmentadas.
Tratamento de erros
E se um Worker falhar?
from langgraph.pregel import RetryPolicy

# Configura a política de retentativas
retry_policy = RetryPolicy(
    max_attempts=3,
    initial_interval=1.0,
    backoff_factor=2.0
)

app = workflow.compile(retry_policy=retry_policy)
Você também pode incluir lógica de tratamento de erro no prompt do Supervisor:

Se algum Agent falhar:
1. Registre a mensagem de erro
2. Tente chamar um Agent alternativo
3. Se falhar várias vezes, informe o problema ao usuário
Persistência de estado
Conversas de várias rodadas precisam salvar estado. O LangGraph oferece o mecanismo de Checkpointer:
from langgraph.checkpoint.memory import MemorySaver

# Usa armazenamento em memória no ambiente de desenvolvimento
memory = MemorySaver()
app = workflow.compile(checkpointer=memory)

# Informa thread_id na execução
config = {"configurable": {"thread_id": "user-123"}}
result = app.invoke({"messages": [HumanMessage(content="...")]}, config=config)

# Conversas posteriores preservam o contexto
result2 = app.invoke({"messages": [HumanMessage(content="Continue a tarefa anterior")]}, config=config)
Em produção, você pode usar Redis ou PostgreSQL como Checkpointer.
"Hierarchical Agent Teams mostra como construir uma arquitetura Supervisor em múltiplas camadas para viabilizar sistemas multi-agent mais complexos."
6. Recomendações para produção
Monitoramento e depuração
LangSmith é a plataforma oficial de monitoramento da LangChain e ajuda a rastrear os detalhes de cada etapa:
import os

os.environ["LANGSMITH_API_KEY"] = "your-api-key"
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_PROJECT"] = "multi-agent-project"
Depois de configurar, cada execução deixa um trace completo no LangSmith, incluindo:
- Entradas e saídas de cada Agent.
- Parâmetros e valores retornados pelas chamadas de ferramentas.
- Estatísticas de consumo de tokens.
- Análise do tempo de execução.
Isso ajuda muito na depuração. Você não precisa mais ficar lendo logs linha por linha.
Controle de custo de tokens
O modo Supervisor é útil, mas múltiplos Agents aumentam o consumo de tokens. Algumas recomendações:
- Enxugue o prompt do Supervisor: inclua apenas a lógica de roteamento necessária.
- Use forward_message_tool: evite resumir a mesma informação de novo.
- Distribua as ferramentas com cuidado: cada Worker deve ter apenas as ferramentas necessárias.
- Controle o número de rodadas: defina um limite máximo de etapas.
# Define o número máximo de etapas
app = workflow.compile(
    checkpointer=memory,
    interrupt_after=20  # Executa no máximo 20 etapas
)
Integração com AWS Bedrock
Se seu projeto roda na AWS, você pode usar modelos do Bedrock:
from langchain_aws import ChatBedrock

model = ChatBedrock(
    model_id="anthropic.claude-3-sonnet-20240229-v1:0",
    region_name="us-east-1"
)

# O restante do código não muda; basta substituir model
supervisor = create_supervisor(
    agents=[math_agent, research_agent],
    model=model
)
Resumo de boas práticas
Depois de tudo isso, algumas lições práticas:
- Comece pequeno: inicie com 2 ou 3 Agents e expanda aos poucos.
- Deixe responsabilidades claras: o domínio de cada Worker precisa ser explícito, sem sobreposição.
- Monitore com LangSmith: integre ainda na fase de desenvolvimento para facilitar a depuração.
- Fique atento ao custo de tokens: multi-agent amplifica o consumo e precisa de otimização.
- Use bem forward_message_tool: ele economiza bastante token.
- Consulte o repositório oficial: langgraph-supervisor-py tem exemplos completos.
Conclusão
O modo Supervisor é, no fundo, uma forma de dividir o trabalho: quebrar uma tarefa grande em partes menores e deixar cada Agent focado no que sabe fazer.
Saímos das três falhas fatais de um único Agent, dificuldade de escolher ferramentas, explosão de contexto e depuração quase impossível, e chegamos a uma solução mais organizada com Supervisor. A API create_supervisor não é complicada. O ponto principal é entender a ideia arquitetural por trás dela.
Minha sugestão é começar por um projeto pequeno. Monte primeiro um sistema com dois Agents, como um de busca e outro de resumo. Depois que isso estiver funcionando, expanda aos poucos. Configure o monitoramento do LangSmith desde o início; na hora de depurar, isso faz diferença.
O exemplo completo está no repositório do GitHub: langgraph-supervisor-py. O tutorial oficial também vale a leitura: Hierarchical Agent Teams.
Se tiver dúvidas, deixe um comentário. Eu respondo quando vir.
Referências
- LangGraph Supervisor Reference
- Hierarchical Agent Teams Tutorial
- LangGraph Multi-Agent Workflows Blog
- GitHub - langgraph-supervisor-py
- Build Multi-Agent Systems with AWS Bedrock
FAQ
Qual é a diferença entre o modo Supervisor e um Multi-Agent comum?
Quando devo usar o modo Supervisor?
O modo Supervisor aumenta o consumo de tokens?
Como depurar um sistema multi-agent?
Qual é a relação entre create_supervisor e StateGraph?
Um Worker Agent pode ser outro Supervisor?
1 min de leitura · Publicado em: 12 mai 2026 · Atualizado em: 14 jul 2026

Guia de engenharia de AI Agents
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Gerenciamento de estado no LangGraph na prática: checkpoint, thread state e recuperação de falhas
Guia prático de gerenciamento de estado no LangGraph em 2026: entenda checkpoint, thread state, recuperação de falhas, comparação com AutoGen e monitoramento para projetar uma arquitetura de agentes resiliente e pronta para produção.
Parte 9 de 22
Próximo
LangGraph vs AutoGen em rastreamento de estado: checkpoints, recuperação de timeout e decisão técnica
Comparativo aprofundado de rastreamento de estado entre LangGraph e AutoGen: 12 dimensões para avaliar Checkpoint, recuperação de timeout e suporte distribuído, com caso real, árvore de decisão e código executável para escolher o framework de Agent mais adequado.
Parte 11 de 22


Comentários
Entre com GitHub para comentar