
Otimização de desempenho em React Server Components: dados e cache na prática
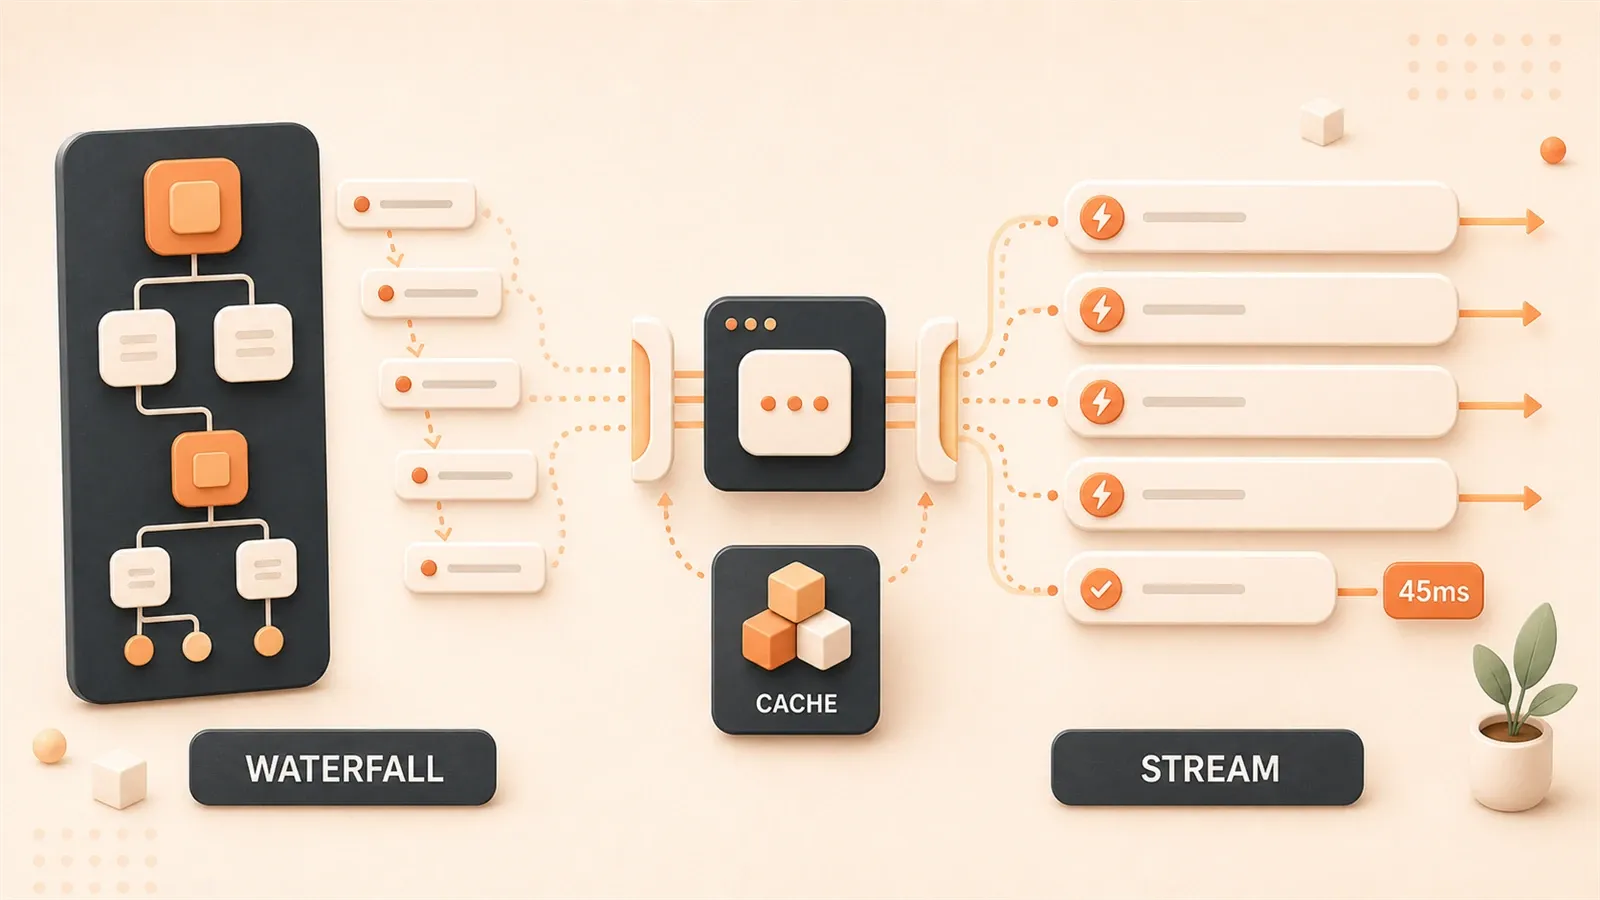
Se a sua página com RSC ainda tem TTFB na faixa de 300 a 500ms, talvez você esteja usando só 30% do potencial de desempenho dela. Dados de testes mostram que uma arquitetura em streaming correta consegue baixar o TTFB para 45ms. Não é mágica; é o resultado de ativar de verdade a renderização em streaming do React Server Components.
No ano passado, ajudei um time de e-commerce a otimizar uma página de detalhes de produto e caí nessa mesma armadilha. Eles usavam Next.js App Router, mas o TTFB ficava estável perto de 380ms. Ao investigar, ficou claro: componentes aninhados buscavam seus próprios dados e formavam um waterfall clássico. As informações do produto esperavam os comentários, os comentários esperavam os dados de preço, e o preço ainda esperava a validação de estoque. Resultado: 9 segundos de tela em branco.
Este texto é sobre como resolver esse problema. Vou comparar 4 formas de lidar com waterfall, explicar os cenários de uso de 5 APIs de cache e deixar um modelo de configuração que você pode adaptar direto. Entre um TTFB de 450ms e um de 45ms, a diferença pode ser apenas a posição de alguns limites de Suspense.
Problema de waterfall: o maior inimigo do desempenho em RSC
Comece por um cenário real. Você abre uma página de produto em um e-commerce: primeiro aparece o nome do produto, depois espera 3 segundos pelo preço e mais 5 segundos até a área de avaliações aparecer. Experiência do usuário? Um desastre.
Esse é o problema de waterfall. Componentes aninhados buscam dados por conta própria, em sequência, não em paralelo. Em React Server Components, a busca de dados é bloqueante por padrão: qualquer requisição com await impede a renderização, a menos que você a envolva com Suspense.
Duas formas de waterfall
A primeira: waterfall dentro do servidor. Na mesma página, o componente pai busca dados antes de renderizar o filho; o filho então busca seus próprios dados. Código típico:
// Exemplo de waterfall: este é o código problemático
async function ProductPage({ id: string }) {
  // Primeira requisição: 1 segundo
  const product = await db.getProduct(id);

  // Estas requisições só começam depois da renderização dos filhos
  return (
    <div>
      <ProductDetails product={product} />
      <ProductPrice id={id} />      {/* internamente faz await getPrice(id), 3 segundos */}
      <ProductReviews id={id} />    {/* internamente faz await getReviews(id), 5 segundos */}
    </div>
  );
}

// ProductPrice.tsx
async function ProductPrice({ id }) {
  const price = await getPrice(id);  // só executa depois da renderização do pai
  return <span>{price}</span>;
}
Tempo total? 9 segundos. O usuário fica olhando para uma página vazia por 9 segundos.
A segunda: waterfall client-server. Um componente cliente chama o servidor, e o servidor então chama o banco de dados. Essa forma é mais escondida; normalmente você só pega com o React DevTools Profiler. É uma variação do problema N+1.
Como identificar waterfall
Abra o React DevTools Profiler e grave um carregamento de página. Se a linha do tempo mostrar uma distribuição clara em degraus, em que cada requisição espera a anterior terminar, você tem um waterfall.
Há também um caminho mais visual. Abra o painel Network do navegador e veja o momento em que as requisições começam. Se as requisições de dados aparecem espalhadas no tempo, em vez de começarem juntas, o problema está praticamente confirmado.
O curioso é que muitos desenvolvedores acham que usar RSC já traz ganho de desempenho automaticamente. Não é assim. Segundo um relatório da SitePoint de 2026, a maioria dos times usa apenas cerca de 30% do potencial de desempenho de RSC. A causa costuma ser waterfall não tratado.
Quatro soluções comparadas: do bruto ao elegante
O problema de waterfall tem quatro soluções principais. Elas vão da mais simples à mais sofisticada, da mais bruta à mais elegante.
Solução 1: busca paralela com Promise.all
A ideia mais direta: disparar todas as requisições juntas e esperar tudo com Promise.all.
// Solução 1: busca paralela com Promise.all
async function ProductPage({ id: string }) {
  // Dispara todas as requisições ao mesmo tempo
  const [product, price, reviews] = await Promise.all([
    getProduct(id),      // 1 segundo
    getPrice(id),        // 3 segundos
    getReviews(id),      // 5 segundos
  ]);

  return (
    <div>
      <ProductDetails product={product} />
      <ProductPriceDisplay price={price} />
      <ProductReviewsList reviews={reviews} />
    </div>
  );
}
Tempo total? 5 segundos. A requisição mais lenta determina o tempo geral.
Vantagens: simples, com pouca mudança.
Desvantagens: o usuário ainda precisa esperar a requisição mais lenta terminar para ver qualquer conteúdo. E há outro problema: acoplamento de dados. O componente pai precisa saber de quais dados os filhos precisam, o que quebra a independência dos componentes.
Solução 2: isolamento com limites de Suspense
Adicione Suspense nas partes que dependem de dados e deixe o conteúdo crítico aparecer primeiro.

// Solução 2: isolamento com limites de Suspense
async function ProductPage({ id: string }) {
  const product = await getProduct(id);  // espera primeiro os dados críticos

  return (
    <div>
      <ProductDetails product={product} />  {/* aparece depois de 1 segundo */}

      {/* Partes não críticas ficam dentro de Suspense */}
      <Suspense fallback={<PriceSkeleton />}>
        <ProductPrice id={id} />
      </Suspense>

      <Suspense fallback={<ReviewsSkeleton />}>
        <ProductReviews id={id} />
      </Suspense>
    </div>
  );
}
Experiência do usuário: em 1 segundo ele vê as informações do produto; em 3 segundos aparece o preço; em 5 segundos os comentários terminam de carregar.
Vantagens: o conteúdo crítico aparece primeiro, e a percepção do usuário melhora.
Desvantagens: as requisições de dados ainda começam em sequência. As chamadas de ProductPrice e ProductReviews só começam depois da renderização do componente pai; não é paralelismo de verdade.
Solução 3: passar Promise como props
O componente pai inicia todas as requisições e passa as Promises como props para os filhos. Cada filho faz seu próprio await.
// Solução 3: padrão de passagem de Promise
async function ProductPage({ id: string }) {
  // Inicia todas as requisições imediatamente, sem await
  const productPromise = getProduct(id);
  const pricePromise = getPrice(id);
  const reviewsPromise = getReviews(id);

  // Só espera os dados críticos
  const product = await productPromise;

  return (
    <div>
      <ProductDetails product={product} />

      <Suspense fallback={<PriceSkeleton />}>
        <ProductPrice pricePromise={pricePromise} />
      </Suspense>

      <Suspense fallback={<ReviewsSkeleton />}>
        <ProductReviews reviewsPromise={reviewsPromise} />
      </Suspense>
    </div>
  );
}

// ProductPrice.tsx: recebe uma Promise
async function ProductPrice({ pricePromise }) {
  const price = await pricePromise;  // reutiliza a Promise iniciada pelo pai
  return <span>{price}</span>;
}
As três requisições começam ao mesmo tempo no componente pai. Os dados críticos aparecem em 1 segundo, o preço em 3 segundos e os comentários em 5 segundos.
Vantagens: todas as requisições são disparadas em paralelo; o conteúdo crítico aparece primeiro; os dados ficam desacoplados, pois o filho só recebe uma Promise.
Desvantagens: exige mudar a interface dos componentes. O filho deixa de receber id e passa a receber uma Promise.
Solução 4: React cache() + preload (recomendada)
O React 19 introduziu a API cache(). Combinada ao padrão de preload, ela vira a solução mais elegante.
// Solução 4: React cache() + preload
import { cache } from 'react';

// Envolve a função de busca de dados com cache
const getComments = cache(async (postId: string) => {
  return db.getComments(postId);
});

// Exporta a função preload, deixando claro o propósito
export const preloadComments = (id: string) => {
  void getComments(id);  // não espera; inicia sem bloquear
};

// Componente pai
async function PostPage({ postId: string }) {
  preloadComments(postId);  // pré-carrega comentários

  const post = await getPost(postId);  // só espera os dados críticos

  return (
    <div>
      <PostContent post={post} />
      <Suspense fallback={<CommentsSkeleton />}>
        <Comments postId={postId} />  {/* usa id diretamente; cache reutiliza automaticamente */}
      </Suspense>
    </div>
  );
}

// Comments.tsx: a interface do componente não muda
async function Comments({ postId }) {
  const comments = await getComments(postId);  // reutiliza a Promise do preload
  return <CommentList comments={comments} />;
}
Como funciona: uma função envolvida por cache() é memoized automaticamente dentro do mesmo ciclo de renderização. A chamada de preload dispara a requisição sem esperar; quando o componente filho faz await, ele reutiliza a mesma Promise.
Vantagens:
- A interface do componente não muda; ele continua recebendo
id - As requisições são memoized automaticamente, sem acoplamento de dados
- Se o componente filho for removido, o preload vira código morto e fica fácil de encontrar
Desvantagens: é preciso entender o mecanismo de cache() e tomar cuidado com acoplamento escondido. Ao remover o componente Comments, remova também o preload correspondente.
Comparação das quatro soluções
| Solução | Tempo total | Quando o conteúdo crítico aparece | Acoplamento de dados | Custo de mudança |
|---|---|---|---|---|
| Busca sequencial | 9s | 9s | Não | Nenhum |
| Promise.all | 5s | 5s | Sim | Baixo |
| Suspense | 5s | 1s | Não | Baixo |
| Passagem de Promise | 5s | 1s | Desacoplado | Médio |
| cache() + preload | 1s | 1s | Não | Médio |
Na prática, a escolha depende do time. Para migração rápida, use a solução 2. Para projetos novos, recomendo a solução 4.
Arquitetura de renderização em streaming: o segredo do TTFB de 45ms
O fluxo tradicional de SSR funciona assim: espera todos os dados chegarem, renderiza o HTML completo e envia tudo de uma vez ao navegador. O TTFB, Time to First Byte, é o tempo de busca de dados somado ao tempo de renderização.
Em números concretos: consulta ao banco em 400ms, renderização em 50ms, TTFB por volta de 450ms. O usuário olha para uma página vazia por quase meio segundo.
Como RSC Streaming muda esse fluxo
O ponto central da renderização em streaming não é reduzir algo isoladamente, mas mudar a ordem em que o conteúdo chega ao usuário. As partes estáticas são enviadas imediatamente; as partes dinâmicas chegam depois, em streaming.
// Exemplo de arquitetura em streaming
export default async function Dashboard() {
  return (
    <Layout>                          {/* shell estático, fora de Suspense */}
      <Nav />                         {/* renderiza imediatamente */}
      <Sidebar />                     {/* renderiza imediatamente */}

      <Suspense fallback={<ChartSkeleton />}>
        <DynamicChart />               {/* dados dinâmicos, carregamento em streaming */}
      </Suspense>

      <Suspense fallback={<TableSkeleton />}>
        <DataTable />                  {/* dados dinâmicos, carregamento em streaming */}
      </Suspense>
    </Layout>
  );
}
Fluxo detalhado:
- T=0ms: o shell estático, com Layout, Nav e Sidebar, é enviado imediatamente a partir do cache de borda do CDN
- T=30-50ms: o navegador começa a renderizar o shell estático e exibe o skeleton
- T=200ms: os dados de
DynamicChartchegam, e o conteúdo do limite de Suspense correspondente é enviado em streaming - T=400ms: os dados de
DataTablechegam, e o conteúdo correspondente é enviado em streaming
TTFB? Cerca de 45ms. É o tempo de envio do shell estático.
O papel do PPR, ou Partial Prerendering
PPR é um recurso introduzido no Next.js 15 e que o Next.js 16 deve habilitar por padrão. Ele pré-renderiza as partes estáticas no CDN e mantém as partes dinâmicas em streaming.
Configuração:
// next.config.js: Next.js 15
module.exports = {
  experimental: {
    ppr: true,  // ativa PPR
  },
};

// next.config.js: Next.js 16 (preview)
module.exports = {
  experimental: {
    ppr: 'incremental',  // ativação gradual
    cacheComponents: true,  // novo modelo de cache
  },
};
Com PPR ativo, o shell estático, como navegação, layout e skeleton, é pré-renderizado e armazenado no CDN. Quando o usuário acessa a página, o CDN devolve o HTML estático imediatamente, e as partes dinâmicas são preenchidas pelo servidor via streaming.
Princípios para desenhar limites de Suspense
Regra principal: esquecer de marcar os blocos de streaming com Suspense faz o React tratar a aplicação inteira como um bloco gigante.
Forma correta:
- Não envolva partes estáticas com Suspense: navegação, Layout e skeletons que não dependem de dados
- Envolva partes dinâmicas com Suspense: componentes que dependem de banco de dados ou API
// Exemplo correto
export default async function Page() {
  return (
    <>
      <Header />                     {/* estático, não envolve */}
      <main>
        <Suspense fallback={<HeroSkeleton />}>
          <HeroSection />             {/* dinâmico, envolve */}
        </Suspense>

        <Suspense fallback={<ContentSkeleton />}>
          <MainContent />             {/* dinâmico, envolve */}
        </Suspense>
      </main>
      <Footer />                      {/* estático, não envolve */}
    </>
  );
}
Exemplo errado, com a página inteira bloqueada:
// Exemplo errado: sem Suspense
export default async function Page() {
  const data = await fetchDashboard();  // await bloqueia a página inteira
  return (
    <>
      <Header />
      <Dashboard data={data} />
      <Footer />
    </>
  );
}
Sem limites de Suspense, a página inteira é tratada como um único bloco de streaming. O TTFB continua em 450ms.

Comparação de desempenho
| Modo de renderização | TTFB | LCP | Explicação |
|---|---|---|---|
| SSR tradicional | ~450ms | ~500ms | Espera todos os dados |
| RSC sem Suspense | ~450ms | ~500ms | Equivale ao SSR tradicional |
| RSC Streaming | ~45ms | ~200ms | Shell estático enviado imediatamente |
| RSC + PPR | ~30ms | ~150ms | Shell estático em cache no CDN |
Fonte dos dados: relatório SitePoint 2026. Os valores medidos podem variar conforme a fonte de dados e a configuração do CDN.
Guia de uso das cinco APIs de cache
Next.js e React oferecem cinco mecanismos de cache. Escolher bem dá muito resultado com pouco esforço; escolher mal pode gerar requisições duplicadas.
1. fetch cache (o mais comum)
Requisições fetch em Server Components são memoized automaticamente. Dentro do mesmo ciclo de renderização, requisições com a mesma URL e os mesmos parâmetros só são disparadas uma vez.
// Exemplo de fetch cache
async function ProductCard({ id }) {
  // Cache automático: a mesma URL não dispara requisições repetidas
  const res = await fetch(`https://api.example.com/products/${id}`, {
    cache: 'force-cache',      // força cache (padrão)
    next: {
      revalidate: 3600,         // revalida depois de 1 hora
      tags: ['products'],       // tag usada com revalidateTag
    },
  });
  return <Card data={res.json()} />;
}

async function ProductList() {
  // Esta requisição reutiliza o cache acima
  const res = await fetch('https://api.example.com/products', {
    next: { tags: ['products'] },
  });
  return <List data={res.json()} />;
}
Opções de configuração:
cache: 'force-cache': prioriza o cache, que é o padrãocache: 'no-store': faz uma nova requisição semprenext.revalidate: revalidação periódica, em segundosnext.tags: marcações usadas comrevalidateTagpara revalidação manual
2. React cache() (novo no React 19)
Serve para armazenar em cache o resultado de chamadas de função. É útil para consultas ao banco de dados e funções customizadas de busca de dados.
import { cache } from 'react';

// Envolve a consulta ao banco com cache
export const getUser = cache(async (id: string) => {
  const user = await db.query('SELECT * FROM users WHERE id = ?', [id]);
  return user;
});

// Uso em vários componentes, com memoização automática
async function UserProfile({ id }) {
  const user = await getUser(id);
  return <Profile user={user} />;
}

async function UserStats({ id }) {
  const user = await getUser(id);  // reutiliza o resultado acima
  return <Stats user={user} />;
}Atenção: cache() só funciona dentro do mesmo ciclo de renderização. Para cache entre requisições, use unstable_cache.
3. unstable_cache (Next.js 14-15)
Cache persistente, mantido entre requisições. É adequado para cálculos caros e dados compartilhados entre páginas.
import { unstable_cache } from 'next/cache';

// Envolve a função e adiciona cache persistente
export const getPopularProducts = unstable_cache(
  async () => {
    const products = await db.getPopularProducts();
    return products;
  },
  ['popular-products'],           // chave de cache
  {
    revalidate: 3600,              // revalida depois de 1 hora
    tags: ['products', 'popular'], // várias tags
  }
);

// Uso
async function HomePage() {
  const products = await getPopularProducts();
  return <ProductGrid products={products} />;
}
Revalidação manual:
import { revalidateTag } from 'next/cache';

// Em uma Server Action ou API Route
async function updateProduct() {
  await db.updateProduct();
  await revalidateTag('products');  // atualiza todos os caches com a tag products
}
4. use cache (novo no Next.js 16)
É uma diretiva de cache no nível de componente. Ao colocar 'use cache' no topo de uma função ou componente, a saída passa a ser armazenada em cache automaticamente.
// 'use cache' no nível de função
'use cache';
export async function getRecommendations(userId: string) {
  return db.getRecommendations(userId);
}

// 'use cache' no nível de componente
'use cache';
export async function CachedFooter() {
  const links = await getFooterLinks();
  return <Footer links={links} />;
}
Cenário de uso: componentes acessados com frequência e conteúdo estático. É um recurso experimental com suporte formal no Next.js 16.
5. revalidatePath / revalidateTag
São métodos para revalidar cache manualmente.
import { revalidatePath, revalidateTag } from 'next/cache';

// Revalidação por caminho
await revalidatePath('/products');      // atualiza todos os caches desse caminho
await revalidatePath('/products/[id]', 'page');  // atualiza uma página específica

// Revalidação por tag
await revalidateTag('products');        // atualiza todos os caches com a tag products
Como escolher:
- Para controle preciso, use
revalidateTag, recomendado - Para revalidação em lote, use
revalidatePath
Comparação das APIs de cache
| API | Escopo do cache | Persistente | Cenário de uso | Versão |
|---|---|---|---|---|
| fetch cache | Requisição individual | Configurável | Requisições de API | Next.js 13+ |
| React cache() | Ciclo de renderização individual | Não | Consultas ao banco e funções customizadas | React 19 |
| unstable_cache | Entre requisições | Sim | Cálculos caros e dados compartilhados | Next.js 14-15 |
| use cache | Nível de função/componente | Sim | Componentes acessados com frequência | Next.js 16 |
| Cache Components | Saída de componente | Sim | Uso junto com PPR | Next.js 16 |
Modelo de configuração prática e armadilhas
Chega de teoria. Aqui vai uma configuração que dá para copiar e adaptar.
Configuração completa de next.config.js
// next.config.mjs
/** @type {import('next').NextConfig} */
const nextConfig = {
  experimental: {
    // Next.js 15: ativa PPR
    ppr: true,

    // Next.js 16: novo modelo de cache
    // cacheComponents: true,  // ativar na versão estável
  },

  // Relacionado a desempenho
  images: {
    formats: ['image/avif', 'image/webp'],
  },

  // Otimização de saída
  output: 'standalone',  // útil para deploy com Docker
};

export default nextConfig;
Padrão para exportar funções preload
Funções preload podem criar acoplamento escondido. Ao remover um componente profundo, o preload pode virar código inútil.
A prática recomendada é adicionar um comentário acima da função preload, marcando sua finalidade.
// comments.ts
import { cache } from 'react';

const getComments = cache(async (postId: string) => {
  return db.getComments(postId);
});

/**
 * preloadComments: pré-carrega os dados de comentários para o componente Comments.
 * Atenção: ao remover o componente Comments, remova também esta função preload.
 */
export const preloadComments = (id: string) => {
  void getComments(id);
};

export async function Comments({ postId }) {
  const comments = await getComments(postId);
  return <CommentList comments={comments} />;
}
Armadilhas comuns
Armadilha 1: esquecer o limite de Suspense
Sintoma: o TTFB da página inteira continua em 450ms, sem efeito de streaming.
Causa: sem limite de Suspense, o React trata a página inteira como um bloco de streaming.
Solução: adicione Suspense aos componentes que dependem de dados.
// Antes da correção
async function Page() {
  const data = await getData();  // bloqueia a página inteira
  return <Dashboard data={data} />;
}

// Depois da correção
async function Page() {
  return (
    <Suspense fallback={<DashboardSkeleton />}>
      <Dashboard />
    </Suspense>
  );
}
Armadilha 2: fazer preload, mas não usar
Sintoma: a requisição é disparada, mas os dados não são usados. Recursos desperdiçados.
Causa: o componente filho foi removido, mas a função preload continuou no código.

Solução: ao remover o componente, remova também o preload; ou marque a relação com comentários.
Armadilha 3: conflito de tags de cache
Sintoma: revalidateTag atualiza um escopo grande demais, e dados que não deveriam ser revalidados também são atualizados.
Causa: vários caches sem relação usam a mesma tag.
Solução: use tags diferentes para dados de domínios diferentes.
// Exemplo errado
await fetch(url, { next: { tags: ['data'] } });  // todos os dados usam a tag 'data'
await revalidateTag('data');  // atualiza todos os dados em cache

// Exemplo correto
await fetch(productsUrl, { next: { tags: ['products'] } });
await fetch(usersUrl, { next: { tags: ['users'] } });
await revalidateTag('products');  // atualiza apenas products
Armadilha 4: misturar fetch cache com React cache
Sintoma: os mesmos dados geram duas requisições.
Causa: fetch foi usado com 'no-store', então React cache() não consegue reutilizar.
Solução: use force-cache ou a configuração padrão no fetch, permitindo a reutilização pelo React cache.
// Exemplo errado
const data1 = await fetch(url, { cache: 'no-store' });  // sem cache
const data2 = await getData();  // envolvido por React cache, mas sem reutilização

// Exemplo correto
const data1 = await fetch(url);  // padrão force-cache
const data2 = await getData();  // pode reutilizar
Ferramentas de depuração
- React DevTools Profiler: grava o processo de renderização e mostra a distribuição de waterfall
- Ferramentas de análise do Next.js:
next build --experimental-debuggera análise do build - Chrome DevTools: o painel Network mostra a ordem das requisições; o painel Performance mostra o momento da renderização
Indicadores principais:
- TTFB: tempo até o primeiro byte, meta < 100ms
- LCP: Largest Contentful Paint, meta < 2.5s
- CLS: Cumulative Layout Shift, meta < 0.1
Recomendações de migração
Ao migrar uma página SSR existente para RSC com streaming:
- Identifique primeiro o waterfall: grave com o Profiler e encontre buscas de dados sequenciais
- Adicione limites de Suspense: envolva componentes que dependem de dados, priorizando o caminho crítico
- Adicione preload: use
cache()+preloadem componentes mais profundos - Configure o cache: adicione tags ao
fetchpara controlar a revalidação com precisão
Migre aos poucos; não reescreva tudo de uma vez. Comece pela página mais lenta, meça o ganho e só então expanda.
Conclusão
Depois de tudo isso, o núcleo cabe em três passos: identificar o waterfall, escolher a solução e configurar a arquitetura em streaming.
O problema de waterfall é fácil de reconhecer: componentes aninhados fazem await dos próprios dados, e a linha do tempo fica em formato de degraus. As quatro soluções têm usos diferentes: para migração rápida, use limites de Suspense; em projetos novos, use React cache() + preload.
O ponto crítico da arquitetura em streaming é a posição dos limites de Suspense. Partes estáticas, como navegação e Layout, ficam fora. Partes dinâmicas, como componentes dependentes de dados, ficam dentro. Se você esquece esse limite, a página inteira continua em renderização bloqueante.
O ganho de desempenho é mensurável: TTFB de 450ms para 45ms, uma diferença de 10 vezes. Entre um resultado e outro, muitas vezes há apenas alguns limites de Suspense e uma função preload.
Agora abra seu projeto Next.js e verifique se há componentes aninhados buscando dados por conta própria. Se o TTFB ainda estiver acima de 300ms, experimente envolver o conteúdo crítico com Suspense. Seus usuários vão sentir a diferença imediatamente.
Referências
- Data Fetching Patterns and Best Practices — documentação oficial do Next.js
- React Server Components Streaming Performance Guide 2026 — SitePoint, 2026-02
- Avoiding Server Component Waterfall Fetching with React 19 cache() — Aurora Scharff, 2025-02
- Avoiding Waterfalls in React Server Components — Akhila Ariyachandra, 2026-01
- Functions: revalidatePath — documentação oficial do Next.js
- Functions: revalidateTag — documentação oficial do Next.js
- Partial Prerendering (PPR) — documentação oficial do Next.js
- React v19 Release — blog oficial do React
Fluxo de otimização de desempenho em React Server Components
Etapas completas de otimização, da identificação de waterfall à configuração de arquitetura em streaming
⏱️ Estimated time: 60 min
- 1
Step 1: Identificar o problema de waterfall
Use o React DevTools Profiler para gravar o carregamento da página:
• Abra o Chrome DevTools e vá para a aba Profiler
• Clique em gravar, atualize a página e espere o carregamento terminar
• Confira a distribuição das requisições na linha do tempo
• Distribuição em degraus = problema de waterfall
• Observe se o TTFB passa de 300ms - 2
Step 2: Escolher a solução
Escolha a abordagem conforme a situação do time:
• Migração rápida: solução 2, isolamento com limites de Suspense
• Projeto novo: solução 4, React cache() + preload
• Acoplamento de dados aceitável: solução 1, Promise.all
• Interface dos componentes sem mudança: solução 4, recomendada - 3
Step 3: Adicionar limites de Suspense
Adicione Suspense aos componentes que dependem de dados:
• Não envolva partes estáticas, como navegação e Layout
• Envolva obrigatoriamente partes dinâmicas, como componentes dependentes de dados
• Forneça um fallback de skeleton adequado
• Priorize o caminho crítico - 4
Step 4: Configurar React cache() + preload
Use a API cache() do React 19:
• Envolva a função de busca de dados com cache
• Exporte uma função preload e não use await nela
• Adicione comentários para marcar a relação entre preload e componente
• Ao remover o componente, remova também o preload correspondente - 5
Step 5: Configurar a estratégia de cache
Escolha a API de cache adequada:
• fetch cache: requisições de API, o caso mais comum
• React cache(): consultas ao banco de dados
• unstable_cache: compartilhamento entre requisições
• Adicione tags ao cache para permitir revalidação precisa - 6
Step 6: Medir o ganho de desempenho
Valide o efeito da otimização:
• Meta de TTFB: < 100ms
• Meta de LCP: < 2.5s
• Meta de CLS: < 0.1
• Compare os dados de desempenho antes e depois
FAQ
O que é o problema de waterfall em React Server Components?
Como escolher entre as quatro soluções para waterfall?
• Promise.all: simples e direto, bom para correções rápidas, mas ainda cria acoplamento de dados
• Limites de Suspense: conteúdo crítico aparece primeiro, bom para migração rápida
• Passagem de Promise: todas as requisições rodam em paralelo, bom quando a interface dos componentes pode mudar
• React cache() + preload: abordagem mais elegante, ideal para projetos novos, recomendada
Onde colocar os limites de Suspense?
Qual é a diferença entre as cinco APIs de cache?
• fetch cache: requisições de API, com memoização automática no Next.js 13+
• React cache(): consultas ao banco de dados, cache dentro de um único ciclo de renderização no React 19
• unstable_cache: persistência entre requisições, útil para cálculos caros no Next.js 14-15
• use cache: cache no nível de função ou componente no Next.js 16
• revalidatePath/Tag: revalidação manual de cache
Como medir o efeito da otimização de RSC?
O que é PPR, ou Partial Prerendering?
Quais são as armadilhas comuns na configuração de cache?
• Esquecer limites de Suspense: a página inteira bloqueia e o TTFB não melhora
• Fazer preload sem uso: o componente foi removido, mas o preload ficou, desperdiçando requisições
• Conflito de tags de cache: revalidateTag atualiza um escopo grande demais
• Misturar fetch cache com React cache: usar no-store impede a reutilização
1 min de leitura · Publicado em: 13 mai 2026 · Atualizado em: 14 jul 2026

Guia completo Next.js
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Next.js App Router + shadcn/ui: guia para combinar Server e Client Components
Aprenda a combinar Server Components e Client Components corretamente no Next.js App Router, com integração prática do shadcn/ui, design do fluxo de dados, correção de erros comuns e otimização de desempenho.
Parte 46 de 51
Próximo
NextAuth.js para iniciantes: guia completo de login com Credentials e gerenciamento de sessão
A autenticação com NextAuth.js parece complexa? Este guia aborda login com Credentials, escolha entre JWT e Session, exemplos completos de código e erros comuns para ajudar desenvolvedores Next.js a implementar autenticação rapidamente.
Parte 48 de 51


Comentários
Entre com GitHub para comentar