
LangGraph 다중 Agent 협업 실전: Supervisor 패턴과 작업 분배
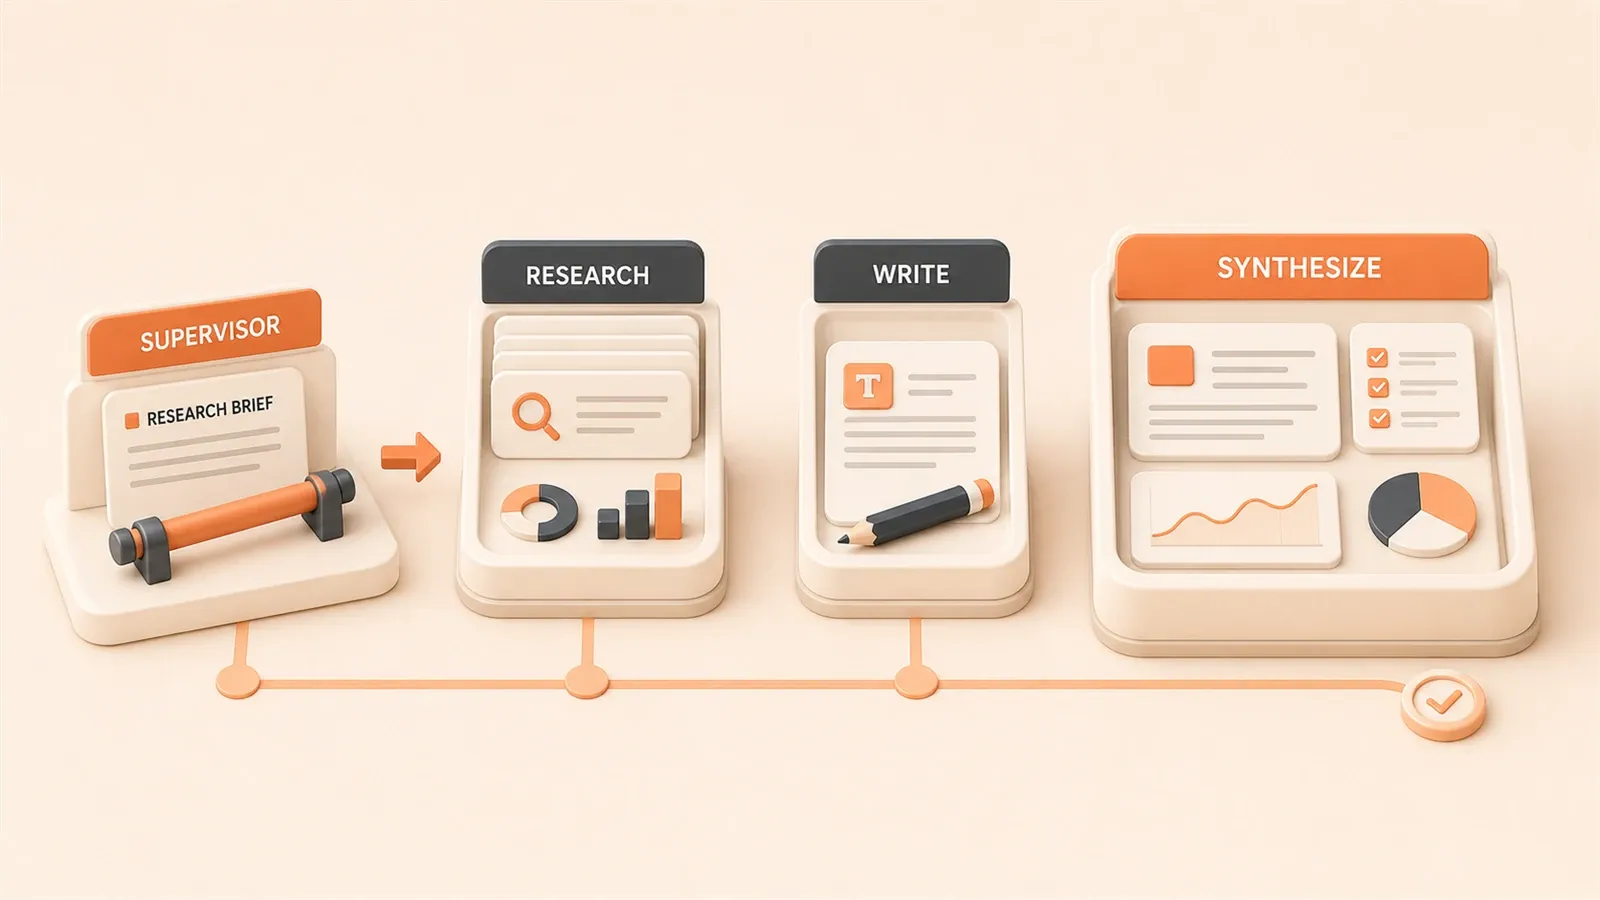
지난달 팀의 Agent 시스템을 리팩터링한 적이 있습니다. 원래는 단일 Agent 하나에 검색, 코드 실행, 문서 생성, 메일 발송 등 12개의 도구가 매달려 있었습니다. 결과는 어땠을까요? LLM이 도구 사이에서 자주 망설였고, 검색해야 할 상황에 코드 실행기를 쓰기도 했습니다. 디버깅할 때 로그를 봐도 어느 도구 호출에서 문제가 생겼는지 알기 어려웠습니다. 시스템 전체가 거의 블랙박스였습니다.
이후 우리는 아키텍처를 Supervisor + Workers 패턴으로 나눴습니다. 총괄 Agent 하나가 라우팅을 맡고, 세 명의 전문가 Agent가 각자 역할을 수행하게 했습니다. 도구 선택 오류율은 기존의 3분의 1 수준으로 떨어졌고, 디버깅도 훨씬 명확해졌습니다. 각 계층을 단계별로 trace할 수 있었기 때문입니다.
간단히 말해, Agent 하나가 10개가 넘는 도구를 들고 있다면 단일 Agent 아키텍처는 이미 문제가 생기기 시작한 것입니다. 이 글에서는 Supervisor 패턴의 아키텍처 원리부터 create_supervisor API의 전체 사용법, 그리고 Research + Writing 팀을 구성하는 실전 사례까지 살펴봅니다. 코드는 바로 실행할 수 있고, GitHub 저장소 링크도 뒤쪽에 정리해 두었습니다.
1. 왜 다중 Agent 시스템이 필요한가?
단일 Agent의 세 가지 치명점
제가 밟았던 함정은 아마 여러분도 겪고 있을 수 있습니다. 단일 Agent 시스템은 겉보기에는 단순하지만, 실제로는 치명적인 문제가 세 가지 있습니다.
첫째: 도구가 너무 많아 선택 장애가 생깁니다.
과장이 아닙니다. 단일 Agent가 10개가 넘는 도구를 갖고 있으면 LLM의 도구 선택 오류율이 눈에 띄게 올라갑니다. 요즘 모델이 점점 똑똑해지고 있지 않느냐고 말할 수도 있습니다. 맞습니다. 하지만 문제는 도구 설명이 prompt 안에 한 덩어리로 쌓이고, 모델이 10개 이상의 도구 중 정확한 하나를 골라야 한다는 점입니다. 이 인지 부담은 결코 작지 않습니다.
제가 이전에 만들었던 시스템에서는 검색 도구와 코드 실행 도구의 기능 설명이 조금 겹쳤습니다. 둘 다 “정보를 찾을 수 있다”는 느낌이 있었죠. 그 결과 모델은 두 도구 사이를 오가며 여러 라운드의 대화를 낭비했습니다.
둘째: 컨텍스트가 누적되어 window가 폭발합니다.
모든 하위 작업의 대화 이력이 하나의 context window에 눌려 들어갑니다. 몇 라운드만 지나도 window는 과거 tool call 기록에 파묻히고, 핵심 지시는 희석됩니다. 모델은 무언가를 “잊기” 시작하고, 심지어 사용자의 최초 요청까지 놓치기도 합니다.
이 부분은 저도 뼈저리게 느꼈습니다. 한 번은 20라운드를 돈 Agent를 디버깅했는데, context 안은 온갖 함수 호출 기록으로 가득했습니다. 마지막에 모델이 출력한 내용은 사용자의 최초 요구와 거의 관련이 없어졌습니다.
셋째: 디버깅할 수 없고 원인 파악이 어렵습니다.
문제가 생기면 어느 도구 호출이 원인인지 알 수 없습니다. 단일 Agent는 블랙박스에 가깝고, 로그에는 장부처럼 이어지는 tool call 기록만 남습니다. 문제를 찾으려면 한 줄씩 뒤져야 합니다.
Supervisor 패턴은 이 문제를 해결합니다. 하나의 “총괄 Agent”가 여러 “전문가 Agent”를 조율하고, 역할을 분리해 각자 맡은 일을 하게 만드는 방식입니다.

Supervisor 패턴의 핵심 아이디어
말로 풀면 간단합니다. 바로 분업입니다.
팀을 상상해 보세요. 프로젝트 매니저가 전체를 조율하고, 아래에는 리서처가 조사에 집중하고, 엔지니어가 구현에 집중하고, 문서 전문가가 보고서 작성에 집중합니다. 각자 전문성이 있고, 프로젝트 매니저는 모든 일을 직접 알 필요가 없습니다. “이 작업을 누구에게 맡겨야 하는지”만 알면 됩니다.
Supervisor 패턴은 바로 이 사고방식입니다.
- Supervisor(총괄 Agent): 구체적인 작업은 하지 않고 라우팅, 조율, 결과 통합만 담당
- Worker Agents(전문가 Agent): 각자 하나의 영역에 집중하고, 도구 집합은 작고 명확하게 유지
이렇게 하면 어떤 장점이 있을까요?
도구 수가 각 Worker로 분산됩니다. 각 Agent는 자기 도구 집합 안에서만 선택하면 됩니다. 컨텍스트도 분산됩니다. 각 Agent는 자기에게 필요한 작은 대화 이력만 유지합니다. 디버깅할 때도 계층별 trace가 가능합니다. Supervisor가 어느 Worker에게 작업을 배정했고, Worker가 어떤 작업을 실행했는지 한눈에 볼 수 있습니다.
2. Supervisor 패턴의 아키텍처 원리
먼저 아키텍처 다이어그램을 보겠습니다.
                    ┌─────────────────┐
                    │   사용자 요청    │
                    └────────┬────────┘
                             │
                             ▼
                    ┌─────────────────┐
                    │   Supervisor    │
                    │   (총괄 Agent)   │
                    │                 │
                    │  라우팅 + 조율   │
                    │  + 결과 통합     │
                    └────────┬────────┘
                             │
              ┌──────────────┼──────────────┐
              │              │              │
              ▼              ▼              ▼
       ┌──────────┐   ┌──────────┐   ┌──────────┐
       │ Research │   │   Math   │   │ Writing  │
       │  Agent   │   │  Agent   │   │  Agent   │
       │          │   │          │   │          │
       │ 검색 도구 │   │ 계산 도구 │   │ 생성 도구 │
       └────┬─────┘   └────┬─────┘   └────┬─────┘
            │              │              │
            │   Worker     │   Worker     │   Worker
            │   실행 결과  │   실행 결과  │   실행 결과
            │              │              │
            └──────────────┴──────────────┘
                           │
                           ▼
                    ┌─────────────────┐
                    │   Supervisor    │
                    │   결과 통합      │
                    └────────┬────────┘
                             │
                             ▼
                    ┌─────────────────┐
                    │   최종 답변      │
                    └─────────────────┘
핵심 구성 요소의 책임
Supervisor는 세 가지 일을 합니다.
- 라우팅: 사용자 요청을 분석하고 어느 Worker에게 맡길지 판단합니다
- 조율: Worker 사이의 작업 흐름을 관리합니다
- 통합: 각 Worker의 실행 결과를 모아 최종 답변을 출력합니다
Worker Agent는 각자 맡은 일을 합니다.
각 Worker는 자기 전용 도구 집합만 갖습니다. 예를 들어 Research Agent는 검색 도구와 웹페이지 수집 도구만 가질 수 있고, Math Agent는 사칙연산 계산기만 가질 수 있습니다. 도구가 적어지면 선택 정확도는 자연스럽게 올라갑니다.
메시지 전달 메커니즘
여기서 중요한 지점이 하나 있습니다. 바로 전역 상태(Global Graph State)입니다.
모든 Agent는 같은 상태 객체를 공유합니다. Worker가 작업을 끝내면 결과를 상태의 messages 필드에 append합니다. Supervisor는 새 message를 보고 다음에 누구에게 배정할지 결정합니다.
이는 append-only 메커니즘입니다. 메시지는 추가만 되고 삭제되지 않으므로 대화 이력의 완전성을 보장합니다.
Fan-out / Fan-in
복잡한 작업은 여러 Worker가 병렬로 실행해야 할 수 있습니다. 예를 들어 사용자가 “A와 B 두 제품의 시장 데이터를 비교해 줘”라고 묻는다면, Supervisor는 두 개의 Research 작업을 동시에 배정할 수 있습니다. 하나는 A를 조사하고, 하나는 B를 조사하는 식입니다. 이것이 fan-out입니다.
두 Worker가 모두 결과를 반환하면 Supervisor가 다시 이를 통합합니다. 이것이 fan-in입니다.
LangGraph는 이런 병렬 패턴을 지원합니다. 다만 기초 편에서는 깊게 다루지 않고, 뒤쪽의 고급 팁에서 다시 이야기하겠습니다.
"LangGraph는 다중 Agent 시스템을 구축하는 방식을 제공하며, 각 Agent가 자기 도구 집합과 책임 범위를 갖고 Supervisor를 통해 조율과 작업 분배를 수행할 수 있게 합니다."
3. create_supervisor API 자세히 보기
이론은 여기까지입니다. 이제 코드를 작성해 보겠습니다.
설치와 가져오기
pip install langgraph-supervisor langchain-openaifrom langchain_openai import ChatOpenAI
from langgraph_supervisor import create_supervisor
from langgraph.prebuilt import create_react_agent도구 정의하기
먼저 각 Worker에 필요한 도구를 준비합니다.
from typing import Annotated

# 수학 계산 도구
def add(
    a: Annotated[float, "첫 번째 숫자"],
    b: Annotated[float, "두 번째 숫자"]
) -> float:
    """Add two numbers together."""
    return a + b

def multiply(
    a: Annotated[float, "첫 번째 숫자"],
    b: Annotated[float, "두 번째 숫자"]
) -> float:
    """Multiply two numbers."""
    return a * b

# 검색 도구(모의)
def web_search(query: str) -> str:
    """Search the web for information."""
    # 실제 프로젝트에서는 Tavily, Serper 등을 연결할 수 있습니다
    if "population" in query.lower():
        return "베이징 인구는 약 2,189만 명입니다(2023년 데이터)"
    elif "weather" in query.lower():
        return "오늘 베이징은 맑고 기온은 15-25°C입니다"
    else:
        return f"검색 결과: {query}"
여기서는 Python의 Annotated 타입 힌트를 사용했습니다. 모델이 각 매개변수의 의미를 더 명확히 이해하도록 돕기 위해서입니다. 도구 함수의 docstring도 중요합니다. 모델은 이를 통해 도구의 기능을 이해합니다.

Worker Agents 만들기
model = ChatOpenAI(model="gpt-4o")

# 수학 전문가 Agent
math_agent = create_react_agent(
    model=model,
    tools=[add, multiply],
    name="math_expert",
    prompt="당신은 수학 전문가이며 수치 계산에 집중합니다. 사용자가 수학 연산을 필요로 할 때 도구를 사용해 작업을 완료하세요."
)

# 연구 전문가 Agent
research_agent = create_react_agent(
    model=model,
    tools=[web_search],
    name="research_expert",
    prompt="당신은 숙련된 연구원이며 검색과 정보 정리에 능합니다. 사용자가 자료 조사를 요청할 때 검색 도구를 사용해 답을 얻으세요."
)
여기에는 몇 가지 주의할 점이 있습니다.
- name 필드가 중요합니다: Supervisor는 이름으로 Worker를 식별하고 호출합니다
- prompt가 역할을 정의합니다: 이 Agent의 전문 분야가 무엇인지 알려줍니다
- 도구 집합은 간결하게 둡니다: 각 Agent는 필요한 도구만 갖고, 과하지도 부족하지도 않게 구성합니다
Supervisor 만들기
# Supervisor 시스템 생성
supervisor = create_supervisor(
    agents=[math_agent, research_agent],
    model=model,
    prompt="""당신은 각 전문가 Agent를 조율하는 팀 Leader입니다.

사용자 요청에 따라 누구에게 작업을 맡길지 결정하세요:
- 수학 계산이 필요함 → math_expert
- 자료 검색이 필요함 → research_expert
- 작업 완료 → 사용자에게 직접 답변

여러 전문가의 협업이 필요하다면 합리적인 순서로 차례대로 호출하세요."""
)

# 실행 가능한 애플리케이션으로 컴파일
app = supervisor.compile()create_supervisor는 세 가지 핵심 매개변수를 받습니다.
agents: Worker Agent 목록model: Supervisor 자신이 사용할 대형 모델prompt: Supervisor에게 작업 배정 방식을 알려주는 지시문
실행 예시
from langchain_core.messages import HumanMessage

# 수학 문제 테스트
result = app.invoke({
    "messages": [HumanMessage(content="123 더하기 456은 얼마인가요?")]
})
print(result["messages"][-1].content)
# 출력: 123 더하기 456은 579입니다

# 검색 문제 테스트
result = app.invoke({
    "messages": [HumanMessage(content="베이징의 인구는 얼마인가요?")]
})
print(result["messages"][-1].content)
# 출력: 검색 결과에 따르면 베이징 인구는 약 2,189만 명입니다
Supervisor는 요청 유형을 자동으로 판단한 뒤 올바른 Worker로 라우팅합니다. 전 과정은 사용자에게 투명합니다. 사용자는 뒤에서 여러 Agent가 일하고 있다는 사실을 알 필요가 없습니다.
4. 실전 사례: Research + Writing 팀 구축
위 예시는 가장 기본적인 형태입니다. 이제 더 완성도 있는 시스템을 만들어 보겠습니다. 기술 주제를 자동으로 조사하고 글까지 생성하는 팀입니다.
시나리오 설명
사용자가 기술 주제를 입력하면 시스템은 자동으로 다음 작업을 완료합니다.
- 관련 자료 조사
- 글의 개요 생성
- 전체 내용 작성
- 검토와 교정
이를 위해 세 명의 전문 Agent가 협업해야 합니다.
전체 도구 집합 정의하기
from typing import TypedDict, List
import json

# 모의 검색 도구
def tech_search(query: str) -> str:
    """기술 자료와 문서를 검색합니다."""
    # 실제 프로젝트에서는 Tavily 또는 Serper를 연결합니다
    database = {
        "langgraph": "LangGraph는 LangChain이 출시한 Agent 프레임워크로, 상태 관리와 순환 그래프 구조를 지원합니다.",
        "supervisor": "Supervisor 패턴은 다중 Agent 시스템의 핵심 아키텍처이며, 하나의 총괄 Agent가 여러 전문가 Agent를 조율합니다.",
        "multi-agent": "다중 Agent 시스템은 작업 분배와 협업을 통해 단일 Agent의 도구 과다와 컨텍스트 폭발 문제를 해결합니다."
    }

    results = []
    for key, value in database.items():
        if key in query.lower():
            results.append(value)

    return json.dumps(results) if results else "관련 자료를 찾지 못했습니다. 검색 범위를 넓히는 것이 좋습니다"

# 개요 생성 도구
def generate_outline(topic: str) -> str:
    """주제에 따라 글의 개요를 생성합니다."""
    return json.dumps({
        "title": f"{topic} 완전 가이드",
        "sections": [
            "1. 개요와 배경",
            "2. 핵심 개념",
            "3. 실전 사례",
            "4. 모범 사례",
            "5. 정리"
        ]
    }, ensure_ascii=False)

# 내용 생성 도구
def write_section(section_title: str, context: str) -> str:
    """제목과 컨텍스트에 따라 단락 내용을 생성합니다."""
    # 실제 프로젝트에서는 여기서 대형 모델을 호출할 수 있습니다
    return f"## {section_title}\n\n조사 자료를 바탕으로 본 {section_title}의 핵심 내용은 다음과 같습니다...\n\n"

# 검토 도구
def review_content(content: str) -> str:
    """내용의 정확성과 가독성을 검토합니다."""
    issues = []
    if len(content) < 100:
        issues.append("내용이 너무 짧습니다. 확장을 권장합니다")
    if "TODO" in content:
        issues.append("완료되지 않은 TODO 표시가 있습니다")

    return json.dumps({
        "passed": len(issues) == 0,
        "issues": issues,
        "suggestion": "내용 품질이 양호하며 게시할 수 있습니다" if not issues else "문제를 수정한 뒤 다시 제출하세요"
    }, ensure_ascii=False)
Worker Agents 만들기
# 연구원 Agent
researcher = create_react_agent(
    model=model,
    tools=[tech_search],
    name="researcher",
    prompt="""당신은 숙련된 기술 연구원이며 새로운 기술을 빠르게 조사하고 이해하는 데 능합니다.

책임:
1. 조사 주제를 받습니다
2. 검색 도구로 관련 자료를 찾습니다
3. 구조화된 조사 보고서로 정리합니다

주의: 조사만 하고 글쓰기는 하지 않습니다. 조사 결과는 writer에게 넘기세요."""
)

# 작성자 Agent
writer = create_react_agent(
    model=model,
    tools=[generate_outline, write_section],
    name="writer",
    prompt="""당신은 기술 글쓰기 전문가이며 복잡한 개념을 명확하고 이해하기 쉬운 글로 바꾸는 데 능합니다.

책임:
1. 조사 보고서를 받습니다
2. 글의 개요를 생성합니다
3. 각 장의 내용을 작성합니다

주의: 초안을 완성한 뒤 reviewer에게 검토를 맡기세요."""
)

# 검토자 Agent
reviewer = create_react_agent(
    model=model,
    tools=[review_content],
    name="reviewer",
    prompt="""당신은 엄격한 검토자이며 글의 품질과 정확성을 보장합니다.

책임:
1. 내용의 완전성과 정확성을 확인합니다
2. 글의 가독성과 논리성을 평가합니다
3. 수정 제안을 내거나 게시 가능 여부를 확인합니다

주의: 문제가 발견되면 writer에게 돌려보내 수정하게 하세요."""
)
Supervisor 로직 구성하기
# StateGraph로 사용자 정의 Supervisor 구성
from langgraph.graph import StateGraph, END
from typing import Annotated, Sequence
from langchain_core.messages import BaseMessage
from langgraph.graph.message import add_messages

# 상태 정의
class AgentState(TypedDict):
    messages: Annotated[Sequence[BaseMessage], add_messages]
    next_agent: str

# Supervisor 의사결정 로직
def supervisor_node(state: AgentState) -> dict:
    """현재 진행 상황에 따라 다음에 실행할 Agent를 결정합니다."""
    messages = state["messages"]

    # 대형 모델을 호출해 결정합니다
    decision = model.invoke([
        {"role": "system", "content": """당신은 팀 Leader입니다. 대화 이력에 따라 다음 단계를 결정하세요:

- 조사 자료가 아직 없으면 → 'researcher' 반환
- 조사 자료는 있지만 글이 아직 없으면 → 'writer' 반환
- 글은 있지만 검토가 아직 없으면 → 'reviewer' 반환
- 검토가 통과되면 → 'FINISH' 반환

Agent 이름만 반환하고 다른 내용은 쓰지 마세요."""},
        *messages
    ])

    next_agent = decision.content.strip()

    # 올바른 Agent 이름으로 매핑
    agent_map = {
        "researcher": "researcher",
        "writer": "writer",
        "reviewer": "reviewer",
        "FINISH": END
    }

    return {"next_agent": agent_map.get(next_agent, "researcher")}

# 그래프 구성
workflow = StateGraph(AgentState)

# 노드 추가
workflow.add_node("supervisor", supervisor_node)
workflow.add_node("researcher", researcher)
workflow.add_node("writer", writer)
workflow.add_node("reviewer", reviewer)

# 조건부 edge 추가(Supervisor의 라우팅 로직)
workflow.add_conditional_edges(
    "supervisor",
    lambda state: state["next_agent"],
    {
        "researcher": "researcher",
        "writer": "writer",
        "reviewer": "reviewer",
        END: END
    }
)

# 모든 Agent가 작업을 마치면 Supervisor로 돌아갑니다
for agent in ["researcher", "writer", "reviewer"]:
    workflow.add_edge(agent, "supervisor")

# 진입점 설정
workflow.set_entry_point("supervisor")

# 컴파일
app = workflow.compile()
이 아키텍처에는 순환 메커니즘이 있습니다. 모든 Worker는 작업을 마치면 Supervisor로 돌아갑니다. Supervisor는 다음 단계에서 다른 Worker에게 배정할지, 아니면 종료할지 결정합니다.
실행 흐름
result = app.invoke({
    "messages": [HumanMessage(content="LangGraph Supervisor 패턴에 관한 기술 글을 작성해 주세요")]
})

# 최종 결과 확인
print(result["messages"][-1].content)

# 실행 경로 확인
for i, msg in enumerate(result["messages"]):
    print(f"{i+1}. {msg.__class__.__name__}: {msg.content[:100]}...")
실행 흐름은 대략 다음과 같습니다.
사용자 요청 → Supervisor 분석 → Researcher에게 배정 →
Researcher 조사 → Supervisor로 반환 → Writer에게 배정 →
Writer 작성 → Supervisor로 반환 → Reviewer에게 배정 →
Reviewer 검토 → Supervisor로 반환 → 완료 확인 → 결과 출력
각 계층을 trace할 수 있으므로 디버깅이 훨씬 명확해집니다.
5. 고급 팁
메시지 전달 최적화: create_forward_message_tool
이미 눈치챘을 수 있는 문제가 하나 있습니다. Worker가 작업을 끝내 반환한 메시지를 Supervisor가 받은 뒤 다시 한 번 요약하거나 재진술할 수 있다는 점입니다. 이는 Token을 낭비하고, 정보가 희석될 수도 있습니다.
LangGraph는 이 문제를 해결하기 위해 create_forward_message_tool을 제공합니다.
from langgraph_supervisor.handoff import create_forward_message_tool

# 전달 도구 생성
forward_tool = create_forward_message_tool("supervisor")

# Supervisor 생성 시 전달
supervisor = create_supervisor(
    agents=[researcher, writer, reviewer],
    model=model,
    tools=[forward_tool]  # 전달 도구 추가
)
이 도구를 사용하면 Supervisor가 Worker의 응답을 다시 요약하지 않고 사용자에게 직접 전달할 수 있습니다. Token을 아끼고 효율도 더 높아집니다.
계층형 팀 아키텍처
프로젝트가 더 복잡하다면 여러 계층의 Supervisor를 구성할 수도 있습니다.
                    ┌──────────────┐
                    │ Top Supervisor│
                    └──────┬───────┘
                           │
           ┌───────────────┼───────────────┐
           │               │               │
           ▼               ▼               ▼
    ┌────────────┐  ┌────────────┐  ┌────────────┐
    │Research    │  │ Writing    │  │ QA         │
    │Team        │  │ Team       │  │ Team       │
    │Supervisor  │  │ Supervisor │  │ Supervisor │
    └─────┬──────┘  └─────┬──────┘  └─────┬──────┘
          │               │               │
     ┌────┼────┐    ┌────┼────┐    ┌────┼────┐
     │    │    │    │    │    │    │    │    │
   Web  Doc  API   Out  Cont Rev   Test Code Audit
 Search Scrp Parse line ent  iew
각 하위 팀은 자기 Supervisor를 갖고, 그 위에 전체를 조율하는 총괄 Supervisor를 둡니다. 이런 아키텍처는 대형 프로젝트에 적합하고 책임 구분도 더 세밀해집니다.
오류 처리
Worker 실행이 실패하면 어떻게 해야 할까요?
from langgraph.pregel import RetryPolicy

# 재시도 정책 설정
retry_policy = RetryPolicy(
    max_attempts=3,
    initial_interval=1.0,
    backoff_factor=2.0
)

app = workflow.compile(retry_policy=retry_policy)
Supervisor의 prompt에 오류 처리 로직을 넣을 수도 있습니다.

특정 Agent 실행이 실패하면:
1. 오류 정보를 기록합니다
2. 예비 Agent 호출을 시도합니다
3. 여러 번 실패하면 사용자에게 문제를 보고합니다
상태 영속화
다중 턴 대화에서는 상태를 저장해야 합니다. LangGraph는 Checkpointer 메커니즘을 제공합니다.
from langgraph.checkpoint.memory import MemorySaver

# 메모리 저장소 사용(개발 환경)
memory = MemorySaver()
app = workflow.compile(checkpointer=memory)

# 실행 시 thread_id 지정
config = {"configurable": {"thread_id": "user-123"}}
result = app.invoke({"messages": [HumanMessage(content="...")]}, config=config)

# 이후 대화는 컨텍스트를 유지합니다
result2 = app.invoke({"messages": [HumanMessage(content="이전 작업을 이어서 진행해 주세요")]}, config=config)
운영 환경에서는 Redis나 PostgreSQL을 Checkpointer로 사용할 수 있습니다.
"Hierarchical Agent Teams는 더 복잡한 다중 Agent 협업 시스템을 구현하기 위해 여러 계층의 Supervisor 아키텍처를 구성하는 방법을 보여줍니다."
6. 운영 배포 제안
모니터링과 디버깅
LangSmith는 LangChain 공식 모니터링 플랫폼으로, 각 단계의 실행 세부 정보를 추적하는 데 도움을 줍니다.
import os

os.environ["LANGSMITH_API_KEY"] = "your-api-key"
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_PROJECT"] = "multi-agent-project"
설정을 마치면 매 실행마다 LangSmith에 전체 경로가 남습니다. 여기에는 다음 정보가 포함됩니다.
- 각 Agent의 입력과 출력
- 도구 호출의 매개변수와 반환값
- Token 사용량 통계
- 실행 시간 분석
디버깅할 때 특히 유용합니다. 더 이상 로그를 한 줄씩 뒤질 필요가 없습니다.
Token 비용 제어
Supervisor 패턴은 좋지만, 다중 Agent는 Token 사용량을 늘립니다. 몇 가지 최적화 제안은 다음과 같습니다.
- Supervisor의 prompt를 간결하게 유지하기: 필요한 라우팅 로직만 포함합니다
- forward_message_tool 사용하기: 반복 요약을 피합니다
- 도구를 합리적으로 배분하기: 각 Worker가 필요한 도구만 갖게 합니다
- 대화 라운드 수 제어하기: 최대 라운드 제한을 설정합니다
# 최대 라운드 수 설정
app = workflow.compile(
    checkpointer=memory,
    interrupt_after=20  # 최대 20단계 실행
)
AWS Bedrock과 통합하기
프로젝트가 AWS 위에 있다면 Bedrock 모델을 사용할 수 있습니다.
from langchain_aws import ChatBedrock

model = ChatBedrock(
    model_id="anthropic.claude-3-sonnet-20240229-v1:0",
    region_name="us-east-1"
)

# 나머지 코드는 그대로 두고 model만 교체하면 됩니다
supervisor = create_supervisor(
    agents=[math_agent, research_agent],
    model=model
)
모범 사례 정리
이야기가 길어졌으니 실전 경험을 몇 가지로 정리해 보겠습니다.
- 작은 규모에서 시작하기: 먼저 2-3개의 Agent로 시작한 뒤 점진적으로 늘립니다
- 책임을 명확하게 두기: 각 Worker의 영역을 분명히 하고 중복을 피합니다
- LangSmith로 모니터링하기: 개발 단계부터 연결해 디버깅을 쉽게 만듭니다
- Token 비용에 주의하기: 다중 Agent는 사용량을 키우므로 최적화가 필요합니다
- forward_message_tool 적극 활용하기: 꽤 많은 Token을 절약할 수 있습니다
- 공식 저장소 참고하기: langgraph-supervisor-py에 전체 예제가 있습니다
정리
Supervisor 패턴의 본질은 분업과 협업입니다. 큰 작업을 작게 나누고, 각 Agent가 자신이 잘하는 일에 집중하게 만드는 방식입니다.
단일 Agent의 세 가지 치명점인 도구 선택 장애, 컨텍스트 폭발, 디버깅 불가부터 Supervisor 패턴의 깔끔한 해결책까지 이 글에서 한 번에 살펴봤습니다. create_supervisor API는 실제로 쓰기 어렵지 않습니다. 핵심은 그 뒤에 있는 아키텍처 사고방식을 이해하는 것입니다.
작은 프로젝트에서 먼저 연습해 보기를 권합니다. 예를 들어 검색 Agent 하나와 요약 Agent 하나로 구성된 2-Agent 시스템을 먼저 만들어 보세요. 잘 동작하면 그다음 단계로 확장하면 됩니다. LangSmith 모니터링은 꼭 붙이세요. 디버깅할 때 그 선택에 감사하게 될 것입니다.
전체 코드 예제는 GitHub 저장소 langgraph-supervisor-py에 있습니다. 공식 튜토리얼 Hierarchical Agent Teams도 읽어볼 만합니다.
궁금한 점이 있으면 댓글로 남겨 주세요. 확인하는 대로 답하겠습니다.
참고 자료
- LangGraph Supervisor Reference
- Hierarchical Agent Teams Tutorial
- LangGraph Multi-Agent Workflows Blog
- GitHub - langgraph-supervisor-py
- Build Multi-Agent Systems with AWS Bedrock
FAQ
Supervisor 패턴과 일반 Multi-Agent는 무엇이 다른가요?
언제 Supervisor 패턴을 써야 하나요?
Supervisor 패턴은 Token 사용량을 늘리나요?
다중 Agent 시스템은 어떻게 디버깅하나요?
create_supervisor와 StateGraph는 어떤 관계인가요?
Worker Agent가 또 다른 Supervisor일 수도 있나요?
1분 읽기 · 게시일: 2026년 5월 12일 · 수정일: 2026년 10월 21일

AI Agent 엔지니어링 가이드
검색으로 들어왔다면 같은 시리즈의 이전 글이나 다음 글로 이동하는 것이 가장 빠릅니다.
이전
LangGraph 상태 관리 실전: Checkpoint, Thread State와 실패 복구
2026 LangGraph 상태 관리 실전 가이드입니다. checkpoint, thread state, failure recovery, AutoGen 비교와 모니터링 방안을 설명해 복구 가능한 프로덕션급 Agent 아키텍처를 설계하도록 돕습니다.
24편 중 9편
다음
LangGraph vs AutoGen 상태 추적 비교: checkpoint 메커니즘, 타임아웃 복구와 선택 기준
LangGraph vs AutoGen 상태 추적을 깊이 비교합니다. Checkpoint 메커니즘, 타임아웃 복구, 분산 지원 등 12개 차원에서 두 Agent 프레임워크를 정량 비교하고, 실제 시행착오 사례와 선택 의사결정 트리, 실행 가능한 코드를 함께 정리했습니다.
24편 중 11편


댓글
GitHub로 로그인하여 댓글을 남기세요