一人公司数据库怎么选:D1、Postgres、R2、S3、SQLite
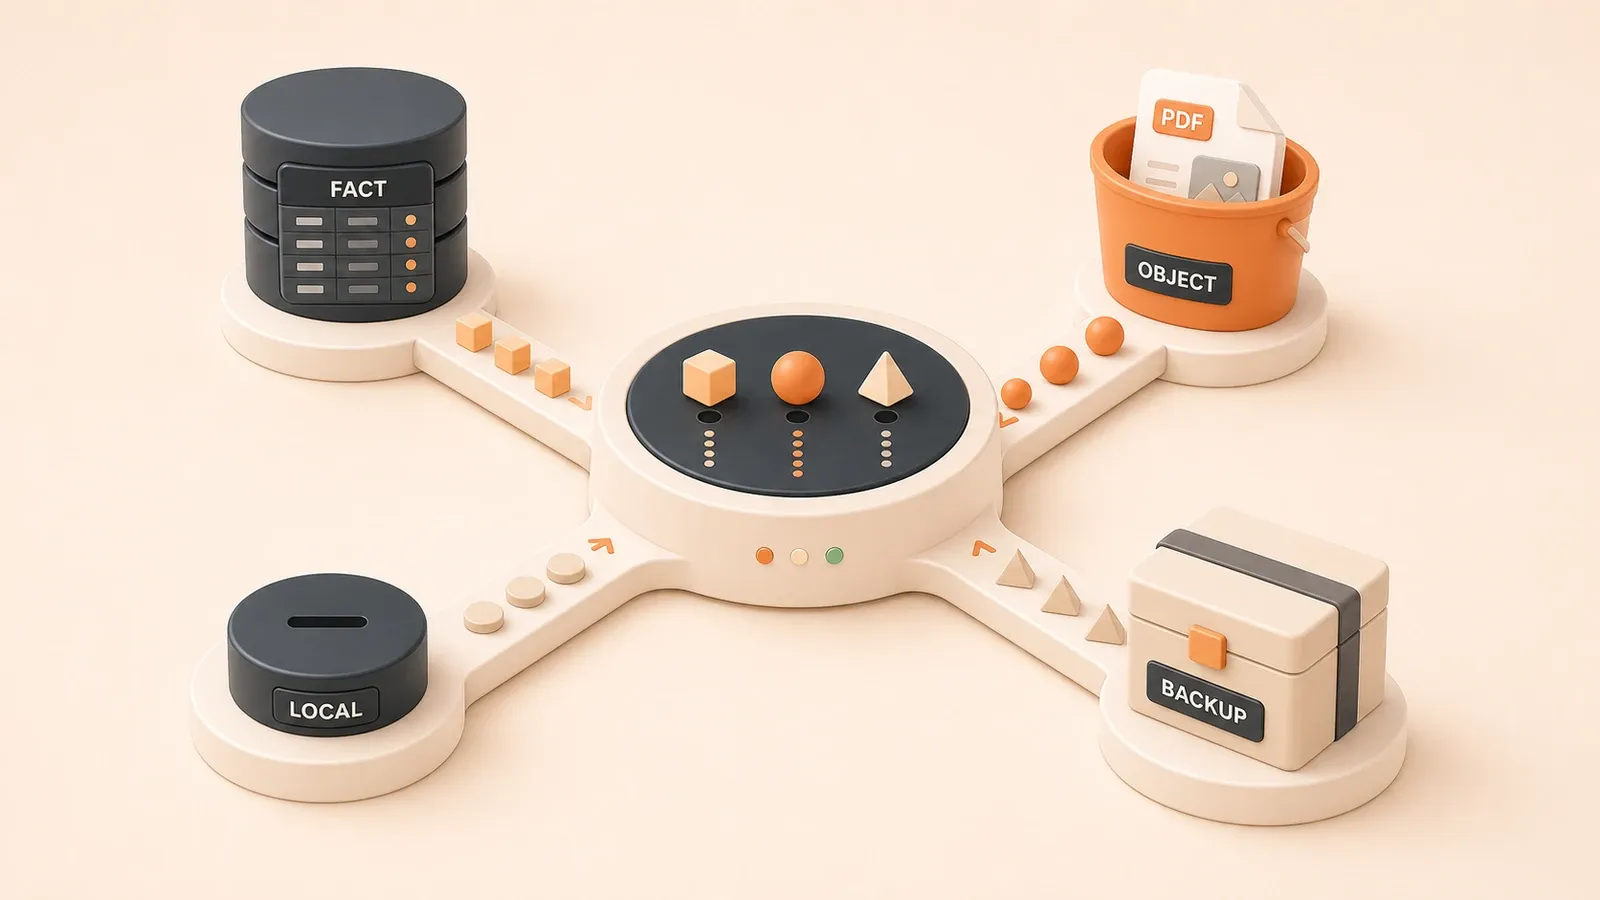
"Cloudflare D1 官方价格页说明 rows read/written、存储额度、索引对扫描行数的影响,以及 Free 达到日限额后的行为。"
你的项目里有这些数据对象:users 表、orders 订单、usage_events 日志、uploads/2026/06/report.pdf 用户上传文件、cache:daily-stats 缓存、local-dev.sqlite 本地开发数据。它们应该分别放进哪个存储?把业务事实塞进对象存储,几天后备份、查询和导出都变慢。用 D1 存数据却没有为过滤条件建索引,rows read 会快速消耗额度;Paid 方案还会产生超额费用。本文建立数据类型→存储选项的决策表,帮你判断每类数据放哪里,避开常见选型错误。
数据类型决策表:你的数据应该放哪里
一人公司项目里的数据对象类型不同,存储选择也不同。业务事实需要查询、关联和权限控制,事件日志需要高频写入和低成本,对象文件需要零出站费用和 CDN 加速。判断依据是:是否需要结构化查询、是否需要权限控制、访问频率、出站成本敏感度。
以下决策表帮你判断每类数据应该放进哪个存储。
7类数据类型和存储选项
| 数据类型 | 具体对象 | 推荐存储 | 判断依据 |
|---|---|---|---|
| 业务事实 | users 表、orders 订单、订阅权益、支付记录 | Supabase Postgres(优先)或 D1 | 需要结构化查询(SELECT/JOIN)、权限控制(RLS)、与方案匹配的备份/时间点恢复、审计追踪 |
| 事件日志 | usage_events 日志、操作记录、访问统计 | D1(边缘读写)或 Postgres(审计需求) | 高频写入、查询简单;非审计事件可降低恢复优先级,安全/计费事件仍需可靠保留 |
| 对象文件 | uploads/2026/06/report.pdf 用户上传、生成结果、导出文件、图片 | R2(Cloudflare 生态)或 S3(AWS 生态)或 Supabase Storage | 不进数据库 blob;零出站成本(R2)、成熟生态(S3)、与 Auth/Postgres 集成(Supabase Storage) |
| 缓存 | cache:daily-stats 缓存、短期状态、临时计算结果 | Cloudflare KV、D1、或本地 SQLite | 读写频繁、通常可过期或重建;边缘轻量用 KV/D1,本地开发用 SQLite |
| 本地开发数据 | local-dev.sqlite 本地测试数据、单用户工具后台 | SQLite(本地文件) | 单用户、无权限系统、copy a file and run、删除摩擦小 |
| 边缘轻数据 | Workers 工具站计数器、配置表、域名映射 | D1 或 Cloudflare KV | Workers 原生访问、轻关系数据、边缘读多 |
| 备份 | 数据库备份文件、导出快照 | R2/S3 + 本地副本 | 零出站成本(R2)、合规和生命周期(S3)、本地副本防止平台故障 |
业务事实优先 Postgres 的原因
业务事实(users、orders、订阅权益、支付记录)是项目核心数据,丢失会影响权益和收入。这类数据需要:
- 结构化查询:SELECT、JOIN、WHERE、ORDER BY 这些 SQL 操作在关系数据库里高效实现,对象存储无法提供。
- 权限控制:Supabase Postgres 的 RLS(Row Level Security)让数据库可从 client 安全查询,D1 目前缺少原生 RLS。
- 备份和恢复:Supabase Pro、Team 和 Enterprise 有日备份,PITR 需另行启用付费附加项;D1 Time Travel 在 Workers Free 保留 7 天、Paid 保留 30 天。
- 审计追踪:支付订单、订阅权益变更需要审计日志,Postgres 的触发器和审计表更容易实现。
Supabase Postgres 不是 Postgres abstraction:每个 Supabase project 是完整的 Postgres database,Auth、Storage、Realtime、Edge Functions 都建在数据库之上(Supabase Database 官方文档)。这意味着你可以用完整的 Postgres 能力,而不是受限的 subset。
事件日志可分离存储
事件日志(usage_events、操作记录、访问统计)和业务事实不同:
- 写入频率高,但查询需求简单(时间范围查询、聚合统计)。
- 非审计型分析事件通常可以采用较低的恢复优先级,但仍应明确保留期和丢失容忍度;安全、计费和权益事件不能按普通访问统计处理。
- 成本敏感:高频写入会消耗 rows written 或 storage quota。
判断边界:
- 如果需要审计追踪(例如操作记录需要关联 user_id 和 action),优先 Postgres。
- 如果只是计数器或统计日志(例如页面访问计数),D1 或 KV 更合适。
对象文件不进数据库
用户上传文件(uploads/2026/06/report.pdf)、生成结果、导出文件、图片不应该放进数据库 blob 字段。原因:
- 备份成本:数据库备份会包含所有 blob,备份时间和存储成本增加。
- 查询负担:把大对象和关系数据混在一行,会放大传输、缓存、备份和维护成本,也更容易让宽查询意外带回文件内容。
- CDN 加速:对象存储更容易接入 CDN、缓存策略和签名下载;数据库 blob 通常需要应用层转发。
- 出站成本:从数据库读取 blob 会占用数据库与应用带宽;R2 直接向互联网传输时不收 R2 egress 费用,S3 则按对应区域和目的地计费。
正确做法:数据库只存对象 key(例如 uploads/2026/06/report.pdf),对象文件存进 R2/S3/Supabase Storage。
缓存和本地开发数据
缓存(cache:daily-stats、session、临时计算)的特征:
- 读写频繁,通常允许过期或重建;登录 session 等安全状态仍要单独定义一致性、过期和撤销要求。
- 可重建缓存通常不需要进入业务数据库备份;安全 session、撤销记录等状态要按其风险单独设计持久化。
- 边缘访问时延迟敏感。
推荐:
- 边缘轻量缓存:Cloudflare KV 或 D1(Workers 原生访问)。
- 本地开发缓存:SQLite 文件或内存 cache。
本地开发数据(local-dev.sqlite)是单用户、无权限系统的场景:
- SQLite 官方定位:local data storage、应用文件、本地数据(SQLite When to use)。
- 不直接竞争 client/server DB:SQLite 强调 local、single-user,Postgres 强调 shared repository、multi-user。
边缘轻数据和备份
边缘轻数据(Workers 工具站计数器、配置表)优先 D1 或 KV:
- Workers 原生访问:HTTP API 或 Workers SDK 直接访问,无额外 latency。
- 轻关系数据:简单的表结构,不需要复杂 JOIN 或外键。
- 边缘读多:大部分查询是读取,写入较少。
备份(数据库备份文件、导出快照)需要零出站成本和本地副本:
- R2 free egress 降低备份下载成本。
- S3 提供合规能力(Object Lock、Glacier tier)和生命周期管理。
- 本地副本防止平台故障:例如 Cloudflare outage 时可以从本地 SQLite 恢复。
D1:Workers 原生的边缘数据库
D1 是 Cloudflare managed serverless database,具备 SQLite SQL semantics(D1 overview)。核心特性:
- Time Travel:Workers Free 可恢复到最近 7 天内的任一分钟,Workers Paid 为 30 天;恢复会原地覆盖数据库,操作前要确认目标时间点。
- read replication:降低读延迟和扩展读吞吐,适合边缘读多场景。
- Workers/HTTP API access:Workers SDK 或 HTTP API 直接访问,无需额外数据库连接池。
- built-in disaster recovery:Cloudflare 自动处理数据库故障和备份。
适用场景:Workers 原生和边缘读多
D1 适合以下场景:
- Workers/Pages 原生项目:已经在 Cloudflare Workers 或 Pages 上部署,D1 是原生边缘数据库,无需跨平台访问。
- 轻关系数据:简单的表结构(例如配置表、计数器、域名映射),不需要复杂 JOIN 或外键。
- 边缘读多写少:大部分查询是读取,写入较少;read replication 可以扩展读吞吐。
- Cloudflare 生态优先:项目已经使用 Workers、R2、KV、Vectorize,D1 是数据库层补充。
不适合场景:
- 多用户 SaaS 需要权限系统(RLS):Supabase Postgres 更合适。
- 支付订单和订阅权益:需要成熟的约束、审计和可验证恢复流程,通常优先 Postgres;具体恢复窗口取决于所选托管方案和附加项。
- 审计追踪需求:Postgres 触发器和审计表更成熟。
rows read 计费机制:扫描行数而非返回行数
D1 按 rows read、rows written 和 storage 计费,这是和传统数据库不同的计费方式。rows read 计费方式:rows read 是查询扫描的行数,不是返回的行数。
截至 2026-06,D1 pricing 显示(价格易变,发布前复核):
| 项目 | Free 版 | Paid 版(Workers Paid) |
|---|---|---|
| rows read/day | 5M | 包含 25B/month |
| rows written/day | 100k | 包含 50M/month |
| storage | 5GB total | 5GB included,超额 $0.75/GB-month |
| rows read 超额计费 | - | $0.001/million rows read |
| rows written 超额计费 | - | $1/million rows written |
| egress/bandwidth | 无额外 charge | 无额外 charge |
rows read 计费陷阱:一个工具站 SELECT * FROM orders WHERE user_id = X LIMIT 20,如果没有在 user_id 上创建索引,D1 会扫描全表(例如 50K 行)来找到 20 行返回。rows read = 50K,而不是 20。
一个未索引过滤即使只返回少量结果,也可能扫描整张表;实际消耗应查看每次查询返回的 meta.rows_read,不要用返回条数推算。
索引设计和查询效率
解决 rows read 陷阱的方法:
- 创建索引:
CREATE INDEX idx_user_id ON orders(user_id);让 D1 只扫描满足索引条件的子集,具体 rows read 以每次查询返回的meta.rows_read为准。 - 缩小查询范围:只取需要的列有利于减少返回载荷和意外耦合,但 D1 的 rows read 按扫描行数计数,列数不会改变行数计费;降低 rows read 的关键仍是索引和过滤条件。
- 监控
rows_read与返回结果的比例:D1 会在查询meta和控制台指标中提供 rows read / written,可自行计算查询效率,定位全表扫描。
索引设计建议:
- 在 WHERE 条件列上创建索引(例如 user_id、created_at)。
- 在 JOIN 条件列上创建索引(例如 order_id、product_id)。
- 避免过多索引:索引会增加 rows written(每次 INSERT/UPDATE 都需要更新索引)。
- 定期审查慢查询:D1 console 会显示 rows read 较高的查询。
D1 免费额度和成本判断
D1 Free 版的限制:
- 5M rows read/day:如果一个查询平均 rows read = 50K,每天只能执行 100 次。
- 100k rows written/day:写入密集场景会快速消耗额度。
- 5GB storage:业务事实数据量较大时会接近上限。
何时升级 Paid 版:
- rows read/day 接近或超过 5M:Free 达到日限额后查询会报错;Paid 改为每月包含 25B rows read,超额计费。
- rows written/day 超过 100k:Paid 包含 50M/month。
- storage 超过 5GB:超额按 $0.75/GB-month 计费。
D1 适合边缘轻数据,不适合高频写入或大存储场景。如果你的工具站数据量增长快,需要监控 rows read/written 和 storage 使用率。
Supabase Postgres:BaaS 默认选择
Supabase 不是 Postgres abstraction,每个 project 是完整的 Postgres database(Supabase Database 官方文档)。Auth、Storage、Realtime、Edge Functions 都建在数据库之上,这意味着你可以用完整的 Postgres 能力:复杂查询、外键、触发器、事务、MVCC、extensions。
RLS:让数据库可从 client 安全查询
Supabase Postgres 的核心能力是 RLS(Row Level Security)。传统做法是数据库只允许 server 访问,client 通过 API server 间接查询。RLS 让数据库直接处理权限逻辑,client 可以安全查询,权限控制、审计追踪和 API 代码减少都在数据库层完成。
RLS 的作用:
- 权限控制:定义 policy 让 user_id = current_user_id 的行可以被查询,其他行不可见。
- 审计追踪:RLS 负责访问边界;若要追踪谁在何时做了什么,还需要单独的审计表、触发器或日志方案。
- 减少重复权限代码:权限规则可下沉到数据库层,但服务端仍需验证身份、控制密钥并审查高权限操作。
适用场景:业务事实、权限强相关、多用户 SaaS、支付订单、订阅权益。这些数据需要权限控制和审计追踪,RLS 是原生解决方案。
备份和恢复
截至 2026-07,Supabase 官方当前口径如下(价格和方案易变,发布前仍应复核):
| 项目 | Free 版 | Pro 版 | Team 版 |
|---|---|---|---|
| database size | 每项目含 500MB | 每项目含 8GB,超额计费 | 每项目含 8GB,超额计费 |
| price | $0 | $25/month | $599/month |
| automatic backups | 不包含 | 日备份,保留 7 天 | 日备份,保留 14 天 |
| PITR | 不包含 | 付费附加项,7 天保留从约 $100/month 起 | 付费附加项,7 天保留从约 $100/month 起 |
这意味着:
- Free 项目不能把平台自动备份当成恢复方案,应定期用
supabase db dump或pg_dump导出并保留异地副本。 - Pro 和 Team 提供日备份,但日备份最多仍可能损失一天内的变更。
- PITR 不是 Pro 默认包含项;它需要至少 Small compute,并按 7、14 或 28 天保留窗口另行计费。
是否升级不能只看数据库容量。订单、订阅权益等业务事实更需要先定义恢复点目标、恢复时间目标和演练频率,再决定日备份是否足够、是否需要 PITR。
与 D1 的对比:权限和备份差异
| 项目 | D1 | Supabase Postgres |
|---|---|---|
| 定位 | Workers 原生边缘数据库 | BaaS 默认 Postgres |
| 权限控制 | 无原生 RLS | RLS 让数据库可从 client 安全查询 |
| 备份 | Time Travel:Free 7 天、Paid 30 天 | Pro/Team/Enterprise 日备份;PITR 为付费附加项 |
| 适用场景 | 边缘轻数据、Workers 原生 | 业务事实、多用户 SaaS、支付订单、订阅权益 |
| 计费 | rows read/written + storage | database storage + MAU |
组合使用场景:
- D1 做边缘读多缓存:配置表、计数器、域名映射。
- Supabase Postgres 做业务事实:users 表、orders 订单、订阅权益、支付记录。
例如:一个 SaaS 工具站,Workers 原生访问 D1 存配置和计数器,Supabase Postgres 存用户和订阅权益。D1 边缘低延迟,Postgres 权限和备份能力完整。
R2:零出站成本的对象存储
R2 是 Cloudflare 的 S3-compatible object storage,主要优势是直接从 R2、Workers API、S3 API 或 r2.dev 域名向互联网传输时不收 R2 egress 费用(R2 pricing)。连接其他计量服务时仍可能产生服务侧费用。R2 适合用户上传文件、生成结果和导出文件,但“免出站费”不等于存储与操作都免费。
Class A/B Operations 计费机制
R2 按 storage、Class A operations、Class B operations 计费,这是和传统对象存储不同的计费方式。
截至 2026-06,R2 pricing 显示(价格易变,发布前复核):
| 项目 | Free 版 | Standard storage | Infrequent Access |
|---|---|---|---|
| storage | 10GB-month/month | $0.015/GB-month | $0.01/GB-month |
| Class A Operations | 1M/month | $4.50/million | $9.00/million |
| Class B Operations | 10M/month | $0.36/million | $0.90/million |
| Data Retrieval | None | None | $0.01/GB |
| Egress (Internet) | Free | Free | Free |
| Minimum storage duration | None | None | 30 days |
Class A/B Operations 说明(R2 pricing):

- Class A(昂贵):PutObject、CopyObject、ListObjects、LifecycleStorageTierTransition 等。写入操作和列表操作属于 Class A,单价 $4.50/million(Standard)。
- Class B(便宜):GetObject、HeadObject、HeadBucket 等。读取操作属于 Class B,单价 $0.36/million(Standard)。
- 免费操作:DeleteObject、DeleteBucket、AbortMultipartUpload。
R2 免费额度误解
常见错误:10GB-month free ≠ 无限存储。
- storage quota:10GB-month 是存储空间限制,不是流量限制。如果你的文件总量超过 10GB,需要升级 Paid 或清理旧文件。
- Class A Operations quota:1M/month 是写入操作限制,如果一个工具站每天上传 1000 个文件,一个月消耗 30K Class A operations,还在免费额度内;但如果批量写入(例如每天上传 10K 文件),会快速消耗额度。
- Class B Operations quota:10M/month 是读取操作限制,如果一个图片 CDN 每天访问 100K 次,一个月消耗 3M Class B operations,还在免费额度内;但如果高频访问(例如每天 1M 次),会超出额度。
Infrequent Access 的 minimum storage duration:30 days minimum storage duration 意味着你不能在 30 天内删除文件,否则仍需要支付 30 天的存储费用。这个限制适合备份和长期存储,不适合临时文件。
适用场景:用户上传文件和生成结果
R2 适合以下场景:
- 用户上传文件:uploads/2026/06/report.pdf、图片、文档。零出站成本降低 CDN 和下载费用。
- 生成结果:导出文件、报告、图片处理结果。频繁下载场景,R2 free egress 是主要优势。
- 备份:数据库备份文件、导出快照。备份下载需要零出站成本。
- Cloudflare 生态优先:项目已经使用 Workers、D1、KV、Vectorize,R2 是对象存储层补充。
不适合场景:
- 业务事实数据(users、orders):需要结构化查询和权限控制,对象存储无法提供。
- 需要 S3 Object Lock、更多存储层级或跨桶/跨区域复制等 AWS 原生治理能力时,S3 更合适。
R2 vs S3 对比
| 项目 | R2 | S3 |
|---|---|---|
| egress (Internet) | R2 侧免费;其他计量服务可能收费 | 按区域、目的地和用量计费,需查对应 AWS 价格表 |
| storage | $0.015/GB-month | 多 tier(Standard、Glacier、Deep Archive) |
| 生态 | Cloudflare Workers/Pages 原生 | AWS Lambda triggers、成熟生态 |
| 治理能力 | 生命周期、Standard/IA、Queues 事件通知;功能范围较聚焦 | Object Lock、多种 Glacier 存储类、生命周期管理、Replication 与多种事件目标 |
| 适用场景 | Cloudflare 生态、出站成本敏感 | AWS 生态、合规需求、数据湖、企业应用 |
何时选择 R2:
- 出站成本敏感:用户上传文件和生成结果频繁下载,R2 free egress 降低成本。
- Cloudflare 生态:Workers/Pages 原生访问,无需跨平台 latency。
何时选择 S3:
- AWS 生态优先:Lambda triggers、数据湖、企业应用需要 S3 集成。
- 治理需求:Object Lock、更多 Glacier 存储类、跨区域复制和 AWS 原生权限体系。
- 成熟生态:AWS 工具链(CloudWatch、IAM、S3 Select、S3 Batch Operations)更完整。
R2 和 S3 不是完全替代关系。如果你的项目已经使用 Cloudflare Workers/Pages,R2 是对象存储的默认选择;如果需要 AWS 生态和合规能力,S3 更合适。组合使用场景:R2 存 CDN 文件和生成结果,S3 存备份和合规数据。
S3:AWS 生态和合规需求
S3 是 AWS object storage service,用于 data lakes、websites、mobile apps、backup/restore、archive、enterprise apps、IoT、big data analytics(Amazon S3 user guide)。核心特性:
- storage classes:Standard、Glacier、Glacier Deep Archive、Intelligent-Tiering 等多种存储 tier,适合不同访问频率和成本需求。
- lifecycle:自动迁移旧文件到 Glacier 或删除过期文件,降低存储成本。
- Object Lock:WORM(Write Once Read Many)模式,合规场景防止文件被修改或删除。
- Replication:跨区域复制,灾难恢复和低延迟访问。
- IAM/bucket policies:细粒度权限控制,Block Public Access 防止意外公开。
- Lambda triggers:文件上传触发 Lambda 函数,自动化处理。
适用场景:AWS 生态和合规需求
S3 适合以下场景:
- AWS 生态优先:项目已经使用 Lambda、EC2、RDS、DynamoDB,S3 是对象存储层补充。
- 合规需求:Object Lock、Glacier tier、SOC2 compliance、GDPR 合规。
- 数据湖:大数据分析和 IoT 数据存储,需要 S3 Select 和 S3 Batch Operations。
- 企业应用:备份/restore、archive、长期存储,需要生命周期管理。
不适合场景:
- 出站成本敏感:用户上传文件频繁下载时,S3 费用取决于区域、目的地、缓存和用量,需要用当前 AWS 价格表估算。
- Cloudflare 生态优先:Workers/Pages 原生访问 R2 更方便。
S3 vs R2:成熟生态和合规能力
S3 的优势是成熟生态和合规能力:
- 事件目标:S3 Event Notifications 可发送到 SNS、SQS、Lambda 和 EventBridge;R2 也支持把对象创建/删除事件发送到 Cloudflare Queues,再由 Worker 或 HTTP pull 消费。
- 存储层级:S3 提供多种 Glacier 归档类;R2 当前主要是 Standard 和 Infrequent Access。
- Object Lock:S3 可用 WORM 模式防止对象在保留期内被覆盖或删除。
- Replication:S3 提供同区域或跨区域的桶级复制,并可复制对象元数据和标签。
何时选择 S3:
- AWS 生态优先:Lambda triggers、数据湖、企业应用需要 S3 集成。
- 合规需求:Object Lock、Glacier tier、生命周期管理。
- 长期存储:Glacier 和 Glacier Deep Archive 成本更低。
何时选择 R2:
- 出站成本敏感:用户上传文件频繁下载。
- Cloudflare 生态:Workers/Pages 原生访问。
组合使用场景:R2 存 CDN 文件和生成结果,S3 存备份和合规数据。一个项目可以同时使用两种对象存储,根据数据类型和访问模式选择。
SQLite:本地和嵌入式优先
SQLite 是 local data storage、应用文件、本地数据、低中流量网站、数据分析、缓存的选择(SQLite When to use)。官方定位:SQLite 不直接和 client/server SQL DB 竞争;client/server DB 强调 shared repository、scalability、concurrency、centralization、control;SQLite 强调 local、single-user、copy a file and run。
适用场景:单用户工具和本地后台
SQLite 适合以下场景:
- 单用户工具:本地后台、数据分析工具、小游戏、单文件数据。
- 应用文件:例如 CAD 软件、财务软件、媒体管理工具,数据文件和应用文件一起分发。
- 低中流量网站:SQLite 官方提到 “fewer than 100K hits/day” 通常 fine(SQLite When to use),但这是保守估计,不作为本站性能承诺。实际承载能力取决于硬件、查询复杂度和并发写入。
- 本地开发数据:local-dev.sqlite 测试数据,单用户、无权限系统。
- 缓存和临时数据:session、临时计算结果,无需持久化。
不适合场景:
- 多用户 SaaS:需要权限系统、并发写入、审计追踪,Postgres 更合适。
- 支付订单和订阅权益:需要备份和 PITR,Postgres 时间窗口更长。
- 高并发写入:SQLite 是单写入者多读取者,写入并发受限。
SQLite vs Postgres 判断:何时切换
| 项目 | SQLite | Postgres |
|---|---|---|
| 定位 | local data storage、应用文件 | shared repository、client/server DB |
| 适用 | 单用户工具、小游戏、本地后台 | 多用户 SaaS、支付订单、订阅权益 |
| 并发 | 单写入者,多读取者 | 多写入者,MVCC |
| 权限 | 无用户管理 | RLS、用户/角色管理 |
| 成本 | 无独立数据库服务器成本 | 取决于自托管或托管方案、计算和备份配置 |
何时从 SQLite 切换到 Postgres(SQLite When to use + 社区实践):
- 用户数增长:从单用户工具变成多用户 SaaS,需要权限系统。
- 并发写入需求:多个用户同时修改数据,SQLite 单写入者会成为瓶颈。
- 支付需求:支付订单和订阅权益需要备份和审计追踪。
- 权限系统:users/roles/permissions 需要数据库层权限控制。
判断边界:如果一个工具站是单用户后台(例如你自己的数据分析工具),SQLite 是合适选择;如果变成多用户 SaaS(例如多个客户付费使用),需要切换到 Postgres。
SQLite 不是 Postgres 替代品
SQLite 官方定位明确:SQLite 不直接竞争 client/server SQL DB(SQLite When to use)。这意味着:
- SQLite 强调 local、single-user、simplicity、copy a file and run、删除摩擦小。
- Postgres 强调 shared repository、multi-user、concurrent state mutations、takes payments。
成本差异:SQLite 本身不需要独立数据库服务器,本地文件即可运行;Postgres 的成本取决于自托管或托管方案、计算规格、存储和备份配置。两者都需要可验证的备份与恢复设计。
何时选择 SQLite:
- 本地工具和小游戏:单用户、无支付、无权限系统。
- 本地开发数据:测试数据和临时文件。
- 低中流量网站:个人博客、文档站、低并发写入。
何时选择 Postgres:
- 多用户 SaaS:支付订单、订阅权益、权限系统。
- 审计需求:操作记录和权益变更需要追踪。
- 备份和 PITR:业务事实数据需要时间点恢复。
组合使用场景:本地开发用 SQLite 测试,生产环境用 Postgres;SQLite 做缓存和临时数据,Postgres 做业务事实。一个项目可以同时使用两种数据库,根据数据类型和访问模式选择。
常见错误警示
数据选型有三个常见错误:把业务事实塞对象存储、rows read 计费陷阱、R2 免费额度误解。这些错误会导致备份困难、查询变慢、成本失控。
错误1:把业务事实塞对象存储
users 表、orders 订单、usage_events 日志不应该放进 R2/S3。对象存储缺少结构化查询、关联查询、权限控制和审计追踪能力。
具体后果:
- 无法 SELECT 和 JOIN:对象存储是 key-value 访问,无法执行 SELECT * FROM orders WHERE user_id = X LIMIT 20 或 JOIN users ON orders.user_id = users.id。如果需要查询订单,需要把所有订单文件下载到本地处理。
- 备份困难:对象存储的备份是文件列表,无法按时间范围恢复(例如恢复最近 7 天的订单)。数据库备份是 SQL dump,可以按时间范围恢复。
- 导出变慢:导出所有订单需要遍历所有对象文件,时间和带宽成本增加。数据库导出是 SQL query,可以按条件导出。
正确做法:数据库存业务事实(users、orders、订阅权益),对象存储存文件(uploads/2026/06/report.pdf、图片、备份)。数据库只存对象 key,对象文件存进 R2/S3/Supabase Storage。
错误2:rows read 计费陷阱
D1 的 rows read 计费是扫描行数,不是返回行数。无索引的 SELECT * 会导致 rows read 远大于返回行数,成本失控。
例如一个 50,000 行的 orders 表执行 SELECT * FROM orders WHERE user_id = ? LIMIT 20,如果 user_id 没有索引,D1 可能需要扫描大量行才能返回 20 行;实际消耗应以查询 meta.rows_read 为准。Free 达到 5M rows read 日限额后,查询会报错,Paid 超过月包含量则按量计费。
解决方案:
- 在真实过滤列上建立索引,例如
CREATE INDEX idx_user_id ON orders(user_id);。 - 用
EXPLAIN QUERY PLAN和meta.rows_read检查查询是否仍在全表扫描。 - 只查询需要的列以控制载荷,但不要误以为列数会改变 rows read;D1 按扫描行数计数。
错误3:R2 免费额度误解
R2 Free 版的 10GB-month storage、1M Class A operations、10M Class B operations 不是无限使用。
具体误解:
- 10GB-month ≠ 无限存储:storage quota 是空间限制,不是流量限制。如果你的文件总量超过 10GB,需要升级 Paid 或清理旧文件。
- Class A operations ≠ 无限写入:PutObject 是 Class A operation,单价 $4.50/million(Standard)。如果一个工具站每天上传 10K 文件,一个月消耗 300K Class A operations,还在免费额度内;但如果批量写入(例如每天上传 100K 文件),会快速消耗额度。
- Infrequent Access 30 days minimum:你不能在 30 天内删除文件,否则仍需要支付 30 天的存储费用。这个限制适合备份和长期存储,不适合临时文件。
正确做法:监控 storage、Class A/B operations 使用率,定期清理旧文件,避免批量写入消耗 Class A quota。如果需要临时文件存储,用本地 SQLite 或 KV 缓存,不要用 R2 Infrequent Access。
结论
一人公司项目的数据选型,判断依据是数据类型:业务事实、事件日志、对象文件、缓存、本地开发数据、边缘轻数据、备份。业务事实优先 Supabase Postgres(RLS、关系约束、可配置备份与审计),边缘轻数据优先 D1(Workers 原生、边缘读多),对象文件优先 R2/S3(零出站成本或合规需求),本地开发数据优先 SQLite(单用户、无权限系统)。
核心行动建议:
- 根据数据类型选择存储:参考数据类型决策表,判断每类数据的查询需求、权限控制、访问频率、成本敏感度。
- 索引设计降低成本:D1 rows read 是扫描行数,创建索引可以减少 rows read,避免成本失控。
- 避免常见错误:业务事实不塞对象存储、SELECT * 无索引、R2 免费额度误解。
后续会单独写支付方案和用户系统,这两篇文章会影响数据库选择:支付订单数据优先 Postgres(关系约束、备份和审计),用户权益和权限数据优先 Postgres(RLS 与可验证恢复)。如果你已经在规划支付和用户系统,可以提前考虑数据库选型。
如果你不确定某个数据对象应该放进哪个存储,可以参考数据类型决策表或系列上游文章(技术栈设计原则、后端技术栈、部署方案),建立整体技术架构后再细化存储选择。
为一人公司项目分配数据存储
从数据盘点到恢复演练,用六步确定数据库和对象存储边界。
- 1
步骤 1: 列出数据对象
把 users、orders、usage_events、uploads、cache、本地文件和备份逐项列出,不先按产品分组。 - 2
步骤 2: 标记数据类型
为每项标记业务事实、事件、对象文件、缓存、本地数据或备份,并注明是否允许过期或重建。 - 3
步骤 3: 写清一致性与权限
记录事务、约束、RLS、并发写入、审计和多实例共享需求,判断是否需要 Postgres 或 D1。 - 4
步骤 4: 估算访问与成本触发器
估算 D1 rows read/written、R2 Class A/B operations、对象容量、读取频率和潜在出站费用。 - 5
步骤 5: 设计稳定引用
数据库保存对象 key、owner、status 和 metadata,文件本体放对象存储,并保持 key 命名稳定。 - 6
步骤 6: 验证备份和迁移
设置导出、异地副本、删除窗口和恢复演练;迁移时先同步 metadata,再同步对象并切换读路径。
常见问题
一人公司数据库应该先选 D1 还是 Supabase Postgres?
R2 和 S3 适合放什么?
SQLite 能不能直接做第一个 SaaS?
用户上传文件能不能放数据库?
D1 的 rows read 计费是什么意思?
Cloudflare R2 免费额度够不够?
25 分钟阅读 · 发布于: 2026年10月9日


评论
使用 GitHub 账号登录后即可评论