1인 개발 데이터베이스 선택: D1, Postgres, R2, S3, SQLite
"Cloudflare D1 공식 가격 문서는 rows read/written, 저장 한도, 인덱스가 스캔 행 수에 미치는 영향, Free 일일 한도 도달 시 동작을 설명합니다."
프로젝트에는 users 테이블, orders, usage_events, uploads/2026/06/report.pdf의 사용자 업로드, cache:daily-stats 캐시, local-dev.sqlite 로컬 개발 데이터가 있습니다. 각각 어디에 둬야 할까요? 업무 사실을 오브젝트 스토리지의 파일로 만들면 백업, 쿼리, 내보내기가 금방 불편해집니다. D1에서 필터 열에 인덱스가 없으면 rows read 한도를 빠르게 소모하고 Paid에서는 초과 비용도 생길 수 있습니다. 따라서 제품명이 아니라 데이터 유형에서 시작해야 합니다.
데이터 배치표: 무엇을 어디에 저장할까
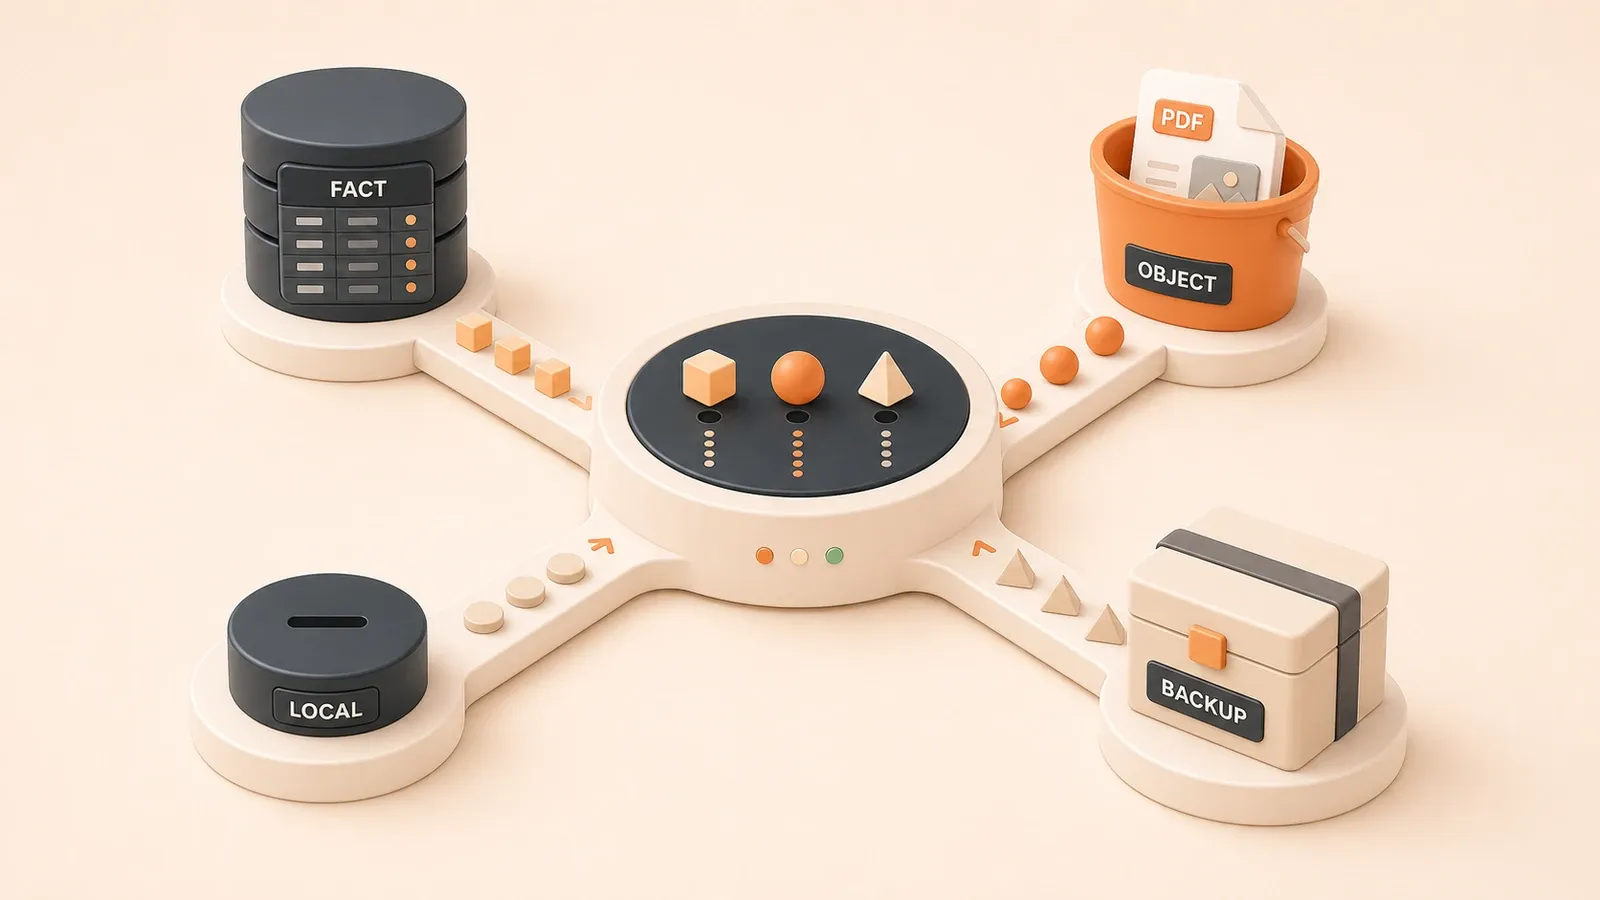
1인 프로젝트라도 오브젝트마다 필요한 저장소가 다릅니다. 업무 사실에는 쿼리, 관계, 접근 제어가 필요합니다. 이벤트 로그에는 안정적인 쓰기와 합리적인 보존 비용이 중요합니다. 오브젝트 파일에는 다운로드 권한, 수명 주기, 트래픽에 맞는 비용 모델이 필요합니다. 구조화 쿼리와 권한이 필요한지, 접근 빈도는 어떤지, egress 비용에 민감한지 확인합니다.
다음 표를 첫 판단 기준으로 사용할 수 있습니다.
일곱 가지 데이터 유형과 저장소
| 데이터 유형 | 구체적인 오브젝트 | 권장 저장소 | 판단 기준 |
|---|---|---|---|
| 업무 사실 | users, orders, 구독 권리, 결제 기록 | Supabase Postgres 우선, 단순한 경우 D1 | 구조화 쿼리(SELECT/JOIN), 권한(RLS), 요금제에 맞는 백업/시점 복구, 감사 가능성 |
| 이벤트 로그 | usage_events, 운영 기록, 접근 통계 | 엣지 쓰기는 D1, 감사 목적은 Postgres | 잦은 쓰기와 단순 쿼리. 일반 분석은 복구 우선순위를 낮출 수 있지만 보안/과금 이벤트는 안정적으로 보존 |
| 오브젝트 파일 | uploads/2026/06/report.pdf, 생성 결과, 내보내기, 이미지 | Cloudflare는 R2, AWS는 S3 또는 Supabase Storage | DB blob 금지. R2 egress, S3 생태계, Supabase Auth/Postgres 연동을 기준으로 선택 |
| 캐시 | cache:daily-stats, 단기 상태, 임시 계산 | Cloudflare KV, D1 또는 로컬 SQLite | 접근이 잦고 보통 만료/재생성 가능. 엣지는 KV/D1, 로컬은 SQLite |
| 로컬 개발 데이터 | local-dev.sqlite, 테스트 데이터, 1인 관리 도구 | SQLite 파일 | 단일 사용자, 권한 시스템 없음, 복사와 실행이 간단함 |
| 가벼운 엣지 데이터 | Workers 카운터, 설정 테이블, 도메인 매핑 | D1 또는 Cloudflare KV | Workers 네이티브 접근, 단순한 관계, 읽기 중심 |
| 백업 | 데이터베이스 dump, 내보내기 snapshot | R2/S3와 로컬 사본 | R2 egress 모델, S3 governance/lifecycle, 공급자 장애에 대비한 독립 사본 |
업무 사실을 Postgres에서 시작하는 이유
사용자, 주문, 구독 권리, 결제는 핵심 기록입니다. 잃으면 고객 접근과 매출이 바뀝니다. 다음 기능이 필요합니다.
- 구조화 쿼리: 관계형 데이터베이스는 SELECT, JOIN, WHERE, ORDER BY를 처리하지만 오브젝트 스토리지는 그렇지 않습니다.
- 접근 제어: Supabase Postgres는 Row Level Security로 client 쿼리를 제어할 수 있습니다. D1에는 현재 네이티브 RLS가 없습니다.
- 백업과 복구: Supabase Pro, Team, Enterprise는 일일 백업을 제공합니다. PITR은 별도로 활성화하는 유료 add-on입니다. D1 Time Travel은 Workers Free 7일, Paid 30일을 보존합니다.
- 감사 추적: 결제와 권리 변경은 Postgres trigger와 별도 감사 테이블로 구현하기 쉽습니다.
Supabase Postgres는 제한된 Postgres 추상화가 아닙니다. 각 project에 완전한 Postgres database가 있고 Auth, Storage, Realtime, Edge Functions가 그 위에 구축됩니다(Supabase Database 공식 문서). 일반 Postgres 기능을 유지합니다.
이벤트와 업무 레코드 분리하기
usage_events, 운영 동작, 접근 통계는 다르게 작동합니다.
- 쓰기가 잦고 일반적인 쿼리는 기간 필터와 집계입니다.
- 감사 대상이 아닌 분석 이벤트는 복구 우선순위를 낮출 수 있지만 보존 기간과 손실 허용 정책이 필요합니다. 보안, 과금, 권리 이벤트는 일반 page view처럼 다룰 수 없습니다.
- 잦은 쓰기는 rows written과 storage quota를 소모합니다.
경계는 명확합니다.
user_id와action이 연결된 감사 기록이면 Postgres를 사용합니다.- 단순 카운터나 재생성 가능한 분석 신호라면 D1 또는 KV를 사용할 수 있습니다.
오브젝트 파일을 데이터베이스에 넣지 않기
업로드, 생성 결과, 내보내기 파일, 이미지는 데이터베이스 blob 열에 두지 않는 편이 좋습니다.
- 백업 비용: 모든 blob이 데이터베이스 백업에 포함되어 시간과 용량이 늘어납니다.
- 쿼리 부담: 큰 오브젝트와 관계형 행을 섞으면 전송, 캐시, 백업, 유지 관리 비용이 커지고 넓은 쿼리가 파일 본문을 실수로 반환하기 쉽습니다.
- CDN 배포: 오브젝트 스토리지는 CDN, cache policy, signed download와 연결하기 쉽지만 DB blob은 보통 application proxy가 필요합니다.
- Egress: blob 제공은 DB와 애플리케이션 대역폭을 사용합니다. R2에서 Internet으로 직접 전송하면 R2 egress 비용이 없고 S3는 region과 destination에 따라 달라집니다.
데이터베이스에는 uploads/2026/06/report.pdf 같은 object key만 저장합니다. 파일은 R2, S3 또는 Supabase Storage에 둡니다.
캐시와 로컬 개발 데이터
cache:daily-stats, 단기 상태, 임시 계산에는 보통 다음 특징이 있습니다.
- 읽고 쓰는 빈도가 높지만 일반적으로 만료하거나 재생성할 수 있습니다. 보안 관련 session은 일관성, 만료, 폐기 규칙을 따로 정의합니다.
- 재생성 가능한 캐시는 보통 업무 DB 백업에 들어갈 필요가 없습니다. session 폐기 기록 같은 보안 상태는 별도 영속성 정책이 필요합니다.
- 엣지 접근은 latency에 민감합니다.
실용적인 선택입니다.
- Workers의 가벼운 엣지 cache는 Cloudflare KV 또는 D1을 사용합니다.
- 로컬 개발은 SQLite 파일 또는 memory cache를 사용합니다.
local-dev.sqlite는 권한 시스템 없는 단일 사용자 용도입니다.
- SQLite는 local application data와 application file에 맞습니다(SQLite 사용 시점).
- client/server database와 같은 문제를 해결하지 않습니다. SQLite는 local/single-user, Postgres는 shared/multi-user를 중시합니다.
가벼운 엣지 데이터와 백업
Workers 카운터, 작은 설정 테이블, 도메인 매핑에는 D1 또는 KV가 좋은 시작점입니다.
- 네이티브 접근: 별도 connection pool 없이 Worker binding 또는 HTTP API를 사용합니다.
- 가벼운 관계: 복잡한 JOIN이나 큰 foreign-key graph에 의존하지 않는 단순 schema입니다.
- 읽기 중심: 쓰기보다 읽기가 훨씬 많습니다.
백업 내보내기에는 저렴한 회수와 독립 사본이 필요합니다.
- R2에서 Internet으로 직접 다운로드하면 R2 egress 비용이 없습니다.
- S3는 Object Lock, 여러 archive class, lifecycle management를 제공합니다.
- 로컬 또는 두 번째 공급자의 사본은 account/provider 장애를 방어합니다. 유일한 restore 사본을 production 옆에만 두면 안 됩니다.
D1: Workers 네이티브 serverless database
D1은 SQLite SQL semantics를 제공하는 Cloudflare의 managed serverless database입니다(D1 개요). 핵심 기능은 다음과 같습니다.
- Time Travel: Workers Free는 최근 7일, Paid는 30일 안의 임의 시점으로 복구합니다. 복구는 데이터베이스를 덮어쓰므로 목표 시간을 확인합니다.
- Read replication: 읽기 latency를 낮추고 read-heavy workload의 처리량을 확장합니다.
- Workers/HTTP API 접근: 자체 DB connection pool 없이 binding 또는 HTTP API를 사용합니다.
- Built-in disaster recovery: Cloudflare가 DB history와 recovery system을 관리합니다.
적합한 경우: Workers 네이티브와 읽기 중심 앱
D1은 다음에 맞습니다.
- 쿼리마다 다른 platform을 거치지 않으려는 Workers 또는 Pages 프로젝트.
- 설정, 카운터, 도메인 매핑처럼 복잡한 관계망이 없는 가벼운 관계형 데이터.
- read replication으로 읽기를 확장할 수 있는 read-heavy workload.
- Workers, R2, KV, Vectorize를 이미 사용하고 같은 ecosystem에 relational layer가 필요한 프로젝트.
D1이 덜 맞는 경우입니다.
- 성숙한 권한 시스템과 RLS가 필요한 multi-user SaaS.
- constraint, 감사, 검증된 restore가 필요한 주문과 구독 권리. 보통 Postgres가 더 안전한 시작점이며 복구 기간은 managed plan과 add-on에 따라 달라집니다.
- Postgres trigger와 audit pattern을 활용하는 감사 중심 시스템.
rows read 과금: 반환 행이 아니라 스캔 행
D1은 rows read, rows written, storage로 과금합니다. rows read는 쿼리가 반환한 행이 아니라 스캔한 행입니다.
2026년 7월 기준 공식 가격 페이지의 한도와 요금은 다음과 같습니다. 공개하거나 큰 아키텍처 결정을 내리기 전에 다시 확인해야 합니다.
| 항목 | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/day | 첫 25B/month 포함 |
| Rows written | 100K/day | 첫 50M/month 포함 |
| Storage | 총 5 GB | 첫 5 GB 포함, 이후 $0.75/GB-month |
| Rows read 초과 | 사용 불가 | $0.001/million rows read |
| Rows written 초과 | 사용 불가 | $1/million rows written |
| Egress/bandwidth | 별도 비용 없음 | 별도 비용 없음 |
50,000행의 orders에서 user_id 인덱스 없이 SELECT * FROM orders WHERE user_id = ? LIMIT 20을 실행하면 20행을 반환하려고 테이블 대부분을 읽을 수 있습니다. rows read는 20보다 50,000에 가까워집니다.
인덱스 없는 필터는 결과가 적어도 테이블 전체를 스캔할 수 있습니다. 결과 수로 추정하지 말고 실제 쿼리의 meta.rows_read를 확인합니다.
인덱스 설계와 쿼리 효율
rows read를 제어하는 방법입니다.
CREATE INDEX idx_user_id ON orders(user_id);같은 인덱스를 만들어 D1이 해당 subset만 읽게 합니다. 실제 값은meta.rows_read로 확인합니다.- 필요한 열만 선택해 response payload와 결합을 줄입니다. 하지만 D1은 열 수가 아니라 스캔 행을 셉니다. rows read를 줄이는 핵심은 인덱스와 필터입니다.
rows_read와 반환 행을 비교합니다. 쿼리meta와 dashboard가 rows read/written을 제공하므로 full-table scan을 찾을 수 있습니다.
인덱스 설계 원칙입니다.
user_id,created_at처럼 WHERE에 쓰는 열을 인덱싱합니다.order_id,product_id같은 JOIN key를 인덱싱합니다.- 불필요한 인덱스는 피합니다. INSERT/UPDATE가 index row도 쓸 수 있습니다.
- D1 dashboard에서 rows read가 비정상적으로 높은 쿼리를 정기적으로 확인합니다.
D1 무료 한도와 업그레이드 신호
Workers Free의 현재 D1 한도입니다.
- 하루 5M rows read. 평균 50K rows read인 쿼리는 일일 한도까지 약 100회입니다.
- 하루 100K rows written. 쓰기 중심 workload는 빠르게 소모합니다.
- 계정 전체 5 GB storage입니다.
Workers Paid를 검토할 시점입니다.
- 일일 rows read가 5M에 가까워집니다. Free 쿼리는 한도 이후 실패하고 Paid는 월 25B를 포함한 뒤 초과 과금합니다.
- 일일 rows written이 100K에 가까워집니다. Paid는 월 50M을 포함합니다.
- storage가 5 GB를 넘습니다. Paid 초과는 $0.75/GB-month입니다.
D1은 Workers 가까이의 가벼운 관계형 데이터에 강하고 모든 쓰기 중심 또는 대용량 workload의 기본값은 아닙니다. rows read, rows written, storage를 모니터링합니다.
Supabase Postgres: 실용적인 BaaS 기본 선택
각 Supabase project는 제한된 추상화가 아니라 완전한 Postgres database를 제공합니다(Supabase Database 공식 문서). Auth, Storage, Realtime, Edge Functions가 이를 기반으로 하며 복잡한 쿼리, foreign key, trigger, transaction, MVCC, extension을 사용할 수 있습니다.
RLS로 client 접근 제어하기
Row Level Security는 Supabase Postgres의 핵심 장점입니다. 전통적인 구조는 server만 데이터베이스에 접근하고 client는 API를 사용합니다. policy와 key를 올바르게 설정하면 RLS가 client 쿼리에 행 단위 권한을 적용합니다.
RLS의 역할입니다.
- 접근 제어: 인증 사용자와
user_id가 일치하는 행만 보여 주는 policy를 정의할 수 있습니다. - 감사 설계: RLS는 접근 경계를 정합니다. 누가 언제 무엇을 했는지는 audit table, trigger, logging system으로 별도 기록합니다.
- 중복 권한 코드 감소: 규칙을 DB에 둘 수 있지만 server는 identity 검증, privileged key 보호, 고권한 작업 검토를 계속합니다.
업무 사실, 권한 중심 앱, multi-user SaaS, 주문, 구독 권리에 맞습니다. RLS는 DB 경계이며 schema나 감사 설계를 대체하지 않습니다.
백업과 복구
2026년 7월 기준 Supabase 공식 플랜입니다.
| 항목 | Free | Pro | Team |
|---|---|---|---|
| Database size | project당 500 MB 포함 | project당 8 GB 포함, 이후 초과 | project당 8 GB 포함, 이후 초과 |
| Price | $0 | $25/month | $599/month |
| Automatic backups | 미포함 | 일일, 7일 보존 | 일일, 14일 보존 |
| PITR | 미포함 | 유료 add-on, 7일 보존 약 $100/month부터 | 유료 add-on, 7일 보존 약 $100/month부터 |
실무상 세 가지 의미가 있습니다.
- Free project는 platform backup을 복구 계획으로 볼 수 없습니다.
supabase db dump또는pg_dump를 정기 실행하고 외부 사본을 보관합니다. - Pro와 Team은 일일 백업이 있지만 마지막 백업 뒤 변경분을 잃을 수 있습니다.
- PITR은 Pro 기본 기능이 아닙니다. 최소 Small compute가 필요하고 7, 14, 28일 보존 기간별로 별도 과금합니다.
데이터베이스 크기만 보고 upgrade하지 않습니다. 주문과 권리는 RPO, RTO, 복구 훈련 빈도를 먼저 정한 뒤 일일 백업과 PITR 중 선택합니다.
D1과 Supabase 비교: 권한과 복구
| 항목 | D1 | Supabase Postgres |
|---|---|---|
| 포지션 | Workers 네이티브 serverless database | Managed Postgres BaaS |
| 접근 제어 | 네이티브 RLS 없음 | RLS로 client 쿼리 제어 |
| 복구 | Time Travel: Free 7일, Paid 30일 | Pro/Team/Enterprise 일일 backup, PITR은 유료 add-on |
| 적합한 용도 | Workers의 가벼운 관계형 데이터 | 업무 사실, multi-user SaaS, 주문, 권리 |
| 과금 | rows read/written과 storage | database storage, compute, plan usage |
함께 사용할 수도 있습니다.
- D1에 읽기 중심 엣지 설정, 카운터, 도메인 매핑을 둡니다.
- Supabase Postgres에 사용자, 주문, 구독 권리, 결제 기록을 둡니다.
SaaS 도구의 설정과 카운터는 D1, 사용자와 권리는 Postgres에 둘 수 있습니다. D1은 Workers에 가깝고 Postgres는 성숙한 권한, constraint, 복구 수단을 제공합니다.
R2: R2 egress 비용이 없는 오브젝트 스토리지
R2는 Cloudflare의 S3-compatible object storage입니다. R2, Workers API, S3 API, r2.dev에서 Internet으로 직접 전송하면 R2 egress 비용이 없습니다(R2 가격). 연결한 다른 metered service는 과금할 수 있습니다. 업로드, 생성 결과, 내보내기에 맞지만 egress 무료가 storage와 operation까지 무료라는 뜻은 아닙니다.
Class A/B Operations 과금
R2는 storage, Class A operations, Class B operations로 과금합니다. Infrequent Access는 retrieval fee도 있습니다.
2026년 7월 기준 가격입니다.
| 항목 | Free tier | Standard | Infrequent Access |
|---|---|---|---|
| Storage | 10 GB-month/month | $0.015/GB-month | $0.01/GB-month |
| Class A operations | 1M/month | $4.50/million | $9.00/million |
| Class B operations | 10M/month | $0.36/million | $0.90/million |
| Data retrieval | 없음 | 없음 | $0.01/GB |
| Internet egress | Free | Free | Free |
| Minimum storage duration | 없음 | 없음 | 30일 |
operation 분류입니다.

- Class A는 비싼 그룹으로
PutObject,CopyObject,ListObjects, lifecycle tier transition 등이 포함됩니다. 쓰기와 목록 조회가 주로 해당합니다. - Class B는 저렴한 그룹으로
GetObject,HeadObject,HeadBucket등이 포함됩니다. 읽기가 주로 해당합니다. - 무료 operation은
DeleteObject,DeleteBucket,AbortMultipartUpload입니다.
R2 무료 한도의 오해
10 GB-month는 무제한 저장소가 아닙니다.
- Storage: billing period 동안 보관한 용량이며 트래픽이 아닙니다. 초과하면 유료 사용 또는 정리가 필요합니다.
- Class A: 월 1M operation이지만 batch upload는 빠르게 소모할 수 있습니다.
- Class B: 월 10M operation으로 많은 읽기를 감당하지만 트래픽이 큰 이미지 origin은 넘을 수 있습니다.
Infrequent Access는 최소 30일 보관 기간이 있습니다. 일찍 삭제해도 최소 비용은 남습니다. 백업과 장기 오브젝트에 맞고 임시 결과에는 맞지 않습니다.
적합한 경우: 업로드와 생성 결과
R2는 다음에 맞습니다.
uploads/2026/06/report.pdf, 이미지, 문서 같은 사용자 업로드, 특히 다운로드가 많은 경우.- 생성 report, export, 이미지 처리 결과.
- 저렴하게 회수해야 하는 DB dump와 snapshot.
- Workers, D1, KV, Vectorize를 사용하는 프로젝트.
R2가 맞지 않는 경우입니다.
- 구조화 쿼리와 접근 제어가 필요한 사용자와 주문 같은 업무 사실.
- S3 Object Lock, 더 많은 storage tier, AWS 네이티브 cross-bucket/cross-region replication이 필요한 workload.
R2와 S3 비교
| 항목 | R2 | S3 |
|---|---|---|
| Internet egress | R2 쪽 무료, 연결한 metered service는 과금 가능 | region, destination, usage에 따라 달라 현재 AWS 가격표 확인 |
| Storage | Standard $0.015/GB-month | Standard와 Glacier 등 여러 tier |
| Ecosystem | Workers/Pages 네이티브 | Lambda를 포함한 깊은 AWS 연동 |
| Governance | lifecycle, Standard/IA, Queues event notification | Object Lock, 여러 Glacier class, lifecycle, Replication, 여러 event destination |
| 적합한 용도 | Cloudflare ecosystem, egress-sensitive delivery | AWS ecosystem, governance, data lake, enterprise app |
R2를 선택할 때입니다.
- 다운로드가 많아 egress cost가 중요합니다.
- 애플리케이션이 Workers/Pages에서 동작합니다.
S3를 선택할 때입니다.
- Lambda, data lake, enterprise workflow가 AWS service에 의존합니다.
- Object Lock, 더 많은 Glacier class, cross-region replication, AWS 네이티브 IAM governance가 필요합니다.
- CloudWatch, IAM, batch operation 등 넓은 AWS toolchain이 유용합니다.
R2와 S3는 완전한 대체 관계가 아닙니다. Cloudflare 제품은 CDN 파일과 생성 결과를 R2에, governance 대상 archive를 S3에 둘 수 있습니다.
S3: AWS 생태계와 거버넌스
Amazon S3는 data lake, website, mobile application, backup/restore, archive, enterprise application, IoT, analytics용 object storage service입니다(Amazon S3 User Guide). 다음 기능을 제공합니다.
- Standard, Intelligent-Tiering, Glacier, Glacier Deep Archive 등의 storage class.
- 오브젝트를 자동 이동 또는 만료하는 lifecycle rule.
- 덮어쓰기와 삭제를 막는 WORM 방식의 Object Lock.
- recovery, latency, governance를 위한 Same-Region/Cross-Region Replication.
- IAM, bucket policy, Block Public Access.
- Lambda 등 AWS destination으로 보내는 event notification.
적합한 경우: AWS 연동과 거버넌스 요구
S3는 다음에 맞습니다.
- Lambda, EC2, RDS, DynamoDB를 이미 사용하는 제품.
- Object Lock, archive class, 정식 retention control이 필요한 경우.
- AWS analytics service에 의존하는 data lake/IoT pipeline.
- lifecycle rule을 사용하는 장기 backup, restore, archive.
S3가 덜 맞는 경우입니다.
- 사용자 다운로드가 많아 egress cost에 민감한 경우. 대상 region, destination, cache, volume의 현재 AWS 가격을 사용합니다.
- 애플리케이션이 Cloudflare 네이티브이고 Workers/Pages에서 R2로 직접 접근할 수 있는 경우.
S3와 R2: 생태계와 거버넌스의 깊이
S3의 장점은 AWS 연동과 거버넌스 기능의 폭입니다.
- Event destination: S3 Event Notifications는 SNS, SQS, Lambda, EventBridge로 보냅니다. R2도 object-create/delete 이벤트를 Cloudflare Queues로 보내 Worker 또는 HTTP pull이 처리할 수 있습니다.
- Storage class: S3는 여러 Glacier archive class를 제공하고 R2는 현재 Standard와 Infrequent Access가 중심입니다.
- Object Lock: WORM 보존으로 기간 중 덮어쓰기/삭제를 막습니다.
- Replication: 같은 region 또는 다른 region의 bucket으로 object, metadata, tag를 복사합니다.
S3를 선택할 때입니다.
- Lambda, data lake, enterprise application이 AWS 연동에 의존합니다.
- Object Lock, Glacier class, lifecycle governance가 필요합니다.
- 장기 archive가 Glacier family의 이점을 얻습니다.
R2를 선택할 때입니다.
- 사용자 업로드와 생성 파일이 자주 다운로드됩니다.
- Workers/Pages가 주요 runtime입니다.
CDN 파일과 생성 결과를 R2에, governance 대상 backup을 S3에 두는 혼합 구조도 가능합니다. 공급자 하나가 아니라 데이터 유형과 접근 패턴으로 결정합니다.
SQLite: 로컬과 임베디드 우선
SQLite는 local application data, application file, 낮거나 중간인 traffic site, 분석, 캐시에 맞습니다(SQLite 사용 시점). client/server SQL database와 직접 경쟁하지 않습니다. client/server system은 shared repository, concurrency, centralization, control을 중시하고 SQLite는 복사 가능한 단일 파일의 local/single-user 데이터를 중시합니다.
적합한 경우: 단일 사용자 도구와 로컬 backend
SQLite는 다음에 맞습니다.
- 단일 사용자 도구, 로컬 dashboard, 분석 utility, 작은 게임, 단일 파일 dataset.
- CAD, finance, media management software의 application file format.
- 낮거나 중간인 traffic website. SQLite는 100K hits/day 미만이 일반적으로 잘 동작한다고 설명하지만 보수적인 관찰이며 성능 보장은 아닙니다. hardware, 쿼리 복잡도, concurrent write가 용량을 결정합니다.
local-dev.sqlite같은 로컬 개발 데이터.- durable shared state가 필요 없는 cache와 temporary calculation.
SQLite가 덜 맞는 경우입니다.
- 권한, 동시 쓰기, 감사가 필요한 multi-user SaaS.
- 성숙한 backup과 point-in-time recovery가 필요한 주문과 구독 권리.
- SQLite는 여러 reader를 허용하지만 writer는 하나이므로 write-heavy concurrency.
SQLite와 Postgres: 마이그레이션 신호
| 항목 | SQLite | Postgres |
|---|---|---|
| 포지션 | local data, application file | shared client/server repository |
| 적합한 용도 | 단일 사용자 도구, 작은 게임, 로컬 dashboard | multi-user SaaS, 주문, 구독 권리 |
| 동시성 | one writer, many readers | MVCC 기반 multiple writers |
| 권한 | built-in user management 없음 | RLS와 user/role management |
| 비용 | 별도 DB server 없음 | self-host/managed plan, compute, backup에 따라 달라짐 |
SQLite에서 Postgres로 옮길 신호입니다.
- 단일 사용자 도구가 multi-user SaaS가 되어 권한 시스템이 필요합니다.
- 여러 사용자 또는 instance가 같은 상태를 동시에 수정합니다.
- 결제로 주문/권리가 생겨 감사와 검증된 복구가 필요합니다.
users/roles/permissions모델에 DB 수준 접근 제어가 필요합니다.
개인 분석 dashboard는 SQLite를 유지해도 됩니다. 여러 유료 고객이 서비스를 공유하면 Postgres가 더 명확한 경계입니다.
SQLite는 Postgres 대체품이 아니다
SQLite 공식 안내도 client/server SQL database를 대체하려는 제품이 아니라고 설명합니다.
- SQLite는 local, single-user, 단일 파일 복사의 단순성을 최적화합니다.
- Postgres는 shared multi-user repository, concurrent state change, payment-critical record를 최적화합니다.
SQLite는 별도 DB server가 필요 없습니다. Postgres 비용은 self-host/managed plan, compute, storage, backup에 따라 달라집니다. 둘 다 검증된 restore process가 필요합니다.
SQLite를 선택할 경우입니다.
- 결제나 권한 시스템 없는 로컬 utility와 작은 게임.
- development fixture와 temporary data.
- write concurrency가 낮은 개인 사이트와 문서 도구.
Postgres를 선택할 경우입니다.
- 주문, 구독, 권한이 있는 multi-user SaaS.
- 운영 및 권리 변경을 감사해야 하는 경우.
- configurable point-in-time recovery가 필요한 business record.
함께 사용할 수 있습니다. 로컬 개발 또는 재생성 가능한 캐시는 SQLite, production 업무 사실은 Postgres에 둡니다.
피해야 할 세 가지 실수
가장 흔한 실수는 업무 사실을 오브젝트로 저장하고, D1의 scan-based billing을 무시하고, R2 무료 한도를 무제한으로 보는 것입니다. 복구가 어려워지고 쿼리가 느려지며 비용을 예측하기 힘들어집니다.
실수 1: 업무 사실을 오브젝트 스토리지에 저장하기
users, orders, 감사 대상 usage_events는 R2/S3에 두지 않습니다. 오브젝트 스토리지는 관계형 쿼리, constraint, row-level permission, DB audit pattern을 제공하지 않습니다.
구체적인 문제입니다.
- SELECT/JOIN 불가: 오브젝트 스토리지는 key-based입니다.
SELECT * FROM orders WHERE user_id = ? LIMIT 20에 답하려면 애플리케이션이 order object를 list/download해야 합니다. - 복구 어려움: file collection은 transactional order history가 아닙니다. SQL dump나 managed point-in-time system이 더 일관된 DB recovery path를 제공합니다.
- 느린 export: DB 쿼리는 조건에 맞는 record를 stream할 수 있지만 object-per-order 설계는 많은 파일을 스캔해야 합니다.
업무 사실은 데이터베이스, 파일은 오브젝트 스토리지에 둡니다. DB는 안정적인 object key를 저장하고 R2, S3, Supabase Storage가 파일을 보관합니다.
실수 2: rows read 과금 놓치기
D1은 반환 행이 아니라 스캔 행을 셉니다. 인덱스 없는 필터는 결과 수보다 훨씬 많은 rows read를 소모할 수 있습니다.
50,000행의 orders에서 user_id 인덱스 없이 SELECT * FROM orders WHERE user_id = ? LIMIT 20을 실행하면 많은 행을 읽습니다. 실제 과금 사용량은 meta.rows_read에 나옵니다. Free는 일일 5M 이후 쿼리가 실패하고 Paid는 월 포함량을 넘으면 과금합니다.
해결 방법입니다.
- 실제 필터 열에
CREATE INDEX idx_user_id ON orders(user_id);같은 인덱스를 만듭니다. EXPLAIN QUERY PLAN과meta.rows_read로 full-table scan이 남았는지 확인합니다.- response payload를 줄이려고 필요한 열만 선택하되 D1은 열이 아니라 행을 센다는 점을 기억합니다.
실수 3: R2 무료 한도를 무제한으로 보기
R2 Free는 현재 Standard storage 10 GB-month, 월 1M Class A, 10M Class B를 포함합니다. 무제한이 아닙니다.
흔한 오해입니다.
- 10 GB-month는 기간 중 stored capacity이며 transfer allowance가 아닙니다.
PutObject는 Class A operation입니다. 총 용량이 작아도 batch 생성으로 한도를 소모할 수 있습니다.- Infrequent Access는 최소 30일 기간이 있어 일찍 삭제해도 최소 비용이 발생합니다.
storage와 operation count를 모니터링하고 오래된 output을 계획적으로 만료하며 임시 파일에 Infrequent Access를 사용하지 않습니다. 단기 데이터는 로컬 SQLite나 캐시가 더 적합할 수 있습니다.
결론
저장소는 업무 사실, 이벤트, 오브젝트, 캐시, 로컬 개발 데이터, 가벼운 엣지 데이터, 백업이라는 유형으로 결정합니다. Supabase Postgres는 관계형 constraint, RLS, 설정 가능한 복구, audit pattern 덕분에 업무 사실을 맡는 경우가 많습니다. D1은 Workers 네이티브의 가벼운 관계형 데이터, R2/S3는 오브젝트, SQLite는 단일 사용자 로컬 데이터에 맞습니다.
첫 버전을 안전하게 만드는 세 가지 행동입니다.
- 각 오브젝트를 분류하고 쿼리, 권한, 접근 빈도, 비용 요구를 기록합니다.
- D1 필터 열에 인덱스를 만들고 rows-read metric으로 결과를 검증합니다.
- 업무 레코드를 오브젝트 스토리지에 두지 않고 인덱스 없는 스캔을 피하며 R2는 storage뿐 아니라 전체 무료 한도를 추정합니다.
다음 글은 결제와 사용자 시스템을 다룹니다. 결제 주문에는 Postgres constraint, backup, audit가 필요하고 사용자 권리와 권한에는 RLS와 검증된 recovery가 필요합니다.
어떤 오브젝트의 저장소가 여전히 모호하다면 데이터 배치표와 시리즈 앞부분의 아키텍처 원칙, backend stack, deployment 글로 돌아갑니다. 시스템 경계를 먼저 정한 뒤 저장소 역할을 세분화합니다.
1인 프로젝트의 저장소 배치하기
데이터 목록 작성부터 복구 훈련까지 여섯 단계로 데이터베이스와 오브젝트 스토리지의 역할을 나눕니다.
- 1
Step 1: 데이터 오브젝트 목록 만들기
users, orders, usage_events, uploads, 캐시, 로컬 파일, 백업을 제품별로 묶기 전에 모두 적습니다. - 2
Step 2: 데이터 유형 분류하기
각 항목을 업무 사실, 이벤트, 오브젝트 파일, 캐시, 로컬 데이터, 백업으로 표시하고 만료 또는 재생성 가능 여부를 기록합니다. - 3
Step 3: 일관성과 권한 정의하기
트랜잭션, 제약 조건, RLS, 동시 쓰기, 감사, 다중 인스턴스 공유 요구로 Postgres와 D1을 판단합니다. - 4
Step 4: 접근량과 비용 요인 추정하기
D1 rows read/written, R2 Class A/B operations, 용량, 읽기 빈도, 잠재적인 egress 비용을 추정합니다. - 5
Step 5: 안정적인 참조 설계하기
object key, owner, status, metadata는 데이터베이스에, 파일 본문은 오브젝트 스토리지에 두고 key 이름을 안정적으로 유지합니다. - 6
Step 6: 백업과 마이그레이션 검증하기
내보내기, 외부 사본, 삭제 유예, 복구 훈련을 마련하고 metadata, 오브젝트, 읽기 경로 순으로 전환합니다.
FAQ
1인 프로젝트는 D1과 Supabase Postgres 중 무엇부터 선택해야 하나요?
R2와 S3에는 무엇을 저장하나요?
SQLite로 첫 SaaS를 운영할 수 있나요?
사용자 업로드를 데이터베이스에 저장해도 되나요?
D1 rows read 과금은 무엇인가요?
Cloudflare R2 무료 한도로 충분한가요?
6분 읽기 · 게시일: 2026년 10월 9일


댓글
GitHub로 로그인하여 댓글을 남기세요