Datenbank für Soloselbstständige wählen: D1, Postgres, R2, S3 oder SQLite
"Die offizielle D1-Preisseite erklärt rows read/written, Speicherlimits, den Einfluss von Indizes auf gescannte Zeilen und das Verhalten beim Erreichen des Tageslimits im Free-Tarif."
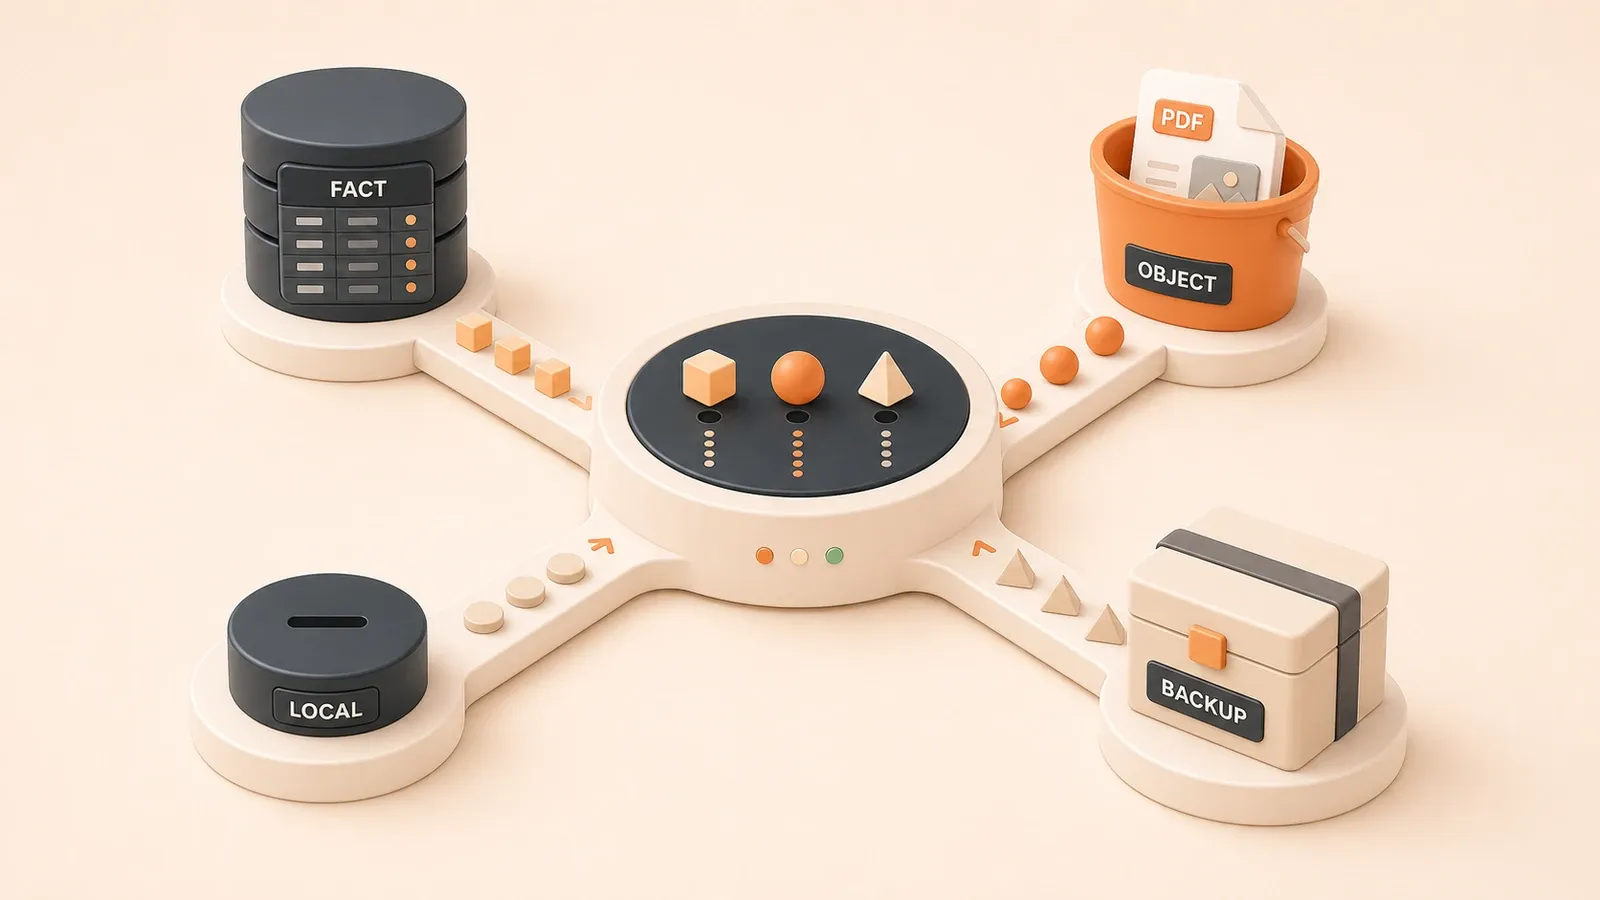
Im Projekt liegen eine Tabelle users, orders, usage_events, ein Benutzer-Upload unter uploads/2026/06/report.pdf, der Cache cache:daily-stats und lokale Entwicklungsdaten in local-dev.sqlite. Wo soll jedes Objekt liegen? Werden Geschäftsdaten als Dateien im Objektspeicher abgelegt, werden Backups, Abfragen und Exporte schnell umständlich. Fehlen in D1 Indizes auf Filterspalten, verbrauchen rows read das Kontingent rasch; im Paid-Tarif können zusätzliche Kosten entstehen. Die Entscheidung beginnt deshalb bei der Datenart, nicht beim Produktnamen.
Datenzuordnung: Was gehört wohin?
Auch in einem Solo-Projekt benötigen unterschiedliche Objekte unterschiedliche Speicher. Geschäftsfakten brauchen Abfragen, Beziehungen und Zugriffsrechte. Ereignisprotokolle verlangen zuverlässige Schreibvorgänge und bezahlbare Aufbewahrung. Objektdateien brauchen Download-Regeln, Lebenszyklen und ein Kostenmodell für ihren Traffic. Entscheidend ist, ob strukturierte Abfragen und Rechte nötig sind, wie oft zugegriffen wird und wie empfindlich der Workload auf Egress-Kosten reagiert.
Die Tabelle liefert einen praktischen Ausgangspunkt.
Sieben Datenarten und passende Speicher
| Datenart | Konkrete Objekte | Empfohlener Speicher | Entscheidungsgrundlage |
|---|---|---|---|
| Geschäftsfakten | users, orders, Abo-Ansprüche, Zahlungsdaten | Vorrangig Supabase Postgres, für einfache Fälle D1 | Strukturierte Abfragen (SELECT/JOIN), Rechte (RLS), tarifgerechte Backups oder Point-in-Time-Restore und Auditierbarkeit |
| Ereignisprotokolle | usage_events, Betriebsaktionen, Zugriffsstatistiken | D1 für Edge-Writes oder Postgres für Audit-Ereignisse | Häufige Writes und einfache Abfragen; normale Analyseereignisse dürfen eine niedrigere Restore-Priorität haben, Sicherheits- und Abrechnungsereignisse nicht |
| Objektdateien | uploads/2026/06/report.pdf, erzeugte Ergebnisse, Exporte, Bilder | R2 im Cloudflare-Umfeld, S3 in AWS oder Supabase Storage | Keine Datenbank-Blobs; R2-Egress, S3-Ökosystem oder Integration mit Supabase Auth/Postgres abwägen |
| Cache | cache:daily-stats, kurzlebiger Zustand, temporäre Berechnungen | Cloudflare KV, D1 oder lokales SQLite | Häufige Zugriffe und meist lösch- oder rekonstruierbar; KV/D1 am Edge, SQLite lokal |
| Lokale Entwicklungsdaten | local-dev.sqlite, Testdaten, Admin-Werkzeug für eine Person | SQLite-Datei | Ein Benutzer, kein Rechtesystem, leicht kopier- und startbar |
| Leichte Edge-Daten | Workers-Zähler, Konfigurationstabellen, Domain-Zuordnungen | D1 oder Cloudflare KV | Workers-nativer Zugriff, leichte Beziehungen, überwiegend Reads |
| Backups | Datenbank-Dumps, Export-Snapshots | R2/S3 plus lokale Kopie | R2-Egress-Modell, S3-Governance und Lifecycle sowie eine unabhängige Kopie für Provider-Ausfälle |
Warum Geschäftsfakten meist in Postgres beginnen
Benutzer, Bestellungen, Abo-Ansprüche und Zahlungen sind zentrale Datensätze. Ein Verlust verändert Kundenzugriff und Umsatz. Sie benötigen:
- Strukturierte Abfragen: Relationale Datenbanken führen SELECT, JOIN, WHERE und ORDER BY aus; Objektspeicher nicht.
- Zugriffsrechte: Supabase Postgres kann über Row Level Security Client-Zugriffe absichern. D1 bietet derzeit kein natives RLS.
- Backup und Restore: Supabase Pro, Team und Enterprise erhalten tägliche Backups; PITR ist ein separat aktiviertes kostenpflichtiges Add-on. D1 Time Travel hält 7 Tage in Workers Free und 30 Tage in Workers Paid.
- Audit-Trails: Trigger und eigene Audit-Tabellen für Änderungen an Zahlungen und Ansprüchen lassen sich in Postgres klar umsetzen.
Supabase Postgres ist keine eingeschränkte Postgres-Abstraktion. Jedes Projekt erhält eine vollständige Postgres-Datenbank, auf der Auth, Storage, Realtime und Edge Functions aufbauen (Supabase-Datenbankdokumentation). Die normalen Postgres-Funktionen bleiben verfügbar.
Ereignisse von Geschäftsdatensätzen trennen
usage_events, Betriebsaktionen und Zugriffsstatistiken verhalten sich anders:
- Sie werden häufig geschrieben; typische Abfragen filtern Zeiträume oder aggregieren Werte.
- Nicht auditpflichtige Analysedaten dürfen eine niedrigere Wiederherstellungspriorität haben, brauchen aber eine klare Aufbewahrungs- und Verlustregel. Sicherheits-, Abrechnungs- und Anspruchsereignisse sind keine gewöhnlichen Seitenaufrufe.
- Häufige Writes verbrauchen rows-written- und Speicherkontingente.
Die Grenze ist konkret:
- Gehört das Ereignis zu einem Audit-Trail mit
user_idundaction, nutze Postgres. - Ist es nur ein Zähler oder rekonstruierbares Analysesignal, kann D1 oder KV genügen.
Objektdateien nicht in die Datenbank legen
Uploads, erzeugte Ergebnisse, Exportarchive und Bilder gehören nicht in eine Blob-Spalte:
- Backup-Kosten: Jedes Blob landet im Datenbank-Backup und erhöht Dauer und Speicherbedarf.
- Abfragelast: Große Objekte in relationalen Zeilen vergrößern Transfer, Cache, Backups und Wartung; breite Abfragen liefern leichter versehentlich Dateiinhalt.
- CDN-Auslieferung: Objektspeicher lässt sich einfacher mit CDN, Cache-Regeln und signierten Downloads verbinden; Datenbank-Blobs benötigen meist einen Anwendungsproxy.
- Egress: Blob-Auslieferung verbraucht Datenbank- und Anwendungsbandbreite. Direkte R2-Übertragungen ins Internet haben keine R2-Egress-Gebühr; S3 hängt von Region und Ziel ab.
Die Datenbank speichert nur den Object Key, etwa uploads/2026/06/report.pdf. Die Datei selbst liegt in R2, S3 oder Supabase Storage.
Caches und lokale Entwicklungsdaten
Ein Cache wie cache:daily-stats, kurzlebiger Zustand oder eine temporäre Berechnung hat meist diese Eigenschaften:
- Häufige Reads und Writes, aber normalerweise Ablauf oder Rekonstruktion möglich. Sicherheitsrelevante Sessions brauchen eigene Regeln für Konsistenz, Ablauf und Widerruf.
- Rekonstruierbare Cache-Daten gehören gewöhnlich nicht in Backups der Geschäftsdatenbank; Session-Widerrufe und anderer Sicherheitszustand benötigen eine eigene Persistenzstrategie.
- Zugriffe am Edge sind latenzsensitiv.
Praktische Optionen:
- Cloudflare KV oder D1 für leichte Edge-Caches in Workers.
- Eine SQLite-Datei oder In-Memory-Cache in der lokalen Entwicklung.
local-dev.sqlite ist ein Einbenutzerfall ohne Rechtesystem:
- SQLite ist für lokale Anwendungsdaten und Anwendungsdateien gedacht (Wann SQLite sinnvoll ist).
- Es löst nicht dasselbe Problem wie eine Client-Server-Datenbank: SQLite betont lokale Einbenutzerdaten, Postgres ein gemeinsam genutztes Mehrbenutzer-Repository.
Leichte Edge-Daten und Backups
D1 oder KV ist ein sinnvoller Start für Workers-Zähler, kleine Konfigurationstabellen und Domain-Zuordnungen:
- Nativer Zugriff: Worker-Binding oder HTTP API ohne separaten Connection Pool.
- Leichte Beziehungen: einfaches Schema ohne komplexe JOINs oder großes Foreign-Key-Netz.
- Read-lastig: deutlich mehr Lese- als Schreibvorgänge.
Backup-Exporte brauchen bezahlbares Abrufen und eine unabhängige Kopie:
- Für direkte Downloads ins Internet berechnet R2 keine R2-Egress-Gebühr.
- S3 bietet Object Lock, mehrere Archivklassen und Lifecycle Management.
- Eine lokale oder bei einem zweiten Provider liegende Kopie schützt vor Konto- und Provider-Ausfällen. Die einzige Restore-Kopie sollte nicht neben der Produktion liegen.
D1: Workers-native Serverless-Datenbank
D1 ist Cloudflares verwaltete Serverless-Datenbank mit SQLite-SQL-Semantik (D1-Überblick). Wichtige Funktionen sind:
- Time Travel: Wiederherstellung auf jede Minute der letzten 7 Tage in Workers Free oder 30 Tage in Workers Paid. Der Restore überschreibt die Datenbank, daher muss der Zielzeitpunkt stimmen.
- Read Replication: geringere Leselatenz und mehr Lesedurchsatz für read-lastige Workloads.
- Workers- und HTTP-API-Zugriff: Binding oder HTTP API ohne eigenen Datenbank-Connection-Pool.
- Integrierte Disaster Recovery: Cloudflare verwaltet Datenbankhistorie und Wiederherstellungssystem.
Passend für Workers-native und read-lastige Anwendungen
D1 passt zu:

- Workers- oder Pages-Projekten, die nicht bei jeder Abfrage eine andere Plattform ansprechen wollen.
- Leichten relationalen Daten wie Konfiguration, Zählern und Domain-Zuordnungen ohne komplexes Beziehungsnetz.
- Read-lastigen Workloads, deren Reads sich über Replikation skalieren lassen.
- Projekten, die Workers, R2, KV oder Vectorize bereits nutzen und eine relationale Schicht im selben Ökosystem brauchen.
Weniger passend ist D1 für:
- Mehrbenutzer-SaaS mit ausgereiftem Rechtesystem und RLS.
- Bestellungen und Abo-Ansprüche, die ausgereifte Constraints, Audits und getestete Restores verlangen. Postgres ist meist der sicherere Start; das Restore-Fenster hängt vom Managed-Tarif und Add-ons ab.
- Audit-lastige Systeme, für die Postgres-Trigger und etablierte Audit-Muster benötigt werden.
Rows-read-Abrechnung: gescannte statt zurückgegebene Zeilen
D1 berechnet rows read, rows written und Speicher. Rows read sind die von einer Abfrage gescannten Zeilen, nicht die zurückgegebenen.
Im Juli 2026 nennt die offizielle Preisseite folgende Kontingente und Preise. Vor Veröffentlichung oder größeren Architekturentscheidungen sollten sie erneut geprüft werden.
| Position | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/Tag | Erste 25B/Monat enthalten |
| Rows written | 100K/Tag | Erste 50M/Monat enthalten |
| Speicher | 5 GB gesamt | Erste 5 GB enthalten, danach $0.75/GB-month |
| Rows-read-Mehrverbrauch | Nicht verfügbar | $0.001/million rows read |
| Rows-written-Mehrverbrauch | Nicht verfügbar | $1/million rows written |
| Egress/Bandbreite | Keine gesonderte Gebühr | Keine gesonderte Gebühr |
Läuft SELECT * FROM orders WHERE user_id = ? LIMIT 20 auf einer Tabelle mit 50.000 Zeilen ohne Index auf user_id, muss D1 möglicherweise fast die ganze Tabelle lesen, um 20 Zeilen zurückzugeben. Rows read liegen dann näher an 50.000 als an 20.
Ein Filter ohne Index kann also die gesamte Tabelle scannen, obwohl er nur wenige Datensätze zurückgibt. Maßgeblich ist meta.rows_read der tatsächlichen Abfrage, nicht die Ergebniszahl.
Indexdesign und Abfrageeffizienz
So lassen sich rows read kontrollieren:
- Lege etwa
CREATE INDEX idx_user_id ON orders(user_id);an, damit D1 nur die indizierte Teilmenge scannt. Prüfe den Wert inmeta.rows_read. - Frage nur benötigte Spalten ab, um Payload und Kopplung zu reduzieren. D1 zählt jedoch gescannte Zeilen, nicht Spalten; Indizes und Filter senken rows read.
- Vergleiche
rows_readmit den zurückgegebenen Zeilen. Query-metaund Dashboard zeigen rows read/written, sodass Full-Table-Scans sichtbar werden.
Hinweise für Indizes:
- Indiziere Spalten in WHERE-Bedingungen wie
user_idundcreated_at. - Indiziere JOIN-Schlüssel wie
order_idundproduct_id. - Vermeide unnötige Indizes, weil INSERT und UPDATE auch Indexzeilen schreiben können.
- Prüfe im D1-Dashboard regelmäßig Abfragen mit ungewöhnlich vielen rows read.
D1-Free-Kontingent und Upgrade-Signale
Workers Free begrenzt D1 derzeit auf:
- 5M rows read pro Tag. Eine Abfrage mit durchschnittlich 50K rows read läuft nur etwa 100-mal bis zum Tageslimit.
- 100K rows written pro Tag, was write-lastige Anwendungen schnell verbrauchen.
- 5 GB Gesamtspeicher im Konto.
Workers Paid lohnt sich zu prüfen, wenn:
- Die täglichen rows read 5M erreichen. Free-Abfragen scheitern danach; Paid enthält monatlich 25B und berechnet Mehrverbrauch.
- Die täglichen rows written 100K erreichen; Paid enthält monatlich 50M.
- Mehr als 5 GB benötigt werden; Mehrverbrauch kostet $0.75/GB-month.
D1 ist am stärksten bei leichten relationalen Daten nahe an Workers, nicht als Standard für jeden write-lastigen oder großen Workload. Beobachte rows read, rows written und Speicher.
Supabase Postgres: praktischer BaaS-Standard
Jedes Supabase-Projekt enthält eine vollständige Postgres-Datenbank statt einer eingeschränkten Abstraktion (Supabase-Datenbankdokumentation). Auth, Storage, Realtime und Edge Functions bauen darauf auf; komplexe Abfragen, Foreign Keys, Trigger, Transaktionen, MVCC und Extensions bleiben verfügbar.
RLS für kontrollierten Client-Zugriff
Row Level Security ist ein zentraler Vorteil von Supabase Postgres. Klassisch erreicht nur der Server die Datenbank und Clients verwenden eine API. RLS wendet bei korrekt eingerichteten Policies und Schlüsseln Rechte auf einzelne Zeilen einer Client-Abfrage an.
RLS unterstützt:
- Zugriffskontrolle: Eine Policy kann nur Zeilen zeigen, deren
user_idzum angemeldeten Benutzer passt. - Audit-Design: RLS definiert die Zugriffsgrenze; eine Audit-Tabelle, Trigger oder Logging zeichnen gesondert auf, wer wann was getan hat.
- Weniger doppelte Rechteprüfung: Regeln können in der Datenbank liegen, während der Server weiterhin Identitäten prüft, privilegierte Schlüssel schützt und erhöhte Operationen kontrolliert.
Das passt zu Geschäftsfakten, rechteintensiven Anwendungen, Mehrbenutzer-SaaS, Bestellungen und Abo-Ansprüchen. RLS ist die Datenbankgrenze, ersetzt aber weder Schema- noch Audit-Design.
Backups und Wiederherstellung
Im Juli 2026 nennt Supabase offiziell:
| Position | Free | Pro | Team |
|---|---|---|---|
| Datenbankgröße | 500 MB pro Projekt enthalten | 8 GB pro Projekt, danach Mehrverbrauch | 8 GB pro Projekt, danach Mehrverbrauch |
| Preis | $0 | $25/Monat | $599/Monat |
| Automatische Backups | Nicht enthalten | Täglich, 7 Tage Aufbewahrung | Täglich, 14 Tage Aufbewahrung |
| PITR | Nicht enthalten | Bezahltes Add-on, etwa $100/Monat für 7 Tage | Bezahltes Add-on, etwa $100/Monat für 7 Tage |
Daraus folgen drei praktische Punkte:
- Ein Free-Projekt darf Plattform-Backups nicht als Restore-Plan betrachten. Führe
supabase db dumpoderpg_dumpregelmäßig aus und bewahre eine externe Kopie auf. - Pro und Team erhalten tägliche Backups, können aber Änderungen seit dem letzten Backup verlieren.
- PITR ist in Pro nicht standardmäßig enthalten. Es benötigt mindestens Small Compute und wird für 7, 14 oder 28 Tage separat berechnet.
Nicht nur die Datenbankgröße entscheidet über ein Upgrade. Für Bestellungen und Ansprüche müssen zuerst Recovery Point Objective, Recovery Time Objective und Häufigkeit der Restore-Tests feststehen. Danach lässt sich zwischen täglichen Backups und PITR entscheiden.
D1 und Supabase: Rechte und Wiederherstellung
| Dimension | D1 | Supabase Postgres |
|---|---|---|
| Positionierung | Workers-native Serverless-Datenbank | Verwaltetes Postgres-BaaS |
| Zugriffskontrolle | Kein natives RLS | RLS kann Client-Abfragen absichern |
| Wiederherstellung | Time Travel: Free 7 Tage, Paid 30 Tage | Tägliche Backups für Pro/Team/Enterprise; PITR als Add-on |
| Passender Einsatz | Leichte relationale Daten in Workers | Geschäftsfakten, Mehrbenutzer-SaaS, Bestellungen, Ansprüche |
| Abrechnung | Rows read/written plus Speicher | Datenbankspeicher, Compute und Tarifnutzung |
Beide lassen sich kombinieren:
- D1 speichert read-lastige Edge-Konfiguration, Zähler und Domain-Zuordnungen.
- Supabase Postgres speichert Benutzer, Bestellungen, Abo-Ansprüche und Zahlungen.
Ein SaaS-Tool kann Konfiguration und Zähler in D1 halten, während Postgres Benutzer und Ansprüche besitzt. D1 bleibt nahe an Workers; Postgres liefert ausgereifte Rechte, Constraints und Restore-Optionen.
R2: Objektspeicher ohne R2-Egress-Gebühr
R2 ist Cloudflares S3-kompatibler Objektspeicher. Direkte Übertragungen aus R2 über Workers API, S3 API oder r2.dev ins Internet verursachen keine R2-Egress-Gebühr (R2-Preise); ein verbundener kostenpflichtiger Dienst kann dennoch abrechnen. R2 passt zu Uploads, erzeugten Ergebnissen und Exporten, aber kostenloser Egress macht Speicher und Operationen nicht kostenlos.
Abrechnung der Class-A/B-Operationen
R2 berechnet Speicher, Class-A- und Class-B-Operationen. Infrequent Access hat zusätzlich Retrieval-Gebühren.
Im Juli 2026 gelten laut Preisseite:
| Position | Free-Kontingent | Standard | Infrequent Access |
|---|---|---|---|
| Speicher | 10 GB-month/Monat | $0.015/GB-month | $0.01/GB-month |
| Class-A-Operationen | 1M/Monat | $4.50/million | $9.00/million |
| Class-B-Operationen | 10M/Monat | $0.36/million | $0.90/million |
| Datenabruf | Keiner | Keiner | $0.01/GB |
| Internet-Egress | Kostenlos | Kostenlos | Kostenlos |
| Mindestdauer | Keine | Keine | 30 Tage |
Zu den Klassen gehören:
- Class A, die teurere Gruppe:
PutObject,CopyObject,ListObjectsund Lifecycle-Tier-Wechsel. Writes und Listings fallen meist hierunter. - Class B, die günstigere Gruppe:
GetObject,HeadObjectundHeadBucket. Reads fallen meist hierunter. - Kostenlose Operationen:
DeleteObject,DeleteBucketundAbortMultipartUpload.
Was das R2-Free-Kontingent nicht bedeutet
10 GB-month sind kein unbegrenzter Speicher:
- Speicher: 10 GB-month misst Kapazität über den Abrechnungszeitraum, nicht Traffic. Mehr Daten erfordern bezahlte Nutzung oder Bereinigung.
- Class A: 1M Operationen pro Monat reichen für viele kleine Seiten, Batch-Uploads können das Kontingent aber schnell verbrauchen.
- Class B: 10M Operationen pro Monat decken viel Leseverkehr ab, ein stark besuchter Bild-Origin kann sie überschreiten.
Infrequent Access hat eine Mindestdauer von 30 Tagen. Früheres Löschen vermeidet die Mindestgebühr nicht. Die Klasse passt zu Backups und langlebigen Objekten, nicht zu temporären Ergebnissen.
Passend für Uploads und erzeugte Ergebnisse
R2 passt zu:
- Benutzer-Uploads wie
uploads/2026/06/report.pdf, Bildern und Dokumenten, besonders bei häufigen Downloads. - Erzeugten Reports, Exporten und Bildverarbeitungsergebnissen.
- Datenbank-Dumps und Snapshots, die günstig abrufbar sein sollen.
- Projekten mit Workers, D1, KV oder Vectorize.
Nicht geeignet ist R2 für:
- Geschäftsfakten wie Benutzer und Bestellungen, die strukturierte Abfragen und Rechte benötigen.
- Workloads mit S3 Object Lock, mehr Speicherklassen oder AWS-nativer Bucket- und Regionsreplikation.
R2 und S3 im Vergleich
| Dimension | R2 | S3 |
|---|---|---|
| Internet-Egress | Auf R2-Seite kostenlos; verbundene Dienste können abrechnen | Abhängig von Region, Ziel und Nutzung; aktuelle AWS-Preise prüfen |
| Speicher | $0.015/GB-month für Standard | Mehrere Klassen einschließlich Standard und Glacier |
| Ökosystem | Nativ in Workers und Pages | Tiefe AWS-Integration einschließlich Lambda |
| Governance | Lifecycle-Regeln, Standard/IA und Queue-Events | Object Lock, mehrere Glacier-Klassen, Lifecycle, Replication und mehrere Event-Ziele |
| Passender Einsatz | Cloudflare-Ökosystem und egress-sensitive Auslieferung | AWS-Ökosystem, Governance, Data Lakes und Unternehmensanwendungen |
R2 wählen, wenn:
- Downloads Egress-Kosten zu einem wesentlichen Faktor machen.
- Die Anwendung bereits auf Workers oder Pages läuft.
S3 wählen, wenn:
- Lambda-, Data-Lake- oder Unternehmensworkflows von AWS-Diensten abhängen.
- Object Lock, mehr Glacier-Klassen, regionsübergreifende Replikation oder AWS-IAM-Governance benötigt werden.
- Das breitere AWS-Werkzeugset mit CloudWatch, IAM und Batch Operations wertvoll ist.
R2 und S3 sind keine vollständigen Ersatzprodukte. Eine Cloudflare-Anwendung kann CDN-Dateien und erzeugte Ergebnisse in R2 halten, governance-relevante Archive dagegen in S3.
S3: AWS-Ökosystem und Governance
Amazon S3 ist ein Objektspeicherdienst für Data Lakes, Websites, mobile Anwendungen, Backup und Restore, Archive, Unternehmensanwendungen, IoT und Analytics (Amazon S3 User Guide). Er bietet:
- Speicherklassen wie Standard, Intelligent-Tiering, Glacier und Glacier Deep Archive.
- Lifecycle-Regeln zum automatischen Verschieben oder Löschen.
- Object Lock mit WORM-Aufbewahrung gegen Überschreiben und Löschen.
- Same-Region- und Cross-Region-Replication für Restore, Latenz und Governance.
- IAM- und Bucket-Policies plus Block Public Access.
- Event Notifications für Lambda und andere AWS-Ziele.
Passend für AWS-Integration und Governance
S3 passt zu:
- Produkten, die Lambda, EC2, RDS oder DynamoDB bereits nutzen.
- Anforderungen an Object Lock, Archivklassen und formelle Aufbewahrung.
- Data Lakes und IoT-Pipelines mit AWS-Analysediensten.
- Langfristigen Backup-, Restore- und Archivabläufen mit Lifecycle-Regeln.
Weniger passend ist S3, wenn:
- Häufige Benutzer-Downloads Egress-Kosten empfindlich machen; maßgeblich sind aktuelle AWS-Preise für Region, Ziel, Cache und Volumen.
- Die Anwendung sonst Cloudflare-nativ ist und direkt aus Workers oder Pages auf R2 zugreift.
S3 und R2: Tiefe von Ökosystem und Governance
S3s Vorteil liegt in der Breite seiner AWS-Integrationen und Governance-Funktionen:
- Event-Ziele: S3 Event Notifications senden an SNS, SQS, Lambda und EventBridge. R2 kann Object-Create- und Object-Delete-Ereignisse an Cloudflare Queues senden, die Worker oder HTTP-Pull verarbeiten.
- Speicherklassen: S3 bietet mehrere Glacier-Archivklassen; R2 konzentriert sich derzeit auf Standard und Infrequent Access.
- Object Lock: WORM-Aufbewahrung verhindert Überschreiben oder Löschen während der Frist.
- Replication: S3 kopiert Objekte, Metadaten und Tags in Buckets derselben oder einer anderen Region.
S3 wählen, wenn:
- Lambda, Data Lakes oder Unternehmensanwendungen von AWS-Integrationen abhängen.
- Object Lock, Glacier-Klassen oder Lifecycle-Governance nötig sind.
- Langzeitarchive von der Glacier-Familie profitieren.
R2 wählen, wenn:
- Benutzer-Uploads und erzeugte Dateien häufig heruntergeladen werden.
- Workers und Pages die primäre Laufzeit sind.
Eine kombinierte Architektur kann CDN-Dateien und Ergebnisse in R2, governance-relevante Backups in S3 halten. Datenart und Zugriffsmuster entscheiden, nicht eine Ein-Provider-Regel.
SQLite: lokal und eingebettet zuerst
SQLite passt zu lokalen Anwendungsdaten, Anwendungsdateien, Websites mit geringem bis mittlerem Traffic, Analysen und Caches (Wann SQLite sinnvoll ist). Es konkurriert nicht direkt mit Client-Server-SQL-Datenbanken. Diese betonen ein gemeinsames Repository, Parallelität, Zentralisierung und Kontrolle; SQLite betont lokale Einbenutzerdaten in einer kopierbaren Datei.
Passend für Einbenutzer-Werkzeuge und lokale Backends
SQLite passt zu:
- Einbenutzer-Werkzeugen, lokalen Dashboards, Analyseprogrammen, kleinen Spielen und Einzeldatei-Datensätzen.
- Anwendungsdateiformaten für CAD-, Finanz- oder Medienverwaltungssoftware.
- Websites mit geringem bis mittlerem Traffic. SQLite nennt weniger als 100K Hits pro Tag als meist unproblematisch, doch das ist eine konservative Beobachtung und keine Leistungszusage. Hardware, Abfragekomplexität und parallele Writes bestimmen die Kapazität.
- Lokalen Entwicklungsdaten wie
local-dev.sqlite. - Caches und temporären Berechnungen ohne dauerhaft gemeinsam genutzten Zustand.
Weniger passend ist SQLite für:
- Mehrbenutzer-SaaS mit Rechten, parallelen Writes und Audit-Anforderungen.
- Bestellungen und Abo-Ansprüche, die ausgereifte Backups und Point-in-Time-Recovery brauchen.
- Write-lastige Parallelität, weil SQLite zwar viele Leser, aber jeweils nur einen Schreiber erlaubt.
SQLite und Postgres: Migrationssignale
| Dimension | SQLite | Postgres |
|---|---|---|
| Positionierung | Lokale Daten und Anwendungsdatei | Gemeinsames Client-Server-Repository |
| Passender Einsatz | Einbenutzer-Werkzeuge, kleine Spiele, lokale Dashboards | Mehrbenutzer-SaaS, Bestellungen, Abo-Ansprüche |
| Parallelität | Ein Schreiber, viele Leser | Mehrere Schreiber mit MVCC |
| Rechte | Keine eingebaute Benutzerverwaltung | RLS und Benutzer-/Rollenverwaltung |
| Kosten | Kein separater Datenbankserver | Abhängig von Self-Hosting oder Managed-Tarif, Compute und Backups |
Von SQLite zu Postgres wechseln, wenn:
- Aus einem Einbenutzer-Werkzeug ein Mehrbenutzer-SaaS mit Rechtesystem wird.
- Mehrere Benutzer oder Instanzen denselben Zustand gleichzeitig ändern müssen.
- Zahlungen Bestellungen und Ansprüche einführen, die Audit und getesteten Restore brauchen.
- Ein Modell aus
users/roles/permissionsDatenbankrechte benötigt.
Ein persönliches Analyse-Dashboard kann bei SQLite bleiben. Teilen mehrere zahlende Kunden denselben Dienst, ist Postgres meist die klarere Grenze.
SQLite ersetzt Postgres nicht
Auch SQLite selbst beschreibt sich nicht als Ersatz für eine Client-Server-SQL-Datenbank:
- SQLite optimiert lokale Einbenutzer-Einfachheit und eine als Datei kopierbare Datenbank.
- Postgres optimiert ein gemeinsam genutztes Mehrbenutzer-Repository mit parallelen Zustandsänderungen und zahlungskritischen Datensätzen.
SQLite benötigt keinen separaten Datenbankserver. Postgres-Kosten hängen von Self-Hosting oder Managed-Tarif, Compute, Speicher und Backups ab. Beide brauchen einen getesteten Restore-Prozess.
SQLite wählen für:

- Lokale Werkzeuge und kleine Spiele ohne Zahlungen oder Rechtesystem.
- Entwicklungsfixtures und temporäre Daten.
- Persönliche Websites und Dokumentationswerkzeuge mit wenigen parallelen Writes.
Postgres wählen für:
- Mehrbenutzer-SaaS mit Bestellungen, Abos und Rechten.
- Auditierbare Betriebs- und Anspruchsänderungen.
- Geschäftsdaten mit konfigurierbarer Point-in-Time-Recovery.
Beide können koexistieren: SQLite für lokale Entwicklung oder rekonstruierbare Caches, Postgres für produktive Geschäftsfakten.
Drei typische Fehler
Die häufigsten Fehler sind Geschäftsfakten als Objekte, ignorierte scanbasierte D1-Abrechnung und die Annahme eines unbegrenzten R2-Free-Kontingents. Sie erschweren Restores, verlangsamen Abfragen und machen Kosten unvorhersehbar.
Fehler 1: Geschäftsfakten im Objektspeicher
Tabellen wie users, orders und auditpflichtige usage_events gehören nicht in R2 oder S3. Objektspeicher bietet keine relationalen Abfragen, Constraints, zeilenbezogenen Rechte oder Datenbank-Audit-Muster.
Die Folgen sind konkret:
- Kein SELECT oder JOIN: Objektspeicher ist key-basiert. Für
SELECT * FROM orders WHERE user_id = ? LIMIT 20müsste die Anwendung Bestellobjekte selbst auflisten und herunterladen. - Umständlicher Restore: Eine Dateisammlung ist keine transaktionale Bestellhistorie. SQL-Dump oder verwaltete Point-in-Time-Systeme liefern einen kohärenteren Datenbank-Restore.
- Langsame Exporte: Datenbankabfragen streamen passende Datensätze; ein Objekt pro Bestellung kann das Scannen vieler Dateien erfordern.
Geschäftsfakten bleiben in der Datenbank, Dateien im Objektspeicher. Die Datenbank speichert einen stabilen Object Key; R2, S3 oder Supabase Storage enthält die Datei.
Fehler 2: Rows-read-Abrechnung übersehen
D1 zählt gescannte statt zurückgegebene Zeilen. Ein Filter ohne Index kann daher viel mehr rows read verbrauchen als die Ergebniszahl vermuten lässt.
Bei 50.000 orders-Zeilen kann SELECT * FROM orders WHERE user_id = ? LIMIT 20 ohne Index viele Zeilen scannen. Den abrechenbaren Wert zeigt meta.rows_read. Free-Abfragen scheitern nach 5M pro Tag; Paid berechnet Nutzung über dem monatlichen Kontingent.
Die Korrektur:
- Indiziere die reale Filterspalte, etwa mit
CREATE INDEX idx_user_id ON orders(user_id);. - Prüfe mit
EXPLAIN QUERY PLANundmeta.rows_read, ob ein Full-Table-Scan bleibt. - Wähle nur benötigte Spalten für eine kleinere Payload, ohne zu vergessen, dass D1 Zeilen statt Spalten zählt.
Fehler 3: Das R2-Free-Kontingent für unbegrenzt halten
R2 Free enthält derzeit 10 GB-month Standard Storage, 1M Class-A- und 10M Class-B-Operationen pro Monat. Das sind Kontingente, keine unbegrenzte Nutzung.
Häufige Missverständnisse:
- 10 GB-month misst gespeicherte Kapazität über Zeit, nicht Transfer.
PutObjectist eine Class-A-Operation. Batch-Erzeugung kann das Monatskontingent trotz kleiner Gesamtdatenmenge verbrauchen.- Infrequent Access hat eine Mindestdauer von 30 Tagen; früheres Löschen verursacht trotzdem die Mindestgebühr.
Überwache Speicher und Operationszahlen, lasse alte Ergebnisse bewusst ablaufen und verwende Infrequent Access nicht für temporäre Dateien. Lokales SQLite oder ein Cache kann für kurzlebige Daten besser passen.
Fazit
Der Datentyp entscheidet: Geschäftsfakten, Ereignisse, Objekte, Caches, lokale Entwicklungsdaten, leichte Edge-Daten und Backups. Supabase Postgres besitzt meist die Geschäftsfakten, weil es relationale Constraints, RLS, konfigurierbare Restores und Audit-Muster bietet. D1 passt zu leichten Workers-nativen relationalen Daten, R2 oder S3 zu Objekten und SQLite zu lokalen Einbenutzerdaten.
Drei Maßnahmen machen die erste Version sicherer:
- Klassifiziere jedes Objekt und notiere Abfragen, Rechte, Zugriffshäufigkeit und Kostenanforderungen.
- Indiziere D1-Filterspalten und überprüfe das Ergebnis anhand der Rows-read-Metriken.
- Halte Geschäftsdaten aus dem Objektspeicher, vermeide unindizierte Scans und schätze das gesamte R2-Kontingent statt nur den Speicher.
Die nächsten Beiträge behandeln Zahlungen und Benutzersysteme. Diese Themen bestätigen die Grenze: Zahlungsbestellungen brauchen Postgres-Constraints, Backups und Audits; Benutzeransprüche und Rechte benötigen RLS und getestete Wiederherstellung.
Ist der Speicherort eines Objekts weiterhin unklar, helfen die Zuordnungstabelle und die früheren Serienbeiträge zu Architekturprinzipien, Backend-Stack und Deployment. Erst die Systemgrenze festlegen, dann die Speicherrolle verfeinern.
Speicher für ein Solo-Projekt zuordnen
Trenne in sechs Schritten von der Bestandsaufnahme bis zum Wiederherstellungstest die Aufgaben von Datenbank und Objektspeicher.
- 1
Step 1: Datenobjekte erfassen
Liste users, orders, usage_events, uploads, Caches, lokale Dateien und Backups auf, ohne sie zuerst nach Produkten zu gruppieren. - 2
Step 2: Objekte klassifizieren
Kennzeichne jedes Element als Geschäftsfakt, Ereignis, Objektdatei, Cache, lokale Daten oder Backup und notiere, ob es ablaufen oder neu erzeugt werden darf. - 3
Step 3: Konsistenz und Rechte festlegen
Erfasse Anforderungen an Transaktionen, Constraints, RLS, parallele Schreibzugriffe, Audits und mehrere Instanzen, um zwischen Postgres und D1 zu entscheiden. - 4
Step 4: Zugriffe und Kostentreiber schätzen
Schätze D1 rows read/written, R2 Class A/B operations, Objektvolumen, Lesehäufigkeit und mögliche Egress-Kosten. - 5
Step 5: Stabile Referenzen entwerfen
Speichere Object Key, Eigentümer, Status und Metadaten in der Datenbank, den Dateiinhalt im Objektspeicher und halte die Key-Namen stabil. - 6
Step 6: Backup und Migration prüfen
Richte Exporte, externe Kopien, Löschfristen und Restore-Tests ein; migriere zuerst Metadaten, dann Objekte und zuletzt den Lesepfad.
FAQ
Sollte ein Solo-Projekt mit D1 oder Supabase Postgres beginnen?
Welche Daten gehören in R2 oder S3?
Kann SQLite das erste SaaS-Produkt betreiben?
Dürfen Benutzer-Uploads in die Datenbank?
Was bedeutet die Abrechnung von D1 rows read?
Reicht das kostenlose Kontingent von Cloudflare R2?
17 Min. Lesezeit · Veröffentlicht am: 9. Okt. 2026

Tech-Stack-Leitfaden fuer Solo-Founder
Wenn du über die Suche hier gelandet bist, kommst du am schnellsten weiter, indem du zum vorherigen oder nächsten Beitrag dieser Serie springst.
Vorheriger
Deployment für Solo-Founder: Cloudflare, Vercel oder Railway?
Vergleiche Cloudflare Pages und Workers, Vercel und Railway nach Workload, aktuellen Limits, Kostenrisiken und Betriebsaufwand für einen schlanken Solo-Founder-Stack.
Teil 7 von 8
Nächster
Dies ist bisher der neueste Beitrag dieser Serie.


Kommentare
Melde dich mit GitHub an, um einen Kommentar zu hinterlassen