Escolher banco de dados solo: D1, Postgres, R2, S3 ou SQLite
"A página oficial de preços do D1 explica rows read/written, limites de armazenamento, o efeito dos índices nas linhas percorridas e o comportamento ao atingir o limite diário do plano Free."
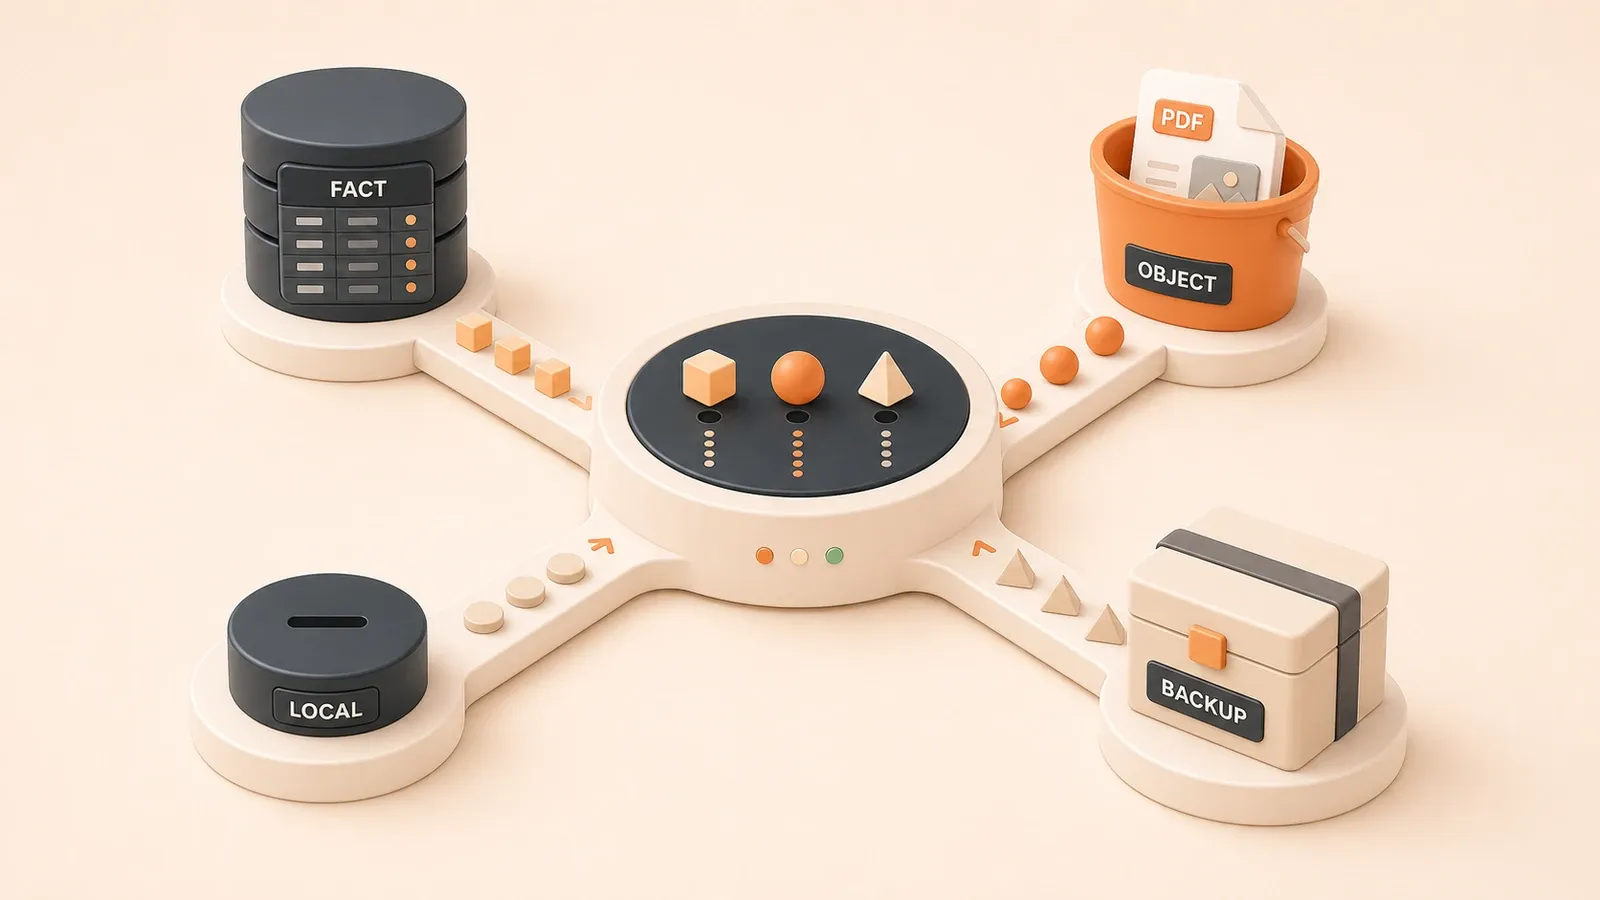
O projeto tem uma tabela users, orders, usage_events, um upload em uploads/2026/06/report.pdf, o cache cache:daily-stats e dados locais em local-dev.sqlite. Onde cada objeto deve ficar? Quando fatos de negócio viram arquivos no armazenamento de objetos, backup, consulta e exportação ficam difíceis. No D1, filtros sem índice consomem rows read rapidamente e podem gerar excedente no plano Paid. Portanto, a decisão começa pelo tipo de dado.
Tabela de alocação: onde guardar cada dado
Mesmo em um projeto solo, objetos diferentes exigem sistemas diferentes. Fatos de negócio precisam de queries, relações e controle de acesso. Eventos pedem escritas confiáveis e retenção econômica. Arquivos de objeto precisam de permissão de download, ciclo de vida e custo compatível com o tráfego. É preciso saber se consultas estruturadas e permissões são necessárias, a frequência de acesso e a sensibilidade ao custo de saída.
A tabela oferece um ponto de partida prático.
Sete tipos de dados e suas opções
| Tipo de dado | Objetos concretos | Armazenamento recomendado | Critério |
|---|---|---|---|
| Fatos de negócio | users, orders, direitos de assinatura, pagamentos | Supabase Postgres primeiro, ou D1 em casos simples | Queries estruturadas (SELECT/JOIN), permissões (RLS), backup ou restauração temporal compatível com o plano e auditoria |
| Eventos | usage_events, ações operacionais, estatísticas | D1 para escritas na borda ou Postgres para auditoria | Escritas frequentes e queries simples; análise comum pode ter prioridade de recovery menor, mas segurança e cobrança não |
| Arquivos de objeto | uploads/2026/06/report.pdf, resultados, exportações, imagens | R2 no Cloudflare, S3 na AWS ou Supabase Storage | Não usar blob no banco; avaliar saída do R2, ecossistema S3 ou integração Supabase Auth/Postgres |
| Cache | cache:daily-stats, estado curto, cálculos temporários | Cloudflare KV, D1 ou SQLite local | Acessos frequentes e dados normalmente expirantes ou recriáveis; KV/D1 na borda, SQLite local |
| Dados locais | local-dev.sqlite, dados de teste, administração de uma pessoa | Arquivo SQLite | Um usuário, sem sistema de permissões, fácil de copiar e executar |
| Dados leves na borda | Contadores Workers, configuração, mapeamento de domínios | D1 ou Cloudflare KV | Acesso nativo de Workers, relações leves, predominância de leitura |
| Backups | Dumps de banco, snapshots de exportação | R2/S3 mais cópia local | Modelo de saída R2, governança/lifecycle S3 e cópia independente contra falha do provedor |
Por que fatos de negócio normalmente começam no Postgres
Usuários, pedidos, direitos de assinatura e pagamentos são registros centrais. Perder esses dados afeta acesso e receita. Eles precisam de:
- Queries estruturadas: bancos relacionais executam SELECT, JOIN, WHERE e ORDER BY; armazenamento de objetos não.
- Controle de acesso: Supabase Postgres pode aplicar Row Level Security a queries de clientes. O D1 não oferece RLS nativo hoje.
- Backup e restauração: Supabase Pro, Team e Enterprise têm backups diários; PITR é um complemento pago ativado separadamente. D1 Time Travel guarda 7 dias no Workers Free e 30 no Workers Paid.
- Auditoria: triggers e tabelas específicas para mudanças de pagamento e direito são mais claros no Postgres.
Supabase Postgres não é uma abstração limitada. Cada projeto recebe um banco Postgres completo, base de Auth, Storage, Realtime e Edge Functions (documentação do Supabase Database). Os recursos normais do Postgres continuam disponíveis.
Separar eventos dos registros de negócio
usage_events, ações operacionais e estatísticas de acesso se comportam de outro modo:
- São gravados com frequência; queries comuns filtram intervalo ou agregam valores.
- Análises sem exigência de auditoria podem ter menor prioridade de restauração, mas precisam de política explícita de retenção e perda. Segurança, cobrança e direitos não são simples page views.
- Muitas escritas consomem quotas de rows written e storage.
A fronteira é concreta:
- Se o evento pertence a uma trilha de auditoria com
user_ideaction, use Postgres. - Se for apenas contador ou sinal analítico recriável, D1 ou KV pode bastar.
Não guardar arquivos de objeto no banco
Uploads, resultados gerados, arquivos de exportação e imagens não devem viver em coluna blob:
- Custo de backup: cada blob entra no backup e aumenta tempo e volume.
- Carga de query: misturar objetos grandes com linhas relacionais amplia transferência, cache, backup e manutenção; uma query ampla pode devolver o arquivo por engano.
- Entrega por CDN: armazenamento de objetos integra melhor com CDN, regras de cache e downloads assinados; blob normalmente exige proxy da aplicação.
- Saída: servir blob usa banda do banco e da aplicação. Transferência direta do R2 para Internet não tem cobrança de egress do R2; S3 depende de região e destino.
O banco guarda somente a object key, como uploads/2026/06/report.pdf. O arquivo fica no R2, S3 ou Supabase Storage.
Caches e dados locais de desenvolvimento
Um cache como cache:daily-stats, estado curto ou cálculo temporário costuma ter estas características:
- Leituras e escritas frequentes, mas normalmente pode expirar ou ser recriado. Sessões sensíveis exigem regras próprias de consistência, expiração e revogação.
- Cache recriável geralmente não entra em backup do banco de negócio; revogações de sessão e outros estados de segurança precisam de persistência própria.
- Acesso na borda é sensível a latência.
Opções práticas:
- Cloudflare KV ou D1 para cache leve na borda em Workers.
- Arquivo SQLite ou cache em memória no desenvolvimento local.
local-dev.sqlite é um caso de um usuário sem sistema de permissões:
- SQLite foi feito para dados locais e arquivos de aplicação (quando usar SQLite).
- Ele não resolve o mesmo problema de um banco cliente/servidor: SQLite prioriza local e usuário único; Postgres, repositório compartilhado multiusuário.
Dados leves na borda e backups
D1 ou KV é um bom começo para contadores Workers, configurações pequenas e mapeamento de domínios:
- Acesso nativo: binding Worker ou API HTTP sem pool separado.
- Relações leves: schema simples sem JOINs complexos ou grande rede de foreign keys.
- Predomínio de leitura: muito mais reads do que writes.
Exportações de backup exigem recuperação econômica e cópia independente:
- O R2 não cobra egress do R2 por downloads diretos para Internet.
- S3 oferece Object Lock, várias classes de arquivo e gestão de ciclo de vida.
- Uma cópia local ou em outro provedor protege contra falha de conta e plataforma. A única cópia de restore não deve ficar ao lado da produção.
D1: banco serverless nativo de Workers
D1 é o banco serverless gerenciado da Cloudflare com semântica SQL do SQLite (visão geral do D1). Os principais recursos são:
- Time Travel: restaura qualquer minuto dos últimos 7 dias no Workers Free ou 30 dias no Workers Paid. A restauração sobrescreve o banco, então valide o horário.
- Read replication: reduz latência e amplia capacidade de leitura para cargas com muitos reads.
- Acesso Workers e API HTTP: binding ou API sem operar pool de conexões próprio.
- Disaster recovery integrado: Cloudflare gerencia histórico e mecanismo de recuperação.
Adequado a aplicações Workers-native com muitas leituras
D1 atende:
- Projetos Workers ou Pages que evitam acessar outra plataforma em cada query.
- Dados relacionais leves como configuração, contadores e mapeamentos sem rede complexa de relações.
- Cargas dominadas por leitura que podem escalar com réplica.
- Projetos que já usam Workers, R2, KV ou Vectorize e precisam de camada relacional no mesmo ecossistema.
D1 atende menos:
- SaaS multiusuário que precisa de permissões maduras e RLS.
- Pedidos e direitos de assinatura que exigem constraints, auditoria e restore testado. Postgres costuma ser o início mais seguro; a janela depende do plano e dos complementos.
- Sistemas pesados em auditoria que dependem de triggers e padrões Postgres.
Cobrança rows read: linhas percorridas, não devolvidas
D1 cobra rows read, rows written e armazenamento. Rows read são as linhas percorridas pela query, não as devolvidas.
Em julho de 2026, a página oficial mostra estas cotas e preços. Revise antes de publicar ou decidir uma arquitetura importante.
| Item | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/dia | Primeiros 25B/mês incluídos |
| Rows written | 100K/dia | Primeiros 50M/mês incluídos |
| Armazenamento | 5 GB total | Primeiros 5 GB incluídos; depois $0.75/GB-month |
| Excesso rows read | Indisponível | $0.001/million rows read |
| Excesso rows written | Indisponível | $1/million rows written |
| Egress/banda | Sem cobrança separada | Sem cobrança separada |
Se SELECT * FROM orders WHERE user_id = ? LIMIT 20 rodar sobre 50.000 linhas sem índice em user_id, D1 pode percorrer quase toda a tabela para devolver 20. Rows read fica perto de 50.000, não de 20.
Um filtro sem índice pode percorrer a tabela inteira mesmo devolvendo poucos registros. Consulte meta.rows_read da execução real, não o número de resultados.
Índices e eficiência da query
Para controlar rows read:
- Crie um índice como
CREATE INDEX idx_user_id ON orders(user_id);para D1 ler o subconjunto indexado. Confirameta.rows_read. - Selecione apenas colunas necessárias para reduzir resposta e acoplamento. D1 conta linhas percorridas, não colunas; índices e filtros reduzem rows read.
- Compare
rows_readcom linhas devolvidas. Ometae o painel expõem rows read/written para encontrar full-table scans.
Dicas de indexação:
- Indexe colunas usadas em WHERE, como
user_idecreated_at. - Indexe chaves de JOIN, como
order_ideproduct_id. - Evite índices desnecessários, pois INSERT e UPDATE também podem escrever linhas de índice.
- Revise no painel D1 queries com rows read muito altos.
Cota gratuita do D1 e sinais de mudança
Workers Free limita hoje o D1 a:
- 5M rows read por dia. Uma query com 50K rows read roda só cerca de 100 vezes antes do limite.
- 100K rows written por dia, consumidas rápido em carga com muitas escritas.
- 5 GB de armazenamento total por conta.
Considere Workers Paid quando:
- Rows read se aproxima de 5M por dia. Queries Free falham depois; Paid inclui 25B mensais e cobra excedente.
- Rows written se aproxima de 100K por dia; Paid inclui 50M por mês.
- Armazenamento passa de 5 GB; o excesso custa $0.75/GB-month.
D1 é forte para dados relacionais leves próximos de Workers, não como padrão para qualquer carga de muitas escritas ou grande volume. Monitore rows read, rows written e storage.
Supabase Postgres: escolha BaaS prática
Cada projeto Supabase tem um banco Postgres completo, não abstração reduzida (documentação do Supabase Database). Auth, Storage, Realtime e Edge Functions se apoiam nele; continuam disponíveis queries complexas, foreign keys, triggers, transações, MVCC e extensões.
RLS para controlar acesso do cliente
Row Level Security é uma vantagem central do Supabase Postgres. Uma arquitetura tradicional reserva o banco ao servidor e faz o cliente usar uma API. Com policies e keys corretas, RLS aplica permissões por linha às queries do cliente.
RLS ajuda a:
- Controlar acesso: uma policy mostra apenas linhas cujo
user_idcorresponde ao usuário autenticado. - Projetar auditoria: RLS define a fronteira; tabela de auditoria, triggers ou logs registram quem fez o quê e quando.
- Reduzir lógica duplicada: regras podem morar no banco, mas o servidor ainda valida identidades, protege keys privilegiadas e revisa operações elevadas.
Isso atende fatos de negócio, aplicações com permissões, SaaS multiusuário, pedidos e direitos. RLS é uma fronteira do banco, não substitui schema ou auditoria.
Backups e recuperação
Em julho de 2026, os planos oficiais do Supabase indicam:
| Item | Free | Pro | Team |
|---|---|---|---|
| Tamanho do banco | 500 MB por projeto incluídos | 8 GB incluídos; depois excedente | 8 GB incluídos; depois excedente |
| Preço | $0 | $25/mês | $599/mês |
| Backups automáticos | Não incluídos | Diários, 7 dias | Diários, 14 dias |
| PITR | Não incluído | Complemento pago, cerca de $100/mês para 7 dias | Complemento pago, cerca de $100/mês para 7 dias |
Três consequências práticas:
- Um projeto Free não pode tratar backup da plataforma como plano de recuperação. Rode
supabase db dumpoupg_dumpregularmente e guarde cópia externa. - Pro e Team têm backups diários, mas podem perder mudanças depois do último.
- PITR não vem incluído no Pro. Exige pelo menos Small compute e é cobrado separadamente por 7, 14 ou 28 dias.
O tamanho sozinho não decide o plano. Para pedidos e direitos, defina primeiro RPO, RTO e frequência de testes; depois escolha entre backup diário e PITR.
D1 contra Supabase: permissões e recuperação
| Dimensão | D1 | Supabase Postgres |
|---|---|---|
| Posição | Banco serverless Workers-native | BaaS Postgres gerenciado |
| Acesso | Sem RLS nativo | RLS pode proteger queries do cliente |
| Recuperação | Time Travel: Free 7 dias, Paid 30 dias | Backups diários no Pro/Team/Enterprise; PITR pago |
| Melhor uso | Dados relacionais leves em Workers | Fatos de negócio, SaaS multiusuário, pedidos, direitos |
| Cobrança | Rows read/written e armazenamento | Armazenamento, compute e uso do plano |
Podem coexistir:
- D1 guarda configuração na borda com muitas leituras, contadores e domínios.
- Supabase Postgres guarda usuários, pedidos, direitos e pagamentos.
Uma ferramenta SaaS pode manter configuração e contadores no D1, e usuários e direitos no Postgres. D1 fica perto de Workers; Postgres traz permissões, constraints e recovery maduros.
R2: armazenamento de objetos sem custo de egress do R2
R2 é o armazenamento compatível com S3 da Cloudflare. Transferências diretas de R2 via Workers API, S3 API ou r2.dev para Internet não geram custo de egress do R2 (preços do R2); outro serviço medido conectado pode cobrar. R2 serve uploads, resultados e exportações, mas saída gratuita não torna storage e operações gratuitos.
Cobrança das operações Class A/B
R2 cobra armazenamento, operações Class A e Class B. Infrequent Access adiciona taxa de recuperação.
Em julho de 2026, a tabela mostra:
| Item | Cota gratuita | Standard | Infrequent Access |
|---|---|---|---|
| Armazenamento | 10 GB-month/mês | $0.015/GB-month | $0.01/GB-month |
| Operações Class A | 1M/mês | $4.50/million | $9.00/million |
| Operações Class B | 10M/mês | $0.36/million | $0.90/million |
| Recuperação | Nenhuma | Nenhuma | $0.01/GB |
| Saída para Internet | Grátis | Grátis | Grátis |
| Duração mínima | Nenhuma | Nenhuma | 30 dias |
As classes incluem:

- Class A, mais cara:
PutObject,CopyObject,ListObjectse transições de lifecycle. Escritas e listagens entram aqui. - Class B, mais barata:
GetObject,HeadObjecteHeadBucket. Leituras entram aqui. - Operações gratuitas:
DeleteObject,DeleteBucketeAbortMultipartUpload.
O que a cota gratuita do R2 não significa
10 GB-month não é armazenamento ilimitado:
- Storage: mede capacidade durante o período, não tráfego. Mais dados exigem pagamento ou limpeza.
- Class A: 1M de operações mensais atende muitos sites pequenos, mas uploads em lote podem consumir rápido.
- Class B: 10M de operações mensais cobre muita leitura, mas uma origem de imagens movimentada pode passar disso.
Infrequent Access tem duração mínima de 30 dias. Excluir antes não evita a cobrança mínima. A classe serve backups e objetos duráveis, não resultados temporários.
Adequado a uploads e resultados gerados
R2 atende:
- Arquivos de usuário como
uploads/2026/06/report.pdf, imagens e documentos, principalmente quando há muitos downloads. - Relatórios gerados, exportações e resultados de processamento de imagem.
- Dumps e snapshots que precisam ser recuperados com baixo custo.
- Projetos que usam Workers, D1, KV ou Vectorize.
R2 não atende:
- Fatos de negócio como usuários e pedidos, que exigem consultas estruturadas e controle de acesso.
- Cargas que precisam de S3 Object Lock, mais classes ou replicação AWS nativa entre buckets e regiões.
R2 contra S3
| Dimensão | R2 | S3 |
|---|---|---|
| Saída para Internet | Grátis do lado R2; serviços conectados podem cobrar | Depende de região, destino e uso; consulte preços AWS atuais |
| Armazenamento | $0.015/GB-month no Standard | Várias classes, incluindo Standard e Glacier |
| Ecossistema | Nativo de Workers e Pages | Integração profunda com AWS, incluindo Lambda |
| Governança | Lifecycle, Standard/IA e eventos por Queue | Object Lock, classes Glacier, lifecycle, Replication e vários destinos |
| Melhor uso | Ecossistema Cloudflare e entrega sensível à saída | Ecossistema AWS, governança, data lakes e apps empresariais |
Escolha R2 quando:
- Downloads tornam o custo de saída relevante.
- O app já roda em Workers ou Pages.
Escolha S3 quando:
- Lambda, data lakes ou fluxos empresariais dependem da AWS.
- São necessários Object Lock, mais classes Glacier, replicação regional ou governança IAM da AWS.
- O conjunto AWS com CloudWatch, IAM e operações em lote agrega valor.
R2 e S3 não são substitutos completos. Um produto Cloudflare pode guardar arquivos CDN e resultados no R2 e arquivos sujeitos a governança no S3.
S3: ecossistema AWS e governança
Amazon S3 é um serviço de armazenamento de objetos para data lakes, sites, aplicativos móveis, backup/restore, arquivos, aplicações empresariais, IoT e analytics (Amazon S3 User Guide). Ele oferece:
- Classes como Standard, Intelligent-Tiering, Glacier e Glacier Deep Archive.
- Regras de lifecycle que movem ou expiram objetos automaticamente.
- Object Lock com retenção WORM contra substituição e exclusão.
- Same-Region e Cross-Region Replication para recovery, latência e governança.
- IAM, políticas de bucket e Block Public Access.
- Notificações de eventos para Lambda e outros destinos AWS.
Adequado a integração AWS e governança
S3 atende:
- Produtos que já usam Lambda, EC2, RDS ou DynamoDB.
- Requisitos de Object Lock, classes de arquivo e retenção formal.
- Data lakes e pipelines IoT dependentes de analytics AWS.
- Backups, restores e arquivos longos gerenciados por lifecycle.
S3 atende menos quando:
- Muitos downloads tornam o custo de saída sensível; use preços AWS atuais para região, destino, cache e volume.
- O app é nativo de Cloudflare e acessa R2 direto de Workers ou Pages.
S3 contra R2: profundidade do ecossistema e governança
A vantagem do S3 é a amplitude de integrações AWS e governança:
- Destinos de eventos: S3 Event Notifications envia para SNS, SQS, Lambda e EventBridge. R2 também envia object-create e object-delete para Cloudflare Queues, consumidas por Worker ou HTTP pull.
- Classes: S3 oferece várias classes Glacier; R2 se concentra hoje em Standard e Infrequent Access.
- Object Lock: retenção WORM impede substituir ou excluir durante o período.
- Replication: S3 copia objetos, metadata e tags para bucket da mesma região ou de outra.
Escolha S3 quando:
- Lambda, data lakes ou apps empresariais dependem da AWS.
- É necessário Object Lock, classes Glacier ou governança lifecycle.
- Arquivos de longo prazo se beneficiam da família Glacier.
Escolha R2 quando:
- Uploads e resultados são baixados com frequência.
- Workers e Pages são o runtime principal.
Uma arquitetura mista pode pôr arquivos CDN e resultados no R2 e backups sujeitos a governança no S3. Tipo e acesso decidem, não uma regra de fornecedor único.
SQLite: primeiro local e embarcado
SQLite serve dados locais, arquivos de aplicação, sites de tráfego baixo ou médio, análise e caches (quando usar SQLite). Ele não concorre diretamente com bancos SQL cliente/servidor. Estes priorizam repositório compartilhado, concorrência, centralização e controle; SQLite prioriza dados locais de um usuário em arquivo copiável.
Adequado a ferramentas de um usuário e backends locais
SQLite atende:
- Ferramentas de um usuário, painéis locais, utilitários de análise, jogos pequenos e conjuntos em um arquivo.
- Formatos de arquivo de aplicações CAD, finanças ou gestão de mídia.
- Sites de tráfego baixo ou médio. SQLite diz que menos de 100K hits/dia costuma funcionar, mas é observação conservadora, não garantia. Hardware, complexidade e escritas concorrentes definem a capacidade.
- Dados locais como
local-dev.sqlite. - Caches e cálculos temporários sem estado compartilhado durável.
SQLite atende menos:
- SaaS multiusuário com permissões, escritas concorrentes e auditoria.
- Pedidos e direitos que exigem backup maduro e recuperação temporal.
- Alta concorrência de escrita, pois SQLite aceita muitos leitores, mas um writer por vez.
SQLite contra Postgres: sinais de migração
| Dimensão | SQLite | Postgres |
|---|---|---|
| Posição | Dados locais e arquivo de aplicação | Repositório cliente/servidor compartilhado |
| Melhor uso | Ferramentas de um usuário, jogos, painéis locais | SaaS multiusuário, pedidos, direitos |
| Concorrência | Um writer, muitos leitores | Vários writers com MVCC |
| Permissões | Sem gestão integrada de usuários | RLS e gestão de usuários/roles |
| Custo | Sem servidor de banco separado | Depende de hospedagem própria ou plano gerenciado, compute e backups |
Mude de SQLite para Postgres quando:
- Uma ferramenta de um usuário vira SaaS multiusuário e precisa de permissões.
- Vários usuários ou instâncias alteram o mesmo estado ao mesmo tempo.
- Pagamentos introduzem pedidos e direitos que precisam de auditoria e restauração testada.
- Um modelo
users/roles/permissionsprecisa de controle no banco.
Um painel pessoal pode ficar no SQLite. Quando vários clientes pagantes compartilham o serviço, Postgres normalmente define uma fronteira mais clara.
SQLite não substitui Postgres
O próprio SQLite diz que não pretende substituir um banco SQL cliente/servidor:
- SQLite otimiza simplicidade local de um usuário e banco copiável como arquivo.
- Postgres otimiza repositório multiusuário com alterações concorrentes e registros críticos para pagamento.
SQLite não exige servidor de banco separado. O custo do Postgres depende de hospedagem própria ou serviço gerenciado, compute, armazenamento e backups. Ambos precisam de processo de restore testado.
Escolha SQLite para:
- Utilitários locais e jogos pequenos sem pagamento nem permissões.
- Fixtures de desenvolvimento e dados temporários.
- Sites pessoais e ferramentas de documentação com poucas escritas concorrentes.
Escolha Postgres para:
- SaaS multiusuário com pedidos, assinaturas e permissões.
- Alterações operacionais e de direitos que precisam de auditoria.
- Dados de negócio que exigem recuperação temporal configurável.
Podem coexistir: SQLite no desenvolvimento local ou caches recriáveis, Postgres para fatos de negócio em produção.
Três erros a evitar
As falhas mais comuns são guardar fatos de negócio como objetos, ignorar a cobrança do D1 por leitura e tratar a cota gratuita do R2 como ilimitada. Elas dificultam recovery, desaceleram queries e tornam custos imprevisíveis.
Erro 1: guardar fatos de negócio no armazenamento de objetos
Tabelas como users, orders e usage_events sujeitos a auditoria não ficam no R2 ou S3. Armazenamento de objetos não oferece queries relacionais, constraints, permissão por linha nem padrões de auditoria de banco.
As consequências são concretas:
- Sem SELECT ou JOIN: o armazenamento usa keys. Para responder
SELECT * FROM orders WHERE user_id = ? LIMIT 20, o app teria de listar e baixar objetos de pedidos. - Restauração difícil: coleção de arquivos não é histórico transacional. Dump SQL ou sistema point-in-time gerenciado oferece recovery mais coerente.
- Exportação lenta: query de banco transmite registros filtrados; objeto por pedido pode exigir percorrer muitos arquivos.
Fatos de negócio ficam no banco e arquivos no armazenamento. O banco guarda uma object key estável; R2, S3 ou Supabase Storage contém o arquivo.
Erro 2: ignorar a cobrança rows read
D1 conta linhas percorridas, não devolvidas. Um filtro sem índice pode consumir muito mais rows read do que o resultado sugere.
Em 50.000 linhas de orders, SELECT * FROM orders WHERE user_id = ? LIMIT 20 pode ler muitas linhas sem índice. meta.rows_read mostra o uso cobrado. Queries Free falham após 5M diários; Paid cobra acima da cota mensal.
Correção:
- Indexe a coluna real, por exemplo
CREATE INDEX idx_user_id ON orders(user_id);. - Verifique com
EXPLAIN QUERY PLANemeta.rows_readse resta full-table scan. - Selecione só as colunas necessárias para reduzir resposta, lembrando que D1 conta linhas, não colunas.
Erro 3: considerar ilimitada a cota gratuita do R2
R2 Free inclui hoje 10 GB-month de Standard storage, 1M operações Class A e 10M Class B por mês. São cotas.
Erros comuns:
- 10 GB-month mede capacidade armazenada ao longo do tempo, não transferência.
PutObjecté Class A. Criação em lote pode esgotar a cota mesmo com volume total pequeno.- Infrequent Access exige 30 dias mínimos; excluir antes ainda cobra esse mínimo.
Monitore armazenamento e operações, expire resultados antigos e não use Infrequent Access para temporários. SQLite local ou cache pode ser melhor para dados curtos.
Conclusão
O tipo decide: fatos de negócio, eventos, objetos, caches, dados locais, dados leves na borda e backups. Supabase Postgres normalmente guarda os fatos por constraints, RLS, recuperação configurável e auditoria. D1 atende dados relacionais leves próximos de Workers, R2/S3 atendem objetos e SQLite dados locais de um usuário.
Três ações deixam a primeira versão mais segura:
- Classifique cada objeto e registre queries, permissões, frequência e requisitos de custo.
- Indexe colunas de filtro no D1 e verifique com métricas rows read.
- Mantenha registros de negócio fora do armazenamento de objetos, evite scans sem índice e estime toda a cota R2, não só storage.
Os próximos artigos tratam pagamentos e usuários. Eles reforçam a fronteira: pedidos precisam de constraints Postgres, backups e auditoria; direitos e permissões de usuários precisam de RLS e recuperação testada.
Se o destino ainda estiver incerto, volte à tabela e aos artigos anteriores sobre princípios de arquitetura, backend e implantação. Defina a fronteira do sistema antes de refinar o armazenamento.
Definir o armazenamento de um projeto solo
Separe em seis etapas, do inventário ao teste de restauração, as responsabilidades do banco e do armazenamento de objetos.
- 1
Step 1: Inventariar os objetos
Liste users, orders, usage_events, uploads, caches, arquivos locais e backups sem agrupá-los primeiro por produto. - 2
Step 2: Classificar cada objeto
Marque cada item como fato de negócio, evento, arquivo de objeto, cache, dado local ou backup e registre se pode expirar ou ser recriado. - 3
Step 3: Definir consistência e permissões
Registre transações, constraints, RLS, escritas concorrentes, auditoria e compartilhamento entre instâncias para escolher Postgres ou D1. - 4
Step 4: Estimar acesso e custo
Estime D1 rows read/written, R2 Class A/B operations, volume, frequência de leitura e possíveis custos de saída. - 5
Step 5: Projetar referências estáveis
Guarde object key, owner, status e metadata no banco, o conteúdo no armazenamento de objetos e mantenha os nomes das keys estáveis. - 6
Step 6: Testar backup e migração
Prepare exportações, cópias externas, janelas de exclusão e testes de restore; migre metadata, depois objetos e por fim o caminho de leitura.
FAQ
Um projeto solo deve começar com D1 ou Supabase Postgres?
O que deve ficar no R2 ou S3?
SQLite pode sustentar o primeiro SaaS?
Uploads de usuários podem ficar no banco?
O que significa a cobrança de D1 rows read?
A camada gratuita do Cloudflare R2 é suficiente?
19 min de leitura · Publicado em: 9 out 2026

Guia de stack tecnico para solo founders
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.


Comentários
Entre com GitHub para comentar