Scegliere il database da soli: D1, Postgres, R2, S3 o SQLite
"La pagina ufficiale dei prezzi di D1 descrive rows read/written, limiti di storage, effetto degli indici sulle righe scansionate e comportamento quando Free raggiunge il limite giornaliero."
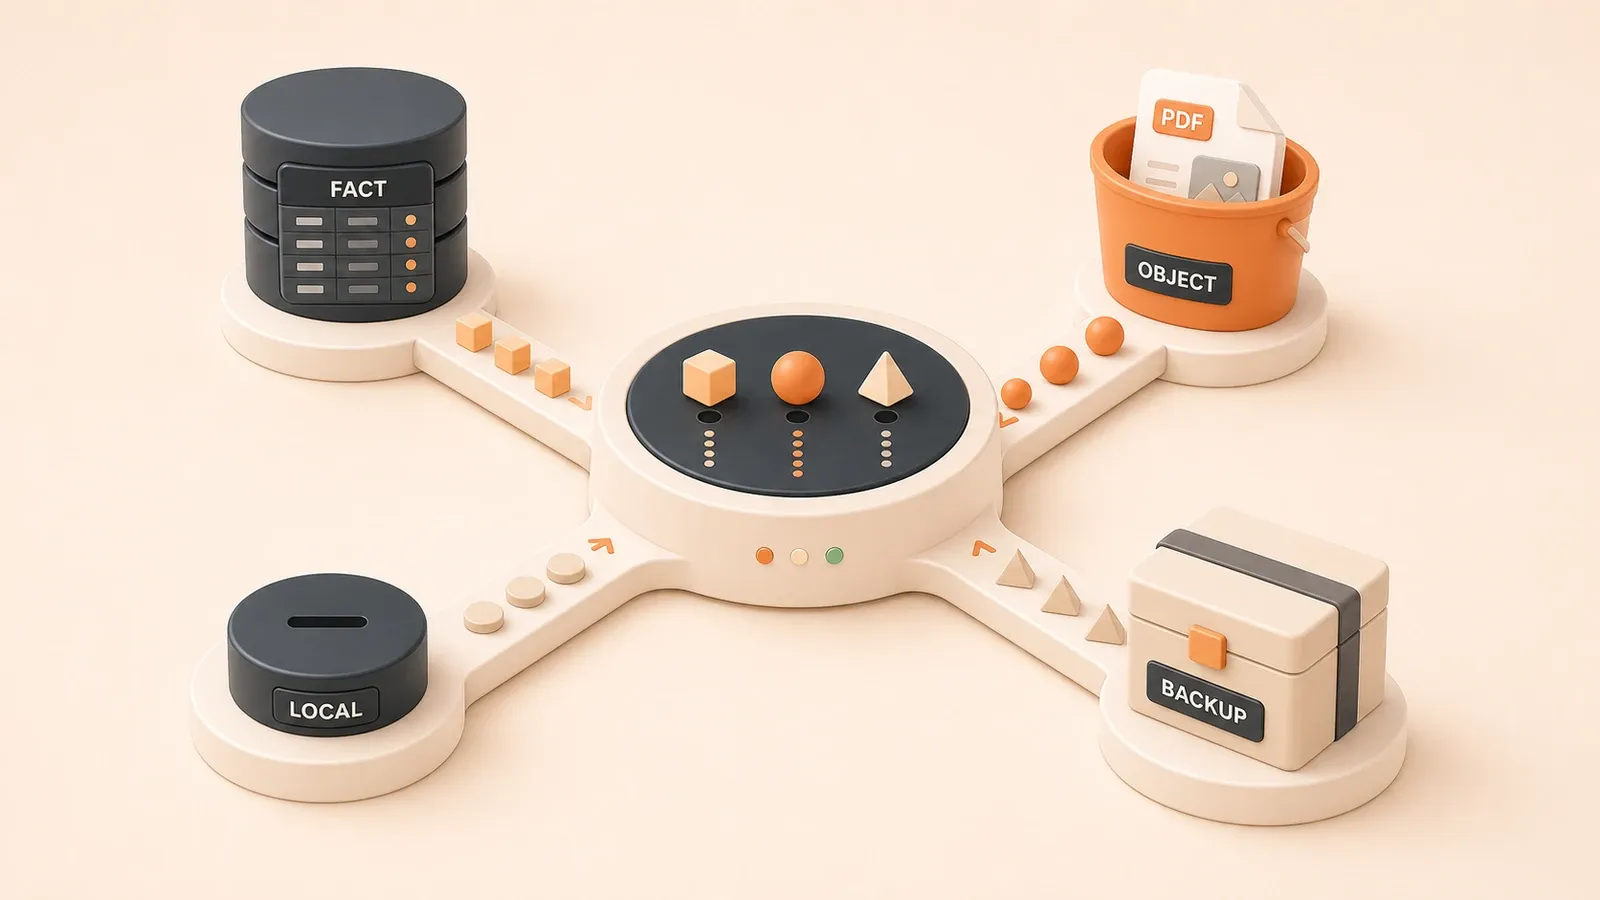
Il progetto contiene una tabella users, orders, usage_events, un upload in uploads/2026/06/report.pdf, la cache cache:daily-stats e dati locali in local-dev.sqlite. Dove dovrebbe vivere ogni oggetto? Se i fatti di business diventano file nell’object storage, backup, query ed esportazioni si complicano rapidamente. In D1, filtri senza indice consumano presto rows read e possono generare costi extra nel piano Paid. La scelta deve quindi partire dal tipo di dato.
Tabella di collocazione: dove salvare ogni dato
Anche in un progetto individuale, oggetti diversi richiedono sistemi diversi. I fatti di business hanno bisogno di query, relazioni e controllo degli accessi. Gli eventi richiedono scritture affidabili e conservazione economica. I file oggetto richiedono permessi di download, ciclo di vita e un modello di costo adatto al traffico. Bisogna capire se servono query strutturate e permessi, la frequenza di accesso e la sensibilità ai costi di uscita.
La tabella offre un punto di partenza pratico.
Sette tipi di dati e relative opzioni
| Tipo di dato | Oggetti concreti | Storage consigliato | Criterio |
|---|---|---|---|
| Fatti di business | users, orders, diritti di abbonamento, pagamenti | Supabase Postgres prima scelta, o D1 nei casi semplici | Query strutturate (SELECT/JOIN), permessi (RLS), backup o ripristino temporale adatto al piano e audit |
| Eventi | usage_events, azioni operative, statistiche | D1 per scritture edge o Postgres per audit | Scritture frequenti e query semplici; l’analisi ordinaria può avere priorità di recovery inferiore, non sicurezza e fatturazione |
| File oggetto | uploads/2026/06/report.pdf, risultati, esportazioni, immagini | R2 in Cloudflare, S3 in AWS o Supabase Storage | Niente blob nel DB; valutare egress R2, ecosistema S3 o integrazione Supabase Auth/Postgres |
| Cache | cache:daily-stats, stato breve, calcoli temporanei | Cloudflare KV, D1 o SQLite locale | Accessi frequenti e dati normalmente eliminabili o rigenerabili; KV/D1 all’edge, SQLite locale |
| Dati locali | local-dev.sqlite, test, amministrazione per una persona | File SQLite | Un utente, nessun sistema di permessi, facile da copiare ed eseguire |
| Dati edge leggeri | Contatori Workers, configurazioni, mappature di domini | D1 o Cloudflare KV | Accesso nativo Workers, relazioni leggere, prevalenza di letture |
| Backup | Dump del database, snapshot di esportazione | R2/S3 più copia locale | Modello egress R2, governance/lifecycle S3 e copia indipendente contro guasti del provider |
Perché i fatti di business iniziano spesso in Postgres
Utenti, ordini, diritti di abbonamento e pagamenti sono record centrali. Perderli cambia accesso dei clienti e ricavi. Servono:
- Query strutturate: un database relazionale esegue SELECT, JOIN, WHERE e ORDER BY; un object storage no.
- Controllo accessi: Supabase Postgres può applicare Row Level Security alle query dei client. D1 oggi non offre RLS nativo.
- Backup e ripristino: Supabase Pro, Team ed Enterprise hanno backup giornalieri; PITR è un add-on a pagamento da attivare separatamente. D1 Time Travel conserva 7 giorni in Workers Free e 30 in Workers Paid.
- Audit trail: trigger e tabelle di audit dedicate per cambi a pagamenti e diritti sono più semplici in Postgres.
Supabase Postgres non è un’astrazione limitata. Ogni progetto riceve un database Postgres completo, fondamento di Auth, Storage, Realtime ed Edge Functions (documentazione Supabase Database). Le normali capacità di Postgres restano disponibili.
Separare eventi e record di business
usage_events, azioni operative e statistiche di accesso si comportano diversamente:
- Vengono scritti spesso; le query comuni filtrano intervalli o aggregano valori.
- Le analisi non soggette ad audit possono avere priorità di ripristino inferiore, ma richiedono regole esplicite di conservazione e perdita. Sicurezza, fatturazione e diritti non sono semplici page view.
- Molte scritture consumano quote di rows written e storage.
Il confine è concreto:
- Se l’evento fa parte di un audit trail con
user_ideaction, usa Postgres. - Se è solo un contatore o un segnale analitico rigenerabile, D1 o KV può bastare.
Non mettere i file oggetto nel database
Upload, risultati generati, archivi di esportazione e immagini non dovrebbero stare in una colonna blob:
- Costo dei backup: ogni blob entra nel backup e aumenta tempo e volume.
- Carico delle query: mescolare oggetti grandi e righe relazionali aumenta trasferimento, cache, backup e manutenzione; una query ampia può restituire il file per errore.
- Distribuzione CDN: l’object storage si integra meglio con CDN, regole cache e download firmati; un blob richiede spesso un proxy applicativo.
- Egress: servire un blob usa banda del database e dell’app. Il trasferimento diretto da R2 a Internet non ha costo egress R2; S3 dipende da regione e destinazione.
Il database conserva solo l’object key, per esempio uploads/2026/06/report.pdf. Il file resta in R2, S3 o Supabase Storage.
Cache e dati locali di sviluppo
Una cache come cache:daily-stats, uno stato breve o un calcolo temporaneo ha spesso queste caratteristiche:
- Letture e scritture frequenti, ma normalmente può scadere o essere rigenerata. Le sessioni sensibili richiedono regole proprie di coerenza, scadenza e revoca.
- La cache rigenerabile in genere non entra nei backup del database di business; revoche di sessione e altri stati di sicurezza richiedono persistenza separata.
- L’accesso edge è sensibile alla latenza.
Opzioni pratiche:
- Cloudflare KV o D1 per una cache edge leggera in Workers.
- File SQLite o cache in memoria nello sviluppo locale.
local-dev.sqlite è un caso monoutente senza sistema di permessi:
- SQLite è pensato per dati locali e file applicativi (quando usare SQLite).
- Non risolve lo stesso problema di un database client/server: SQLite privilegia locale e monoutente; Postgres un repository condiviso multiutente.
Dati edge leggeri e backup
D1 o KV è un buon inizio per contatori Workers, piccole configurazioni e mappature di domini:
- Accesso nativo: binding Worker o API HTTP senza pool di connessioni separato.
- Relazioni leggere: schema semplice senza JOIN complessi o grande rete di foreign key.
- Prevalenza di lettura: molte più letture che scritture.
Le esportazioni di backup richiedono recupero economico e copia indipendente:
- R2 non addebita egress R2 per download diretti verso Internet.
- S3 offre Object Lock, varie classi di archivio e gestione del ciclo di vita.
- Una copia locale o presso un altro provider protegge da guasti di account e piattaforma. L’unica copia di restore non deve stare accanto alla produzione.
D1: database serverless nativo di Workers
D1 è il database serverless gestito di Cloudflare con semantica SQL di SQLite (panoramica D1). Le capacità principali sono:
- Time Travel: ripristino a qualsiasi minuto degli ultimi 7 giorni in Workers Free o 30 giorni in Workers Paid. Il restore sovrascrive il database, quindi va verificato l’orario.
- Read replication: riduce latenza e amplia la capacità di lettura per carichi con molte letture.
- Accesso Workers e API HTTP: binding o API senza gestire un pool di connessioni proprio.
- Disaster recovery integrato: Cloudflare gestisce storico e meccanismo di ripristino.
Adatto ad app Workers-native con molte letture
D1 è adatto a:

- Progetti Workers o Pages che evitano di attraversare un’altra piattaforma per ogni query.
- Dati relazionali leggeri come configurazione, contatori e mappature senza rete complessa di relazioni.
- Carichi dominati dalle letture che possono scalare con repliche.
- Progetti che usano già Workers, R2, KV o Vectorize e richiedono un livello relazionale nello stesso ecosistema.
D1 è meno adatto a:
- SaaS multiutente che richiedono permessi maturi e RLS.
- Ordini e diritti di abbonamento che richiedono vincoli, audit e restore verificato. Postgres è spesso il punto di partenza più sicuro; la finestra dipende da piano e add-on.
- Sistemi ricchi di audit che dipendono da trigger e pattern Postgres.
Fatturazione rows read: righe scansionate, non restituite
D1 fattura rows read, rows written e storage. Rows read sono le righe scansionate dalla query, non quelle restituite.
A luglio 2026, la pagina ufficiale mostra le seguenti quote e tariffe. Vanno ricontrollate prima della pubblicazione o di una decisione importante.
| Voce | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/giorno | Primi 25B/mese inclusi |
| Rows written | 100K/giorno | Primi 50M/mese inclusi |
| Storage | 5 GB totali | Primi 5 GB inclusi, poi $0.75/GB-month |
| Eccedenza rows read | Non disponibile | $0.001/million rows read |
| Eccedenza rows written | Non disponibile | $1/million rows written |
| Egress/banda | Nessun costo separato | Nessun costo separato |
Se SELECT * FROM orders WHERE user_id = ? LIMIT 20 gira su 50.000 righe senza indice su user_id, D1 può scansionare quasi tutta la tabella per restituirne 20. Rows read si avvicina a 50.000, non a 20.
Un filtro senza indice può quindi scansionare tutta la tabella per pochi risultati. Consulta meta.rows_read dell’esecuzione reale, non il numero di risultati.
Indici ed efficienza delle query
Per controllare rows read:
- Crea un indice come
CREATE INDEX idx_user_id ON orders(user_id);perché D1 legga il sottoinsieme indicizzato. Controllameta.rows_read. - Seleziona solo le colonne necessarie per ridurre risposta e accoppiamento. D1 conta però le righe scansionate, non le colonne; indici e filtri riducono rows read.
- Confronta
rows_readcon le righe restituite. Ilmetae il dashboard espongono rows read/written per individuare scansioni complete.
Indicazioni per gli indici:
- Indicizza colonne usate in WHERE come
user_idecreated_at. - Indicizza chiavi di JOIN come
order_ideproduct_id. - Evita indici inutili, perché INSERT e UPDATE possono scrivere anche righe di indice.
- Controlla nel dashboard D1 le query con rows read insolitamente elevato.
Quota gratuita D1 e segnali di passaggio
Workers Free limita oggi D1 a:
- 5M rows read al giorno. Una query da 50K rows read gira circa 100 volte prima del limite.
- 100K rows written al giorno, consumate rapidamente da carichi con molte scritture.
- 5 GB di storage totale per account.
Valuta Workers Paid quando:
- Rows read si avvicina a 5M al giorno. Le query Free falliscono dopo; Paid include 25B mensili e addebita l’eccedenza.
- Rows written si avvicina a 100K al giorno; Paid include 50M al mese.
- Lo storage supera 5 GB; l’eccedenza costa $0.75/GB-month.
D1 è forte per dati relazionali leggeri vicini a Workers, non come default per qualsiasi carico con molte scritture o grande volume. Monitora rows read, rows written e storage.
Supabase Postgres: scelta BaaS pratica
Ogni progetto Supabase ha un database Postgres completo, non un’astrazione ridotta (documentazione Supabase Database). Auth, Storage, Realtime ed Edge Functions si basano su di esso; restano disponibili query complesse, foreign key, trigger, transazioni, MVCC ed estensioni.
RLS per controllare l’accesso client
Row Level Security è un vantaggio importante di Supabase Postgres. Un’architettura tradizionale riserva il database al server e fa usare un’API al client. Con policy e chiavi corrette, RLS applica permessi per riga alle query client.
RLS aiuta a:
- Controllare l’accesso: una policy mostra solo le righe il cui
user_idcorrisponde all’utente autenticato. - Progettare l’audit: RLS definisce il confine; tabella di audit, trigger o log registrano chi ha fatto cosa e quando.
- Ridurre logica duplicata: le regole possono vivere nel database, ma il server continua a verificare identità, proteggere chiavi privilegiate e controllare operazioni elevate.
È adatto a fatti di business, app con permessi, SaaS multiutente, ordini e diritti di abbonamento. RLS è un confine del database, non sostituisce schema o audit.
Backup e ripristino
A luglio 2026, i piani ufficiali Supabase indicano:
| Voce | Free | Pro | Team |
|---|---|---|---|
| Dimensione database | 500 MB inclusi per progetto | 8 GB inclusi, poi eccedenza | 8 GB inclusi, poi eccedenza |
| Prezzo | $0 | $25/mese | $599/mese |
| Backup automatici | Non inclusi | Giornalieri, 7 giorni | Giornalieri, 14 giorni |
| PITR | Non incluso | Add-on a pagamento, circa $100/mese per 7 giorni | Add-on a pagamento, circa $100/mese per 7 giorni |
Tre conseguenze pratiche:
- Un progetto Free non può considerare i backup della piattaforma come piano di ripristino. Esegui regolarmente
supabase db dumpopg_dumpe conserva una copia esterna. - Pro e Team hanno backup giornalieri, ma possono perdere modifiche successive all’ultimo.
- PITR non è incluso in Pro. Richiede almeno Small compute ed è addebitato a parte per 7, 14 o 28 giorni.
La dimensione da sola non decide il piano. Per ordini e diritti, definisci prima RPO, RTO e frequenza dei test, poi scegli tra backup giornaliero e PITR.
D1 rispetto a Supabase: permessi e ripristino
| Dimensione | D1 | Supabase Postgres |
|---|---|---|
| Posizione | Database serverless Workers-native | BaaS Postgres gestito |
| Accesso | Nessun RLS nativo | RLS può proteggere le query client |
| Ripristino | Time Travel: Free 7 giorni, Paid 30 giorni | Backup giornalieri Pro/Team/Enterprise; PITR a pagamento |
| Uso adatto | Dati relazionali leggeri in Workers | Fatti di business, SaaS multiutente, ordini, diritti |
| Fatturazione | Rows read/written e storage | Storage, compute e uso del piano |
Possono convivere:
- D1 conserva configurazione edge con molte letture, contatori e domini.
- Supabase Postgres conserva utenti, ordini, diritti e pagamenti.
Uno strumento SaaS può tenere configurazione e contatori in D1, utenti e diritti in Postgres. D1 resta vicino a Workers; Postgres offre permessi, vincoli e ripristino maturi.
R2: object storage senza costo egress R2
R2 è lo storage compatibile S3 di Cloudflare. I trasferimenti diretti da R2 tramite Workers API, S3 API o r2.dev a Internet non generano costo egress R2 (prezzi R2); un altro servizio a consumo collegato può addebitare. R2 serve upload, risultati ed esportazioni, ma egress gratuito non significa storage e operazioni gratis.
Fatturazione delle operazioni Class A/B
R2 fattura storage, operazioni Class A e Class B. Infrequent Access aggiunge costi di recupero.
A luglio 2026, la tabella indica:
| Voce | Quota gratuita | Standard | Infrequent Access |
|---|---|---|---|
| Storage | 10 GB-month/mese | $0.015/GB-month | $0.01/GB-month |
| Operazioni Class A | 1M/mese | $4.50/million | $9.00/million |
| Operazioni Class B | 10M/mese | $0.36/million | $0.90/million |
| Recupero | Nessuno | Nessuno | $0.01/GB |
| Uscita Internet | Gratuita | Gratuita | Gratuita |
| Durata minima | Nessuna | Nessuna | 30 giorni |
Le classi includono:
- Class A, più costosa:
PutObject,CopyObject,ListObjectse transizioni lifecycle. Scritture e liste rientrano qui. - Class B, meno costosa:
GetObject,HeadObjecteHeadBucket. Le letture rientrano qui. - Operazioni gratuite:
DeleteObject,DeleteBucketeAbortMultipartUpload.
Cosa non significa la quota gratuita R2
10 GB-month non è storage illimitato:
- Storage: misura la capacità durante il periodo, non il traffico. Più dati richiedono pagamento o pulizia.
- Class A: 1M di operazioni mensili copre molti siti piccoli, ma upload in batch possono consumarle presto.
- Class B: 10M di operazioni mensili copre molte letture, ma un’origine immagini trafficata può superarle.
Infrequent Access ha una durata minima di 30 giorni. Eliminare prima non evita il minimo. È adatto a backup e oggetti duraturi, non a risultati temporanei.
Adatto a upload e risultati generati
R2 è adatto a:
- File utente come
uploads/2026/06/report.pdf, immagini e documenti, soprattutto con molti download. - Report generati, esportazioni e risultati di elaborazione immagini.
- Dump e snapshot da recuperare a basso costo.
- Progetti che usano Workers, D1, KV o Vectorize.
R2 non è adatto a:
- Fatti di business come utenti e ordini, che richiedono query strutturate e controllo degli accessi.
- Carichi che richiedono S3 Object Lock, più classi o replica AWS nativa tra bucket e regioni.
R2 rispetto a S3
| Dimensione | R2 | S3 |
|---|---|---|
| Uscita Internet | Gratuita lato R2; servizi collegati possono addebitare | Dipende da regione, destinazione e uso; consultare i prezzi AWS correnti |
| Storage | $0.015/GB-month in Standard | Varie classi, incluse Standard e Glacier |
| Ecosistema | Nativo in Workers e Pages | Integrazione AWS profonda, compresa Lambda |
| Governance | Lifecycle, Standard/IA ed eventi Queue | Object Lock, classi Glacier, lifecycle, Replication e varie destinazioni |
| Uso adatto | Ecosistema Cloudflare e delivery sensibile all’egress | Ecosistema AWS, governance, data lake e app aziendali |
Scegli R2 quando:
- I download rendono il costo di uscita importante.
- L’app gira già su Workers o Pages.
Scegli S3 quando:
- Lambda, data lake o flussi aziendali dipendono da AWS.
- Servono Object Lock, più classi Glacier, replica tra regioni o governance IAM AWS.
- L’insieme AWS con CloudWatch, IAM e operazioni batch porta valore.
R2 e S3 non sono sostituti completi. Un prodotto Cloudflare può tenere file CDN e risultati in R2, archivi soggetti a governance in S3.
S3: ecosistema AWS e governance
Amazon S3 è un servizio di object storage per data lake, siti, app mobili, backup/restore, archivi, app aziendali, IoT e analytics (Amazon S3 User Guide). Offre:
- Classi come Standard, Intelligent-Tiering, Glacier e Glacier Deep Archive.
- Regole lifecycle che spostano o eliminano oggetti automaticamente.
- Object Lock con conservazione WORM contro sovrascrittura ed eliminazione.
- Same-Region e Cross-Region Replication per recovery, latenza e governance.
- IAM, policy dei bucket e Block Public Access.
- Notifiche di eventi per Lambda e altre destinazioni AWS.
Adatto a integrazione AWS e governance
S3 è adatto a:
- Prodotti che usano già Lambda, EC2, RDS o DynamoDB.
- Requisiti di Object Lock, classi di archivio e conservazione formale.
- Data lake e pipeline IoT dipendenti dagli analytics AWS.
- Backup, restore e archivi lunghi gestiti dal lifecycle.
S3 è meno adatto quando:
- Molti download rendono sensibile il costo di uscita; usa i prezzi AWS correnti per regione, destinazione, cache e volume.
- L’app è nativa Cloudflare e accede direttamente a R2 da Workers o Pages.
S3 rispetto a R2: profondità di ecosistema e governance
Il vantaggio di S3 è l’ampiezza di integrazioni AWS e governance:
- Destinazioni eventi: S3 Event Notifications invia a SNS, SQS, Lambda ed EventBridge. R2 può inviare object-create e object-delete a Cloudflare Queues, consumate da Worker o HTTP pull.
- Classi: S3 offre più classi Glacier; R2 oggi si concentra su Standard e Infrequent Access.
- Object Lock: la conservazione WORM impedisce sovrascrittura o eliminazione nel periodo.
- Replication: S3 copia oggetti, metadata e tag in un bucket della stessa regione o di un’altra.
Scegli S3 quando:
- Lambda, data lake o app aziendali dipendono da AWS.
- Servono Object Lock, classi Glacier o governance lifecycle.
- Gli archivi lunghi beneficiano della famiglia Glacier.
Scegli R2 quando:
- Upload e risultati vengono scaricati spesso.
- Workers e Pages sono il runtime principale.
Un’architettura mista può mettere file CDN e risultati in R2, backup soggetti a governance in S3. Decidono tipo e accesso, non una regola mono-provider.
SQLite: prima locale ed embedded
SQLite è adatto a dati locali, file applicativi, siti a traffico basso o medio, analisi e cache (quando usare SQLite). Non compete direttamente con database SQL client/server. Questi privilegiano repository condiviso, concorrenza, centralizzazione e controllo; SQLite privilegia dati locali monoutente in un file copiabile.
Adatto a strumenti monoutente e backend locali
SQLite è adatto a:
- Strumenti monoutente, dashboard locali, utility di analisi, piccoli giochi e dataset in un file.
- Formati file di app CAD, finanza o gestione media.
- Siti a traffico basso o medio. SQLite indica che meno di 100K hits/giorno in genere funziona, ma è un’osservazione prudente, non una garanzia. Hardware, complessità e scritture concorrenti determinano la capacità.
- Dati locali come
local-dev.sqlite. - Cache e calcoli temporanei senza stato condiviso durevole.
SQLite è meno adatto a:
- SaaS multiutente con permessi, scritture concorrenti e audit.
- Ordini e diritti che richiedono backup maturi e ripristino temporale.
- Alta concorrenza di scrittura, perché SQLite accetta molti lettori ma un writer alla volta.
SQLite rispetto a Postgres: segnali di migrazione
| Dimensione | SQLite | Postgres |
|---|---|---|
| Posizione | Dati locali e file applicativo | Repository client/server condiviso |
| Uso adatto | Strumenti monoutente, giochi, dashboard locali | SaaS multiutente, ordini, diritti |
| Concorrenza | Un writer, molti lettori | Più writer con MVCC |
| Permessi | Nessuna gestione utenti integrata | RLS e gestione utenti/ruoli |
| Costo | Nessun server database separato | Dipende da self-hosting o piano gestito, compute e backup |
Passa da SQLite a Postgres quando:
- Uno strumento monoutente diventa SaaS multiutente e richiede permessi.
- Più utenti o istanze modificano lo stesso stato insieme.
- I pagamenti introducono ordini e diritti che richiedono audit e ripristino testato.
- Un modello
users/roles/permissionsrichiede controllo nel database.
Una dashboard personale può restare su SQLite. Quando più clienti paganti condividono il servizio, Postgres segna spesso un confine più chiaro.
SQLite non sostituisce Postgres
SQLite stesso indica di non voler sostituire un database SQL client/server:
- SQLite ottimizza semplicità locale monoutente e un database copiabile come file.
- Postgres ottimizza un repository multiutente con modifiche concorrenti e record critici per i pagamenti.
SQLite non richiede un server separato. Il costo di Postgres dipende da self-hosting o servizio gestito, compute, storage e backup. Entrambi richiedono un processo di restore testato.
Scegli SQLite per:

- Utility locali e piccoli giochi senza pagamenti né permessi.
- Fixture di sviluppo e dati temporanei.
- Siti personali e strumenti di documentazione con poche scritture concorrenti.
Scegli Postgres per:
- SaaS multiutente con ordini, abbonamenti e permessi.
- Modifiche operative e di diritti da sottoporre ad audit.
- Dati di business che richiedono ripristino temporale configurabile.
Possono convivere: SQLite per sviluppo locale o cache rigenerabili, Postgres per fatti di business in produzione.
Tre errori da evitare
Gli errori più comuni sono salvare fatti di business come oggetti, ignorare la fatturazione D1 per scansione e trattare la quota gratuita R2 come illimitata. Rendono difficile il recovery, rallentano le query e rendono i costi imprevedibili.
Errore 1: salvare fatti di business nell’object storage
Tabelle come users, orders e usage_events soggetti ad audit non vanno in R2 o S3. L’object storage non offre query relazionali, vincoli, permessi per riga né pattern di audit del database.
Le conseguenze sono concrete:
- Niente SELECT o JOIN: lo storage usa key. Per rispondere a
SELECT * FROM orders WHERE user_id = ? LIMIT 20, l’app dovrebbe elencare e scaricare gli oggetti ordine. - Restore difficile: una raccolta di file non è una cronologia transazionale. Un dump SQL o un sistema point-in-time gestito offre recovery più coerente.
- Esportazioni lente: una query può trasmettere i record filtrati; un oggetto per ordine può richiedere di scansionare molti file.
I fatti di business restano nel database e i file nell’object storage. Il database conserva un object key stabile; R2, S3 o Supabase Storage contiene il file.
Errore 2: ignorare la fatturazione rows read
D1 conta righe scansionate, non restituite. Un filtro senza indice può consumare molte più rows read di quanto suggerisca il risultato.
Su 50.000 righe orders, SELECT * FROM orders WHERE user_id = ? LIMIT 20 può leggere molte righe senza indice. meta.rows_read mostra l’uso fatturabile. Le query Free falliscono dopo 5M giornaliere; Paid addebita oltre la quota mensile.
Correzione:
- Indicizza la colonna reale, per esempio
CREATE INDEX idx_user_id ON orders(user_id);. - Verifica con
EXPLAIN QUERY PLANemeta.rows_readse resta una scansione completa. - Seleziona solo le colonne necessarie per ridurre la risposta, ricordando che D1 conta righe, non colonne.
Errore 3: considerare illimitata la quota gratuita R2
R2 Free include oggi 10 GB-month di Standard storage, 1M operazioni Class A e 10M Class B al mese. Sono quote.
Errori comuni:
- 10 GB-month misura la capacità conservata nel tempo, non il trasferimento.
PutObjectè Class A. La creazione in batch può esaurire la quota anche con volume totale ridotto.- Infrequent Access impone 30 giorni minimi; eliminare prima comporta comunque il costo minimo.
Monitora storage e operazioni, fai scadere i risultati vecchi e non usare Infrequent Access per temporanei. SQLite locale o cache può essere migliore per dati brevi.
Conclusione
Decide il tipo: fatti di business, eventi, oggetti, cache, dati locali, dati edge leggeri e backup. Supabase Postgres conserva spesso i fatti grazie a vincoli, RLS, ripristino configurabile e audit. D1 gestisce dati relazionali leggeri vicini a Workers, R2/S3 gli oggetti e SQLite i dati locali monoutente.
Tre azioni rendono più sicura la prima versione:
- Classifica ogni oggetto e registra query, permessi, frequenza e requisiti di costo.
- Indicizza le colonne filtro D1 e verifica con le metriche rows read.
- Tieni i record di business fuori dall’object storage, evita scansioni senza indice e stima tutta la quota R2, non solo lo storage.
I prossimi articoli trattano pagamenti e utenti. Rafforzano il confine: gli ordini richiedono vincoli Postgres, backup e audit; diritti e permessi utente richiedono RLS e ripristino testato.
Se la destinazione di un oggetto resta incerta, torna alla tabella e agli articoli precedenti su principi architetturali, backend e deployment. Definisci prima il confine del sistema, poi affina lo storage.
Assegnare lo storage a un progetto individuale
Separa in sei passaggi, dall'inventario al test di ripristino, i ruoli del database e dell'object storage.
- 1
Step 1: Inventariare gli oggetti
Elenca users, orders, usage_events, uploads, cache, file locali e backup senza raggrupparli subito per prodotto. - 2
Step 2: Classificare ogni oggetto
Segna ogni elemento come fatto di business, evento, file oggetto, cache, dato locale o backup e indica se può scadere o essere rigenerato. - 3
Step 3: Definire coerenza e permessi
Registra transazioni, vincoli, RLS, scritture concorrenti, audit e condivisione tra istanze per scegliere Postgres o D1. - 4
Step 4: Stimare accessi e costi
Stima D1 rows read/written, R2 Class A/B operations, volume, frequenza di lettura e possibili costi di egress. - 5
Step 5: Progettare riferimenti stabili
Conserva object key, owner, status e metadata nel database, il contenuto nell'object storage e nomi delle key stabili. - 6
Step 6: Testare backup e migrazione
Prepara esportazioni, copie esterne, finestre di eliminazione e prove di restore; migra metadata, poi oggetti e infine le letture.
FAQ
Un progetto individuale dovrebbe iniziare con D1 o Supabase Postgres?
Cosa va conservato in R2 o S3?
SQLite può sostenere il primo SaaS?
Gli upload degli utenti possono stare nel database?
Cosa significa la fatturazione D1 rows read?
Il livello gratuito di Cloudflare R2 è sufficiente?
19 min di lettura · Pubblicato il: 9 ott 2026

Guida allo stack tecnico per solo founder
Se arrivi dalla ricerca, il modo più veloce per orientarti è passare all’articolo precedente o successivo della stessa serie.
Precedente
Deploy per solo founder: Cloudflare, Vercel o Railway
Confronta Cloudflare Pages e Workers, Vercel e Railway per workload, limiti attuali, rischi di costo e manutenzione di uno stack gestito da una persona.
Parte 7 di 8
Successivo
Questo è l’articolo più recente della serie per ora.


Commenti
Accedi con GitHub per lasciare un commento