Choisir sa base de données en solo : D1, Postgres, R2, S3 ou SQLite
"La page tarifaire officielle de D1 décrit rows read/written, les quotas de stockage, l'effet des index sur les lignes parcourues et le comportement lorsque l'offre Free atteint sa limite quotidienne."
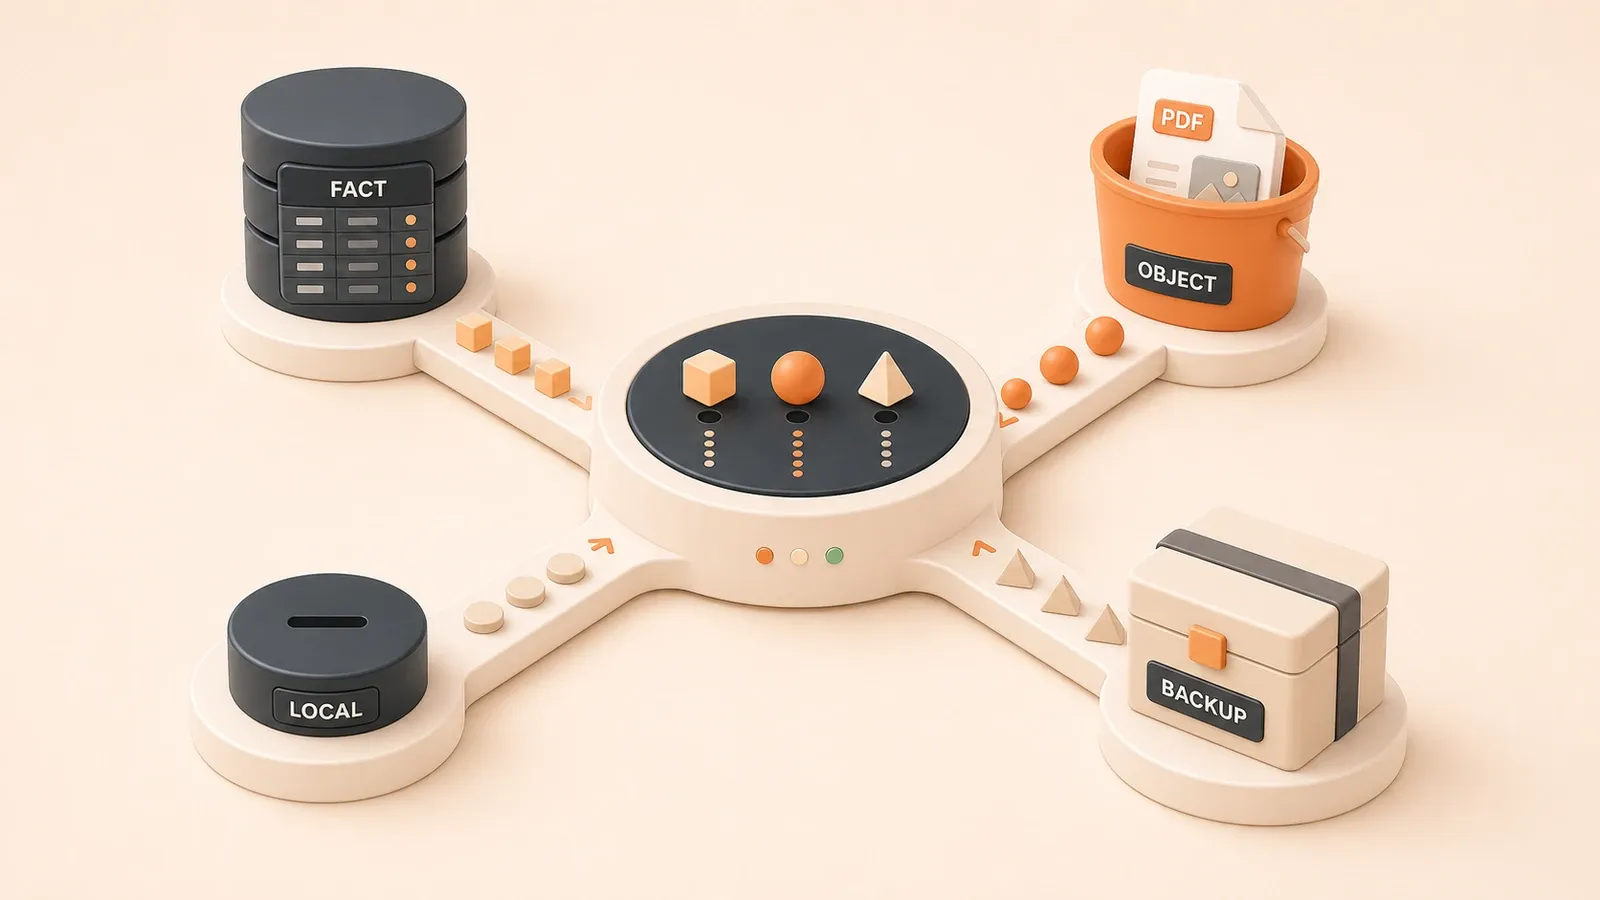
Le projet contient une table users, des orders, des usage_events, un fichier envoyé sous uploads/2026/06/report.pdf, un cache cache:daily-stats et des données locales dans local-dev.sqlite. Où placer chaque objet ? Si les faits métier deviennent des fichiers dans un stockage objet, sauvegardes, requêtes et exports se compliquent vite. Dans D1, l’absence d’index sur les colonnes filtrées consomme rapidement les rows read et peut entraîner un dépassement en offre Paid. Le choix doit donc commencer par le type de donnée.
Tableau de placement : où stocker chaque donnée
Même dans un projet solo, les objets n’ont pas tous les mêmes besoins. Les faits métier demandent requêtes, relations et contrôle d’accès. Les journaux d’événements privilégient des écritures fiables et une rétention abordable. Les fichiers objets demandent droits de téléchargement, cycle de vie et modèle de coût adapté au trafic. Il faut vérifier le besoin de requêtes structurées et de permissions, la fréquence d’accès et la sensibilité aux frais de sortie.
Le tableau donne un point de départ pratique.
Sept types de données et leurs stockages
| Type de donnée | Objets concrets | Stockage recommandé | Critères de décision |
|---|---|---|---|
| Faits métier | users, orders, droits d’abonnement, paiements | Supabase Postgres en priorité, ou D1 pour les cas simples | Requêtes structurées (SELECT/JOIN), droits (RLS), sauvegarde ou restauration temporelle adaptée au forfait, auditabilité |
| Journaux d’événements | usage_events, actions d’exploitation, statistiques | D1 pour les écritures edge ou Postgres pour l’audit | Écritures fréquentes et requêtes simples ; l’analytique ordinaire peut avoir une priorité de restauration moindre, pas les événements de sécurité ou de facturation |
| Fichiers objets | uploads/2026/06/report.pdf, résultats, exports, images | R2 chez Cloudflare, S3 chez AWS ou Supabase Storage | Pas de blob en base ; arbitrer entre sortie R2, écosystème S3 et intégration Supabase Auth/Postgres |
| Cache | cache:daily-stats, état court, calculs temporaires | Cloudflare KV, D1 ou SQLite local | Accès fréquents et données généralement expirables ou régénérables ; KV/D1 en périphérie, SQLite en local |
| Données locales | local-dev.sqlite, jeux de test, administration mono-utilisateur | Fichier SQLite | Un utilisateur, pas de système de droits, copie et démarrage simples |
| Données edge légères | Compteurs Workers, tables de configuration, correspondances de domaines | D1 ou Cloudflare KV | Accès Workers-native, relations légères, lectures dominantes |
| Sauvegardes | Dumps de base, snapshots d’export | R2/S3 plus copie locale | Modèle de sortie R2, gouvernance/lifecycle S3 et copie indépendante contre une panne fournisseur |
Pourquoi les faits métier commencent souvent dans Postgres
Utilisateurs, commandes, droits d’abonnement et paiements sont des enregistrements centraux. Leur perte touche l’accès client et le revenu. Ils exigent :
- Requêtes structurées : une base relationnelle gère SELECT, JOIN, WHERE et ORDER BY ; un stockage objet ne le fait pas.
- Contrôle d’accès : Supabase Postgres peut appliquer Row Level Security aux accès clients. D1 ne propose actuellement pas de RLS natif.
- Sauvegarde et restauration : les projets Supabase Pro, Team et Enterprise ont des sauvegardes quotidiennes ; PITR est un module payant activé séparément. D1 Time Travel conserve 7 jours sur Workers Free et 30 jours sur Workers Paid.
- Piste d’audit : triggers et tables d’audit dédiées sont plus simples à structurer autour des paiements et des droits dans Postgres.
Supabase Postgres n’est pas une abstraction limitée. Chaque projet reçoit une base Postgres complète, fondation d’Auth, Storage, Realtime et Edge Functions (documentation Supabase Database). Les capacités normales de Postgres restent disponibles.
Séparer événements et enregistrements métier
usage_events, actions d’exploitation et statistiques d’accès se comportent autrement :
- Ils sont souvent écrits, tandis que les requêtes courantes filtrent une période ou agrègent des valeurs.
- L’analytique non soumise à audit peut avoir une priorité de restauration moindre, mais demande une règle explicite de rétention et de perte. Sécurité, facturation et droits ne sont pas de simples pages vues.
- Des écritures fréquentes consomment les quotas de rows written et de stockage.
La frontière est concrète :
- Si l’événement appartient à une piste d’audit liée à
user_idetaction, utilisez Postgres. - S’il s’agit d’un compteur ou d’un signal analytique régénérable, D1 ou KV peut suffire.
Ne pas mettre les fichiers objets dans la base
Téléversements, résultats générés, archives d’export et images ne devraient pas vivre dans une colonne blob :
- Coût des sauvegardes : chaque blob entre dans la sauvegarde et augmente durée et volume.
- Charge des requêtes : mélanger gros objets et lignes relationnelles amplifie transfert, cache, sauvegarde et maintenance ; une requête large peut renvoyer accidentellement le fichier.
- Diffusion CDN : un stockage objet s’intègre plus facilement à un CDN, à des règles de cache et à des téléchargements signés ; un blob exige souvent un proxy applicatif.
- Sortie : servir un blob utilise la bande passante de la base et de l’application. Une sortie directe de R2 vers Internet n’a pas de frais R2, tandis que S3 dépend de la région et de la destination.
La base ne garde que l’object key, par exemple uploads/2026/06/report.pdf. Le fichier reste dans R2, S3 ou Supabase Storage.
Caches et données locales de développement
Un cache comme cache:daily-stats, un état court ou un calcul temporaire possède souvent ces propriétés :
- Lectures et écritures fréquentes, avec expiration ou régénération possible. Les sessions sensibles demandent leurs propres règles de cohérence, d’expiration et de révocation.
- Un cache régénérable n’a généralement pas à entrer dans les sauvegardes métier ; révocations de session et autres états de sécurité exigent une stratégie de persistance distincte.
- L’accès edge est sensible à la latence.
Choix pratiques :
- Cloudflare KV ou D1 pour un cache edge léger dans Workers.
- Fichier SQLite ou cache mémoire pour le développement local.
local-dev.sqlite correspond à un usage mono-utilisateur sans système de droits :
- SQLite vise les données locales d’application et les fichiers applicatifs (quand utiliser SQLite).
- Il ne résout pas le même problème qu’une base client/serveur : SQLite privilégie le local mono-utilisateur, Postgres un référentiel partagé multi-utilisateurs.
Données edge légères et sauvegardes
D1 ou KV forme un bon point de départ pour compteurs Workers, petites configurations et correspondances de domaines :
- Accès natif : binding Worker ou API HTTP sans pool de connexions séparé.
- Relations légères : schéma simple sans JOIN complexes ni grand graphe de clés étrangères.
- Lectures dominantes : beaucoup plus de lectures que d’écritures.
Les exports de sauvegarde demandent une récupération abordable et une copie indépendante :
- R2 ne facture pas de sortie R2 pour un téléchargement direct vers Internet.
- S3 propose Object Lock, plusieurs classes d’archive et la gestion du cycle de vie.
- Une copie locale ou chez un second fournisseur protège contre les pannes de compte et de plateforme. L’unique copie de restauration ne doit pas rester à côté de la production.
D1 : base serverless native de Workers
D1 est la base serverless gérée de Cloudflare avec une sémantique SQL SQLite (présentation de D1). Ses capacités principales :
- Time Travel : restauration à la minute près sur les 7 derniers jours avec Workers Free ou 30 jours avec Workers Paid. La restauration écrase la base en place, il faut donc valider l’heure cible.
- Read replication : baisse de latence et capacité de lecture accrue pour les charges surtout lues.
- Accès Workers et API HTTP : binding ou API sans gérer un pool de connexions distinct.
- Disaster recovery intégré : Cloudflare gère l’historique et le mécanisme de restauration.
Adapté aux applications Workers-native surtout lues
D1 convient :
- Aux projets Workers ou Pages qui évitent de traverser une autre plateforme à chaque requête.
- Aux données relationnelles légères : configuration, compteurs, correspondances de domaines sans réseau complexe de relations.
- Aux charges dominées par la lecture que la réplication peut étendre.
- Aux projets utilisant déjà Workers, R2, KV ou Vectorize et cherchant une couche relationnelle dans le même écosystème.
D1 convient moins :
- Aux SaaS multi-utilisateurs exigeant un système de droits mûr et RLS.
- Aux commandes et droits d’abonnement qui demandent contraintes, audits et restauration testée. Postgres est généralement un meilleur départ ; la fenêtre dépend du forfait géré et des modules.
- Aux systèmes lourds en audit qui reposent sur les triggers et modèles Postgres.
Facturation rows read : lignes parcourues, pas renvoyées
D1 facture rows read, rows written et le stockage. Rows read correspond aux lignes parcourues par la requête, pas au résultat.
En juillet 2026, la page officielle indique les quotas et prix suivants. Ils sont à vérifier avant publication ou décision d’architecture importante.
| Élément | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/jour | Premiers 25B/mois inclus |
| Rows written | 100K/jour | Premiers 50M/mois inclus |
| Stockage | 5 GB au total | Premiers 5 GB inclus, puis $0.75/GB-month |
| Dépassement rows read | Indisponible | $0.001/million rows read |
| Dépassement rows written | Indisponible | $1/million rows written |
| Sortie/bande passante | Pas de frais séparés | Pas de frais séparés |
Si SELECT * FROM orders WHERE user_id = ? LIMIT 20 s’exécute sur 50 000 lignes sans index sur user_id, D1 peut parcourir presque toute la table pour renvoyer 20 lignes. Rows read se rapproche de 50 000 plutôt que de 20.
Un filtre non indexé peut donc parcourir toute la table pour quelques résultats. Consultez meta.rows_read de la requête réelle au lieu d’estimer d’après le résultat.
Index et efficacité des requêtes
Pour maîtriser rows read :
- Créez un index comme
CREATE INDEX idx_user_id ON orders(user_id);afin que D1 lise le sous-ensemble indexé. Vérifiezmeta.rows_read. - Ne sélectionnez que les colonnes utiles pour réduire la réponse et le couplage. D1 compte toutefois les lignes parcourues, pas les colonnes ; index et filtres réduisent rows read.
- Comparez
rows_readau nombre de lignes renvoyées. Lemetade requête et le tableau de bord exposent rows read/written pour repérer les scans complets.
Conseils d’indexation :
- Indexez les colonnes de WHERE telles que
user_idetcreated_at. - Indexez les clés de JOIN telles que
order_idetproduct_id. - Évitez les index inutiles, car INSERT et UPDATE peuvent aussi écrire des lignes d’index.
- Contrôlez les requêtes qui lisent beaucoup de lignes dans le tableau de bord D1.
Quota gratuit D1 et signaux de passage à Paid
Workers Free limite actuellement D1 à :
- 5M rows read par jour. Une requête à 50K rows read ne s’exécute qu’environ 100 fois avant la limite.
- 100K rows written par jour, vite consommées par une charge riche en écritures.
- 5 GB de stockage total par compte.
Envisagez Workers Paid lorsque :
- Les rows read approchent 5M par jour. Les requêtes Free échouent ensuite ; Paid inclut 25B par mois et facture le dépassement.
- Les rows written approchent 100K par jour ; Paid en inclut 50M par mois.
- Le stockage dépasse 5 GB ; le surplus coûte $0.75/GB-month.
D1 excelle pour les données relationnelles légères proches de Workers, pas comme valeur par défaut pour toute charge riche en écritures ou volumineuse. Surveillez rows read, rows written et stockage.
Supabase Postgres : valeur BaaS pratique par défaut
Chaque projet Supabase reçoit une base Postgres complète, pas une abstraction réduite (documentation Supabase Database). Auth, Storage, Realtime et Edge Functions s’appuient dessus ; requêtes complexes, clés étrangères, triggers, transactions, MVCC et extensions restent accessibles.
RLS pour contrôler les accès clients
Row Level Security est un avantage central de Supabase Postgres. Une architecture classique réserve la base au serveur et fait passer les clients par une API. Avec des policies et clés correctement configurées, RLS applique des droits ligne par ligne aux requêtes clientes.
RLS aide à :
- Contrôler l’accès : une policy peut montrer seulement les lignes dont
user_idcorrespond à l’utilisateur authentifié. - Concevoir l’audit : RLS fixe la frontière d’accès ; table d’audit, triggers ou logs enregistrent séparément qui a fait quoi et quand.
- Réduire la duplication : les règles peuvent vivre dans la base, mais le serveur doit toujours valider les identités, protéger les clés privilégiées et contrôler les opérations élevées.
Cela convient aux faits métier, applications à permissions fortes, SaaS multi-utilisateurs, commandes et droits d’abonnement. RLS est une frontière de base de données, pas un remplacement du schéma ou de l’audit.
Sauvegardes et restauration
En juillet 2026, les forfaits officiels Supabase indiquent :
| Élément | Free | Pro | Team |
|---|---|---|---|
| Taille de base | 500 MB inclus par projet | 8 GB inclus, puis dépassement | 8 GB inclus, puis dépassement |
| Prix | $0 | $25/mois | $599/mois |
| Sauvegardes automatiques | Non incluses | Quotidiennes, 7 jours | Quotidiennes, 14 jours |
| PITR | Non inclus | Module payant, environ $100/mois pour 7 jours | Module payant, environ $100/mois pour 7 jours |
Trois conséquences pratiques :
- Un projet Free ne peut pas prendre les sauvegardes de plateforme comme plan de reprise. Exécutez régulièrement
supabase db dumpoupg_dumpet gardez une copie externe. - Pro et Team ont des sauvegardes quotidiennes, mais peuvent perdre les changements depuis la dernière sauvegarde.
- PITR n’est pas inclus par défaut dans Pro. Il exige au moins Small compute et se facture séparément pour 7, 14 ou 28 jours.
La taille seule ne décide pas du passage de forfait. Pour commandes et droits, définissez d’abord RPO, RTO et fréquence des tests de restauration, puis arbitrez entre sauvegarde quotidienne et PITR.
D1 face à Supabase : droits et restauration
| Dimension | D1 | Supabase Postgres |
|---|---|---|
| Positionnement | Base serverless Workers-native | BaaS Postgres géré |
| Contrôle d’accès | Pas de RLS natif | RLS peut protéger les requêtes clientes |
| Restauration | Time Travel : Free 7 jours, Paid 30 jours | Sauvegardes quotidiennes Pro/Team/Enterprise ; PITR payant |
| Usage adapté | Données relationnelles légères dans Workers | Faits métier, SaaS multi-utilisateurs, commandes, droits |
| Facturation | Rows read/written et stockage | Stockage, compute et usage du forfait |
Les deux peuvent cohabiter :
- D1 reçoit configuration edge surtout lue, compteurs et correspondances de domaines.
- Supabase Postgres reçoit utilisateurs, commandes, droits d’abonnement et paiements.
Un outil SaaS peut garder configuration et compteurs dans D1, utilisateurs et droits dans Postgres. D1 reste proche de Workers ; Postgres apporte permissions, contraintes et options de restauration mûres.
R2 : stockage objet sans frais de sortie R2
R2 est le stockage objet compatible S3 de Cloudflare. Les transferts directs depuis R2 via Workers API, S3 API ou r2.dev vers Internet n’entraînent pas de frais de sortie R2 (tarifs R2) ; un autre service facturé connecté au bucket peut néanmoins facturer. R2 convient aux fichiers envoyés, résultats générés et exports, mais la sortie gratuite ne rend pas le stockage et les opérations gratuits.
Facturation des opérations Class A/B
R2 facture stockage, opérations Class A et Class B. Infrequent Access ajoute des frais de récupération.
En juillet 2026, la grille indique :
| Élément | Offre gratuite | Standard | Infrequent Access |
|---|---|---|---|
| Stockage | 10 GB-month/mois | $0.015/GB-month | $0.01/GB-month |
| Opérations Class A | 1M/mois | $4.50/million | $9.00/million |
| Opérations Class B | 10M/mois | $0.36/million | $0.90/million |
| Récupération | Aucune | Aucune | $0.01/GB |
| Sortie Internet | Gratuite | Gratuite | Gratuite |
| Durée minimale | Aucune | Aucune | 30 jours |
Les classes comprennent :

- Class A, plus coûteuse :
PutObject,CopyObject,ListObjectset transitions de lifecycle. Écritures et listes y appartiennent généralement. - Class B, moins coûteuse :
GetObject,HeadObjectetHeadBucket. Les lectures y appartiennent généralement. - Opérations gratuites :
DeleteObject,DeleteBucketetAbortMultipartUpload.
Ce que l’offre gratuite R2 ne signifie pas
10 GB-month ne signifie pas stockage illimité :
- Stockage : la mesure porte sur la capacité pendant la période, pas le trafic. Davantage de données exige paiement ou nettoyage.
- Class A : 1M d’opérations mensuelles couvre beaucoup de petits sites, mais un upload par lots peut l’épuiser vite.
- Class B : 10M d’opérations mensuelles couvre beaucoup de lectures, mais une origine d’images très fréquentée peut dépasser ce nombre.
Infrequent Access impose 30 jours de stockage minimum. Supprimer plus tôt n’annule pas la charge minimale. Cette classe convient aux sauvegardes et objets durables, pas aux résultats temporaires.
Adapté aux uploads et résultats générés
R2 convient :
- Aux fichiers utilisateurs comme
uploads/2026/06/report.pdf, images et documents, surtout quand les téléchargements sont fréquents. - Aux rapports générés, exports et résultats de traitement d’image.
- Aux dumps et snapshots qui doivent rester abordables à récupérer.
- Aux projets utilisant Workers, D1, KV ou Vectorize.
R2 ne convient pas :
- Aux faits métier comme utilisateurs et commandes, qui demandent requêtes structurées et contrôle d’accès.
- Aux charges nécessitant S3 Object Lock, davantage de classes ou une réplication AWS native entre buckets et régions.
Comparaison entre R2 et S3
| Dimension | R2 | S3 |
|---|---|---|
| Sortie Internet | Gratuite côté R2 ; des services connectés peuvent facturer | Dépend de la région, destination et utilisation ; consulter les tarifs AWS actuels |
| Stockage | $0.015/GB-month en Standard | Plusieurs classes dont Standard et Glacier |
| Écosystème | Natif dans Workers et Pages | Intégration AWS profonde, dont Lambda |
| Gouvernance | Lifecycle, Standard/IA et notifications Queue | Object Lock, classes Glacier, lifecycle, Replication et destinations d’événements multiples |
| Usage adapté | Écosystème Cloudflare et diffusion sensible au coût de sortie | Écosystème AWS, gouvernance, data lakes et applications d’entreprise |
Choisissez R2 lorsque :
- Les téléchargements font du coût de sortie un facteur majeur.
- L’application tourne déjà sur Workers ou Pages.
Choisissez S3 lorsque :
- Lambda, data lakes ou workflows d’entreprise dépendent de services AWS.
- Object Lock, plus de classes Glacier, réplication interrégionale ou gouvernance IAM AWS sont nécessaires.
- L’outillage AWS plus large, dont CloudWatch, IAM et opérations par lots, apporte de la valeur.
R2 et S3 ne se remplacent pas entièrement. Un produit Cloudflare peut placer fichiers CDN et résultats dans R2, mais archives soumises à gouvernance dans S3.
S3 : écosystème AWS et gouvernance
Amazon S3 est un service de stockage objet pour data lakes, sites web, applications mobiles, sauvegarde/restauration, archives, applications d’entreprise, IoT et analytique (Amazon S3 User Guide). Il fournit :
- Des classes comme Standard, Intelligent-Tiering, Glacier et Glacier Deep Archive.
- Des règles de lifecycle qui déplacent ou expirent automatiquement les objets.
- Object Lock avec rétention WORM contre écrasement ou suppression.
- Same-Region et Cross-Region Replication pour reprise, latence et gouvernance.
- IAM, bucket policies et Block Public Access.
- Des notifications d’événements pour Lambda et d’autres destinations AWS.
Adapté à l’intégration AWS et à la gouvernance
S3 convient :
- Aux produits utilisant déjà Lambda, EC2, RDS ou DynamoDB.
- Aux besoins d’Object Lock, classes d’archive et rétention formelle.
- Aux data lakes et pipelines IoT dépendant des services analytiques AWS.
- Aux sauvegardes, restaurations et archives longues gérées par lifecycle.
S3 convient moins lorsque :
- Des téléchargements fréquents rendent le coût de sortie sensible ; utilisez les tarifs AWS actuels pour la région, destination, cache et volume concernés.
- L’application est autrement native Cloudflare et accède directement à R2 depuis Workers ou Pages.
S3 face à R2 : profondeur d’écosystème et de gouvernance
L’avantage de S3 est la largeur de ses intégrations AWS et de sa gouvernance :
- Destinations d’événements : S3 Event Notifications envoie vers SNS, SQS, Lambda et EventBridge. R2 peut aussi envoyer object-create et object-delete à Cloudflare Queues, consommées par Worker ou HTTP pull.
- Classes : S3 propose plusieurs classes d’archive Glacier ; R2 se concentre actuellement sur Standard et Infrequent Access.
- Object Lock : la rétention WORM empêche l’écrasement ou la suppression pendant la période.
- Replication : S3 copie objets, metadata et tags vers un bucket de la même région ou d’une autre.
Choisissez S3 lorsque :
- Lambda, data lakes ou applications d’entreprise dépendent d’intégrations AWS.
- Object Lock, classes Glacier ou gouvernance lifecycle sont requis.
- Les archives longues bénéficient de la famille Glacier.
Choisissez R2 lorsque :
- Les fichiers utilisateurs et résultats générés sont souvent téléchargés.
- Workers et Pages sont le runtime principal.
Une architecture mixte peut placer fichiers CDN et résultats dans R2, sauvegardes soumises à gouvernance dans S3. Le type de donnée et l’accès décident, pas une règle mono-fournisseur.
SQLite : priorité au local et à l’embarqué
SQLite convient aux données locales d’application, fichiers applicatifs, sites à trafic faible ou moyen, analyses et caches (quand utiliser SQLite). Il ne concurrence pas directement les bases SQL client/serveur. Celles-ci privilégient référentiel partagé, concurrence, centralisation et contrôle ; SQLite privilégie une donnée locale mono-utilisateur dans un fichier copiable.
Adapté aux outils mono-utilisateur et backends locaux
SQLite convient :
- Aux outils mono-utilisateur, tableaux de bord locaux, utilitaires d’analyse, petits jeux et jeux de données mono-fichier.
- Aux formats de fichier d’applications de CAO, finance ou gestion de médias.
- Aux sites à trafic faible ou moyen. SQLite estime qu’un site sous 100K hits/jour fonctionne généralement bien, mais c’est une observation prudente, pas une promesse. Matériel, complexité des requêtes et écritures concurrentes déterminent la capacité.
- Aux données locales comme
local-dev.sqlite. - Aux caches et calculs temporaires sans état partagé durable.
SQLite convient moins :
- Aux SaaS multi-utilisateurs avec droits, écritures concurrentes et audits.
- Aux commandes et droits d’abonnement exigeant sauvegardes mûres et restauration temporelle.
- Aux écritures fortement concurrentes, car SQLite accepte plusieurs lecteurs mais un seul writer à la fois.
SQLite face à Postgres : signaux de migration
| Dimension | SQLite | Postgres |
|---|---|---|
| Positionnement | Données locales et fichier applicatif | Référentiel client/serveur partagé |
| Usage adapté | Outils mono-utilisateur, petits jeux, tableaux locaux | SaaS multi-utilisateurs, commandes, droits d’abonnement |
| Concurrence | Un writer, plusieurs lecteurs | Plusieurs writers avec MVCC |
| Droits | Pas de gestion utilisateurs intégrée | RLS et gestion utilisateurs/rôles |
| Coût | Pas de serveur de base séparé | Dépend de l’auto-hébergement ou du forfait géré, compute et sauvegardes |
Passez de SQLite à Postgres lorsque :
- Un outil mono-utilisateur devient un SaaS multi-utilisateurs et demande des droits.
- Plusieurs utilisateurs ou instances modifient le même état simultanément.
- Les paiements introduisent commandes et droits qui exigent audit et restauration testée.
- Un modèle
users/roles/permissionsnécessite un contrôle au niveau base.
Un tableau analytique personnel peut rester sur SQLite. Lorsque plusieurs clients payants partagent le service, Postgres forme généralement une frontière plus claire.
SQLite ne remplace pas Postgres
SQLite indique lui-même qu’il ne cherche pas à remplacer une base SQL client/serveur :
- SQLite optimise la simplicité locale mono-utilisateur et une base copiable comme fichier.
- Postgres optimise un référentiel multi-utilisateurs avec changements concurrents et enregistrements critiques pour le paiement.
SQLite ne demande pas de serveur séparé. Le coût de Postgres dépend de l’auto-hébergement ou du service géré, du compute, du stockage et des sauvegardes. Les deux demandent un processus de restauration testé.
Choisissez SQLite pour :
- Les utilitaires locaux et petits jeux sans paiements ni système de droits.
- Les fixtures de développement et données temporaires.
- Les sites personnels et outils documentaires avec peu d’écritures concurrentes.
Choisissez Postgres pour :
- Les SaaS multi-utilisateurs avec commandes, abonnements et droits.
- Les changements d’exploitation et de droits qui doivent être audités.
- Les données métier nécessitant une restauration temporelle configurable.
Les deux peuvent coexister : SQLite pour le développement local ou les caches régénérables, Postgres pour les faits métier en production.
Trois erreurs à éviter
Les erreurs les plus fréquentes sont de stocker les faits métier comme objets, d’ignorer la facturation de D1 fondée sur le scan et de croire l’offre R2 illimitée. Elles compliquent la reprise, ralentissent les requêtes et rendent les coûts moins prévisibles.
Erreur 1 : placer les faits métier dans le stockage objet
Les tables users, orders et les usage_events soumis à audit ne vont pas dans R2 ou S3. Le stockage objet ne fournit ni requêtes relationnelles, ni contraintes, ni droits par ligne, ni modèles d’audit de base.
Les conséquences sont concrètes :
- Pas de SELECT ou JOIN : le stockage objet est fondé sur les keys. Pour répondre à
SELECT * FROM orders WHERE user_id = ? LIMIT 20, l’application devrait lister et télécharger les objets elle-même. - Restauration difficile : une collection de fichiers n’est pas un historique transactionnel de commandes. Dump SQL ou système point-in-time géré fournit un chemin de reprise plus cohérent.
- Exports lents : une requête de base peut diffuser les enregistrements filtrés ; un objet par commande peut imposer le scan de nombreux fichiers.
Gardez les faits métier dans la base et les fichiers dans le stockage objet. La base stocke une key stable ; R2, S3 ou Supabase Storage contient le fichier.
Erreur 2 : oublier la facturation rows read
D1 compte les lignes parcourues, pas celles renvoyées. Un filtre sans index peut donc consommer bien plus de rows read que le résultat ne le laisse penser.
Sur 50 000 lignes orders, SELECT * FROM orders WHERE user_id = ? LIMIT 20 peut lire de nombreuses lignes sans index. meta.rows_read donne l’usage facturable. Les requêtes Free échouent après 5M par jour ; Paid facture au-delà de l’inclus mensuel.
Correction :
- Indexez la vraie colonne filtrée, par exemple
CREATE INDEX idx_user_id ON orders(user_id);. - Vérifiez avec
EXPLAIN QUERY PLANetmeta.rows_readqu’il ne reste pas de scan complet. - Sélectionnez seulement les colonnes utiles pour réduire la réponse, en gardant à l’esprit que D1 compte les lignes, pas les colonnes.
Erreur 3 : croire l’offre gratuite R2 illimitée
R2 Free comprend actuellement 10 GB-month de Standard storage, 1M opérations Class A et 10M Class B par mois. Ce sont des quotas.
Erreurs courantes :
- 10 GB-month mesure la capacité stockée dans le temps, pas le transfert.
PutObjectest une opération Class A. Une création par lots peut épuiser le quota malgré un volume total faible.- Infrequent Access impose 30 jours minimum ; supprimer plus tôt entraîne tout de même la charge minimale.
Surveillez stockage et opérations, faites expirer les anciens résultats et n’utilisez pas Infrequent Access pour du temporaire. SQLite local ou un cache peut mieux convenir aux données courtes.
Conclusion
Le type de donnée décide : faits métier, événements, objets, caches, développement local, données edge légères et sauvegardes. Supabase Postgres porte généralement les faits métier grâce aux contraintes relationnelles, à RLS, aux restaurations configurables et aux modèles d’audit. D1 convient aux données relationnelles légères proches de Workers, R2/S3 aux objets et SQLite au local mono-utilisateur.
Trois actions sécurisent la première version :
- Classez chaque objet et notez requêtes, droits, fréquence d’accès et contraintes de coût.
- Indexez les colonnes filtrées dans D1 et vérifiez avec les métriques rows read.
- Ne placez pas les enregistrements métier dans le stockage objet, évitez les scans sans index et estimez tout le quota R2, pas seulement le stockage.
Les prochains articles traiteront paiements et système utilisateurs. Ils renforcent cette frontière : les commandes de paiement ont besoin de contraintes Postgres, sauvegardes et audits ; droits utilisateurs et permissions demandent RLS et restauration testée.
Si le stockage d’un objet reste incertain, revenez au tableau et aux articles précédents sur principes d’architecture, backend et déploiement. Fixez la frontière du système avant d’affiner le rôle du stockage.
Attribuer le stockage d'un projet solo
Séparez en six étapes, de l'inventaire au test de restauration, les responsabilités de la base et du stockage objet.
- 1
Step 1: Inventorier les objets
Listez users, orders, usage_events, uploads, caches, fichiers locaux et sauvegardes sans les regrouper d'abord par produit. - 2
Step 2: Classer chaque objet
Marquez chaque élément comme fait métier, événement, fichier objet, cache, donnée locale ou sauvegarde, puis notez s'il peut expirer ou être régénéré. - 3
Step 3: Définir cohérence et droits
Recensez transactions, contraintes, RLS, écritures concurrentes, audits et partage multi-instance pour choisir entre Postgres et D1. - 4
Step 4: Estimer accès et coûts
Estimez D1 rows read/written, R2 Class A/B operations, volume d'objets, fréquence de lecture et éventuels frais de sortie. - 5
Step 5: Concevoir des références stables
Conservez object key, owner, status et metadata dans la base, le contenu du fichier dans le stockage objet, avec des noms de key stables. - 6
Step 6: Tester sauvegarde et migration
Prévoyez exports, copies hors site, délais de suppression et exercices de restauration ; migrez metadata, puis objets, avant de basculer les lectures.
FAQ
Un projet solo doit-il commencer par D1 ou Supabase Postgres ?
Que faut-il stocker dans R2 ou S3 ?
SQLite peut-il faire fonctionner un premier SaaS ?
Peut-on stocker les fichiers utilisateurs dans la base ?
Que signifie la facturation D1 rows read ?
L'offre gratuite de Cloudflare R2 suffit-elle ?
21 min de lecture · Publié le: 9 oct. 2026

Guide de stack technique pour solo founder
Si vous arrivez depuis la recherche, le plus rapide est de passer à l’article précédent ou suivant de cette série.
Précédent
Déploiement en solo : Cloudflare, Vercel ou Railway ?
Comparez Cloudflare Pages et Workers, Vercel et Railway selon le type de charge, les limites actuelles, les risques de facturation et la maintenance.
Partie 7 sur 8
Suivant
C’est le dernier article publié dans cette série pour le moment.


Commentaires
Connectez-vous avec GitHub pour laisser un commentaire