Elegir base de datos en solitario: D1, Postgres, R2, S3 o SQLite
"La página oficial de precios de D1 explica rows read/written, límites de almacenamiento, efecto de los índices en las filas recorridas y qué ocurre al alcanzar el límite diario de Free."
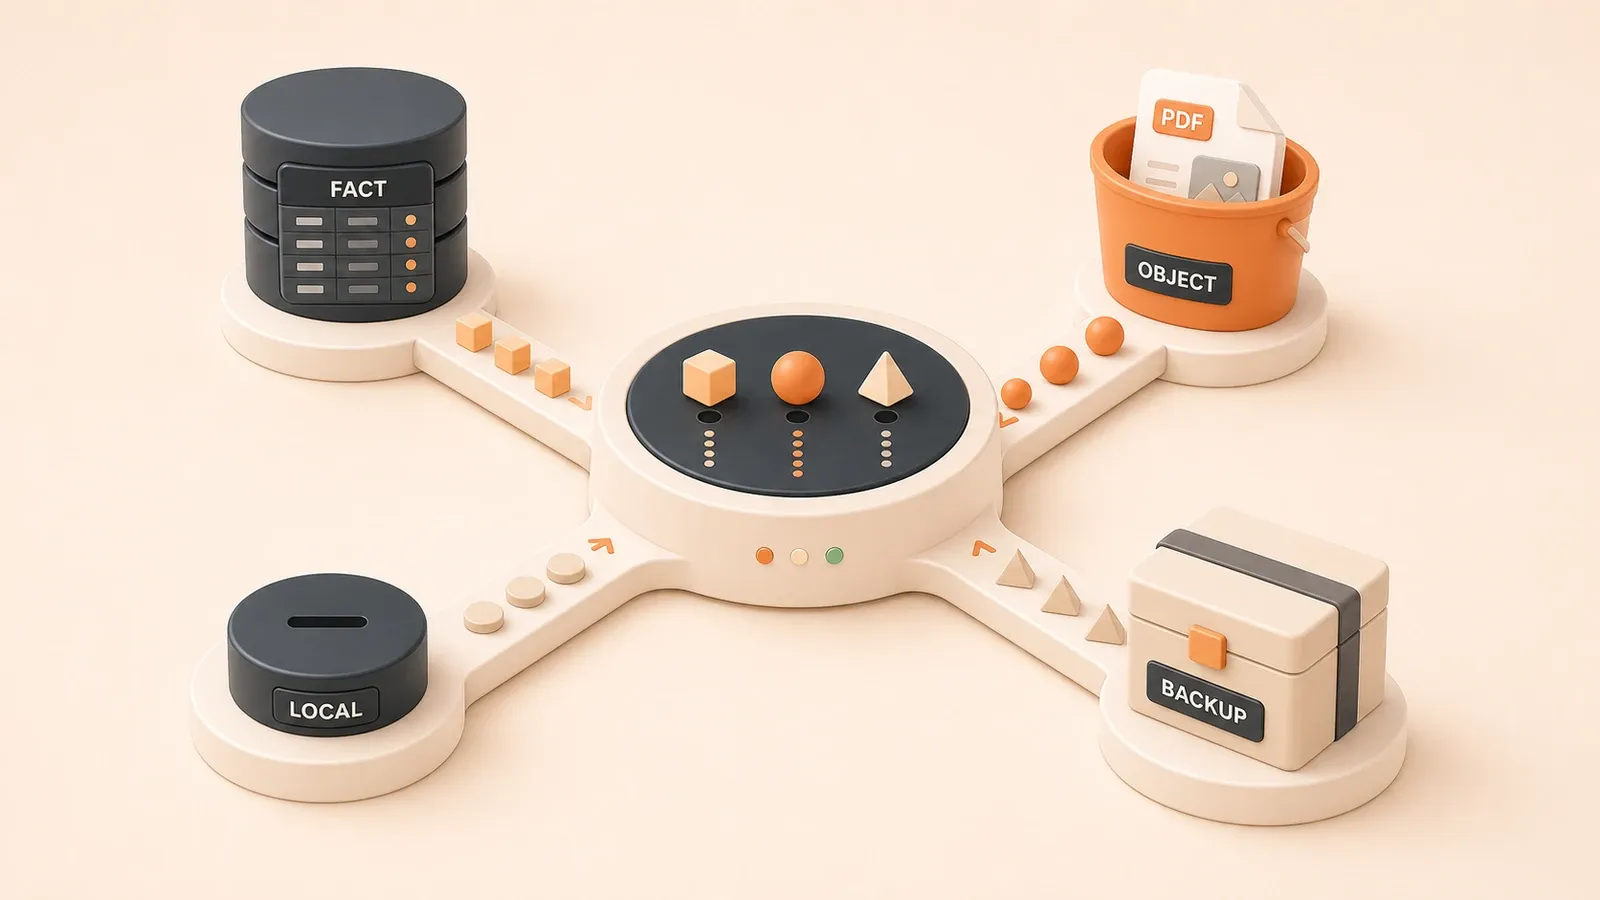
El proyecto tiene una tabla users, orders, usage_events, un archivo subido en uploads/2026/06/report.pdf, un caché cache:daily-stats y datos locales en local-dev.sqlite. ¿Dónde debe vivir cada objeto? Si los hechos de negocio se convierten en archivos de un almacén de objetos, las copias, consultas y exportaciones se complican rápido. En D1, no indexar las columnas de filtro consume pronto rows read y puede generar sobrecostos en Paid. Por eso la decisión empieza por el tipo de dato.
Tabla de ubicación: dónde guardar cada dato
Incluso en un proyecto personal, distintos objetos necesitan distintos sistemas. Los hechos de negocio requieren consultas, relaciones y control de acceso. Los eventos necesitan escrituras fiables y retención asequible. Los archivos objeto requieren permisos de descarga, ciclo de vida y un modelo de costo acorde al tráfico. Hay que saber si se necesitan consultas estructuradas y permisos, con qué frecuencia se accede y cuánto importan los cargos de salida.
La tabla ofrece un punto de partida práctico.
Siete tipos de datos y sus opciones
| Tipo de dato | Objetos concretos | Almacenamiento recomendado | Criterio |
|---|---|---|---|
| Hechos de negocio | users, orders, derechos de suscripción, pagos | Supabase Postgres primero, o D1 en casos simples | Consultas estructuradas (SELECT/JOIN), permisos (RLS), copia o restauración temporal acorde al plan y auditoría |
| Eventos | usage_events, acciones operativas, estadísticas | D1 para escrituras edge o Postgres para auditoría | Escrituras frecuentes y consultas simples; la analítica común puede tener menor prioridad de recuperación, pero no seguridad o facturación |
| Archivos objeto | uploads/2026/06/report.pdf, resultados, exportaciones, imágenes | R2 en Cloudflare, S3 en AWS o Supabase Storage | No usar blobs; valorar salida de R2, ecosistema S3 o integración Supabase Auth/Postgres |
| Caché | cache:daily-stats, estado breve, cálculos temporales | Cloudflare KV, D1 o SQLite local | Accesos frecuentes y normalmente puede caducar o regenerarse; KV/D1 en edge, SQLite local |
| Datos locales | local-dev.sqlite, datos de prueba, administración monousuario | Archivo SQLite | Un usuario, sin sistema de permisos, fácil de copiar y ejecutar |
| Datos edge ligeros | Contadores Workers, configuración, mapeos de dominios | D1 o Cloudflare KV | Acceso nativo de Workers, relaciones simples, predominio de lecturas |
| Copias | Dumps de base, snapshots de exportación | R2/S3 más copia local | Modelo de salida R2, gobierno/lifecycle S3 y copia independiente ante fallos del proveedor |
Por qué los hechos de negocio suelen empezar en Postgres
Usuarios, pedidos, derechos de suscripción y pagos son registros centrales. Perderlos afecta el acceso y los ingresos. Necesitan:
- Consultas estructuradas: una base relacional ejecuta SELECT, JOIN, WHERE y ORDER BY; un almacén de objetos no.
- Control de acceso: Supabase Postgres puede aplicar Row Level Security a consultas de clientes. D1 no ofrece RLS nativo hoy.
- Copia y recuperación: Supabase Pro, Team y Enterprise tienen copias diarias; PITR es un complemento de pago que se activa aparte. D1 Time Travel conserva 7 días en Workers Free y 30 en Workers Paid.
- Auditoría: triggers y tablas de auditoría para cambios de pagos y derechos son más claros en Postgres.
Supabase Postgres no es una abstracción limitada. Cada proyecto obtiene una base Postgres completa, base de Auth, Storage, Realtime y Edge Functions (documentación de Supabase Database). Se mantienen las capacidades normales de Postgres.
Separar eventos de registros de negocio
usage_events, acciones operativas y estadísticas de acceso se comportan de otra manera:
- Se escriben con frecuencia; las consultas normales filtran intervalos o agregan valores.
- La analítica no sujeta a auditoría puede tener menor prioridad de recuperación, pero necesita reglas claras de retención y pérdida. Seguridad, facturación y derechos no son simples vistas de página.
- Muchas escrituras consumen cuotas de rows written y storage.
La frontera es concreta:
- Si el evento pertenece a una auditoría con
user_idyaction, usa Postgres. - Si solo es un contador o señal analítica regenerable, D1 o KV puede bastar.
No guardar archivos objeto en la base
Cargas, resultados generados, archivos de exportación e imágenes no deberían vivir en una columna blob:
- Costo de copias: cada blob entra en el backup y aumenta tiempo y volumen.
- Carga de consultas: mezclar objetos grandes con filas relacionales amplía transferencia, caché, backups y mantenimiento; una consulta amplia puede devolver el archivo por error.
- Distribución CDN: un almacén de objetos se integra mejor con CDN, políticas de caché y descargas firmadas; un blob suele necesitar proxy de aplicación.
- Salida: servir un blob usa ancho de banda de la base y la aplicación. Una transferencia directa de R2 a Internet no cobra egress de R2; S3 depende de región y destino.
La base conserva solo el object key, por ejemplo uploads/2026/06/report.pdf. El archivo queda en R2, S3 o Supabase Storage.
Cachés y datos locales de desarrollo
Un caché como cache:daily-stats, estado breve o cálculo temporal suele tener estas propiedades:
- Lecturas y escrituras frecuentes, pero normalmente puede caducar o regenerarse. Las sesiones sensibles requieren reglas propias de consistencia, expiración y revocación.
- El caché regenerable normalmente no entra en copias de la base de negocio; las revocaciones de sesión y otros estados de seguridad necesitan persistencia propia.
- El acceso edge es sensible a la latencia.
Opciones prácticas:
- Cloudflare KV o D1 para un caché edge ligero en Workers.
- Archivo SQLite o caché en memoria para desarrollo local.
local-dev.sqlite es un caso monousuario sin sistema de permisos:
- SQLite está pensado para datos locales y archivos de aplicación (cuándo usar SQLite).
- No resuelve el mismo problema que una base cliente/servidor: SQLite prioriza local y monousuario; Postgres, un repositorio compartido multiusuario.
Datos edge ligeros y copias
D1 o KV es un buen inicio para contadores Workers, configuraciones pequeñas y mapeos de dominio:
- Acceso nativo: binding Worker o API HTTP sin pool de conexiones aparte.
- Relaciones ligeras: esquema simple sin JOIN complejos ni una gran red de claves foráneas.
- Predominio de lectura: muchas más lecturas que escrituras.
Las exportaciones de respaldo necesitan recuperación asequible y una copia independiente:
- R2 no cobra egress de R2 por descargas directas a Internet.
- S3 ofrece Object Lock, varias clases de archivo y gestión del ciclo de vida.
- Una copia local o en otro proveedor protege ante fallos de cuenta y plataforma. La única copia de restauración no debe estar junto a producción.
D1: base serverless nativa de Workers
D1 es la base serverless administrada de Cloudflare con semántica SQL de SQLite (resumen de D1). Sus capacidades clave son:
- Time Travel: restaura a cualquier minuto de los últimos 7 días en Workers Free o 30 días en Workers Paid. La restauración sobrescribe la base, así que hay que validar la hora.
- Read replication: reduce latencia y amplía capacidad de lectura para cargas con muchas lecturas.
- Acceso Workers y API HTTP: binding o API sin gestionar un pool de conexiones propio.
- Disaster recovery integrado: Cloudflare gestiona historial y recuperación.
Adecuado para aplicaciones Workers-native de muchas lecturas
D1 encaja con:
- Proyectos Workers o Pages que evitan cruzar a otra plataforma en cada consulta.
- Datos relacionales ligeros como configuración, contadores y mapeos sin una red compleja de relaciones.
- Cargas dominadas por lecturas que pueden escalar mediante réplicas.
- Proyectos que ya usan Workers, R2, KV o Vectorize y necesitan una capa relacional en el mismo ecosistema.
D1 encaja menos con:
- SaaS multiusuario que necesita permisos maduros y RLS.
- Pedidos y derechos de suscripción que exigen restricciones, auditoría y restauración probada. Postgres suele ser un inicio más seguro; la ventana depende del plan y complementos.
- Sistemas con mucha auditoría que dependen de triggers y patrones Postgres.
Facturación rows read: filas recorridas, no devueltas
D1 factura rows read, rows written y almacenamiento. Rows read son las filas recorridas por la consulta, no las devueltas.
En julio de 2026, la página oficial muestra estas cuotas y precios. Conviene revisarlos antes de publicar o tomar una decisión importante.
| Elemento | Workers Free | Workers Paid |
|---|---|---|
| Rows read | 5M/día | Primeros 25B/mes incluidos |
| Rows written | 100K/día | Primeros 50M/mes incluidos |
| Almacenamiento | 5 GB total | Primeros 5 GB incluidos; luego $0.75/GB-month |
| Exceso rows read | No disponible | $0.001/million rows read |
| Exceso rows written | No disponible | $1/million rows written |
| Egress/ancho de banda | Sin cargo separado | Sin cargo separado |
Si SELECT * FROM orders WHERE user_id = ? LIMIT 20 se ejecuta sobre 50 000 filas sin índice en user_id, D1 puede recorrer casi toda la tabla para devolver 20. Rows read se acerca a 50 000, no a 20.
Un filtro sin índice puede recorrer toda la tabla aunque devuelva pocos registros. Consulta meta.rows_read de la ejecución real, no el número de resultados.
Índices y eficiencia de consulta
Para controlar rows read:
- Crea un índice como
CREATE INDEX idx_user_id ON orders(user_id);para que D1 lea el subconjunto indexado. Compruebameta.rows_read. - Selecciona solo columnas necesarias para reducir respuesta y acoplamiento. D1 cuenta filas recorridas, no columnas; índices y filtros reducen rows read.
- Compara
rows_readcon las filas devueltas. Elmetay el panel exponen rows read/written para detectar recorridos completos.
Consejos de indexación:
- Indexa columnas usadas en WHERE, como
user_idycreated_at. - Indexa claves de JOIN como
order_idyproduct_id. - Evita índices innecesarios, porque INSERT y UPDATE también pueden escribir filas de índice.
- Revisa en el panel D1 las consultas con rows read inusualmente altos.
Cuota gratuita de D1 y señales de cambio
Workers Free limita hoy D1 a:
- 5M rows read al día. Una consulta con 50K rows read solo se ejecuta unas 100 veces antes del límite.
- 100K rows written al día, que una carga de muchas escrituras consume rápido.
- 5 GB de almacenamiento total por cuenta.
Considera Workers Paid cuando:
- Rows read se acerca a 5M diarios. Las consultas Free fallan después; Paid incluye 25B mensuales y cobra el exceso.
- Rows written se acerca a 100K diarios; Paid incluye 50M al mes.
- El almacenamiento supera 5 GB; el exceso cuesta $0.75/GB-month.
D1 es fuerte con datos relacionales ligeros cerca de Workers, no como opción por defecto para cualquier carga de muchas escrituras o gran volumen. Supervisa rows read, rows written y storage.
Supabase Postgres: opción BaaS práctica
Cada proyecto Supabase tiene una base Postgres completa, no una abstracción reducida (documentación de Supabase Database). Auth, Storage, Realtime y Edge Functions se apoyan en ella; siguen disponibles consultas complejas, claves foráneas, triggers, transacciones, MVCC y extensiones.
RLS para controlar el acceso del cliente
Row Level Security es una ventaja central de Supabase Postgres. La arquitectura tradicional reserva la base al servidor y hace que el cliente use una API. Con policies y claves correctas, RLS aplica permisos por fila a las consultas del cliente.
RLS ayuda a:
- Controlar acceso: una policy muestra solo filas cuyo
user_idcorresponde al usuario autenticado. - Diseñar auditoría: RLS fija la frontera de acceso; una tabla de auditoría, triggers o logs registran quién hizo qué y cuándo.
- Reducir lógica duplicada: las reglas pueden vivir en la base, aunque el servidor aún valida identidades, protege claves privilegiadas y revisa operaciones elevadas.
Esto encaja con hechos de negocio, aplicaciones de permisos fuertes, SaaS multiusuario, pedidos y derechos de suscripción. RLS es una frontera, no sustituye el esquema ni la auditoría.
Copias y recuperación
En julio de 2026, los planes oficiales de Supabase indican:
| Elemento | Free | Pro | Team |
|---|---|---|---|
| Tamaño de base | 500 MB por proyecto incluidos | 8 GB incluidos; luego exceso | 8 GB incluidos; luego exceso |
| Precio | $0 | $25/mes | $599/mes |
| Copias automáticas | No incluidas | Diarias, 7 días | Diarias, 14 días |
| PITR | No incluido | Complemento de pago, unos $100/mes para 7 días | Complemento de pago, unos $100/mes para 7 días |
Tres consecuencias prácticas:
- Un proyecto Free no puede considerar las copias de plataforma su plan de recuperación. Ejecuta
supabase db dumpopg_dumpcon regularidad y guarda una copia externa. - Pro y Team tienen copias diarias, pero pueden perder cambios posteriores a la última.
- PITR no viene incluido en Pro. Requiere al menos Small compute y se cobra aparte por 7, 14 o 28 días.
El tamaño no decide por sí solo el cambio de plan. Para pedidos y derechos, define primero RPO, RTO y frecuencia de simulacros; luego decide entre copia diaria y PITR.
D1 frente a Supabase: permisos y recuperación
| Dimensión | D1 | Supabase Postgres |
|---|---|---|
| Posición | Base serverless Workers-native | BaaS Postgres administrado |
| Acceso | Sin RLS nativo | RLS puede proteger consultas de clientes |
| Recuperación | Time Travel: Free 7 días, Paid 30 días | Copias diarias en Pro/Team/Enterprise; PITR de pago |
| Mejor uso | Datos relacionales ligeros en Workers | Hechos de negocio, SaaS multiusuario, pedidos, derechos |
| Facturación | Rows read/written y almacenamiento | Almacenamiento, compute y uso del plan |
Pueden coexistir:
- D1 guarda configuración edge de muchas lecturas, contadores y dominios.
- Supabase Postgres guarda usuarios, pedidos, derechos y pagos.
Una herramienta SaaS puede mantener configuración y contadores en D1, y usuarios y derechos en Postgres. D1 queda cerca de Workers; Postgres aporta permisos, restricciones y recuperación maduros.
R2: almacenamiento de objetos sin cargo de salida R2
R2 es el almacén compatible con S3 de Cloudflare. Las transferencias directas desde R2 por Workers API, S3 API o r2.dev a Internet no generan cargo de salida R2 (precios de R2); otro servicio medido conectado sí puede cobrar. R2 sirve para cargas, resultados y exportaciones, pero salida gratuita no significa storage y operaciones gratis.
Facturación de operaciones Class A/B
R2 factura almacenamiento, operaciones Class A y Class B. Infrequent Access añade cargos de recuperación.
En julio de 2026, la tabla indica:
| Elemento | Nivel gratuito | Standard | Infrequent Access |
|---|---|---|---|
| Almacenamiento | 10 GB-month/mes | $0.015/GB-month | $0.01/GB-month |
| Operaciones Class A | 1M/mes | $4.50/million | $9.00/million |
| Operaciones Class B | 10M/mes | $0.36/million | $0.90/million |
| Recuperación | Ninguna | Ninguna | $0.01/GB |
| Salida a Internet | Gratis | Gratis | Gratis |
| Duración mínima | Ninguna | Ninguna | 30 días |
Las clases incluyen:

- Class A, más costosa:
PutObject,CopyObject,ListObjectsy transiciones de lifecycle. Escrituras y listados suelen caer aquí. - Class B, más barata:
GetObject,HeadObjectyHeadBucket. Las lecturas suelen caer aquí. - Operaciones gratis:
DeleteObject,DeleteBucketyAbortMultipartUpload.
Lo que no significa el nivel gratuito de R2
10 GB-month no es almacenamiento ilimitado:
- Storage: mide capacidad durante el periodo, no tráfico. Más datos requieren pago o limpieza.
- Class A: 1M de operaciones mensuales cubre muchos sitios pequeños, pero cargas por lotes pueden consumirlo rápido.
- Class B: 10M de operaciones mensuales cubre muchas lecturas, pero un origen de imágenes con gran tráfico puede superarlo.
Infrequent Access tiene una duración mínima de 30 días. Borrar antes no evita el mínimo. Es adecuado para copias y objetos duraderos, no resultados temporales.
Adecuado para cargas y resultados generados
R2 encaja con:
- Archivos de usuario como
uploads/2026/06/report.pdf, imágenes y documentos, sobre todo si se descargan mucho. - Informes generados, exportaciones y resultados de procesamiento de imágenes.
- Dumps y snapshots que deben recuperarse con bajo costo.
- Proyectos que usan Workers, D1, KV o Vectorize.
R2 no encaja con:
- Hechos de negocio como usuarios y pedidos, que requieren consultas estructuradas y control de acceso.
- Cargas que necesitan S3 Object Lock, más clases o replicación AWS nativa entre buckets y regiones.
R2 frente a S3
| Dimensión | R2 | S3 |
|---|---|---|
| Salida a Internet | Gratis del lado R2; servicios conectados pueden cobrar | Depende de región, destino y uso; consultar precios AWS actuales |
| Almacenamiento | $0.015/GB-month en Standard | Varias clases, incluidas Standard y Glacier |
| Ecosistema | Nativo en Workers y Pages | Integración profunda AWS, incluida Lambda |
| Gobierno | Lifecycle, Standard/IA y eventos por Queue | Object Lock, clases Glacier, lifecycle, Replication y varios destinos |
| Mejor uso | Ecosistema Cloudflare y entrega sensible al costo de salida | Ecosistema AWS, gobierno, data lakes y aplicaciones empresariales |
Elige R2 cuando:
- Las descargas hacen del costo de salida un factor principal.
- La aplicación ya se ejecuta en Workers o Pages.
Elige S3 cuando:
- Lambda, data lakes o flujos empresariales dependen de servicios AWS.
- Se requiere Object Lock, más clases Glacier, replicación entre regiones o gobierno IAM de AWS.
- El conjunto de herramientas AWS con CloudWatch, IAM y operaciones por lotes aporta valor.
R2 y S3 no son sustitutos completos. Un producto Cloudflare puede guardar archivos CDN y resultados en R2, y archivos sujetos a gobierno en S3.
S3: ecosistema AWS y gobierno
Amazon S3 es un servicio de almacenamiento de objetos para data lakes, sitios, aplicaciones móviles, copia/restauración, archivos, aplicaciones empresariales, IoT y analítica (Amazon S3 User Guide). Ofrece:
- Clases como Standard, Intelligent-Tiering, Glacier y Glacier Deep Archive.
- Reglas de lifecycle que mueven o eliminan objetos automáticamente.
- Object Lock con retención WORM contra sobrescritura y borrado.
- Same-Region y Cross-Region Replication para recuperación, latencia y gobierno.
- IAM, políticas de bucket y Block Public Access.
- Notificaciones de eventos para Lambda y otros destinos AWS.
Adecuado para integración AWS y gobierno
S3 encaja con:
- Productos que ya usan Lambda, EC2, RDS o DynamoDB.
- Requisitos de Object Lock, clases de archivo y retención formal.
- Data lakes y pipelines IoT dependientes de analítica AWS.
- Copias, restauraciones y archivos largos gestionados por lifecycle.
S3 encaja menos cuando:
- Muchas descargas hacen sensible el costo de salida; usa precios AWS actuales de región, destino, caché y volumen.
- La aplicación es nativa de Cloudflare y accede directo a R2 desde Workers o Pages.
S3 frente a R2: profundidad del ecosistema y gobierno
La ventaja de S3 es la amplitud de integraciones AWS y gobierno:
- Destinos de eventos: S3 Event Notifications envía a SNS, SQS, Lambda y EventBridge. R2 también envía object-create y object-delete a Cloudflare Queues, consumidas por Worker o HTTP pull.
- Clases: S3 ofrece varias clases Glacier; R2 se centra hoy en Standard e Infrequent Access.
- Object Lock: la retención WORM impide sobrescribir o borrar durante el periodo.
- Replication: S3 copia objetos, metadata y tags a un bucket de la misma región o de otra.
Elige S3 cuando:
- Lambda, data lakes o aplicaciones empresariales dependen de AWS.
- Se necesita Object Lock, clases Glacier o gobierno lifecycle.
- Los archivos de largo plazo se benefician de Glacier.
Elige R2 cuando:
- Las cargas y resultados se descargan con frecuencia.
- Workers y Pages son el runtime principal.
Una arquitectura mixta puede poner archivos CDN y resultados en R2, y copias sujetas a gobierno en S3. Deciden el tipo y el acceso, no una regla de un solo proveedor.
SQLite: primero local y embebido
SQLite encaja con datos locales, archivos de aplicación, sitios de tráfico bajo o medio, análisis y cachés (cuándo usar SQLite). No compite directamente con bases SQL cliente/servidor. Estas priorizan repositorio compartido, concurrencia, centralización y control; SQLite prioriza datos locales monousuario en un archivo copiable.
Adecuado para herramientas monousuario y backends locales
SQLite encaja con:
- Herramientas monousuario, paneles locales, utilidades de análisis, juegos pequeños y conjuntos en un archivo.
- Formatos de archivo de aplicaciones CAD, finanzas o gestión multimedia.
- Sitios de tráfico bajo o medio. SQLite indica que menos de 100K hits/día suele funcionar bien, pero es una observación conservadora, no garantía. Hardware, complejidad y escrituras concurrentes determinan la capacidad.
- Datos locales como
local-dev.sqlite. - Cachés y cálculos temporales sin estado compartido duradero.
SQLite encaja menos con:
- SaaS multiusuario con permisos, escrituras concurrentes y auditoría.
- Pedidos y derechos que requieren copias maduras y restauración temporal.
- Alta concurrencia de escritura, porque SQLite permite muchos lectores pero un writer a la vez.
SQLite frente a Postgres: señales de migración
| Dimensión | SQLite | Postgres |
|---|---|---|
| Posición | Datos locales y archivo de aplicación | Repositorio cliente/servidor compartido |
| Mejor uso | Herramientas monousuario, juegos, paneles locales | SaaS multiusuario, pedidos, derechos |
| Concurrencia | Un writer, muchos lectores | Varios writers con MVCC |
| Permisos | Sin gestión integrada de usuarios | RLS y gestión de usuarios/roles |
| Costo | Sin servidor de base separado | Depende de autohospedaje o plan administrado, compute y copias |
Pasa de SQLite a Postgres cuando:
- Una herramienta monousuario se convierte en SaaS multiusuario y necesita permisos.
- Varios usuarios o instancias modifican el mismo estado a la vez.
- Los pagos introducen pedidos y derechos que necesitan auditoría y restauración probada.
- Un modelo
users/roles/permissionsnecesita control de acceso en la base.
Un panel personal puede seguir en SQLite. Cuando varios clientes de pago comparten el servicio, Postgres suele marcar una frontera más clara.
SQLite no sustituye a Postgres
SQLite indica que no busca sustituir una base SQL cliente/servidor:
- SQLite optimiza simplicidad local monousuario y una base copiable como archivo.
- Postgres optimiza un repositorio multiusuario con cambios concurrentes y registros críticos de pago.
SQLite no necesita servidor de base independiente. El costo de Postgres depende de autohospedaje o servicio administrado, compute, almacenamiento y copias. Ambos requieren un proceso de restauración probado.
Elige SQLite para:
- Utilidades locales y juegos pequeños sin pagos ni permisos.
- Fixtures de desarrollo y datos temporales.
- Sitios personales y herramientas de documentación con pocas escrituras concurrentes.
Elige Postgres para:
- SaaS multiusuario con pedidos, suscripciones y permisos.
- Cambios operativos y de derechos que deban auditarse.
- Datos de negocio que requieran restauración temporal configurable.
Pueden coexistir: SQLite para desarrollo local o cachés regenerables, Postgres para hechos de negocio en producción.
Tres errores que debes evitar
Los fallos más comunes son guardar hechos de negocio como objetos, ignorar la facturación de D1 por recorrido y tratar el nivel gratuito de R2 como ilimitado. Dificultan la recuperación, ralentizan consultas y hacen los costos impredecibles.
Error 1: guardar hechos de negocio en almacenamiento de objetos
Tablas como users, orders y usage_events sujetos a auditoría no van en R2 o S3. El almacenamiento de objetos no ofrece consultas relacionales, restricciones, permisos por fila ni patrones de auditoría de base.
Las consecuencias son concretas:
- Sin SELECT ni JOIN: el almacén usa keys. Para responder
SELECT * FROM orders WHERE user_id = ? LIMIT 20, la aplicación tendría que listar y descargar los objetos de pedidos. - Restauración difícil: una colección de archivos no es un historial transaccional. Un dump SQL o sistema point-in-time administrado ofrece recuperación más coherente.
- Exportaciones lentas: una consulta puede transmitir registros filtrados; un objeto por pedido puede requerir recorrer muchos archivos.
Los hechos de negocio quedan en la base y los archivos en el almacén. La base guarda un object key estable; R2, S3 o Supabase Storage contiene el archivo.
Error 2: ignorar la facturación rows read
D1 cuenta filas recorridas, no devueltas. Un filtro sin índice puede consumir muchas más rows read de lo que su resultado sugiere.
En 50 000 filas de orders, SELECT * FROM orders WHERE user_id = ? LIMIT 20 puede leer muchas filas sin índice. meta.rows_read muestra el uso facturable. Las consultas Free fallan tras 5M diarias; Paid cobra lo que excede el incluido mensual.
Solución:
- Indexa la columna real, por ejemplo
CREATE INDEX idx_user_id ON orders(user_id);. - Comprueba con
EXPLAIN QUERY PLANymeta.rows_readsi queda un recorrido completo. - Selecciona solo las columnas necesarias para reducir respuesta, recordando que D1 cuenta filas, no columnas.
Error 3: creer ilimitado el nivel gratuito de R2
R2 Free incluye hoy 10 GB-month de Standard storage, 1M operaciones Class A y 10M Class B por mes. Son cuotas.
Errores comunes:
- 10 GB-month mide capacidad almacenada a lo largo del tiempo, no transferencia.
PutObjectes Class A. La creación por lotes puede agotar la cuota aunque el volumen total sea pequeño.- Infrequent Access exige 30 días mínimos; borrar antes sigue cobrando ese mínimo.
Supervisa almacenamiento y operaciones, caduca resultados antiguos y no uses Infrequent Access para temporales. SQLite local o un caché puede ser mejor para datos breves.
Conclusión
El tipo decide: hechos de negocio, eventos, objetos, cachés, datos locales, datos edge ligeros y copias. Supabase Postgres suele poseer los hechos por sus restricciones, RLS, recuperación configurable y auditoría. D1 encaja con datos relacionales ligeros cercanos a Workers, R2/S3 con objetos y SQLite con datos locales monousuario.
Tres acciones hacen más segura la primera versión:
- Clasifica cada objeto y anota consultas, permisos, frecuencia y requisitos de costo.
- Indexa columnas de filtro D1 y verifica el resultado con métricas rows read.
- Mantén registros de negocio fuera del almacén de objetos, evita recorridos sin índice y estima toda la cuota R2, no solo storage.
Los siguientes artículos tratan pagos y usuarios. Refuerzan la frontera: pedidos de pago necesitan restricciones Postgres, copias y auditoría; derechos y permisos de usuarios necesitan RLS y recuperación probada.
Si el destino de un objeto sigue sin estar claro, vuelve a la tabla y a los artículos anteriores sobre principios de arquitectura, backend y despliegue. Define la frontera del sistema antes de afinar el almacenamiento.
Asignar almacenamiento a un proyecto personal
Separa en seis pasos, desde el inventario hasta la restauración, las funciones de la base y del almacenamiento de objetos.
- 1
Step 1: Inventariar los objetos
Enumera users, orders, usage_events, uploads, cachés, archivos locales y copias sin agruparlos primero por producto. - 2
Step 2: Clasificar cada objeto
Marca cada elemento como hecho de negocio, evento, archivo objeto, caché, dato local o copia, e indica si puede caducar o regenerarse. - 3
Step 3: Definir consistencia y permisos
Registra transacciones, restricciones, RLS, escrituras concurrentes, auditoría y uso multiinstancia para decidir entre Postgres y D1. - 4
Step 4: Estimar accesos y costos
Estima D1 rows read/written, R2 Class A/B operations, volumen, frecuencia de lectura y posibles cargos de salida. - 5
Step 5: Diseñar referencias estables
Conserva object key, owner, status y metadata en la base, el contenido en almacenamiento de objetos y nombres de key estables. - 6
Step 6: Probar copia y migración
Prepara exportaciones, copias externas, ventanas de borrado y simulacros de restauración; migra metadata, después objetos y por último las lecturas.
FAQ
¿Un proyecto personal debe empezar con D1 o Supabase Postgres?
¿Qué se guarda en R2 o S3?
¿SQLite puede sostener el primer SaaS?
¿Se pueden guardar archivos de usuarios en la base?
¿Qué significa la facturación de D1 rows read?
¿Alcanza el nivel gratuito de Cloudflare R2?
20 min de lectura · Publicado el: 9 oct 2026

Guia de stack tecnico para solo founders
Si llegaste desde búsqueda, lo más rápido es ir al artículo anterior o siguiente de esta misma serie.
Anterior
Despliegue para solopreneurs: Cloudflare, Vercel o Railway
Compara Cloudflare Pages y Workers, Vercel y Railway por tipo de carga, límites actuales, riesgos de facturación y mantenimiento para un stack en solitario.
Parte 7 de 8
Siguiente
Este es el artículo más reciente de la serie por ahora.


Comentarios
Inicia sesión con GitHub para dejar un comentario