
AI 内容还能做 SEO 吗?Google 批量内容与质量门禁
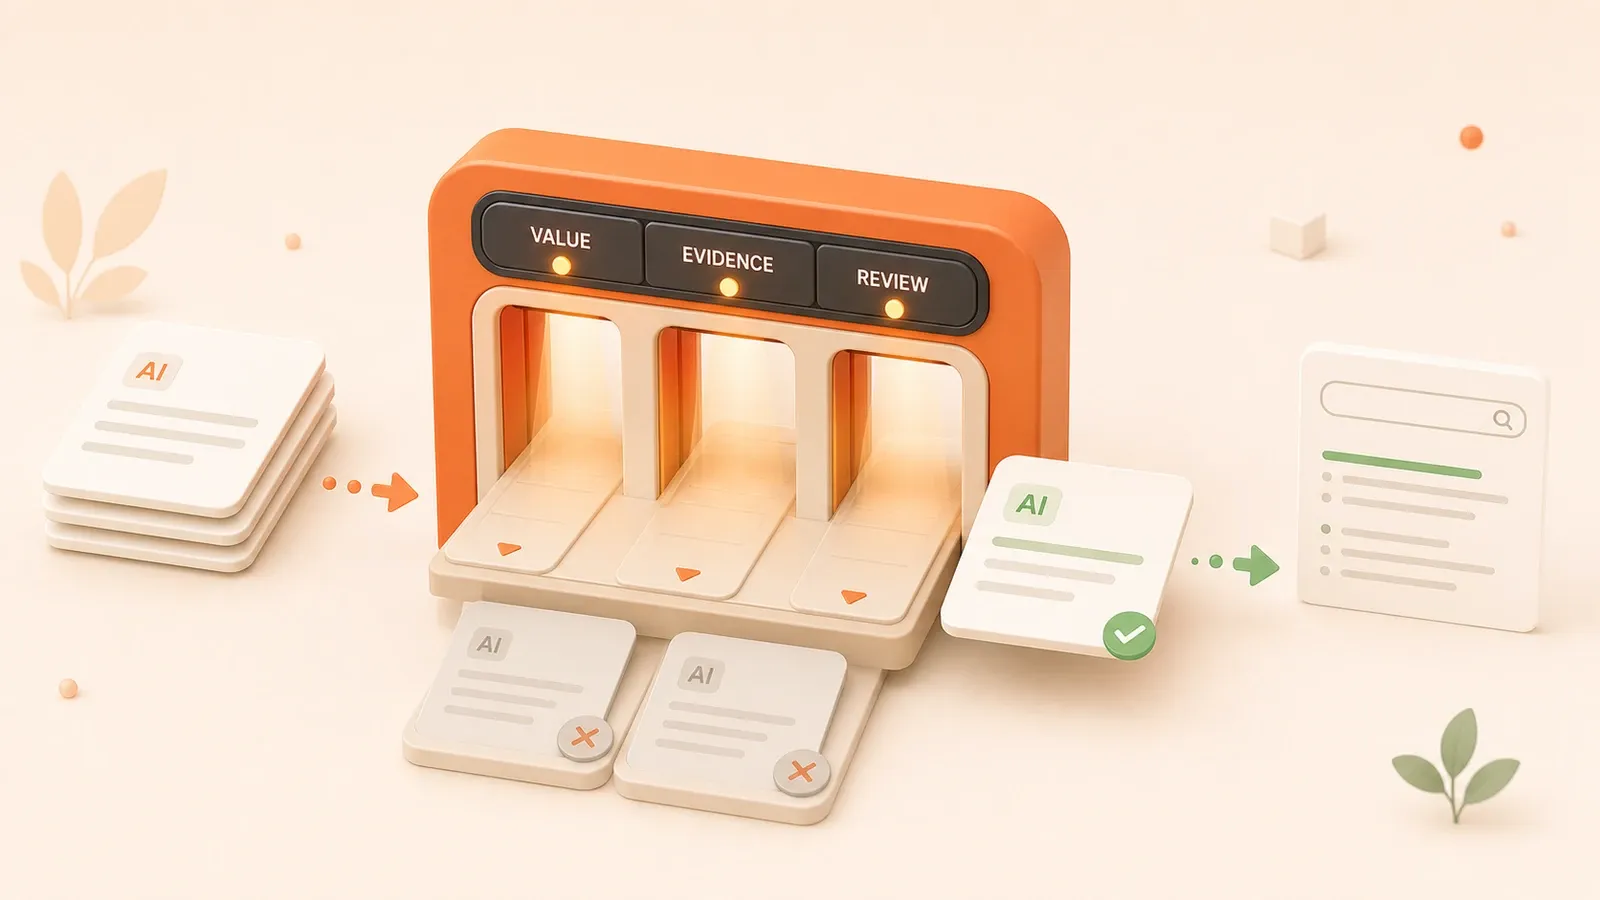
"Google Search 的生成式 AI 内容指南说明,AI 可用于调研和组织原创内容,但批量生成不增加用户价值的页面可能违反 scaled content abuse 政策。"
内容任务表里有 20 篇已完成调研的选题,你准备一键生成草稿。鼠标停在“批量发布”按钮前,最近看到的“Google 打击 AI 内容”新闻又让你不确定:这个按钮能不能点?
本文基于 Google 官方文档,回答三个问题:AI 参与写作会不会违规?批量操作的红线在哪里?如何把质量门禁落到每篇文章?
Google 官方立场:AI 不是原罪
Google 在 2023 年 2 月的官方博客中明确回应:“适当使用 AI 或自动化不违反我们的指南。”这句话来自 Google Search Central Blog 的 FAQ,直接回答了站长最关心的问题:AI 本身不是违规原因。
问题在于用途。Google 同一篇博客说明,使用包括 AI 在内的自动化手段,主要为了操纵搜索排名,会违反 spam policies。换句话说,工具不是判断依据,目的和结果才是。如果内容主要为了帮助用户,而不是刷排名,AI 辅助写作本身并不违规。
AI 也没有排名特权。Google 明确表示,AI 不会带来特殊排名收益;内容如果有用、原创并体现 E-E-A-T,可能表现良好,否则可能不会。这意味着 AI 写的内容不会因为用了 AI 就自动排得更好,也不会因为用了 AI 就被自动惩罚。排名取决于内容本身是否 helpful、reliable、people-first。
Google 当前的 spam policies 给出了更精确的风险边界:规模化内容主要为了操纵排名而不是帮助用户,并常表现为大量缺少原创性、对用户几乎没有价值的页面。是否使用 AI 并不是核心条件。
把这些判断放在一起,可以消除最常见的误解:
| 读者疑问 | Google 官方回答 |
|---|---|
| Google 禁止 AI 内容吗? | 不禁止。适当使用 AI 不违反指南。 |
| AI 内容会自动排名更高吗? | 不会。AI 没有排名特权。 |
| AI 内容会被自动惩罚吗? | 不会。风险在于规模化内容主要为了操纵排名,而不是帮助用户。 |
真正需要警惕的不是“用了 AI”,而是“如何用”。AI 用于调研主题、结构化原创内容、改进表达,是适当使用。但如果批量生成很多页面,每个页面主要目的是刷排名,对用户几乎没有真实价值,就可能触发 spam policies。
Scaled Content Abuse:同时看规模、目的和用户价值
March 2024 Core Update 引入了新的 spam policies,其中 scaled content abuse 扩展了旧的 automatically-generated content 政策。Google 在 2024 年 3 月的官方博客里解释:新政策不再只覆盖自动化生成的内容,而是覆盖自动化、人力或混合流程产生的低价值规模化内容。
这意味着,即便是人工洗稿的批量页面,只要主要为了操纵排名而不是帮助用户,同样可能违规。工具本身不重要,判断时要同时看三个轴:
- Many pages:是否在规模化生成页面
- Primary purpose manipulating rankings:主要目的是否是操纵排名
- Little or no value to users:页面是否缺少原创性和用户价值
Google 的正式定义把“规模化页面”“主要为了操纵排名”“而不是帮助用户”连在一起;“缺少原创性、很少或没有用户价值”是这类滥用的典型表现。不要把它机械理解成只要少发几页,或者塞入少量独特文字,就一定安全。
比如,你为产品文档的每个功能生成独立页面,每个页面有真实差异和价值,主要目的是帮助用户理解产品功能,即便数量多,也不等于 spam。但如果你批量生成 1000 个页面,每个页面只是关键词变体,主要目的是覆盖长尾搜索词,对用户几乎没有帮助,就符合 scaled content abuse 的风险特征。
用表格对比会更清楚:
| 判断轴 | 高风险表现 | 较安全表现 |
|---|---|---|
| Many pages | 大量近似页面同时上线 | 数量由真实产品、数据或用户需求决定 |
| Primary purpose | 主要为了操纵排名或 AI 响应 | 主要为了帮助目标用户完成任务 |
| Little/no value | 每页只有关键词或变量替换 | 每页有可验证的差异和原创增量 |
判断时可以用这个清单:
✓ 主要目的是帮助用户(而非操纵排名)
✓ 每页对用户有真实价值(而非只是关键词变体)
✓ 内容有原创增量(而非只是改写或翻译)
→ 可持续的规模化

✗ 主要目的是操纵排名
✗ 对用户几乎没有价值
✗ 批量生成无差异页面
→ Scaled Content Abuse 风险
核心问题不是“能不能批量”,而是“批量后每页有没有真实差异和价值”。如果规模化操作来自真实数据和用户需求,每个页面有原创增量,风险较低。如果规模化只是为了覆盖更多关键词,页面之间只有表面差异,就是 spam 风险。
People-First Content 自评清单
Google 的 Creating helpful, reliable, people-first content 文档提供了一个自评框架,把抽象原则拆成 Who、How、Why 三个维度。这些问题是给创作者用的,不是给算法打分用的。你可以在发布前问自己这些问题,判断内容是否真的以用户为中心。

Who:内容是给谁的?
- 内容是否有明确的目标受众?还是试图覆盖所有可能的读者?
- 是否展示了第一手经验或专业知识?还是只是总结别人的观点?
- 读者读完能学到东西或完成任务吗?还是只是读完就忘了?
- 内容是否会让读者觉得“这是专门为我写的”?还是觉得“这又是千篇一律的内容”?
How:内容是如何产生的?
- 内容是否经过人工审核和验证?
- 是否清楚标注了来源和作者信息?还是来源和作者都不清楚?
- 内容是否准确、完整、有帮助?还是有明显错误或遗漏?
- 是否有明显的自动化痕迹?比如格式统一但内容空洞,或者所有段落长度都差不多。
Why:内容为什么存在?
- 内容的主要目的是帮助用户还是操纵排名?
- 内容是否为了追热点、追关键词而写?还是因为真的有东西要分享?
- 是否为了字数而写,而非为了解决问题?
Google 还列出了 search engine-first 警告信号,帮助识别内容是否偏离 people-first 原则:
- 大量多主题内容,而非专注某一领域
- 广泛自动化,而非人工审核
- 主要总结别人内容,而非提供原创见解
- 追趋势、追关键词,而非解决真实问题
- 为字数而写,而非为读者价值而写
- 改日期装新鲜,而非实质性更新
把这些信号放在一起,可以做一个对比表格:
| 维度 | People-First | Search Engine-First |
|---|---|---|
| Who | 明确目标受众、第一手经验 | 无明确受众、总结别人内容 |
| How | 人工审核、标注来源 | 广泛自动化、无审核痕迹 |
| Why | 帮助用户解决问题 | 操纵排名、追关键词 |
这些自评问题不要求每篇都打分,但可以作为发布前的最后一道检查。如果内容在 Who、How、Why 三个维度都偏向 search engine-first,即便没有触发 spam policies,也可能不会表现良好。
E-E-A-T 在 AI 内容中的体现
E-E-A-T 是 Experience(经验)、Expertise(专业性)、Authoritativeness(权威性)、Trustworthiness(可信度)的缩写,来自 Google 的 Search Quality Rater Guidelines。但首先要澄清一个误解:E-E-A-T 本身不是直接的排名因子。
Google 文档明确说,E-E-A-T 本身不是一个 specific ranking factor。Google 系统会使用多种因素来识别体现 E-E-A-T 的内容,但它不是可以直接优化成数值分数的单一指标。Rater Guidelines 是给评分员使用的;评分员的判断不直接影响排名,而是帮助 Google 评估和改进系统。
但 E-E-A-T 仍然是有用的质量框架。你可以用它来检查内容是否体现了用户期望的质量信号。对于 AI 辅助内容,核心问题是如何在流水线中留下这些信号。
Experience(经验)
AI 内容能否展示真实使用经验?AI 可以写技术原理,但很难凭空写出“我踩过这个坑”的第一手经验。解决方案是结合个人实践:在 AI 生成的框架里加入真实案例、失败复盘和实际遇到的问题。比如,一篇关于 Docker 部署的文章,AI 可以写出步骤,但你需要补充生产环境中遇到的问题和排查过程。
检查项:是否有第一手经验描述?是否有真实案例或失败复盘?
Expertise(专业性)
专业性来自作者背景、一手证据和技术深度。AI 可以帮助整理技术细节,但你需要标注谁审核了内容、依据了哪些权威材料。比如,一篇关于 Cloudflare Workers 的文章,AI 可以写出功能介绍,但你需要标注依据(官方文档、实际测试)和审核者(谁确认了技术细节)。
检查项:是否标注 author_reviewed_by?是否引用权威来源?是否有技术深度分析?
Authoritativeness(权威性)
权威性来自其他网站的推荐和同行认可。这不是单篇文章可以控制的,而是长期积累的结果。你可以通过公开可复核的实践、获取高质量外链来建立权威性。对于 AI 辅助内容,核心是确保内容值得被推荐:有原创观点、独特视角、真实数据。
检查项:是否获得其他网站推荐?是否公开了可复核的实践?内容是否值得被推荐?
Trustworthiness(可信度)
可信度来自明确来源、作者信息和更新记录。这是最容易落地的部分:每篇文章标注 sources(来源列表)、last_updated(最后更新日期)、author_reviewed_by(审核者)。这些信息告诉读者:内容经过验证、有来源可查、有人负责。Google 的 people-first 文档还强调,在 E-E-A-T 的几个方面中,trust 最重要。
检查项:sources 是否填写?last_updated 是否维护?author_reviewed_by 是否标注?
把这四个维度放在一起,可以做一个对照表:
| 维度 | AI 内容如何体现 | 检查项 |
|---|---|---|
| Experience | 结合个人实践、真实案例 | 是否有第一手经验描述? |
| Expertise | 标注作者背景、引用权威来源 | 是否标注 author_reviewed_by? |
| Authoritativeness | 获得外链与同行认可 | 是否有其他网站推荐? |
| Trustworthiness | 标注来源、作者、更新记录 | sources、last_updated 是否填写? |
常见误解清单:
- 误解 1:E-E-A-T 可以直接优化成数值分数
- 误解 2:E-E-A-T 是单一排名因子
- 误解 3:AI 内容天然无法满足 E-E-A-T
- 正确理解:E-E-A-T 是质量信号框架,AI 内容仍可通过人工审核、来源标注、原创增量来体现
AI 内容声明与透明性建议
Google 是否强制要求声明 AI 参与?答案是不强制。Google 的公开 FAQ 没有要求所有 AI 内容都必须声明“由 AI 生成”。但 Google 建议在读者会合理关心内容如何产生的场景提供上下文:让读者知道自动化如何使用、来源是什么、谁审核了。

透明性包括四个要素:
- 作者信息:谁写了或审核了内容
- 来源列表:引用了哪些文档、数据、案例
- 更新记录:内容最后更新时间
- AI 使用方式:AI 参与了哪些环节(调研、结构、草稿、改进表达)
这四个要素不需要在每篇文章开头写一段固定声明,而是可以通过页面信息、元数据、侧边栏等方式呈现。比如,文章底部有作者信息、来源列表和最后更新日期,就已经给读者提供了重要上下文。
但在某些领域,明确标注 AI 参与更有必要。涉及医疗、金融、法律等专业领域的内容,读者对信息来源和准确性更敏感。在这些领域,建议明确说明内容是否经过专业人士审核、AI 参与了哪些环节。比如,一篇关于税法的文章,可以标注“本文参考 IRS 官方文档,内容由税务专业人士审核,AI 用于结构化信息和改进表达”。
程序化页面也需要说明生成逻辑。如果站点有大量由程序生成的页面,例如产品页、城市页,可以在页面或方法文档中说明:这些页面如何产生、数据来源是什么、每页有哪些真实差异。比如,一个程序化 SEO 页面可以说明“本页面基于真实用户数据生成,每个页面包含城市特定服务信息和本地化内容”。
核心原则:不要把 disclosure 写成所有 AI 内容都必须用的固定声明。透明性不是套模板,而是让读者清楚内容的来源、审核者和更新状态。
批量翻译、改写、程序化 SEO 风险判断
很多站点会进行规模化操作:批量翻译、改写现有内容、程序化生成页面。这些操作本身不违规,但要看 primary purpose 和 added value。
批量翻译
安全场景:翻译用户真正需要的内容,例如产品文档、技术教程;保留原文价值,不做过度简化;进行术语、表达和搜索意图本地化,而不是只做未经校对的机器翻译。
风险场景:机器翻译后不校对,出现大量语法错误和文化不适配;仅为覆盖关键词,把一篇低价值文章翻译成多种语言;不同语言版本没有人工检查或用户需求依据。
判断问题:用户是否真的需要这个语言版本?翻译后是否保留了原文价值?是否做了本地化调整?
改写/同义词替换
安全场景:改写后新增原创见解,例如在现有技术文章基础上加入自己的实践经验;面向不同受众重新组织;结合新的数据或案例,而不只是改变表达。
风险场景:仅为绕过重复内容检测,把别人的文章改几个词就当原创;改写后和原文几乎一样,只是表达方式不同;批量改写站内文章,只为覆盖更多关键词。
判断问题:改写后是否有新增价值?是否有原创见解或新的案例?是否真正面向不同受众?
程序化 SEO
安全场景:页面由真实数据驱动,每个产品或地区有可验证的差异;页面满足具体查询意图,读者确实需要独立页面。
风险场景:模板只替换城市名、产品名或关键词;生成大量长尾关键词变体页,每页没有真实差异;抓取、拼接或翻译其他页面后不增加价值。
判断问题:每页是否有真实差异?用户是否真的需要这个页面?页面是否满足具体查询意图?
把这三种操作放在一起,可以做一个风险判断表:
| 操作类型 | 安全边界 | 风险边界 |
|---|---|---|
| 批量翻译 | 本地化调整、保留价值、用户真正需要 | 机器翻译不校对、仅覆盖关键词、低价值内容 |
| 改写 | 新增原创见解、面向不同受众、结合新数据 | 绕过重复检测、无新增价值、批量改写 |
| 程序化 SEO | 数据驱动、真实差异、满足查询意图 | 模板填充、覆盖长尾、近似页面 |
核心判断标准是 primary purpose + added value。问自己三个问题:
- 主要目的是帮助用户吗?还是操纵排名?
- 每页有真实的增量价值吗?还是只有表面差异?
- 用户确实需要这些页面吗?还是你假设他们需要?
如果答案都能用证据支持,就是可持续的规模化。如果主要目的、页面价值或用户需求站不住脚,就需要重新审视风险。
AI Search / Fan-out Queries 新风险
AI 搜索时代带来新的风险。Google 的 AI features 和 generative AI search 会在用户提问时生成多个查询变体,这些变体常被称为 fan-out queries。比如,用户问“如何改进 Docker 性能”,AI 搜索可能同时查询 Docker 性能技巧、容器资源限制和性能监控工具等相关问题。
一些站点为了覆盖这些变体,会为每个查询创建独立页面。这种做法看起来是合理的关键词覆盖,但可能触发 scaled content abuse。
Google 当前的 generative AI search 优化指南 明确提醒:不要为了覆盖每一种查询或 fan-out query 而创建大量独立页面。如果主要目的是操纵排名或 Google Search 的生成式 AI 响应,就会违反 scaled content abuse 政策。
更稳妥的做法是用一篇内容全面回答相关问题,而不是为每个变体创建独立页面。比如,一篇 Docker 性能改进指南可以涵盖技巧、资源限制、监控工具等多个子话题,让用户在一个页面完成任务。
这个话题涉及 AI Search 和 GEO 的更深层策略,后续会单独讨论。本篇只提醒风险:不要为了覆盖查询变体批量生成低价值页面。
AI 内容流水线质量门禁字段
把 Google 的质量原则转为可执行的内容任务表字段,是落地 people-first 的最后一步。每个字段对应一个具体的质量信号,发布前必须填写。
字段定义
| 字段名 | 用途 | 必填/选填 | 对应 Google 原则 |
|---|---|---|---|
| sources | 文章引用的所有来源链接 | 必填 | Trustworthiness、Expertise |
| author_reviewed_by | 作者或审核者信息 | 必填 | Expertise、Accountability |
| original_increment | 相比现有内容新增的原创价值(观点、数据、案例) | 必填 | People-first、Added value |
| human_qa_status | 人工质量审核状态(草稿/审核中/已发布) | 必填 | How、Trustworthiness |
| gsc_feedback | 发布后从 GSC 回写的查询和页面反馈 | 选填 | Why、持续改进 |
| last_updated | 最后更新日期 | 必填 | Freshness、Trustworthiness |
| ai_usage | AI 使用方式(调研/结构/草稿/改进表达) | 选填 | Transparency |
门禁通过标准
发布前必须满足以下条件:
- sources 不为空:至少 3 个高置信度材料(官方文档、权威博客、实际测试)
- author_reviewed_by 已填写:明确谁审核了内容
- original_increment 已说明:至少 1 个原创观点、案例或数据
- human_qa_status 从“审核中”进入“已批准”:经过人工审核
- last_updated 为本次实质审核或更新日期
实际应用示例
安全示例:
sources: ["https://developers.google.com/search/docs/fundamentals/using-gen-ai-content",
          "https://developers.google.com/search/docs/essentials/spam-policies",
          "https://developers.google.com/search/blog/2023/02/google-search-and-ai-content"]
author_reviewed_by: "张三(技术博客站长)"
original_increment: "提供 Google 政策拆解 + 三轴判断框架 + 质量门禁字段设计"
human_qa_status: "已批准"
last_updated: "2026-07-26"
ai_usage: "调研、结构、草稿改进表达"
风险示例:
sources: []
author_reviewed_by: ""
original_increment: ""
human_qa_status: "草稿" → 直接发布
last_updated: ""
ai_usage: "全文生成未审核"
阶段检查清单
| 阶段 | 必填字段 | 检查项 |
|---|---|---|
| 调研阶段 | sources | 至少 3 个高置信度来源 |
| 写作阶段 | original_increment | 至少 1 个原创观点、案例或数据 |
| 审核阶段 | author_reviewed_by, human_qa_status | 审核者已填写,状态为“已批准” |
| 发布后 | gsc_feedback, last_updated | GSC 数据回写,更新日期对应实质改动 |
这些字段不是 Google 官方规定,而是基于 people-first 原则推导的实践。你的工作流可以使用不同字段名,但核心逻辑不变:每篇文章必须有来源、审核者、原创增量、人工批准和更新记录。
结论
AI 参与内容生产不是原罪,低价值批量操纵才是风险。判断的核心在于三个问题:主要目的是帮助用户吗?每页有真实增量吗?用户确实需要这些页面吗?
发布前检查内容任务表:sources、author_reviewed_by、original_increment 填写了吗?门禁通过标准满足了吗?如果内容有来源、有审核者、有原创增量,批量发布前先过一遍这些检查,而不是让鼠标停在按钮前犹豫。
后续会单独讨论 AI Search/GEO 的深度优化方法,重点是让内容被 AI 搜索正确理解和引用,而不是为了覆盖查询变体批量生成低价值页面。
建立 AI 内容发布前的最小质量门禁
从选题到发布后复盘,为每篇 AI 辅助内容保留用户价值、事实与人工责任证据。
- 1
步骤 1: 确认目标读者与站点边界
先说明谁会直接受益、文章解决什么问题,不为可能的流量跨入缺少经验的领域。 - 2
步骤 2: 检查站内重叠
在调研前检索既有文章,决定新建、刷新、合并或停止,避免制造近似页面。 - 3
步骤 3: 保留一手来源
对政策、价格、版本和技术限制记录官方或一手材料及读取日期。 - 4
步骤 4: 写明原创增量
记录本篇新增的测试、经验、分析、数据或决策框架,不能只改写已有内容。 - 5
步骤 5: 完成事实与表达审核
核对事实、示例、标题承诺、重复内容和自动化痕迹,补充实际验证。 - 6
步骤 6: 记录人工责任
填写审核者、来源、AI 使用方式和风险说明,最终发布必须由人批准。 - 7
步骤 7: 用真实反馈触发更新
发布后用 GSC 查询与页面表现决定实质更新,不只修改日期或摘要。
常见问题
AI 生成内容会被 Google 自动惩罚吗?
Google 反对 AI 内容,还是反对低质量批量内容?
什么是 scaled content abuse?
用 AI 写技术博客还能做 SEO 吗?
批量翻译或程序化 SEO 一定违规吗?
AI 内容必须声明由 AI 生成吗?
19 分钟阅读 · 发布于: 2026年11月13日


评论
使用 GitHub 账号登录后即可评论