
I contenuti con IA funzionano ancora per la SEO? Regole Google
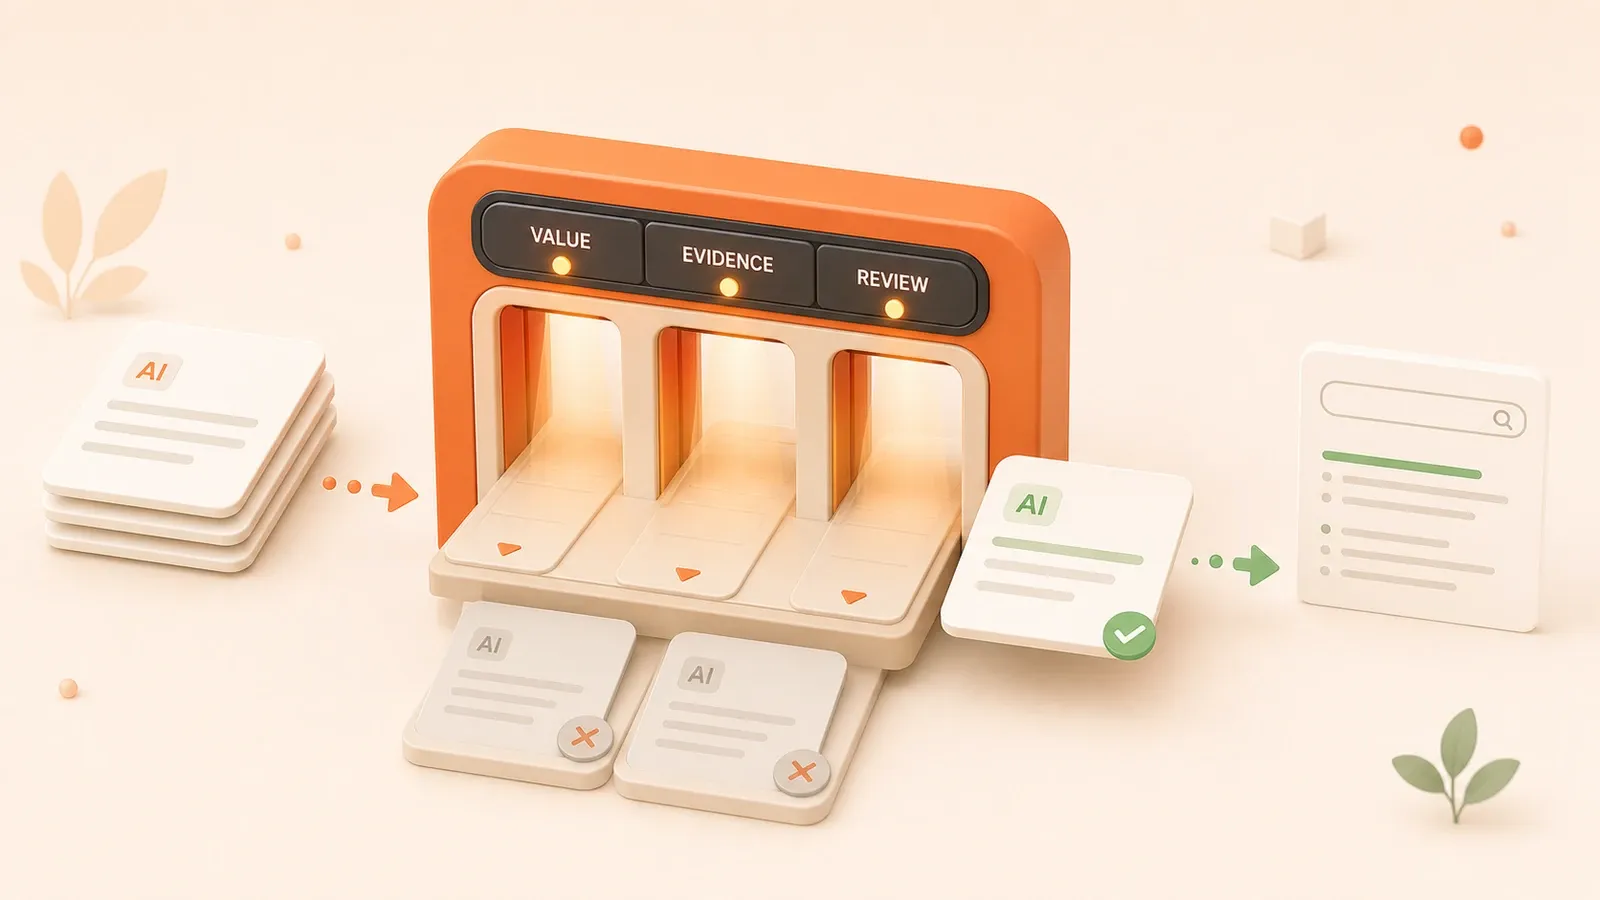
"Le indicazioni di Google sui contenuti con IA generativa spiegano che l’IA può aiutare ricerca e struttura di contenuti originali, ma generare molte pagine senza valore per gli utenti può violare la policy sullo scaled content abuse."
La bacheca editoriale contiene 20 argomenti già studiati e tutti i bozzi stanno per essere generati in una volta. Tuttavia, dopo un altro titolo su Google che «colpisce i contenuti con IA», il cursore si ferma su «Pubblica in massa». È sicuro fare clic?
La documentazione di Google permette di rispondere a tre domande: scrivere con l’aiuto dell’IA viola le regole? Dove si trova il limite della pubblicazione su larga scala? Come si applica un controllo qualità a ogni articolo?
La posizione di Google: l’IA non è la violazione
In un post ufficiale del febbraio 2023, Google ha risposto chiaramente che l’uso appropriato di IA o automazione non viola le sue linee guida. La FAQ di Search Central risolve la preoccupazione principale: l’IA, da sola, non rende un contenuto contrario alle regole.
Il problema è lo scopo. Lo stesso post spiega che usare automazione, inclusa l’IA, principalmente per manipolare il ranking di ricerca viola le spam policies. Lo strumento non è il criterio decisivo; lo sono intenzione e risultato. Se il contenuto esiste soprattutto per aiutare le persone e non per manipolare il ranking, la scrittura assistita dall’IA non è vietata.
L’IA non riceve nemmeno un privilegio di ranking. Google afferma che i contenuti con IA non ottengono vantaggi speciali. Un contenuto utile, originale e capace di mostrare aspetti di E-E-A-T può funzionare bene; uno debole può non riuscirci. Un testo non viene favorito o punito automaticamente per l’uso dell’IA. Deve essere helpful, reliable e people-first.
Le attuali spam policies di Google tracciano un confine più preciso: contenuti prodotti su larga scala principalmente per manipolare il ranking invece di aiutare gli utenti, spesso come grandi volumi di materiale poco originale con poco o nessun valore. L’uso dell’IA non è la prova centrale.
I malintesi più comuni si riassumono così:
| Domanda | Risposta di Google |
|---|---|
| Google vieta i contenuti con IA? | No. L’uso appropriato dell’IA non viola le linee guida. |
| I contenuti con IA ottengono automaticamente un ranking migliore? | No. L’IA non ha un vantaggio speciale. |
| I contenuti con IA vengono penalizzati automaticamente? | No. Il rischio è produrre su larga scala soprattutto per manipolare il ranking e non per aiutare. |
L’avvertimento non riguarda l’aver usato l’IA, ma come la si usa. L’IA può supportare la ricerca degli argomenti, strutturare materiale originale e migliorare la scrittura. Il rischio compare quando vengono generate molte pagine per conquistare posizioni, con quasi nessun valore reale per gli utenti.
Scaled content abuse: valutare insieme scala, scopo e valore
La March 2024 Core Update ha introdotto nuove spam policies. Lo scaled content abuse ha ampliato la precedente policy sull’automatically-generated content. L’annuncio Google di marzo 2024 ha chiarito che contenuti di basso valore su larga scala possono provenire da automazione, lavoro umano o flussi misti.
Anche le pagine riscritte da persone possono quindi violare la policy. Lo strumento non conta; bisogna valutare tre dimensioni:
- Many pages: il flusso produce pagine su larga scala?
- Primary purpose of manipulating rankings: manipolare il ranking è lo scopo principale?
- Little or no value to users: le pagine mancano di originalità e valore?
La definizione formale di Google unisce molte pagine generate, lo scopo principale di manipolare il ranking e la mancata utilità per gli utenti. Scarsa originalità e poco o nessun valore sono caratteristiche tipiche. Non va trasformata in una scappatoia meccanica in cui meno pagine o un paragrafo unico garantiscono la conformità.
Pagine separate per funzioni diverse di un prodotto possono essere utili se ognuna contiene differenze reali e aiuta a comprendere quella funzione. Il volume da solo non le rende spam. Al contrario, 1.000 pagine che cambiano solo una parola chiave, servono a coprire ricerche long tail e aiutano appena l’utente mostrano il modello dello scaled content abuse.
Confronto delle tre dimensioni:
| Dimensione | Modello ad alto rischio | Modello più sicuro |
|---|---|---|
| Many pages | Viene pubblicato insieme un grande gruppo di pagine quasi identiche | Il numero segue prodotti, dati o esigenze reali |
| Primary purpose | Manipolare ranking o risposte generative | Aiutare un pubblico definito a completare un’attività |
| Little/no value | Cambiano solo parole chiave o variabili | Ogni pagina ha differenze verificabili e valore originale |
Questa lista aiuta nel controllo:
✓ Lo scopo principale è aiutare gli utenti, non manipolare il ranking
✓ Ogni pagina offre valore reale, non solo una variante di parola chiave
✓ Il contenuto aggiunge qualcosa di originale, invece di limitarsi a riscrivere o tradurre
→ Pubblicazione sostenibile su larga scala

✗ Lo scopo principale è manipolare il ranking
✗ Le pagine offrono poco o nessun valore
✗ Pagine senza differenze vengono generate in massa
→ Rischio di scaled content abuse
La domanda centrale non è se la pubblicazione possa essere automatizzata, ma se ogni pagina risultante abbia una differenza reale e un motivo per esistere. Scalare partendo da dati ed esigenze autentiche, con un contributo originale per pagina, riduce il rischio. Varianti superficiali create solo per coprire più parole chiave riproducono il modello dello spam.
Autovalutazione dei contenuti people-first
Il documento Google Creating helpful, reliable, people-first content organizza l’autovalutazione intorno a Who, How e Why. Sono domande per i creatori, non punteggi per un algoritmo. Prima della pubblicazione aiutano a capire se una pagina serve davvero le persone.

Who: per chi è il contenuto?
- Esiste un pubblico definito o la pagina cerca di rivolgersi a tutti?
- Mostra esperienza diretta o competenza, oppure riassume soltanto opinioni altrui?
- Il lettore può imparare o completare un’attività, oppure se ne va senza risultato?
- Sente che il testo è stato scritto per la sua situazione o che è un altro articolo intercambiabile?
How: come è stato prodotto?
- Una persona lo ha rivisto e verificato?
- Fonti e autore sono chiaramente identificati o restano entrambi sconosciuti?
- È accurato, completo e utile, oppure contiene errori e omissioni evidenti?
- Mostra tracce di automazione, come forma uniforme con poca sostanza?
Why: perché esiste?
- Lo scopo principale è aiutare o manipolare il ranking?
- È stato creato solo per seguire una tendenza o una parola chiave, oppure c’è qualcosa di rilevante da spiegare?
- È stato scritto per raggiungere una quantità di parole invece di risolvere un problema?
Google elenca anche segnali di search engine-first content:
- Pubblicare su molti argomenti senza un focus chiaro
- Usare automazione estesa senza revisione individuale
- Riassumere soprattutto materiale altrui senza idee proprie
- Inseguire tendenze e parole chiave invece di problemi reali
- Scrivere per una quantità di parole e non per il valore
- Cambiare la data senza aggiornamento sostanziale per apparire recente
Il contrasto:
| Dimensione | People-First | Search Engine-First |
|---|---|---|
| Who | Pubblico definito ed esperienza diretta | Pubblico poco chiaro e riassunti di altri contenuti |
| How | Revisione umana e fonti chiare | Automazione ampia senza prove di revisione |
| Why | Risolvere un problema dell’utente | Manipolare il ranking e inseguire parole chiave |
Non è necessario assegnare un punteggio a ogni articolo. Le domande funzionano come controllo finale. Se Who, How e Why puntano tutti verso search engine-first, il contenuto può rendere male anche senza superare chiaramente una linea di spam.
Come i contenuti con IA possono dimostrare E-E-A-T
E-E-A-T significa Experience, Expertise, Authoritativeness e Trustworthiness, termini delle Search Quality Rater Guidelines di Google. Prima va eliminata una confusione: E-E-A-T non è di per sé un fattore di ranking diretto.
Google dice esplicitamente che E-E-A-T non è uno specific ranking factor. I suoi sistemi usano una combinazione di fattori per riconoscere queste qualità, ma non esiste un punteggio unico da ottimizzare. Le Rater Guidelines guidano i valutatori; i loro giudizi non modificano direttamente il ranking, ma aiutano Google a valutare e migliorare i sistemi.
E-E-A-T resta un modello di qualità utile. Un flusso editoriale può verificare se esistono i segnali attesi dai lettori. Nei contenuti assistiti dall’IA, la domanda pratica è come conservare le relative prove.
Experience
I contenuti con IA possono mostrare uso reale? Un modello sa spiegare principi tecnici, ma non può inventare esperienza diretta credibile. Vanno aggiunti casi reali, tentativi falliti e problemi incontrati. In un articolo sul deployment Docker, l’IA può preparare i passaggi, ma il problema in produzione e l’indagine che lo ha risolto devono venire da chi li ha vissuti.
Controllo: è presente esperienza diretta? Il testo include un caso reale o un’analisi di errore?
Expertise
La competenza deriva dal profilo dell’autore, dalle prove primarie e dalla profondità tecnica. L’IA può organizzare i dettagli, ma la pagina deve indicare chi li ha verificati e quali fonti autorevoli li sostengono. Una spiegazione su Cloudflare Workers necessita comunque di documentazione ufficiale o test e di una persona responsabile.
Controllo: author_reviewed_by è compilato? Ci sono fonti autorevoli? È presente un’analisi tecnica?
Authoritativeness
L’autorevolezza si costruisce con raccomandazioni di altri siti e riconoscimento dei colleghi. Un solo articolo non può fabbricarla. Pratiche riproducibili, argomenti originali, punti di vista distinti e dati reali possono meritare link di qualità.
Controllo: altri siti raccomandano il lavoro? La pratica è riproducibile? Il contenuto merita di essere consigliato?
Trustworthiness
La fiducia deriva da fonti chiare, informazioni sull’autore e cronologia degli aggiornamenti. È la parte più semplice da implementare. sources, last_updated e author_reviewed_by mostrano che il contenuto è stato verificato, che le prove sono accessibili e che qualcuno ne risponde. Il documento people-first di Google indica inoltre trust come l’aspetto più importante di E-E-A-T.
Controllo: sources è compilato? last_updated viene mantenuto? author_reviewed_by è identificato?
Le quattro dimensioni in una tabella operativa:
| Dimensione | Come dimostrarla con l’IA | Controllo |
|---|---|---|
| Experience | Aggiungere uso reale e casi vissuti | È presente esperienza diretta? |
| Expertise | Identificare l’autore e usare prove autorevoli | author_reviewed_by è compilato? |
| Authoritativeness | Ottenere link e riconoscimento | Altri siti raccomandano il lavoro? |
| Trustworthiness | Mostrare fonti, responsabilità e aggiornamenti | sources e last_updated sono presenti? |
Errori frequenti:

- Errore 1: E-E-A-T può essere ottimizzato come punteggio numerico
- Errore 2: E-E-A-T è un singolo fattore di ranking diretto
- Errore 3: i contenuti con IA non possono mai dimostrare E-E-A-T
- Lettura corretta: E-E-A-T è un modello di qualità; revisione umana, fonti e contributo originale permettono di dimostrarlo anche nei contenuti assistiti dall’IA
Divulgazione e trasparenza dei contenuti assistiti dall’IA
Google richiede una dichiarazione sull’IA? Non in ogni pagina. La FAQ pubblica non impone un’etichetta fissa «generato con IA» per tutti i contenuti. Raccomanda però di fornire contesto quando il lettore può ragionevolmente voler capire il metodo: come è stata usata l’automazione, da dove provengono le prove e chi ha controllato il risultato.
La trasparenza ha quattro parti:
- Informazioni sull’autore: chi ha scritto o rivisto?
- Fonti: quali documenti, dati e casi sostengono il contenuto?
- Cronologia: quando è avvenuto l’ultimo aggiornamento sostanziale?
- Uso dell’IA: in quali fasi è stata impiegata, come ricerca, struttura, bozza o revisione?
Questi elementi non richiedono un paragrafo standard all’inizio di ogni articolo. Possono comparire nei metadati, in un riquadro autore, nella barra laterale o in una pagina metodologica. Autore, elenco delle fonti e data di aggiornamento offrono già un contesto importante.
Alcuni settori giustificano una spiegazione più chiara. Medicina, finanza e diritto creano aspettative maggiori su prove e accuratezza. Occorre indicare se un professionista ha rivisto il contenuto e come è intervenuta l’IA. Un articolo fiscale può citare documentazione ufficiale IRS, revisione di uno specialista e uso dell’IA limitato a organizzazione e scrittura.
Anche le pagine programmatiche devono spiegare la logica di generazione. Un sito con molte pagine di prodotti o città può documentare fonte dei dati, processo e differenze reali. Dire che una pagina usa dati autentici e informazioni specifiche del luogo la distingue da una semplice sostituzione di variabili.
Il principio non è imporre lo stesso modello ovunque. Trasparenza significa permettere al lettore di capire prove, revisore, metodo di produzione e stato di aggiornamento.
Rischi di traduzione massiva, riscrittura e SEO programmatica
I siti traducono spesso in massa, riscrivono materiale esistente o generano pagine in modo programmatico. Nessuna operazione è una violazione per natura. La decisione dipende da primary purpose e added value.
Traduzione massiva
Uso più sicuro: tradurre contenuti di cui le persone hanno davvero bisogno, come documentazione di prodotto o tutorial tecnici. Conservare il valore originale, non riassumere troppo e localizzare terminologia, espressione e intento di ricerca, invece di pubblicare una traduzione automatica non revisionata.
Uso rischioso: pubblicare senza revisione con errori grammaticali o culturali; tradurre una pagina di basso valore in molte lingue solo per coprire parole chiave; creare versioni senza prova di domanda o controllo umano.
Domanda: il pubblico ha bisogno di questa versione? Conserva il valore dell’originale? È stata davvero localizzata?
Riscrittura e sostituzione di sinonimi
Uso più sicuro: aggiungere idee originali, esperienza pratica, nuovi dati o casi. Riorganizzare per un pubblico realmente diverso invece di cambiare soltanto le parole.
Uso rischioso: modificare poche parole di un articolo altrui per evitare il rilevamento dei duplicati; produrre quasi lo stesso testo senza valore aggiunto; riformulare pagine interne in massa solo per catturare altre parole chiave.
Domanda: quale nuovo valore aggiunge? Include un’idea o un caso originale? Si rivolge davvero a un pubblico diverso?
SEO programmatica
Uso più sicuro: usare dati reali affinché ogni prodotto o luogo abbia differenze verificabili. Ogni pagina soddisfa un intento specifico e ha un motivo per esistere separatamente.
Uso rischioso: sostituire soltanto una città, un prodotto o una parola chiave in un modello; generare molte varianti long tail senza differenze sostanziali; estrarre, combinare o tradurre altre pagine senza aggiungere valore.
Domanda: ogni pagina ha una differenza reale? Gli utenti hanno bisogno di una pagina separata? Soddisfa un intento specifico?
Confronto:
| Operazione | Confine più sicuro | Confine rischioso |
|---|---|---|
| Traduzione massiva | Domanda reale, valore conservato, buona localizzazione | Automatica non revisionata, copertura di keyword, fonte debole |
| Riscrittura | Idee proprie, altro pubblico, nuovi dati | Evitare duplicati, nessun valore, parafrasi massive |
| SEO programmatica | Dati reali, differenze utili, intento chiaro | Riempimento di modelli, long tail, pagine quasi identiche |
Il test centrale combina primary purpose e added value. Tre domande:
- Lo scopo principale è aiutare o manipolare il ranking?
- Ogni pagina aggiunge valore reale o soltanto una differenza superficiale?
- Gli utenti hanno davvero bisogno di queste pagine o la domanda è solo presunta?
Se tutte le risposte sono sostenute da prove, l’operazione ha più probabilità di essere sostenibile. Se scopo, valore o necessità non possono essere difesi, il rischio va rivalutato.

Nuovo rischio di AI Search e fan-out queries
La ricerca con IA crea un’altra tentazione. Le AI features e la ricerca generativa di Google possono scomporre una domanda in più ricerche correlate, chiamate fan-out queries. Una domanda sulle prestazioni Docker può aprire ricerche su ottimizzazione, limiti delle risorse e strumenti di monitoraggio.
Alcuni siti creano una pagina separata per ogni variante. Può sembrare una copertura accurata delle parole chiave, ma trasformarsi in scaled content abuse.
L’attuale guida Google per la ricerca generativa avverte esplicitamente di non creare molte pagine per ogni variante o fan-out query. Se l’obiettivo principale è manipolare ranking o risposte generative di Google Search, la pratica viola la policy sullo scaled content abuse.
Un approccio più sostenibile risponde alle domande correlate in una sola pagina. Una guida alle prestazioni Docker può riunire ottimizzazione, limiti delle risorse e monitoraggio, così l’utente conclude l’attività in un unico posto.
AI Search e GEO richiedono una strategia più ampia, da trattare separatamente. La regola immediata è non generare in massa pagine di basso valore solo per coprire ogni variante.
Campi di controllo qualità per una pipeline di contenuti con IA
L’ultimo passaggio trasforma i principi di Google in campi che una bacheca editoriale può imporre. Ogni campo registra un segnale di qualità e deve essere compilato prima della pubblicazione.
Definizione dei campi
| Campo | Scopo | Obbligatorio/facoltativo | Principio Google |
|---|---|---|---|
| sources | Link a tutte le prove utilizzate | Obbligatorio | Trustworthiness, Expertise |
| author_reviewed_by | Identità dell’autore o del revisore | Obbligatorio | Expertise, Accountability |
| original_increment | Valore originale aggiunto, come analisi, dati o caso | Obbligatorio | People-first, Added value |
| human_qa_status | Stato della revisione umana: bozza, in revisione, approvato | Obbligatorio | How, Trustworthiness |
| gsc_feedback | Feedback GSC su query e pagine dopo la pubblicazione | Facoltativo | Why, miglioramento continuo |
| last_updated | Data dell’ultimo aggiornamento sostanziale | Obbligatorio | Freshness, Trustworthiness |
| ai_usage | Fasi con IA: ricerca, struttura, bozza o revisione | Facoltativo | Transparency |
Controllo di pubblicazione
Prima della pubblicazione, richiedere:
- sources non è vuoto: almeno tre elementi affidabili, come documentazione ufficiale, pubblicazione autorevole o test pratico
- author_reviewed_by è compilato: una persona specifica assume la revisione
- original_increment menziona almeno un’idea, un caso o un dato originale
- human_qa_status passa da «in revisione» ad «approvato» dopo il controllo umano
- last_updated registra la data di questa revisione o modifica sostanziale
Esempio approvato:
sources: ["https://developers.google.com/search/docs/fundamentals/using-gen-ai-content",
          "https://developers.google.com/search/docs/essentials/spam-policies",
          "https://developers.google.com/search/blog/2023/02/google-search-and-ai-content"]
author_reviewed_by: "Jane Zhang (editor del blog tecnico)"
original_increment: "analisi delle policy Google + modello a tre assi + progettazione dei campi di controllo"
human_qa_status: "approvato"
last_updated: "2026-07-26"
ai_usage: "ricerca, struttura e miglioramento della bozza"
Esempio rischioso:
sources: []
author_reviewed_by: ""
original_increment: ""
human_qa_status: "bozza" → pubblicazione diretta
last_updated: ""
ai_usage: "generazione completa senza revisione"
Controlli per fase
| Fase | Campi obbligatori | Controllo |
|---|---|---|
| Ricerca | sources | Almeno tre fonti affidabili |
| Scrittura | original_increment | Almeno un’idea, un caso o un dato originale |
| Revisione | author_reviewed_by, human_qa_status | Revisore registrato e stato «approvato» |
| Dopo la pubblicazione | gsc_feedback, last_updated | Feedback GSC registrato e data legata a un cambiamento sostanziale |
Questi campi non sono requisiti diretti di Google. Sono una pratica operativa derivata dai principi people-first. I nomi possono cambiare, ma la logica resta: ogni articolo ha bisogno di fonti, un revisore responsabile, valore originale, approvazione umana e cronologia di aggiornamento mantenuta.
Conclusione
L’IA in un flusso editoriale non è la violazione. Il rischio è pubblicare contenuti di basso valore su larga scala per manipolare il ranking. Tre domande decidono: lo scopo principale è aiutare? Ogni pagina aggiunge valore reale? Gli utenti ne hanno davvero bisogno?
Prima di pubblicare in massa, controlla la bacheca. sources, author_reviewed_by e original_increment sono completi? L’articolo ha superato il controllo? Prove, una persona responsabile e contributo originale devono esistere prima della pubblicazione.
Un altro articolo approfondirà AI Search e GEO. L’obiettivo sarà rendere i contenuti comprensibili e citabili dalla ricerca con IA, non generare pagine deboli per ogni variante di query.
Creare un controllo qualità minimo per i contenuti con IA
Dalla scelta dell’argomento alla revisione dopo la pubblicazione, ogni articolo conserva prove di valore per l’utente, base fattuale e responsabilità umana.
- 1
Step 1: Definire il lettore e il confine tematico
Indica chi beneficia dell’articolo e quale problema risolve. Non entrare in un settore sconosciuto soltanto per il traffico potenziale. - 2
Step 2: Controllare le sovrapposizioni interne
Cerca i contenuti esistenti prima della ricerca e decidi se creare, aggiornare, unire o fermare, invece di produrre una pagina quasi duplicata. - 3
Step 3: Conservare le fonti primarie
Registra prove ufficiali o dirette e date di consultazione per policy, prezzi, versioni e limiti tecnici. - 4
Step 4: Definire il contributo originale
Documenta test, esperienza, analisi, dati o modello decisionale aggiunti dall’articolo. Riformulare materiale esistente non basta. - 5
Step 5: Rivedere fatti e presentazione
Controlla fatti, esempi, promesse del titolo, duplicazioni e tracce di automazione, poi aggiungi le verifiche pratiche necessarie. - 6
Step 6: Registrare la responsabilità umana
Salva revisore, fonti, uso dell’IA e note di rischio. Una persona deve approvare la pubblicazione finale. - 7
Step 7: Usare feedback reali per aggiornare
Usa query e dati di pagina di GSC per decidere modifiche sostanziali, invece di cambiare solo data o riassunto.
FAQ
Google penalizza automaticamente i contenuti generati con IA?
Google è contrario ai contenuti con IA o ai contenuti di bassa qualità su larga scala?
Che cos’è lo scaled content abuse?
Un blog tecnico assistito dall’IA può ancora fare SEO?
Traduzione massiva e SEO programmatica violano sempre le regole?
Ogni articolo assistito dall’IA deve dichiarare l’uso dell’IA?
15 min di lettura · Pubblicato il: 13 nov 2026

Guida pratica all automazione dei siti di contenuti AI
Stai leggendo il primo articolo di questa serie. Continua con il successivo o apri l’hub della serie.


Commenti
Accedi con GitHub per lasciare un commento