
Agente IA per la ricerca dei temi: idee per blog da Google, Reddit e GitHub
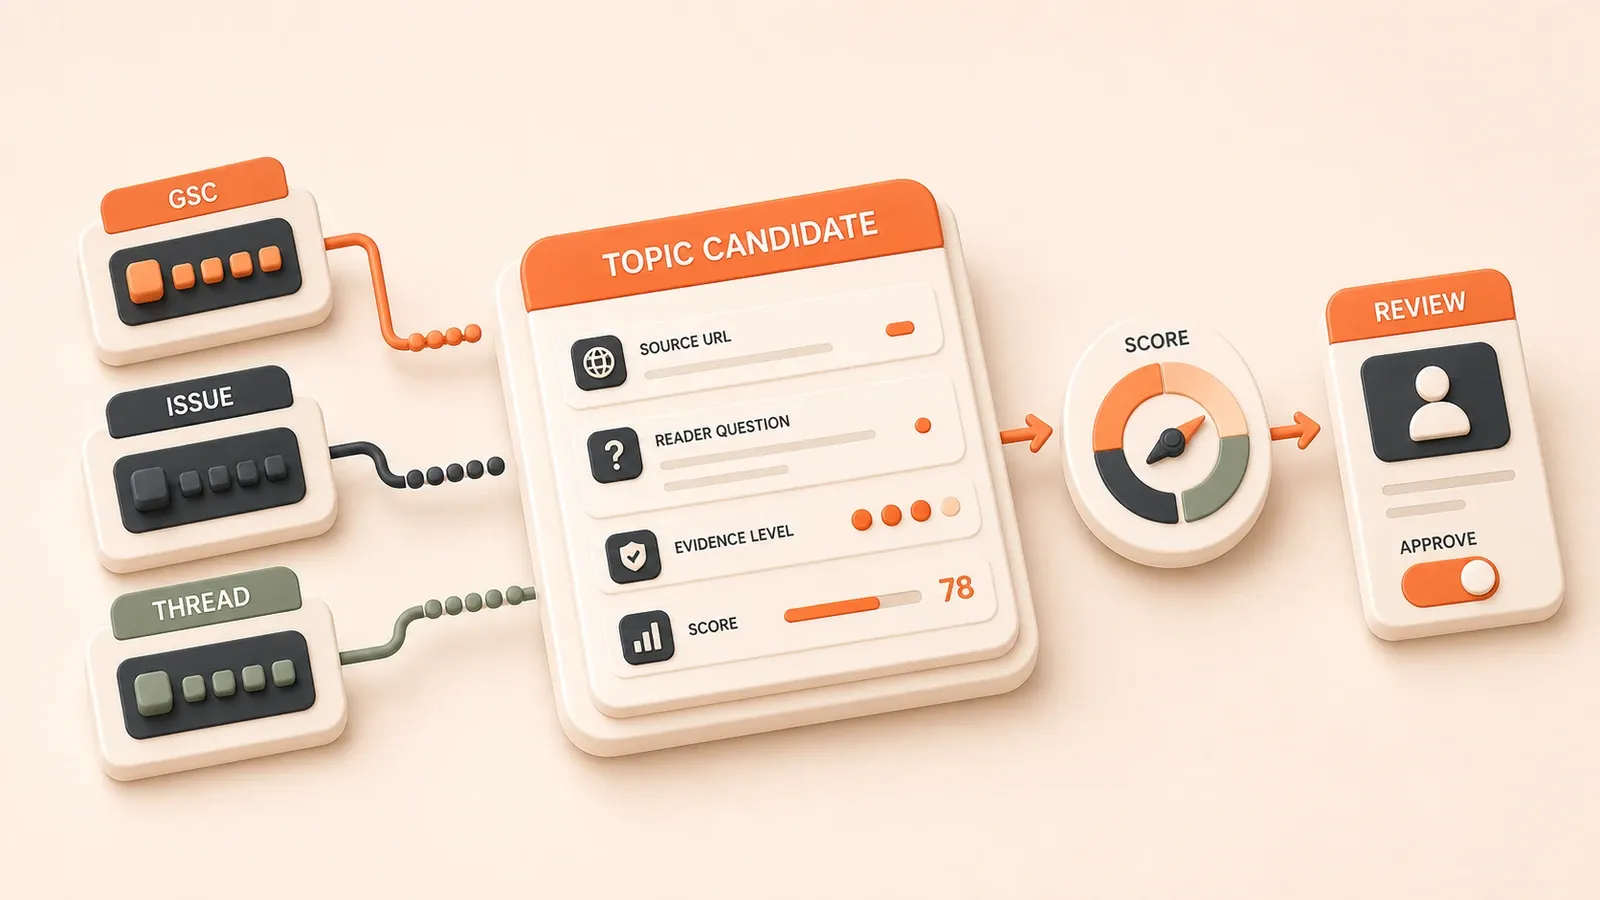
"L'API Google Search Analytics supporta dimensioni query e pagina, rowLimit da 1 a 25.000 e paginazione con startRow, ma dichiara esplicitamente di non garantire tutte le righe."
Una tabella dei temi candidati di solito parte da tre colonne: source_url conserva l’origine, reader_question registra come il lettore formula il problema ed evidence_level indica l’affidabilità della prova. Una domanda proveniente da un forum appartiene alla seconda colonna, non a fact_claim; i fatti tecnici richiedono ancora documentazione ufficiale o un errore riprodotto.
Un agente per la ricerca dei temi non è un bot che insegue le tendenze. Trasforma query reali di Google Search Console e ostacoli tecnici delle issue GitHub in schede verificabili. Gli input separati dei forum forniscono il linguaggio usato dai lettori. Punteggio, deduplicazione e filtri di rischio decidono cosa entra nel backlog. Il processo diventa ripetibile e revisionabile, anziché dipendere dall’ispirazione.
Progettare il livello di input dell’agente
Dati proprietari Google: rapporto sul rendimento e limiti dell’API
Il primo livello di input dovrebbe provenire dai dati di ricerca del sito, non da un punteggio di tendenza di terze parti. Il rapporto sul rendimento di Google Search Console presenta quattro metriche principali e sei dimensioni.
Dimensioni del rapporto sul rendimento
| Tipo di dimensione | Campo | Scopo |
|---|---|---|
| Query | queries | Mostra ciò che i lettori digitano e rivela candidati con molte impressioni e pochi clic |
| Pagina | pages | Mostra quali pagine ricevono già traffico e impedisce coperture duplicate |
| Paese o area geografica | countries | Registra differenze regionali quando un tema riguarda solo alcuni mercati |
| Dispositivo | devices | Separa comportamento mobile e desktop, che può cambiare formato e profondità |
| Aspetto nella ricerca | search appearance | Individua tipi di risultati avanzati e possibili lacune nei dati strutturati |
| Data | dates | Definisce finestre di campionamento e confronto |
Le quattro metriche sono clicks, impressions, CTR e average position. impressions è particolarmente utile per trovare temi: se una query ottiene impressioni ma nessun clic, i lettori cercano qualcosa che il sito potrebbe non spiegare abbastanza chiaramente.
Progettazione delle query e limiti dell’API Search Console
L’accesso programmatico usa il metodo searchAnalytics.query. Secondo la documentazione Google consultata a luglio 2026, il metodo richiede autorizzazione OAuth, accetta rowLimit da 1 a 25.000 e supporta dimensions, come query o pagina, filters, come paese o dispositivo, e aggregationType.
Contano due vincoli. Primo, l’API non garantisce tutte le righe: i limiti interni di Search Console favoriscono quelle principali. Secondo, le richieste per dati recenti possono includere metadati che indicano date o ore ancora in elaborazione. L’agente deve paginare, usare una cache e conservare un indicatore di dati incompleti, invece di trattare l’esportazione come esaustiva.
Avviso di migrazione per Custom Search JSON API
Google Custom Search JSON API era un modo comune per eseguire ricerche web via programma, ma la pagina ufficiale ora indica che è chiusa ai nuovi clienti e che quelli esistenti devono migrare entro il 1° gennaio 2027. Un nuovo sistema dovrebbe usare un prodotto di ricerca supportato o un gateway generale senza dipendere da questa API.
Se un progetto esistente usa ancora Custom Search JSON API, pianifica presto la migrazione e mantieni sostituibile il provider nella configurazione.
Input GitHub: limiti della Search API e modelli di query per issue
GitHub è una fonte efficace di idee tecniche. I titoli delle issue descrivono spesso un errore reale o un vincolo del prodotto, mentre note di rilascio e discussioni rivelano cambi di versione e richieste di pratiche migliori. Anche la GitHub Search API ha limiti precisi.
Limiti della GitHub Search API e rate limit
| Tipo | Rate limit | Note |
|---|---|---|
| ricerca autenticata, escluso il codice | 30 richieste/min | Richiede un token ed è adatta alla raccolta continua |
| ricerca non autenticata | 10 richieste/min | Accesso pubblico adatto solo a test poco frequenti |
| ricerca nel codice | 10 richieste/min | Richiede autenticazione per query sul codice sorgente |
Ogni ricerca fornisce al massimo 1.000 risultati e la paginazione non può esporne altri. Una query può anche scadere; la risposta JSON imposta quindi incomplete_results: true, indicando che l’insieme restituito potrebbe essere incompleto.
Modelli di query per issue e formati degli articoli
La ricerca GitHub supporta qualificatori combinabili:

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
I qualificatori comuni includono is:issue e is:pr per il tipo di risorsa, in:title, in:body e in:comments per i campi, repo:, user: e org: per l’ambito, oltre a state:, label: e reason:.
Schemi diversi suggeriscono formati diversi:
| Schema della query | Tipo di articolo candidato | Esempio di direzione del titolo |
|---|---|---|
| bug + in:title + parola di errore | Risoluzione dei problemi | ”Errori comuni dopo un aggiornamento” |
| enhancement + in:title | Confronto o migrazione | ”Nuova funzione e vecchio approccio a confronto” |
| discussion + in:body + “best practice” | Buone pratiche | ”Approcci pratici da un forum di maintainer” |
| closed + reason:“completed” | Analisi del rilascio | ”Novità della v2.0: issue verificati e note di migrazione” |
Alternative per rate limit e incomplete_results
Dopo ogni chiamata API, leggi prima gli header x-ratelimit-*. Chiama GET /rate_limit quando serve un riepilogo dei gruppi di risorse. Se superi un limite, attendi fino a retry-after o x-ratelimit-reset; se gli errori continuano, usa il backoff esponenziale e infine interrompi i tentativi.
Quando compare incomplete_results: true, marca la scheda con “i dati potrebbero essere incompleti; serve un controllo manuale”, invece di trattare il risultato come esaustivo. Stelle e numero di risposte possono essere segnali di supporto, ma nessuno dei due deve diventare l’unico criterio di classifica.
Input Reddit: allowlist in sola lettura e rischi di accesso
I post dei forum possono fornire formulazioni realistiche e parole relative ai problemi, ma la policy API e i controlli antiabuso di Reddit possono cambiare, quindi il recupero è meno affidabile. Usa questi segnali solo per intento e FAQ candidate; le affermazioni tecniche richiedono documentazione ufficiale o errori riprodotti.
Allowlist degli endpoint in sola lettura
La ricerca BetterLink consente soltanto recupero e ricerca, senza operazioni di scrittura:
Endpoint consentiti in sola lettura:
listing: recuperare elenchi di postcomments: recuperare i commenti di un postinfo: recuperare i metadati di un post o utentesearch: cercare post
Endpoint di scrittura vietati:
comment: pubblicare un commentosubmit: pubblicare un postvote: votaresaveehide: salvare o nascondere un post
Se l’agente accede all’API Reddit, codifica l’allowlist in modo che il flusso non possa attivare per errore un endpoint di scrittura.
Rischi di accesso e alternative
L’accesso a Reddit può fallire per tre motivi comuni: autorizzazione non riuscita a causa di un token scaduto o insufficiente, blocco antiabuso temporaneo dopo traffico eccessivo o modifica della policy della Developer Platform che disabilita un endpoint.
Usa questa sequenza:
- Tentare la richiesta API Reddit → registrare l’errore se fallisce
- Ripiegare sui risultati accessibili della ricerca di domande della community
- Estrarre formulazioni e termini dei problemi → creare FAQ candidate
- Continuare punteggio e deduplicazione senza fermare il flusso
Anche se il recupero da Reddit fallisce, l’agente può continuare con GSC e GitHub; perde solo parte dei segnali relativi a linguaggio e problemi.
Posizionare i dati come domande, non come prova
Tre colonne rendono esplicito il ruolo di Reddit:
| Colonna | Scopo | Contenuto Reddit consentito |
|---|---|---|
source_url | Fonte originale | Consentito |
reader_question | Domanda normalizzata del lettore | Consentito e uso principale |
evidence_level | Affidabilità della prova | Non compilare fact_claim; registrare solo come reader_signal |
Per esempio, il post “How to fix X error after upgrading to v2?” diventa una scheda con reader_question: "Come risolvo l'errore dopo l'aggiornamento alla v2?" ed evidence_level: "community". Il punteggio attribuisce meno peso alla prova e l’interfaccia di revisione richiede documentazione ufficiale o un caso riprodotto.
Questa separazione evita affermazioni non supportate come “molte persone lo chiedono su Reddit”. Reddit fornisce il linguaggio dell’intento di ricerca, non la prova di un fatto tecnico.
Estrarre e classificare i temi candidati
Il compito centrale dell’agente è normalizzare tre fonti — GSC, GitHub e Reddit — in schede, quindi sottoporle a punteggio, deduplicazione e filtri di rischio. Il flusso ha cinque passaggi.
Flusso in cinque passaggi
Passaggio 1: dati proprietari Google
- Interrogare l’API Search Console per le
queriesdegli ultimi 30–90 giorni - Individuare query con molte impressioni e pochi clic, usando una soglia di esempio come impressioni > 100 e CTR < 2%
- Trovare pagine che ricevono traffico ma non hanno una sezione FAQ
- Produrre una tabella GSC con
query,impressions,CTRedexisting_page
Passaggio 2: classificazione delle issue GitHub
- Cercare issue in gruppi per repository o organizzazione con i modelli precedenti
- Classificare
label:bugcome risoluzione dei problemi,label:enhancementcome confronto e le discussioni come buone pratiche - Estrarre termini di errore, numeri di versione e nomi di funzioni dai titoli
- Produrre una tabella GitHub con
issue_url,suggested_typeekeywords
Passaggio 3: estrazione dei problemi da Reddit e HN
- Cercare subreddit selezionati o HN ed estrarre formulazioni ricorrenti
- Normalizzare schemi come “Come risolvere X”, “Perché succede X” e “Il modo migliore per fare X”
- Usare i post per formulare domande, non per dimostrare fatti tecnici
- Produrre una tabella con
source_url,reader_questionedevidence_level: community
Passaggio 4: deduplicazione e ricerca interna
- Cercare nel sito con le parole chiave di ogni candidato
- Verificare se una query GSC ha già una pagina che copre l’intento
- Calcolare la somiglianza dei titoli per non trasformare “errori dopo un aggiornamento” e “gestione degli errori di aggiornamento” in due duplicati
- Produrre schede deduplicate con
duplicate_check_result
Passaggio 5: revisione umana
- Prima di ammettere una scheda, controllare:
- Se i punteggi di opportunità, coerenza con il sito, valore aggiunto e verificabilità sono sensati
- Se direzione del titolo e parole chiave sono accurate
- Se l’azione corretta è un nuovo articolo o l’aggiornamento della FAQ di un articolo esistente
- Inviare le schede approvate al backlog dei contenuti
Non è un flusso totalmente autonomo. L’agente automatizza la raccolta e produce un output strutturato, ma una persona prende la decisione editoriale finale.
Valutare opportunità, coerenza, valore aggiunto e verificabilità
Un tema non merita la pubblicazione soltanto perché è popolare. L’agente deve valutare se l’idea è coerente con il sito, aggiunge qualcosa di non ancora coperto e può essere sostenuta da fonti verificabili.
Dimensioni del punteggio
| Dimensione | Peso | Segnali di valutazione | Fonte dati |
|---|---|---|---|
| Opportunità di ricerca | w1, per esempio 0,3 | Impressioni GSC, volume della query, copertura dei concorrenti | Search Console, strumenti SEO di terze parti |
| Coerenza con il sito | w2, per esempio 0,25 | Ambito del sito, serie, allineamento dei tag | Configurazione, elenco serie, libreria tag |
| Valore aggiunto | w3, per esempio 0,25 | Articoli interni simili e qualità della copertura SERP esistente | Ricerca interna, analisi dei concorrenti |
| Verificabilità | w4, per esempio 0,2 | Documenti ufficiali, issue, rilasci e test riproducibili | Metadati della fonte, evidence_level |
Formula: total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
Assegna a ogni dimensione un valore da 0 a 1, mantenendo total_score nello stesso intervallo. Una soglia di esempio di 0,6 può segnare i candidati inferiori come “in attesa di revisione” anziché ammetterli automaticamente.
Esempio: “Risolvere gli errori dopo un aggiornamento”
Supponiamo che il candidato provenga da is:issue state:open label:bug in:title error after upgrading to v2. Il sito tratta DevOps e container e il tema normalizzato è “Errori comuni dopo un aggiornamento”.
| Dimensione | Punteggio | Motivazione |
|---|---|---|
| Opportunità di ricerca | 0,7 | GSC contiene una query correlata con impressioni moderate; gli articoli concorrenti sono frammentari |
| Coerenza con il sito | 0,8 | Il sito ha una serie sugli aggiornamenti dei container e un tag DevOps; il candidato colma una lacuna |
| Valore aggiunto | 0,6 | Un articolo esistente sulle note di aggiornamento non tratta gli errori; il team può ampliarlo o creare un articolo figlio |
| Verificabilità | 0,9 | Una issue e una nota di rilascio ufficiale descrivono la modifica incompatibile e l’errore è riproducibile |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
Poiché 0,74 > 0,6, il candidato entra nella revisione umana. Il revisore vede anche una raccomandazione: aggiornare prima l’articolo esistente o creare un articolo figlio mirato se l’ambito lo giustifica.
Questo modello evita due errori comuni: inseguire domanda non coerente con il sito e pubblicare contenuti duplicati che non aggiungono prove o esperienza significative.
Applicare deduplicazione, livelli di prova e controlli di rischio
Prima di entrare nel backlog, il candidato deve superare tre controlli: deduplicazione interna, classificazione dell’affidabilità della fonte e verifica del rischio di qualità Google. Insieme espongono duplicati, prove deboli e rischi dei contenuti su larga scala.
Checklist dei tre controlli
Controllo 1: deduplicazione interna
- Verificare se una query GSC ha già una pagina dedicata
- Cercare titoli simili nel sito
- Confrontare la somiglianza per non considerare “risoluzione dell’errore di aggiornamento” e “gestione degli errori dopo un aggiornamento” come idee separate
- Scrivere
unique,similar_to_existingoduplicateinduplicate_check_result
Controllo 2: affidabilità della prova

- Impostare
evidence_level:high: guida o documentazione ufficiale, issue con risposta ufficiale o dati di test direttimedium: post della community o pubblicazione indipendente senza conferma del maintainerlow: fonte sconosciuta, nessun link o inferenza non supportata
- Richiedere
evidence_levelin ogni scheda
Controllo 3: rischio di qualità Google
- Controllare se il candidato incoraggia contenuti di scarso valore su larga scala:
- È lo stesso articolo con un parametro sostituito, come due configurazioni quasi identiche per Cloudflare Workers e Cloudflare Pages?
- Aggiunge un nuovo punto di vista, un test riproducibile o un giudizio operativo rispetto alla copertura esistente?
- Il piano di verifica tiene separate le domande Reddit dalle prove ufficiali o dai risultati dei test?
- Scrivere
safe,batch_risk,no_value_addedofact_check_neededinrisk_flag
Riferimento dei livelli di prova
| evidence_level | Tipo di fonte | Esempio | Azione successiva |
|---|---|---|---|
| high | ufficiale/guida/documenti | Guida di Google Search Console o issue con risposta del maintainer | Può sostenere un’affermazione se si conserva l’URL |
| medium | community/blog | Discussione di un forum, post indipendente o blog tecnico | Usare per il linguaggio dei lettori; aggiungere una fonte primaria |
| low | sconosciuta | Nessun URL, pura inferenza o dati inventati | Rifiutare o spostare nella coda che richiede ricerca |
Ogni scheda deve avere evidence_level, così i revisori vedono subito quali idee richiedono fonti più forti. Una issue GitHub con risposta del maintainer può essere high; una discussione tra soli utenti resta medium.
Questi controlli assegnano stati visibili invece di eliminare in silenzio ogni candidato rischioso. Una scheda segnalata può arrivare alla coda di revisione, ma la persona vede il problema prima di decidere.
Archiviare le schede e ammetterle nel backlog
L’output finale dell’agente è una scheda, non un articolo. Dopo l’approvazione umana, la scheda diventa un record del backlog per gli agenti successivi di clustering delle parole chiave e scrittura.
Campi della scheda
| Campo | Tipo | Descrizione | Esempio |
|---|---|---|---|
source_url | string | Fonte originale | https://github.com/user/repo/issues/123 |
reader_question | string | Domanda normalizzata del lettore | ”Come risolvo gli errori dopo l’aggiornamento alla v2?” |
evidence_level | enum | Affidabilità della fonte | high / medium / low |
search_value_score | number | Opportunità di ricerca da 0 a 1 | 0,7 |
site_match_score | number | Coerenza con il sito da 0 a 1 | 0,8 |
value_score | number | Valore aggiunto da 0 a 1 | 0,6 |
verify_score | number | Verificabilità da 0 a 1 | 0,9 |
total_score | number | Totale ponderato da 0 a 1 | 0,74 |
suggested_type | enum | Formato consigliato | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | Serie consigliata | cloudflare-bindui, se il sito ha quella serie |
duplicate_check_result | enum | Risultato della sovrapposizione | unique / similar_to_existing / duplicate |
risk_flag | enum | Indicatore di rischio | safe / batch_risk / no_value_added / fact_check_needed |
Le schede possono essere archiviate come JSON o record di database. I revisori vedono tutti i campi invece di decidere soltanto in base a titolo e popolarità.
Campi del backlog
Un candidato approvato diventa un record con:
- Titolo, finalizzato durante la revisione umana
- Parole chiave primarie e secondarie
- Stato:
to_write,writing,reviewopublished - Il
total_scoredel candidato - Locale, come zh o en, in base alla configurazione del sito
- Serie, quando
suggested_seriesè valida - Data di pubblicazione pianificata e priorità
Il prossimo articolo può definire lo schema completo e l’API del backlog. Questo flusso copre solo il modo in cui una scheda ottiene l’ammissione.
Flusso di revisione umana
Prima dell’ammissione, una persona controlla:
- Revisione del punteggio:
total_scoreè sensato e una dimensione bassa comeverify_score = 0.2richiede più prove? - Revisione di titolo e parole chiave:
reader_questiondescrive correttamente il problema e le parole chiave vanno cambiate? - Seconda ricerca interna: la deduplicazione automatica ha ignorato un articolo simile?
- Decisione di ammissione: approvare, rifiutare o chiedere altre prove, registrando il motivo
Il flusso è estrazione dell’agente → punteggio e filtri strutturati → revisione umana → ammissione. L’automazione organizza segnali dispersi in schede confrontabili, mentre la responsabilità editoriale resta umana.
Passaggi successivi e letture correlate
Dopo punteggio e revisione, le fasi abituali sono clustering delle parole chiave, gestione del backlog e pianificazione della scrittura. Questi articoli offrono un contesto utile:
- Agente di ricerca IA: dalla ricerca multipiattaforma al rapporto delle prove
- Procedura settimanale GA/GSC per pagine con molte impressioni e pochi clic
- Tecniche avanzate di Google Search Console
- Pianificazione trimestrale dei temi per blog tecnici
Un agente per la ricerca dei temi è soltanto la prima fase dell’automazione di un sito di contenuti. Trasforma segnali di più fonti in candidati revisionabili; clustering, gestione dei compiti, verifica della scrittura e aggiornamento dei contenuti restano responsabilità successive separate.
Creare un agente IA minimo per la ricerca dei temi
Normalizza i segnali di più fonti in schede, assegna punteggi e deduplica, quindi scrivi nel backlog solo gli elementi approvati da una persona.
- 1
Step 1: Caricare l'inventario dei contenuti
Leggi articoli esistenti, piani delle serie e tag per creare la base della deduplicazione e del punteggio di coerenza con il sito. - 2
Step 2: Recuperare i dati GSC
Recupera clic, impressioni, CTR e posizione media per query e pagina, poi segnala domanda esistente e lacune di copertura. - 3
Step 3: Aggiungere il contesto esterno
Usa la ricerca generale per domande SERP e fonti primarie, salvando query, orario, URL e stato del recupero. - 4
Step 4: Raccogliere segnali di community e issue in sola lettura
Estrai le formulazioni delle domande da Reddit e gli ostacoli relativi a errori, versioni o funzioni dalle issue GitHub, senza operazioni di scrittura. - 5
Step 5: Normalizzare e valutare i candidati
Crea le schede e valuta opportunità di ricerca, coerenza con il sito, valore aggiunto e verificabilità. - 6
Step 6: Deduplicare e filtrare i rischi
Normalizza entità e intento, poi controlla sovrapposizioni interne, livelli di prova, rischio di contenuti su larga scala e fatti variabili. - 7
Step 7: Revisionare e ammettere i candidati
Una persona revisiona le schede meglio classificate, inserisce nel backlog solo quelle approvate e registra se creare, aggiornare, ampliare, unire o scartare.
FAQ
L'agente deve estrarre i risultati Google o usare i dati di Search Console?
Un post popolare su Reddit può diventare direttamente un tema?
Quali temi tecnici possono rivelare le issue GitHub?
Come si distingue la domanda reale da un reclamo isolato?
Il flusso deve fermarsi se GitHub Search o l'accesso a Reddit falliscono?
Google Custom Search JSON API è adatta a un nuovo progetto?
Cosa deve controllare una persona prima che il candidato entri nel backlog?
14 min di lettura · Pubblicato il: 13 nov 2026

Guida pratica all automazione dei siti di contenuti AI
Se arrivi dalla ricerca, il modo più veloce per orientarti è passare all’articolo precedente o successivo della stessa serie.
Precedente
I contenuti con IA funzionano ancora per la SEO? Regole Google
Google chiarisce quando i contenuti con IA sono accettabili, quando pubblicare su larga scala diventa spam e quali controlli umani riducono il rischio.
Parte 1 di 4
Successivo
Clustering delle keyword con IA: dalle query alle serie e ai link interni
Unisci query GSC, idee e articoli; raggruppa per intento, valida con SERP e revisione umana, quindi assegna ogni cluster a pagina, aggiornamento, FAQ o link.
Parte 3 di 4


Commenti
Accedi con GitHub per lasciare un commento