
Agent IA de recherche de sujets : trouver des idées de blogs avec Google, Reddit et GitHub
"L’API Google Search Analytics prend en charge les dimensions query et page, un rowLimit de 1 à 25 000 et la pagination startRow, tout en précisant qu’elle ne garantit pas toutes les lignes de données."
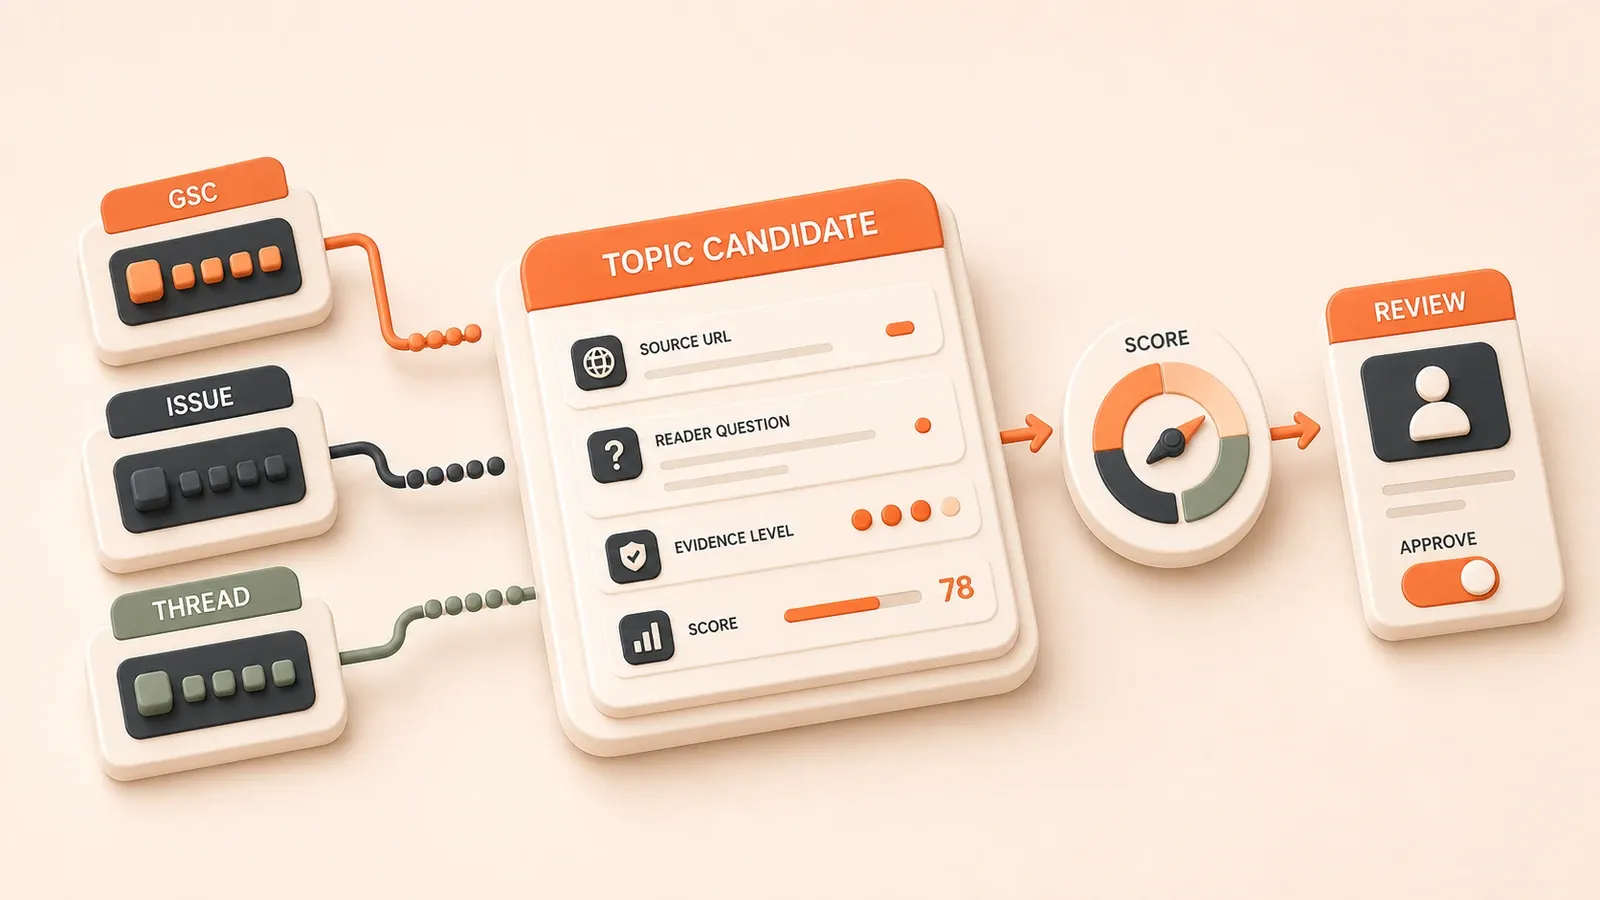
Une table de sujets candidats commence généralement par trois colonnes : source_url conserve l’origine, reader_question reformule le besoin du lecteur et evidence_level indique la solidité de la preuve. Une formulation issue d’un forum va dans la deuxième colonne, pas dans fact_claim ; les faits techniques nécessitent toujours une documentation officielle ou une erreur reproduite.
Un agent de recherche de sujets ne poursuit pas les tendances. Il transforme les requêtes réelles de Google Search Console, les blocages techniques issus des issues GitHub et les formulations de problèmes relevées sur Reddit ou HN en fiches candidates auditables. La notation, la déduplication et les filtres de risque décident de ce qui atteint le backlog. Le processus devient reproductible et vérifiable.
Concevoir les couches d’entrée de l’agent
Données Google propriétaires : Performance report et limites de l’API
La première couche doit venir des données de recherche du site, plutôt que d’un indice de tendance tiers. Le Performance report de Google Search Console expose quatre métriques principales et six dimensions.
Dimensions du Performance report
| Dimension | Champ | Utilité |
|---|---|---|
| Requête | queries | Montre les termes réellement saisis et repère les candidats à fortes impressions et faibles clics |
| Page | pages | Indique les pages qui reçoivent déjà du trafic et évite les doublons |
| Pays ou région | countries | Révèle les différences géographiques pour les sujets propres à certains marchés |
| Appareil | devices | Sépare mobile et desktop, ce qui influence le format et la profondeur |
| Apparence dans la recherche | search appearance | Identifie les résultats enrichis et les lacunes possibles de données structurées |
| Date | dates | Définit les fenêtres d’échantillonnage et de comparaison |
Les quatre métriques sont clicks, impressions, CTR et average position. impressions est particulièrement utile pour choisir un sujet : lorsqu’une query reçoit des impressions sans clic, un besoin existe mais le site n’y répond peut-être pas encore assez clairement.
Conception des requêtes et limites de Search Console API
L’accès programmatique utilise searchAnalytics.query. D’après la documentation Google de juillet 2026, la méthode exige OAuth, accepte un rowLimit de 1 à 25 000 et prend en charge des dimensions comme query ou page, des filters comme country ou device et aggregationType.
Deux limites comptent. Premièrement, l’API ne garantit pas chaque ligne ; les limites internes de Search Console privilégient les premières lignes. Deuxièmement, une demande de données récentes peut renvoyer des métadonnées indiquant des jours ou des heures encore en traitement. L’agent doit paginer, mettre en cache et conserver un indicateur de données incomplètes au lieu de traiter l’export comme exhaustif.
Avertissement de migration pour Custom Search JSON API
Google Custom Search JSON API a longtemps servi à effectuer des recherches web par programme. Sa page officielle indique désormais qu’elle est fermée aux nouveaux clients et que les clients existants doivent migrer avant le 1er janvier 2027. Un nouveau système doit s’appuyer sur un produit de recherche pris en charge ou sur une passerelle de recherche générale.
Si un projet existant utilise encore cette API, il faut préparer tôt la migration et rendre le fournisseur interchangeable dans la configuration.
Entrée GitHub : limites de Search API et modèles d’issues
GitHub constitue une bonne source de sujets techniques. Les titres d’issues décrivent souvent une erreur réelle ou un blocage fonctionnel ; les release notes et discussions révèlent les changements de version et les besoins en bonnes pratiques. GitHub Search API impose toutefois des limites strictes.
Limites et quotas de GitHub Search API
| Type | Limite | Remarque |
|---|---|---|
| recherche authentifiée hors code | 30 requests/min | Nécessite un token et convient à une collecte régulière |
| recherche non authentifiée | 10 requests/min | Réservée aux tests peu fréquents sur des données publiques |
| code search | 10 requests/min | Exige une authentification pour le code source |
Chaque recherche fournit au maximum 1 000 résultats ; la pagination ne permet pas d’aller au-delà. Une requête complexe peut aussi expirer. La réponse JSON contient alors incomplete_results: true, ce qui signale un ensemble potentiellement incomplet.
Modèles de requêtes d’issues et types d’articles
GitHub Search accepte des qualificateurs combinables :

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
is:issue et is:pr séparent les types, in:title, in:body et in:comments limitent les champs, tandis que repo:, user: et org: définissent la portée. On ajoute ensuite state:, label: et reason:.
Les modèles suggèrent différents formats :
| Modèle | Type d’article candidat | Direction de titre |
|---|---|---|
| bug + in:title + terme d’erreur | Dépannage | « Erreurs fréquentes après une mise à niveau » |
| enhancement + in:title | Comparaison ou migration | « Nouvelle fonction ou ancienne méthode : comparaison pratique » |
| discussion + in:body + “best practice” | Bonnes pratiques | « Méthodes pratiques issues d’un forum de mainteneurs » |
| closed + reason:“completed” | Analyse de version | « Nouveautés de la v2.0 : issues vérifiées et points de migration » |
Repli face aux limites et à incomplete_results
Après chaque appel, lisez d’abord les en-têtes x-ratelimit-*. Appelez GET /rate_limit lorsqu’une vue des différents budgets est nécessaire. En cas de limite, attendez retry-after ou x-ratelimit-reset ; si les échecs persistent, appliquez un backoff exponentiel puis arrêtez.
Avec incomplete_results: true, marquez la fiche « données potentiellement incomplètes, complément manuel requis ». Les résultats ne sont pas exhaustifs. Les étoiles et le nombre de réponses restent des signaux secondaires, jamais l’unique facteur de classement.
Entrée Reddit : liste blanche en lecture seule et risques d’accès
Les publications communautaires fournissent des formulations naturelles et des termes de difficulté. Les règles et protections de Reddit API peuvent toutefois changer, ce qui rend la récupération moins fiable. Ces signaux servent uniquement à l’intention et aux FAQ candidates ; les affirmations techniques demandent une documentation officielle ou une erreur reproduite.
Liste blanche des endpoints en lecture seule
La recherche BetterLink autorise la lecture et la recherche, sans écriture :
Endpoints autorisés en lecture seule :
listing: récupérer une liste de postscomments: récupérer les commentaires d’un postinfo: récupérer les métadonnées d’un post ou d’un utilisateursearch: rechercher des posts
Endpoints d’écriture interdits :
comment: publier un commentairesubmit: publier un postvote: votersaveethide: enregistrer ou masquer un post
Lorsque l’agent utilise Reddit API, la liste blanche doit être codée en dur afin qu’aucun workflow ne déclenche accidentellement une écriture.
Risques d’accès et solutions de repli
Les échecs les plus fréquents sont une autorisation expirée ou insuffisante, un blocage temporaire après un débit excessif et un changement de la Developer Platform qui retire un endpoint.
La chaîne de repli est la suivante :
- Appeler Reddit API → consigner l’erreur en cas d’échec
- Passer à des résultats accessibles sur les problèmes communautaires
- Extraire les formulations et les difficultés → créer des FAQ candidates
- Continuer la notation et la déduplication sans arrêter tout le workflow
Même sans Reddit, l’agent peut encore exploiter GSC et GitHub. Seule une partie du signal de formulation et de difficulté disparaît.
Positionner les données comme formulation, pas comme preuve
Les trois colonnes de la table rendent le rôle explicite :
| Colonne | Utilité | Données Reddit autorisées |
|---|---|---|
source_url | Source originale | autorisées |
reader_question | Formulation normalisée du lecteur | autorisée, usage principal |
evidence_level | Confiance dans la preuve | ne doit pas remplir fact_claim, uniquement reader_signal |
Par exemple, « How to fix X error after upgrading to v2? » devient une fiche avec reader_question: "Comment corriger l’erreur après le passage à la v2 ?" et evidence_level: "community". La preuve reçoit moins de poids et l’interface exige une documentation officielle ou une reproduction.
Cette séparation évite des affirmations non étayées comme « beaucoup de personnes sur Reddit rencontrent ce problème ». La communauté fournit le vocabulaire de l’intention de recherche, pas la preuve d’un fait technique.
Extraire et classer les sujets candidats
La tâche centrale consiste à normaliser les trois entrées — GSC, GitHub et Reddit — en fiches candidates, puis à appliquer notation, déduplication et filtres de risque. Le workflow comporte cinq étapes.
Workflow en cinq étapes
Étape 1 : données Google propriétaires

- Interroger Search Console API pour obtenir les
queriesdes 30 à 90 derniers jours - Repérer les requêtes à fortes impressions et faible CTR, avec un seuil d’exemple comme impressions > 100 et CTR < 2%
- Identifier les pages qui ont du trafic mais pas de FAQ suffisante
- Sortie : table GSC avec
query,impressions,CTRetexisting_page
Étape 2 : classification des issues GitHub
- Rechercher les issues par dépôt ou organisation avec les modèles précédents
- Classer
label:bugen dépannage,label:enhancementen comparaison et les discussions en bonnes pratiques - Extraire les termes d’erreur, numéros de version et noms de fonction des titres
- Sortie : table GitHub avec
issue_url,suggested_typeetkeywords
Étape 3 : extraction des difficultés Reddit/HN
- Rechercher dans les subreddits choisis ou sur HN et extraire les formulations récurrentes
- Normaliser les modèles « How to fix X », « Why does X happen » et « Best way to do X »
- Utiliser les posts pour formuler l’intention, pas pour prouver un fait technique
- Sortie : table avec
source_url,reader_questionetevidence_level: community
Étape 4 : déduplication et recherche interne
- Rechercher sur le site avec les mots-clés de chaque candidat
- Vérifier si une page couvre déjà l’intention d’une query GSC
- Calculer la similarité des titres afin que « erreurs après mise à niveau » et « gestion des erreurs de mise à niveau » ne deviennent pas deux sujets
- Sortie : fiches dédupliquées avec
duplicate_check_result
Étape 5 : validation humaine
- Avant l’admission, vérifier :
- Les scores de potentiel, adéquation, valeur et vérifiabilité sont-ils plausibles ?
- La direction du titre et les mots-clés sont-ils corrects ?
- Faut-il un nouvel article ou une FAQ dans un article existant ?
- Sortie : fiches approuvées dans le backlog de contenu
Le workflow n’est pas entièrement autonome. L’agent automatise la collecte et la structure ; une personne conserve la décision éditoriale finale.
Noter le potentiel, l’adéquation, la valeur et la vérifiabilité
La popularité ne suffit pas à justifier une publication. L’agent évalue si le sujet correspond au site, ajoute une valeur absente des contenus existants et dispose de sources vérifiables.
Dimensions de notation
| Dimension | Poids | Signaux | Source |
|---|---|---|---|
| Potentiel de recherche | w1, par exemple 0,3 | GSC impressions, query volume, couverture concurrente | Search Console, outils SEO tiers |
| Adéquation au site | w2, par exemple 0,25 | périmètre du site, série, correspondance des tags | configuration, liste de séries, bibliothèque de tags |
| Valeur ajoutée | w3, par exemple 0,25 | articles internes similaires et qualité des résultats existants | recherche interne, étude concurrente |
| Vérifiabilité | w4, par exemple 0,2 | docs officielles, issues, releases et tests reproductibles | métadonnées de source, evidence_level |
Formule : total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
Chaque dimension va de 0 à 1, donc total_score reste dans cet intervalle. Un seuil d’exemple à 0,6 peut placer les candidats faibles « en attente de revue » au lieu de les admettre automatiquement.
Exemple : « corriger les erreurs après une mise à niveau »
Supposons que le candidat vienne de is:issue state:open label:bug in:title error after upgrading to v2. Le site traite DevOps et les conteneurs, et le sujet normalisé est « erreurs fréquentes après une mise à niveau ».
| Dimension | Score | Justification |
|---|---|---|
| Potentiel de recherche | 0,7 | GSC contient une query proche avec des impressions moyennes ; les articles concurrents sont fragmentaires |
| Adéquation au site | 0,8 | Le site possède une série sur les mises à niveau de conteneurs et un tag DevOps ; le sujet comble une lacune |
| Valeur ajoutée | 0,6 | Un article « précautions de mise à niveau » existe sans dépannage ; on peut le compléter ou créer un article enfant |
| Vérifiabilité | 0,9 | Une issue GitHub et une release note officielle décrivent le changement incompatible, et l’erreur est reproductible |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
Comme 0,74 > 0,6, le candidat passe en revue humaine. Une recommandation accompagne la fiche : compléter d’abord l’article existant ou créer un article enfant si le périmètre est autonome.
Ce cadre évite de poursuivre une demande hors sujet et de publier un doublon sans preuve ni expérience supplémentaire.
Appliquer les contrôles de doublon, de preuve et de risque
Avant l’admission, chaque candidat passe trois contrôles : déduplication interne, classification de la fiabilité des sources et risque qualité Google. Ils rendent visibles les doublons, les preuves faibles et le risque de contenu industrialisé.
Liste des trois contrôles
Contrôle 1 : déduplication interne
- Vérifier si une query GSC possède déjà une page dédiée
- Rechercher des titres similaires sur le site
- Comparer la similarité pour ne pas séparer « dépannage d’erreurs de mise à niveau » et « gestion des erreurs après une mise à niveau »
- Écrire
unique,similar_to_existingouduplicatedansduplicate_check_result
Contrôle 2 : niveau de preuve
- Définir
evidence_level:high: aide ou docs officielles, issue avec réponse officielle ou données de test directesmedium: post communautaire ou publication indépendante sans confirmation d’un mainteneurlow: source inconnue, absence de lien ou déduction non étayée
- Rendre
evidence_levelobligatoire sur chaque fiche
Contrôle 3 : risque qualité Google
- Vérifier si le candidat encourage un contenu à grande échelle et de faible valeur :
- S’agit-il du même article avec un paramètre différent, comme deux procédures presque identiques pour Cloudflare Workers et Cloudflare Pages ?
- Apporte-t-il un angle neuf, un test reproductible ou un jugement opérationnel au-delà des bons contenus existants ?
- Le plan de vérification sépare-t-il les formulations communautaires des preuves officielles ou des tests ?
- Écrire
safe,batch_risk,no_value_addedoufact_check_neededdansrisk_flag
Référence des niveaux de preuve
| evidence_level | Type de source | Exemple | Suite |
|---|---|---|---|
| high | official/help/docs | aide Google Search Console ou issue GitHub avec réponse d’un mainteneur | Peut soutenir une affirmation si l’URL est conservée |
| medium | community/blog | forum, publication indépendante ou blog technique | Sert au vocabulaire des lecteurs ; ajouter une source primaire |
| low | unknown | absence d’URL, simple déduction ou donnée inventée | Rejeter ou placer dans une file « recherche requise » |
Chaque fiche exige evidence_level afin d’identifier immédiatement les sujets qui ont besoin de sources plus solides. Une issue avec réponse d’un mainteneur peut être high ; un échange entre utilisateurs reste medium.
Ces contrôles ne suppriment pas silencieusement tous les candidats risqués. Ils attribuent des états visibles pour que la personne choisisse l’action suivante.
Enregistrer les fiches et les admettre dans le backlog
La sortie finale de l’agent est une fiche candidate, pas un article. Après validation humaine, elle devient une entrée du backlog pour le clustering de mots-clés et les agents de rédaction.
Champs d’une fiche candidate
| Champ | Type | Description | Exemple |
|---|---|---|---|
source_url | string | source d’origine | https://github.com/user/repo/issues/123 |
reader_question | string | question normalisée | « Comment corriger les erreurs après le passage à la v2 ? » |
evidence_level | enum | fiabilité de la source | high / medium / low |
search_value_score | number | potentiel de recherche de 0 à 1 | 0,7 |
site_match_score | number | adéquation au site de 0 à 1 | 0,8 |
value_score | number | valeur ajoutée de 0 à 1 | 0,6 |
verify_score | number | vérifiabilité de 0 à 1 | 0,9 |
total_score | number | total pondéré de 0 à 1 | 0,74 |
suggested_type | enum | format recommandé | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | série recommandée | cloudflare-bindui si cette série existe |
duplicate_check_result | enum | résultat du chevauchement interne | unique / similar_to_existing / duplicate |
risk_flag | enum | risque qualité | safe / batch_risk / no_value_added / fact_check_needed |
Les fiches peuvent être stockées en JSON ou en base de données. Les personnes qui valident voient tous les champs au lieu de décider seulement à partir du titre et d’un indicateur de popularité.
Champs du backlog
Un candidat approuvé devient une entrée avec :
- Le titre finalisé pendant la revue humaine
- Les mots-clés principaux et secondaires
- Le statut
to_write,writing,reviewoupublished - Le
total_scoredu candidat - La langue, par exemple zh ou en, selon la configuration du site
- La série lorsque
suggested_seriesest valide - La date de publication prévue et la priorité
Un article suivant peut définir le schéma complet et l’API. Ce workflow couvre uniquement l’admission de la fiche candidate.
Workflow de revue humaine
Avant l’admission, une personne vérifie :
- Revue du score :
total_scoreest-il plausible et une valeur basse commeverify_score = 0.2exige-t-elle davantage de preuves ? - Revue du titre et des mots-clés :
reader_questiondécrit-elle correctement le problème et faut-il ajuster les mots-clés ? - Deuxième recherche interne : la déduplication automatique a-t-elle manqué un article similaire ?
- Décision d’admission : approuver, rejeter ou demander plus de preuves, avec le motif
Le flux est extraction par l’agent → notation et filtrage structurés → revue humaine → admission. L’automatisation organise des signaux dispersés en fiches comparables, tandis que la responsabilité éditoriale reste humaine.
Étapes suivantes et articles associés
Après la notation et la revue viennent généralement le clustering de mots-clés, la gestion du backlog et la planification de la rédaction. Ces articles fournissent un contexte utile :
- Agent IA de recherche : de la recherche multiplateforme au rapport de preuves
- SOP hebdomadaire GA/GSC pour les pages à fortes impressions et faibles clics
- Techniques avancées pour Google Search Console
- Planification trimestrielle des sujets d’un blog technique
Un agent de recherche de sujets n’est que la première étape de l’automatisation d’un site de contenu. Il transforme plusieurs signaux en candidats vérifiables ; clustering, gestion des tâches, validation rédactionnelle et mise à jour restent des étapes distinctes.
Construire un agent IA minimal de recherche de sujets
Normalisez plusieurs signaux de demande en fiches candidates, notez-les, dédupliquez-les et n’ajoutez au backlog que les éléments validés par une personne.
- 1
Step 1: Charger l’inventaire de contenu
Lisez les articles existants, les plans de séries et les tags pour établir la base de déduplication et d’adéquation au site. - 2
Step 2: Récupérer les données GSC
Obtenez clicks, impressions, CTR et average position par query et page, puis signalez la demande existante et les lacunes. - 3
Step 3: Ajouter le contexte externe
Utilisez la recherche générale pour les questions SERP et les sources primaires, puis enregistrez la requête, l’heure, l’URL et l’état de récupération. - 4
Step 4: Collecter les signaux de communautés et d’issues en lecture seule
Extrayez les formulations de Reddit et les erreurs, versions ou blocages fonctionnels des issues GitHub sans effectuer d’écriture. - 5
Step 5: Normaliser et noter les candidats
Créez des fiches candidates et notez le potentiel de recherche, l’adéquation au site, la valeur ajoutée et la vérifiabilité. - 6
Step 6: Filtrer les doublons et les risques
Normalisez les entités et l’intention, puis contrôlez le chevauchement interne, les niveaux de preuve, le risque de contenu industrialisé et les faits volatils. - 7
Step 7: Faire valider et admettre
Faites examiner les fiches les mieux classées, ajoutez uniquement les éléments approuvés et consignez création, mise à jour, ajout de FAQ, fusion ou rejet.
FAQ
Un agent de sujets doit-il privilégier les résultats Google ou les données Search Console ?
Un post Reddit populaire peut-il devenir directement un sujet de blog ?
Quels sujets techniques peut-on tirer des issues GitHub ?
Comment distinguer une demande réelle d’une plainte isolée ?
Le processus doit-il s’arrêter si GitHub Search ou Reddit échoue ?
Google Custom Search JSON API convient-elle à un nouveau projet ?
Que doit vérifier une personne avant l’entrée d’un sujet dans le backlog ?
14 min de lecture · Publié le: 13 nov. 2026

Guide pratique de l automatisation des sites de contenu IA
Si vous arrivez depuis la recherche, le plus rapide est de passer à l’article précédent ou suivant de cette série.
Précédent
Le contenu IA peut-il encore être référencé ? Règles de Google
Google précise quand le contenu IA est acceptable, quand la publication à grande échelle devient du spam et quels contrôles humains réduisent le risque.
Partie 1 sur 4
Suivant
Clustering de mots-clés par IA : transformer les requêtes en séries et liens internes
Regroupez requêtes GSC, idées et articles existants, puis validez les clusters par les SERP et une revue humaine avant de choisir page, mise à jour, FAQ ou lien.
Partie 3 sur 4


Commentaires
Connectez-vous avec GitHub pour laisser un commentaire