
AI選定エージェント実践:Google・Reddit・GitHubから技術ブログのテーマを探す
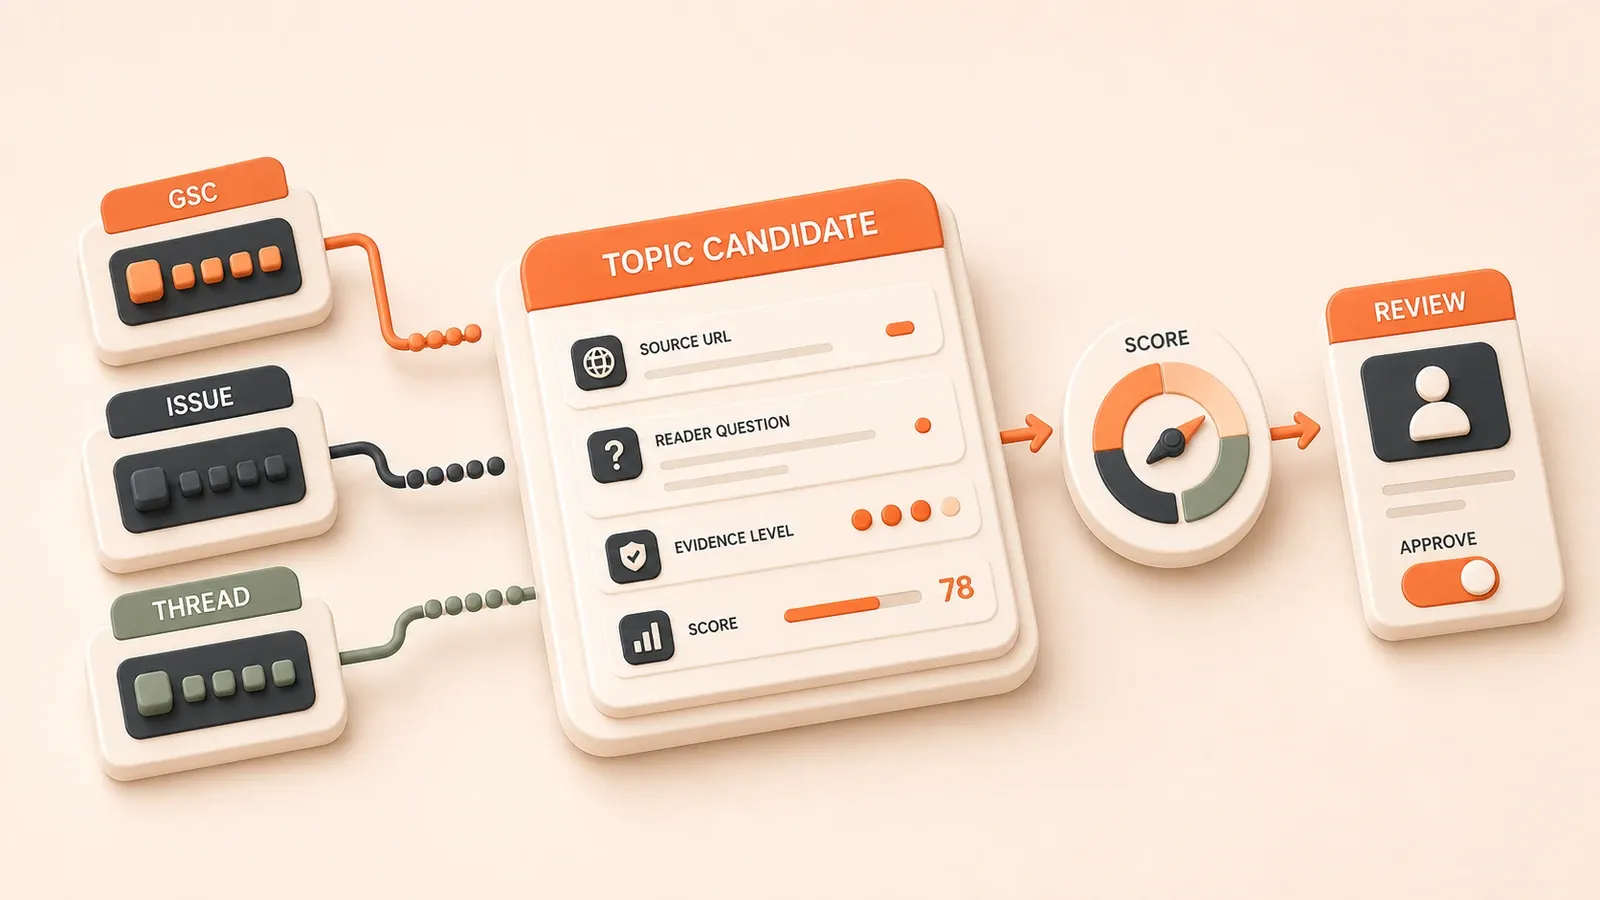
"Google Search Analytics APIはqueryやpageなどのディメンション、1〜25,000のrowLimit、startRowによるページングを提供し、すべてのデータ行を保証しないことも明記しています。"
候補テーマ表は通常、3つの列から始めます。source_urlには出典、reader_questionには読者の問い方、evidence_levelには証拠の信頼度を記録します。コミュニティ由来の問いは2列目に置き、fact_claimには入れません。技術的な事実は、公式ドキュメントまたは再現できたエラーで裏付けます。
選定エージェントは、流行を追うボットではありません。Google Search Consoleの実検索語句、GitHub issueに現れる技術上の詰まり、RedditやHNで使われる悩みの表現を、監査可能な候補カードへ変換します。スコアリング、重複排除、リスクフィルターを通過した項目だけがコンテンツタスクになります。思いつきではなく、繰り返して検証できる工程です。
選定エージェントの入力レイヤーを設計する
Googleの自社データ:Performance reportとAPIの境界
最初の入力は、第三者のトレンド指標ではなく、自サイトの検索データにします。Google Search ConsoleのPerformance reportは、4つの主要指標と6つのディメンションを提供します。
Performance reportのディメンション
| ディメンション | フィールド | 用途 |
|---|---|---|
| 検索語句 | queries | 読者が実際に入力した語句を確認し、表示回数が多くクリックが少ない候補を見つける |
| ページ | pages | すでに流入があるページを確認し、重複記事を防ぐ |
| 国・地域 | countries | 地域差を把握し、特定市場だけに適したテーマを分ける |
| デバイス | devices | mobileとdesktopを分け、形式や情報量の判断に使う |
| 検索での見え方 | search appearance | リッチリザルトの種類を確認し、構造化データの不足を探る |
| 日付 | dates | サンプル期間と比較期間を定める |
4つの指標はclicks、impressions、CTR、average positionです。選定ではimpressionsが特に役立ちます。表示されているのにクリックされないqueryは、需要がある一方で、サイトが答えを十分に提供できていない可能性を示します。
Search Console APIのクエリ設計と制限
プログラムからはsearchAnalytics.queryを使います。2026年7月時点のGoogle公式ドキュメントでは、OAuth認証が必要で、rowLimitは1〜25,000です。queryやpageなどのdimensions、countryやdeviceなどのfilters、aggregationTypeを指定できます。
制約は2つあります。第一に、APIは全データ行を保証せず、Search Console内部の制限によって上位行を優先します。第二に、最新データを要求した場合、処理中の日付や時間を示すメタデータが返ることがあります。ページングとキャッシュを実装し、「不完全な可能性あり」という状態を残してください。エクスポートを全量データとして扱ってはいけません。
Custom Search JSON APIの移行注意
Google Custom Search JSON APIは、かつてプログラム検索によく使われました。しかし公式ページでは、新規顧客への提供を終了し、既存顧客も2027年1月1日までに移行する必要があると案内しています。新システムは、このAPIを前提にせず、サポート対象の検索製品または一般検索ゲートウェイを選びます。
既存プロジェクトで利用中なら、早めに移行を計画し、設定から検索プロバイダーを交換できるようにします。
GitHub入力:Search APIの境界とissueクエリ
GitHubは技術テーマを見つけやすい情報源です。issueタイトルには実際のエラーや機能上の詰まりが現れ、release noteやdiscussionからはバージョン変更やベストプラクティスの需要が分かります。一方で、GitHub Search APIには明確な上限があります。
GitHub Search APIの上限とレート制限
| 種類 | レート制限 | 説明 |
|---|---|---|
| 認証済みsearch(code以外) | 30 requests/min | tokenが必要で、継続収集に向く |
| 未認証search | 10 requests/min | 公開データの低頻度テスト向け |
| code search | 10 requests/min | ソースコード検索には認証が必要 |
1回の検索で得られる結果は最大1,000件で、それを超える部分はページングでも取得できません。複雑なクエリはタイムアウトすることがあり、その場合JSONのincomplete_results: trueが、結果が不完全な可能性を示します。
issueクエリと記事タイプの対応
GitHub検索では複数の修飾子を組み合わせられます。

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-nameis:issueとis:prは種類、in:title、in:body、in:commentsは検索対象、repo:、user:、org:は範囲を限定します。さらにstate:、label:、reason:を組み合わせます。
パターンごとに、候補となる記事タイプが変わります。
| クエリパターン | 記事タイプ候補 | タイトルの方向性 |
|---|---|---|
| bug + in:title + エラー語句 | トラブルシューティング | 「アップグレード後のよくあるエラー」 |
| enhancement + in:title | 比較・移行 | 「新機能と旧方式を実践比較」 |
| discussion + in:body + “best practice” | ベストプラクティス | 「メンテナーフォーラムに見る実践方法」 |
| closed + reason:“completed” | バージョン解説 | 「v2.0の新機能:issue検証と移行ポイント」 |
レート制限とincomplete_resultsへの縮退
API呼び出し後は、まずレスポンスヘッダーのx-ratelimit-*を読みます。リソース別の残量をまとめて確認するときだけGET /rate_limitを使います。制限に達したらretry-afterまたはx-ratelimit-resetまで待ち、失敗が続く場合は指数バックオフ後に停止します。
incomplete_results: trueなら、候補カードに「データが不完全な可能性あり、手動補完が必要」と記録します。既存結果を全量とはみなしません。starsやレスポンス数は補助シグナルにとどめ、単独の重みにしないでください。
Reddit入力:読み取り専用の許可リストとアクセスリスク
コミュニティ投稿からは、読者の自然な言い回しや痛みを抽出できます。ただしReddit APIのポリシーや不正利用対策は変わり得るため、取得の安定性は高くありません。入力は問い方とFAQ候補だけに使い、本文の技術的主張は公式ドキュメントや再現結果で支えます。
読み取り専用エンドポイントの許可リスト
BetterLinkの調査では、取得と検索だけを許可し、書き込み操作を禁止します。
許可する読み取り専用エンドポイント:
listing:投稿一覧を取得comments:投稿のコメントを取得info:投稿またはユーザーのメタデータを取得search:投稿を検索
禁止する書き込みエンドポイント:
comment:コメントを投稿submit:投稿を作成vote:投票save、hide:投稿を保存または非表示
Reddit APIを使う場合は、誤って書き込み処理を実行できないよう、コードに読み取り専用の許可リストを組み込みます。
アクセスリスクと縮退方法
主な失敗は3種類です。tokenの期限切れや権限不足による認証失敗、頻度超過による一時的な制限、Developer Platformの方針変更によるエンドポイント停止です。
次の順で縮退します。
- Reddit APIを呼び出す → 失敗したらエラーを記録
- アクセス可能なコミュニティ検索結果へ切り替える
- 問い方と悩みの語句を抽出する → FAQ候補へ変換
- フロー全体を止めず、採点と重複排除を続ける
Redditから取得できなくても、GSCとGitHubは利用できます。失われるのは、問い方と悩みに関する一部のシグナルです。
データの位置付け:事実の証明ではなく問い方の入力
候補表の3列で、用途を明確にできます。
| 列 | 用途 | Reddit由来データの扱い |
|---|---|---|
source_url | 出典URL | 利用可能 |
reader_question | 読者の問い方 | 主用途として利用可能 |
evidence_level | 証拠の信頼度 | fact_claimには入れず、reader_signalとしてのみ記録 |
例えば「How to fix X error after upgrading to v2?」という投稿は、reader_question: "v2へアップグレードした後のエラーをどう解決するか"、evidence_level: "community"を持つ候補カードになります。採点では証拠の重みを下げ、審査画面で公式資料または再現結果の追加を求めます。
この分離によって「多数の利用者が困っている」といった裏付けのない表現を避けられます。コミュニティは検索意図の言葉を提供しますが、技術的事実の証拠にはなりません。
候補テーマを抽出して分類する
エージェントの中心的な仕事は、GSC、GitHub、Redditの3入力を候補カードに揃え、採点、重複排除、リスクフィルターへ送ることです。フローは5段階に分かれます。
5段階のワークフロー
Step 1:Googleの自社データ
- Search Console APIから過去30〜90日の
queriesを取得 - 例としてimpressions > 100かつCTR < 2%など、表示が多くクリックが少ないqueryを抽出
- 流入はあるがFAQが不足するページを抽出
- 出力:
query、impressions、CTR、existing_pageを持つGSC候補表
Step 2:GitHub issueの分類
- repoまたはorg単位で、前述のテンプレートを使ってissueを一括検索
label:bugはトラブルシューティング、label:enhancementは比較、discussionはベストプラクティスに分類- issueタイトルからエラー語句、バージョン番号、機能名を抽出
- 出力:
issue_url、suggested_type、keywordsを持つGitHub候補表
Step 3:Reddit/HNの悩み抽出
- 指定したsubredditまたはHNを検索し、繰り返し使われる表現を抽出
- 「How to fix X」「Why does X happen」「Best way to do X」などの型を正規化
- 投稿は問い方の整理にだけ使い、技術的事実の証明には使わない
- 出力:
source_url、reader_question、evidence_level: communityを持つ表
Step 4:重複排除とサイト内検索
- 候補のキーワードでサイト内を検索
- GSC queryの意図をすでに満たすページがあるか確認
- 「アップグレード後のエラー解決」と「アップグレードエラーの対処」が別候補にならないようタイトル類似度を計算
- 出力:
duplicate_check_resultを持つ重複排除済み候補
Step 5:人による審査
- 候補カードを登録する前に確認:
- 検索機会、サイト適合性、追加価値、検証可能性のスコアは妥当か
- タイトル案とキーワードは正確か
- 新規記事にするか、既存記事のFAQを更新するか
- 出力:承認済み候補カードをコンテンツタスクへ登録
これは完全自動のフローではありません。収集と構造化は自動化しますが、最終的な編集判断は人が行います。
検索機会・サイト適合性・追加価値・検証可能性を採点する
話題性だけでは公開する価値を判断できません。サイトの対象に合うか、既存記事にない価値を加えられるか、検証可能な情報源があるかを4軸で採点します。
採点項目
| 項目 | 重み | 判断材料 | データソース |
|---|---|---|---|
| 検索機会 | w1(例:0.3) | GSC impressions、query volume、競合のカバー状況 | Search Console、外部SEOツール |
| サイト適合性 | w2(例:0.25) | サイトの対象範囲、シリーズ、タグとの一致 | サイト設定、シリーズ一覧、タグ一覧 |
| 追加価値 | w3(例:0.25) | 類似する既存記事、SERP上の既存記事の品質 | サイト内検索、競合調査 |
| 検証可能性 | w4(例:0.2) | 公式docs、issue、release note、再現テスト | 出典情報、evidence_level |
計算式:total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
各項目を0〜1で採点すると、total_scoreも0〜1になります。例として0.6を基準にし、それ未満は自動登録せず「審査待ち」にできます。
採点例:「アップグレード後のエラー解決」
候補がis:issue state:open label:bug in:title error after upgrading to v2から得られ、サイトがDevOpsとコンテナを扱い、テーマを「アップグレード後のよくあるエラー」に正規化したとします。
| 項目 | スコア | 理由 |
|---|---|---|
| 検索機会 | 0.7 | GSCに関連queryがあり、impressionsは中程度。競合記事は断片的 |
| サイト適合性 | 0.8 | コンテナ更新シリーズとDevOpsタグがあり、シリーズの不足を補える |
| 追加価値 | 0.6 | 既存の「更新時の注意」記事にはエラー解決がない。追記または子記事にできる |
| 検証可能性 | 0.9 | GitHub issueと公式release noteが破壊的変更を示し、エラーを再現できる |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
0.74 > 0.6なので、人による審査へ送ります。審査画面には「まず既存記事へ追記。範囲が独立するなら子記事を作る」という推奨も表示します。
この採点は、サイトに合わない需要を追うことと、追加価値のない重複記事を公開することの両方を防ぎます。
重複排除・証拠階層・リスクのゲートを通す
候補をタスクリストへ入れる前に、サイト内重複、情報源の信頼度、Google品質リスクの3段階を確認します。これにより、重複、弱い証拠、大量生成リスクを事前に見える状態にします。
3つのゲート
ゲート1:サイト内重複
- GSC query専用のページがすでにあるか確認
- 類似タイトルをサイト内検索
- 「更新時のエラー解決」と「アップグレード後のエラー対処」を別テーマにしないよう類似度を比較
duplicate_check_resultにunique、similar_to_existing、duplicateを記録
ゲート2:証拠の信頼度

evidence_levelを設定:high:公式help/docs、公式回答のあるissue、実測データmedium:メンテナー確認のないコミュニティ投稿や独立記事low:出典不明、リンクなし、根拠のない推測
- すべての候補カードで
evidence_levelを必須にする
ゲート3:Google品質リスク
- 低価値コンテンツの大量生成につながらないか確認:
- Cloudflare WorkersとCloudflare Pagesの設定記事のように、パラメーターだけを替えた同一構成ではないか
- 優れた既存記事に対して、新しい視点、再現テスト、運用判断を追加できるか
- コミュニティの問いと、公式情報またはテスト結果を分離できるか
risk_flagにsafe、batch_risk、no_value_added、fact_check_neededを記録
証拠階層の基準
| evidence_level | 情報源 | 例 | 後続処理 |
|---|---|---|---|
| high | official/help/docs | Google Search Consoleヘルプ、メンテナー回答付きissue | URLを保持したうえで事実の根拠にできる |
| medium | community/blog | フォーラム、独立投稿、技術ブログ | 読者の言い回しに使い、本文には一次情報を追加 |
| low | unknown | URLなし、推測、捏造データ | 破棄するか「要調査」キューへ送る |
evidence_levelがあれば、どの候補に強い情報源が必要かを審査時にすぐ判断できます。メンテナー回答付きissueはhigh、利用者だけのやり取りはmediumです。
ゲートは危険な候補をすべて黙って削除する仕組みではありません。問題を状態として表示し、人が処理を決められるようにします。
候補カードを保存してタスクリストへ登録する
最終出力は記事ではなく候補カードです。人が承認したカードだけが、キーワードクラスタリングや執筆エージェントへ渡すコンテンツタスクになります。
候補カードのフィールド
| フィールド | 型 | 説明 | 例 |
|---|---|---|---|
source_url | string | 元のURL | https://github.com/user/repo/issues/123 |
reader_question | string | 正規化した読者の問い | 「v2へ更新した後のエラーをどう解決するか」 |
evidence_level | enum | 情報源の信頼度 | high / medium / low |
search_value_score | number | 検索機会(0〜1) | 0.7 |
site_match_score | number | サイト適合性(0〜1) | 0.8 |
value_score | number | 追加価値(0〜1) | 0.6 |
verify_score | number | 検証可能性(0〜1) | 0.9 |
total_score | number | 加重合計(0〜1) | 0.74 |
suggested_type | enum | 推奨形式 | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | 推奨シリーズ | サイトに存在する場合はcloudflare-bindui |
duplicate_check_result | enum | サイト内重複結果 | unique / similar_to_existing / duplicate |
risk_flag | enum | 品質リスク | safe / batch_risk / no_value_added / fact_check_needed |
候補カードはJSONまたはデータベースレコードとして保存できます。審査者はタイトルと人気指標だけでなく、すべてのフィールドを見て判断できます。
タスクリストのフィールド
承認済み候補は、次のフィールドを持つタスクになります。
- 人が審査して確定したタイトル
- メインキーワードと関連キーワード
- 状態:
to_write、writing、review、published - 候補から引き継ぐ
total_score - サイト設定に従うzhやenなどの言語
suggested_seriesが有効な場合のシリーズ- 公開予定日と優先度
詳細なタスクスキーマとAPIは次の記事で扱えます。ここでは、候補カードが登録されるまでに範囲を限定します。
人による審査フロー
登録前に、人が次を確認します。
- スコア確認:
total_scoreは妥当か。verify_score = 0.2など低い項目には追加証拠が必要か - タイトルとキーワード確認:
reader_questionは問題を正確に表すか。キーワードを直すべきか - サイト内検索の再確認:自動重複排除が類似記事を見落としていないか
- 登録判断:承認、拒否、追加証拠の依頼を選び、理由を記録
流れは、エージェントによる抽出 → 構造化した採点とフィルター → 人による審査 → 登録です。自動化は散在するシグナルを比較可能なカードへ整理し、編集責任は人に残します。
次のステップと関連記事
採点と審査の後は、キーワードクラスタリング、タスク管理、執筆計画へ進みます。実装の参考になる記事はこちらです。
- AI調査エージェント:複数プラットフォーム検索から証拠レポートまで
- 高表示・低クリックを改善するGA/GSC週次運用SOP
- Google Search Consoleの高度な活用方法
- 技術ブログの四半期テーマ計画
選定エージェントは、コンテンツサイト自動化の最初の工程です。複数ソースのシグナルを審査可能な候補へ変換し、クラスタリング、タスク管理、執筆検証、既存記事更新は下流の独立した工程として扱います。
最小構成のAI選定エージェントを作る
複数ソースの需要シグナルを候補カードに正規化し、採点、重複排除、人による審査を経て合格項目だけをタスクリストへ入れます。
- 1
ステップ 1: コンテンツ在庫を読み込む
既存記事、シリーズ計画、タグを読み込み、重複排除とサイト適合性の基準を作ります。 - 2
ステップ 2: GSCデータを取得する
queryとpageごとにclicks、impressions、CTR、average positionを取得し、既存需要とコンテンツ不足を示します。 - 3
ステップ 3: 外部の文脈を補う
一般検索でSERP上の問いと一次情報を調べ、検索語、時刻、URL、取得状態を保存します。 - 4
ステップ 4: コミュニティとissueを読み取り専用で集める
Redditから読者の言い回しを、GitHub issueからエラー、バージョン、機能上の詰まりを抽出し、書き込み操作は行いません。 - 5
ステップ 5: 候補を正規化して採点する
候補カードを作り、検索機会、サイト適合性、追加価値、検証可能性を採点します。 - 6
ステップ 6: 重複とリスクを確認する
エンティティと意図を正規化し、サイト内重複、証拠階層、大量生成リスク、変動しやすい事実を確認します。 - 7
ステップ 7: 人が審査して登録する
上位候補を人が確認し、合格項目だけをタスクリストへ入れ、新規、更新、FAQ追加、統合、破棄の判断を記録します。
FAQ
選定エージェントはGoogle検索結果とSearch Consoleのどちらを優先すべきですか?
Redditの人気投稿をそのままブログテーマにできますか?
GitHub issueからどのような技術記事を見つけられますか?
実際の需要と一度きりの不満をどう見分けますか?
GitHub Search APIやRedditへのアクセスが失敗したら処理を止めるべきですか?
Google Custom Search JSON APIは新規プロジェクトに適していますか?
候補をタスクリストへ入れる前に人が確認する項目は何ですか?
9分で読めます · 公開日: 2026年11月13日

AI コンテンツサイト自動化実践ガイド: 企画、執筆、公開、運用
検索からこのページに来た場合は、前後の記事もあわせて読むと同じテーマの理解がかなり早く深まります。


コメント
GitHubアカウントでログインしてコメントできます