
Agente de IA para pesquisar temas: ideias de blog com Google, Reddit e GitHub
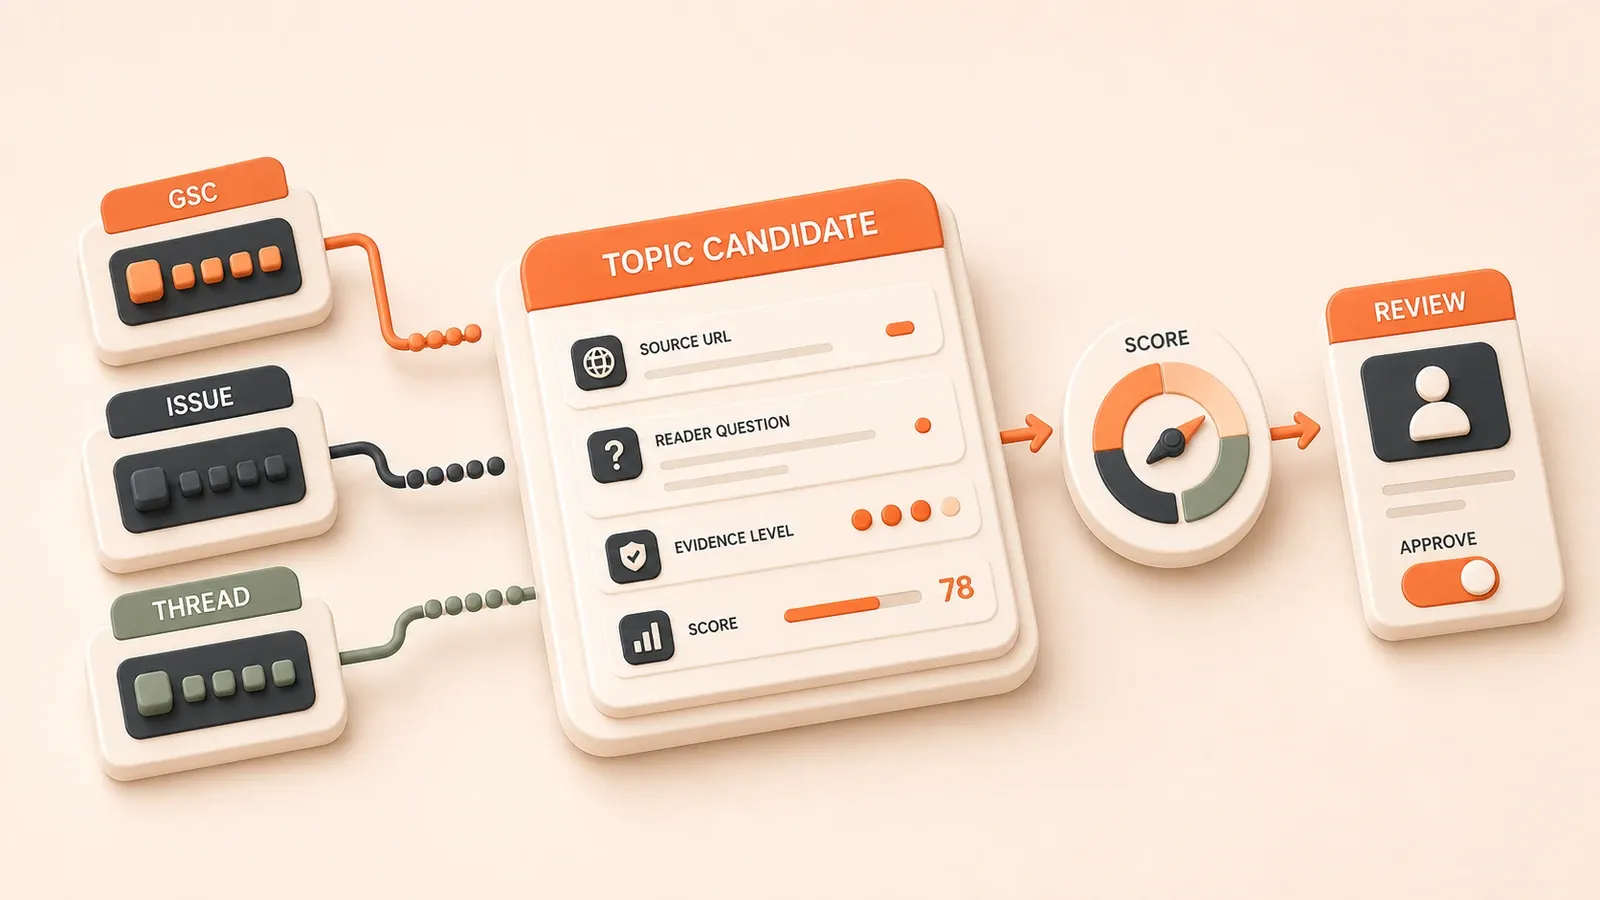
"A API Google Search Analytics aceita dimensões de consulta e página, rowLimit de 1 a 25.000 e paginação com startRow, mas informa explicitamente que não garante todas as linhas de dados."
Uma tabela de temas candidatos costuma começar com três colunas: source_url guarda a origem, reader_question registra como o leitor formula o problema e evidence_level indica a confiança na evidência. Uma pergunta obtida em fórum pertence à segunda coluna, não a fact_claim; fatos técnicos continuam exigindo documentação oficial ou um erro reproduzido.
Um agente de pesquisa de temas não é um robô que persegue tendências. Ele transforma consultas reais do Google Search Console e atritos técnicos de issues do GitHub em fichas auditáveis. Entradas separadas de fóruns fornecem a linguagem usada pelos leitores. Pontuação, deduplicação e filtros de risco decidem o que chega ao backlog. Assim, o processo é repetível e revisável, em vez de depender de inspiração.
Projetar a camada de entrada do agente de temas
Dados próprios do Google: relatório de desempenho e limites da API
A primeira camada deve vir dos dados de busca do próprio site, não de uma pontuação de tendência de terceiros. O relatório de desempenho do Google Search Console apresenta quatro métricas principais e seis dimensões.
Dimensões do relatório de desempenho
| Tipo de dimensão | Campo | Finalidade |
|---|---|---|
| Consulta | queries | Mostra o que os leitores digitam e revela candidatos com muitas impressões e poucos cliques |
| Página | pages | Mostra quais páginas já recebem tráfego e evita cobertura duplicada |
| País ou região | countries | Registra diferenças regionais quando o tema vale apenas para determinados mercados |
| Dispositivo | devices | Separa comportamento móvel e desktop, que pode afetar formato e profundidade |
| Aparência na pesquisa | search appearance | Identifica tipos de resultado enriquecido e possíveis lacunas de dados estruturados |
| Data | dates | Define janelas de amostragem e comparação |
As quatro métricas são clicks, impressions, CTR e average position. impressions é particularmente útil para descobrir temas: quando uma consulta recebe impressões sem cliques, os leitores procuram algo que o site talvez ainda não explique com clareza.
Desenho da consulta e limites da API do Search Console
O acesso programático usa o método searchAnalytics.query. Segundo a documentação do Google consultada em julho de 2026, o método exige autorização OAuth, aceita rowLimit de 1 a 25.000 e permite dimensions, como consulta ou página, filters, como país ou dispositivo, e aggregationType.
Duas restrições importam. Primeiro, a API não garante todas as linhas: os limites internos do Search Console favorecem as principais. Segundo, consultas de dados recentes podem incluir metadados que indicam datas ou horas ainda em processamento. O agente deve paginar, manter cache e preservar um indicador de dados incompletos, em vez de tratar a exportação como um conjunto exaustivo.
Aviso de migração da Custom Search JSON API
A Google Custom Search JSON API já foi uma opção comum para executar buscas na web por programação, mas a página oficial agora informa que ela está fechada para novos clientes e que os clientes atuais precisam migrar até 1º de janeiro de 2027. Um sistema novo deve usar um produto de busca compatível ou um gateway geral, sem depender dessa API.
Se um projeto existente ainda usa a Custom Search JSON API, planeje a migração cedo e mantenha o provedor de busca substituível na configuração.
Entrada do GitHub: limites da Search API e modelos de consulta de issues
O GitHub é uma fonte forte de ideias técnicas. Títulos de issues frequentemente descrevem erros reais ou restrições de produto, enquanto notas de versão e discussões revelam mudanças e pedidos de melhores práticas. A GitHub Search API também tem limites definidos.
Limites da GitHub Search API e de requisições
| Tipo | Limite | Observações |
|---|---|---|
| busca autenticada, exceto código | 30 requisições/min | Exige token e serve para coleta contínua |
| busca não autenticada | 10 requisições/min | Acesso público adequado apenas a testes de baixa frequência |
| busca de código | 10 requisições/min | Exige autenticação para consultas de código-fonte |
Cada busca fornece no máximo 1.000 resultados, e a paginação não expõe itens além desse limite. Uma consulta também pode expirar; nesse caso, a resposta JSON define incomplete_results: true, indicando que o conjunto retornado talvez esteja incompleto.
Modelos de consulta de issues e formatos de artigo
A busca do GitHub aceita qualificadores combináveis:

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
Qualificadores comuns incluem is:issue e is:pr para o tipo de recurso, in:title, in:body e in:comments para campos, repo:, user: e org: para escopo, além de state:, label: e reason:.
Padrões diferentes sugerem formatos diferentes:
| Padrão da consulta | Tipo de artigo candidato | Direção de título |
|---|---|---|
| bug + in:title + palavra de erro | Solução de problemas | ”Erros comuns depois de uma atualização” |
| enhancement + in:title | Comparação ou migração | ”Novo recurso vs abordagem antiga: comparação prática” |
| discussion + in:body + “best practice” | Melhores práticas | ”Abordagens práticas de um fórum de mantenedores” |
| closed + reason:“completed” | Análise de versão | ”Novidades da v2.0: issues verificados e notas de migração” |
Alternativas para limites e incomplete_results
Depois de cada chamada, leia primeiro os cabeçalhos x-ratelimit-*. Chame GET /rate_limit quando precisar de um resumo dos grupos de recursos. Se o limite for excedido, aguarde até retry-after ou x-ratelimit-reset; se as falhas continuarem, use espera exponencial e, por fim, pare de tentar.
Quando aparecer incomplete_results: true, marque a ficha como “dados possivelmente incompletos; acompanhamento manual necessário”, em vez de tratar o resultado como exaustivo. Estrelas e quantidade de respostas podem ser sinais auxiliares, mas nenhum deles deve ser o único fator de classificação.
Entrada do Reddit: lista permitida somente leitura e riscos de acesso
Publicações em fóruns podem fornecer formulações realistas e termos de dor, mas a política da API e os controles antiabuso do Reddit podem mudar, tornando a coleta menos previsível. Use esses sinais somente para intenção e candidatos a FAQ; afirmações técnicas ainda precisam de documentação oficial ou erros reproduzidos.
Lista de endpoints permitidos somente leitura
A pesquisa da BetterLink permite apenas recuperação e busca, sem operações de escrita:
Endpoints somente leitura permitidos:
listing: obter listas de publicaçõescomments: obter comentários de uma publicaçãoinfo: obter metadados de publicação ou usuáriosearch: pesquisar publicações
Endpoints de escrita proibidos:
comment: publicar comentáriosubmit: publicar uma postagemvote: votarsaveehide: salvar ou ocultar uma postagem
Se o agente acessar a API do Reddit, codifique a lista permitida no sistema para impedir que o fluxo acione um endpoint de escrita por engano.
Riscos de acesso e alternativas
O acesso ao Reddit pode falhar por três motivos comuns: autorização inválida por token vencido ou insuficiente, bloqueio antiabuso temporário depois de tráfego excessivo ou mudança na política da Developer Platform que desative um endpoint.
Use esta sequência:
- Tentar a requisição à API do Reddit → registrar o erro em caso de falha
- Recorrer a resultados acessíveis de busca por perguntas da comunidade
- Extrair formulações e termos de dor → criar candidatos a FAQ
- Continuar a pontuação e deduplicação sem interromper o fluxo
Mesmo que a coleta no Reddit falhe, o agente continua usando GSC e GitHub; perde apenas parte dos sinais de linguagem e dor.
Tratar os dados como perguntas, não como prova
Três colunas deixam o papel do Reddit explícito:
| Coluna | Finalidade | Conteúdo permitido do Reddit |
|---|---|---|
source_url | Fonte original | Permitido |
reader_question | Formulação normalizada do leitor | Permitido e uso principal |
evidence_level | Confiança na evidência | Não preencher fact_claim; registrar apenas como reader_signal |
Por exemplo, a publicação “How to fix X error after upgrading to v2?” vira uma ficha com reader_question: "Como resolver o erro depois de atualizar para a v2?" e evidence_level: "community". A pontuação reduz o peso da evidência, e a interface de revisão solicita documentação oficial ou um caso reproduzido.
Essa separação evita afirmações sem apoio, como “muitas pessoas estão perguntando no Reddit”. O Reddit fornece linguagem de intenção de busca, não prova de um fato técnico.
Extrair e classificar temas candidatos
O trabalho central do agente é normalizar três fontes — GSC, GitHub e Reddit — em fichas e enviá-las por filtros de pontuação, deduplicação e risco. O fluxo tem cinco etapas.
Fluxo de cinco etapas
Etapa 1: dados próprios do Google

- Consultar a API do Search Console para obter
queriesdos últimos 30 a 90 dias - Identificar consultas com muitas impressões e poucos cliques, usando como exemplo impressões > 100 e CTR < 2%
- Encontrar páginas que recebem tráfego, mas não têm FAQ
- Gerar tabela de candidatos GSC com
query,impressions,CTReexisting_page
Etapa 2: classificação de issues do GitHub
- Pesquisar issues em lotes por repositório ou organização com os modelos acima
- Classificar
label:bugcomo solução de problemas,label:enhancementcomo comparação e discussões como melhores práticas - Extrair termos de erro, versões e nomes de recursos dos títulos
- Gerar tabela com
issue_url,suggested_typeekeywords
Etapa 3: extração de dores no Reddit e HN
- Pesquisar subreddits selecionados ou HN e extrair formulações recorrentes
- Normalizar padrões como “Como resolver X”, “Por que X acontece” e “Melhor forma de fazer X”
- Usar as publicações para formular perguntas, não comprovar fatos técnicos
- Gerar tabela com
source_url,reader_questioneevidence_level: community
Etapa 4: deduplicação e busca interna
- Pesquisar no site usando as palavras-chave de cada candidato
- Verificar se uma consulta do GSC já tem página que cobre a intenção
- Calcular similaridade de títulos para não tratar “erros após atualização” e “tratamento de erro na atualização” como duplicatas separadas
- Gerar fichas deduplicadas com
duplicate_check_result
Etapa 5: revisão humana
- Antes de admitir uma ficha, revisar:
- Se as pontuações de oportunidade de busca, aderência ao site, valor adicional e verificabilidade fazem sentido
- Se a direção do título e as palavras-chave estão corretas
- Se a ação adequada é um novo artigo ou a atualização de FAQ de um artigo existente
- Enviar as fichas aprovadas ao backlog de conteúdo
Este não é um fluxo totalmente autônomo. O agente automatiza a coleta e produz saída estruturada, mas uma pessoa toma a decisão editorial final.
Pontuar oportunidade, aderência, valor adicional e verificabilidade
Um tema não merece publicação apenas por ser popular. O agente deve pontuar se a ideia combina com o site, acrescenta algo ainda não coberto e pode ser sustentada por fontes verificáveis.
Dimensões da pontuação
| Dimensão | Peso | Sinais de avaliação | Fonte de dados |
|---|---|---|---|
| Oportunidade de busca | w1, por exemplo 0,3 | Impressões no GSC, volume da consulta, cobertura concorrente | Search Console, ferramentas SEO de terceiros |
| Aderência ao site | w2, por exemplo 0,25 | Escopo do site, série e alinhamento de tags | Configuração, lista de séries, biblioteca de tags |
| Valor adicional | w3, por exemplo 0,25 | Artigos internos semelhantes e qualidade da cobertura atual na SERP | Busca interna, pesquisa concorrente |
| Verificabilidade | w4, por exemplo 0,2 | Documentação oficial, issues, versões e testes reproduzíveis | Metadados da fonte, evidence_level |
Fórmula: total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
Pontue cada dimensão de 0 a 1, mantendo total_score na mesma faixa. Um limite de exemplo de 0,6 pode marcar candidatos inferiores como “aguardar revisão”, em vez de admiti-los automaticamente.
Exemplo: “Resolver erros após uma atualização”
Suponha que o candidato venha de is:issue state:open label:bug in:title error after upgrading to v2. O site trata de DevOps e contêineres, e o tema normalizado é “Erros comuns após uma atualização”.
| Dimensão | Pontuação | Justificativa |
|---|---|---|
| Oportunidade de busca | 0,7 | O GSC contém consulta relacionada com impressões moderadas; artigos concorrentes são fragmentados |
| Aderência ao site | 0,8 | O site tem uma série sobre atualização de contêineres e uma tag DevOps; o candidato preenche uma lacuna |
| Valor adicional | 0,6 | Um artigo existente de notas de atualização não cobre erros; a equipe pode ampliá-lo ou criar um artigo filho |
| Verificabilidade | 0,9 | Um issue e a nota oficial descrevem a mudança incompatível, e o erro pode ser reproduzido |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
Como 0,74 > 0,6, o candidato entra em revisão humana. A pessoa também vê a recomendação: atualizar primeiro o artigo existente ou criar um artigo filho focado se o escopo justificar.
Esse modelo evita dois erros comuns: perseguir demanda sem aderência ao site e publicar cobertura duplicada sem evidência ou experiência relevante.
Aplicar deduplicação, níveis de evidência e controles de risco
Antes de entrar no backlog, o candidato deve passar por três controles: deduplicação interna, classificação de confiança da fonte e verificação de risco de qualidade do Google. Juntos, eles expõem duplicatas, evidências fracas e risco de conteúdo em escala.
Checklist de três controles
Controle 1: deduplicação interna
- Verificar se a consulta do GSC já tem página dedicada
- Pesquisar títulos semelhantes no site
- Comparar similaridade para não tratar “solução de erro de atualização” e “tratamento de erros após atualizar” como ideias distintas
- Gravar
unique,similar_to_existingouduplicateemduplicate_check_result
Controle 2: confiança da evidência
- Definir
evidence_level:high: ajuda ou documentação oficial, issue com resposta oficial ou dados de teste própriomedium: publicação comunitária ou independente sem confirmação do mantenedorlow: fonte desconhecida, sem link ou inferência sem apoio
- Exigir
evidence_levelem toda ficha
Controle 3: risco de qualidade do Google
- Verificar se o candidato incentiva conteúdo de baixo valor em escala:
- É o mesmo artigo com um parâmetro trocado, como configurações quase idênticas para Cloudflare Workers e Cloudflare Pages?
- Acrescenta novo ângulo, teste reproduzível ou julgamento operacional além da cobertura existente?
- O plano de verificação mantém perguntas do Reddit separadas de evidências oficiais ou resultados de testes?
- Gravar
safe,batch_risk,no_value_addedoufact_check_neededemrisk_flag
Referência de níveis de evidência
| evidence_level | Tipo de fonte | Exemplo | Acompanhamento |
|---|---|---|---|
| high | oficial/ajuda/docs | Ajuda do Google Search Console ou issue com resposta de mantenedor | Pode sustentar uma afirmação quando a URL for preservada |
| medium | comunidade/blog | Tópico de fórum, publicação independente ou blog técnico | Usar para formulação; adicionar fonte primária ao artigo |
| low | desconhecida | Sem URL, inferência pura ou dados inventados | Rejeitar ou mover para fila de pesquisa necessária |
Toda ficha precisa de evidence_level, para que revisores vejam imediatamente quais ideias exigem fontes melhores. Um issue com resposta de mantenedor pode ser high; uma discussão apenas entre usuários permanece medium.
Esses controles atribuem estados visíveis, em vez de excluir silenciosamente todo candidato arriscado. Uma ficha marcada pode chegar à fila de revisão, mas a pessoa vê o problema antes de decidir.
Armazenar fichas e admitir itens no backlog
A saída final do agente é uma ficha de candidato, não um artigo. Após aprovação humana, a ficha se torna um registro do backlog para os agentes posteriores de agrupamento de palavras-chave e escrita.
Campos da ficha de candidato
| Campo | Tipo | Descrição | Exemplo |
|---|---|---|---|
source_url | string | Fonte original | https://github.com/user/repo/issues/123 |
reader_question | string | Pergunta normalizada | ”Como resolver erros depois de atualizar para a v2?” |
evidence_level | enum | Confiança da fonte | high / medium / low |
search_value_score | number | Oportunidade de busca de 0 a 1 | 0,7 |
site_match_score | number | Aderência ao site de 0 a 1 | 0,8 |
value_score | number | Valor adicional de 0 a 1 | 0,6 |
verify_score | number | Verificabilidade de 0 a 1 | 0,9 |
total_score | number | Total ponderado de 0 a 1 | 0,74 |
suggested_type | enum | Formato recomendado | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | Série recomendada | cloudflare-bindui, quando a série existir |
duplicate_check_result | enum | Resultado de sobreposição | unique / similar_to_existing / duplicate |
risk_flag | enum | Indicador de risco | safe / batch_risk / no_value_added / fact_check_needed |
As fichas podem ser armazenadas em JSON ou banco de dados. Revisores veem todos os campos, em vez de decidir somente por título e popularidade.
Campos do backlog
Um candidato aprovado vira um registro com:
- Título, finalizado durante a revisão humana
- Palavras-chave primárias e secundárias
- Status:
to_write,writing,reviewoupublished - O
total_scoredo candidato - Locale, como zh ou en, conforme a configuração do site
- Série, quando
suggested_seriesfor válida - Data planejada de publicação e prioridade
O artigo seguinte pode definir o schema completo e a API do backlog. Este fluxo cobre apenas como uma ficha conquista a admissão.
Fluxo de revisão humana
Antes da admissão, uma pessoa verifica:
- Revisão da pontuação:
total_scorefaz sentido? Uma dimensão baixa, comoverify_score = 0.2, exige mais evidência? - Revisão de título e palavras-chave:
reader_questionrepresenta o problema com precisão? As palavras-chave precisam mudar? - Segunda busca interna: a deduplicação automática deixou passar um artigo semelhante?
- Decisão de admissão: aprovar, rejeitar ou pedir mais evidências, registrando o motivo
O fluxo é extração pelo agente → pontuação e filtragem estruturadas → revisão humana → admissão. A automação organiza sinais dispersos em fichas comparáveis; a responsabilidade editorial continua humana.
Próximas etapas e leituras relacionadas
Depois da pontuação e revisão, as etapas usuais são agrupamento de palavras-chave, gestão do backlog e planejamento de escrita. Estes artigos ajudam na implementação:
- Agente de pesquisa com IA: da busca em várias plataformas ao relatório de evidências
- SOP semanal de GA/GSC para páginas com muitas impressões e poucos cliques
- Técnicas avançadas do Google Search Console
- Planejamento trimestral de temas para blogs técnicos
Um agente de pesquisa de temas é apenas a primeira etapa da automação de um site de conteúdo. Ele transforma sinais de várias fontes em candidatos revisáveis; agrupamento, gestão de tarefas, verificação da escrita e atualização de conteúdo continuam sendo responsabilidades posteriores separadas.
Criar um agente de IA mínimo para pesquisar temas
Normalize sinais de várias fontes em fichas de candidatos, pontue e deduplique, e grave no backlog apenas os itens aprovados por uma pessoa.
- 1
Step 1: Carregar o inventário de conteúdo
Leia artigos existentes, planos de séries e tags para formar a base da deduplicação e da pontuação de aderência ao site. - 2
Step 2: Obter dados do GSC
Recupere cliques, impressões, CTR e posição média por consulta e página; depois marque demanda existente e lacunas de cobertura. - 3
Step 3: Adicionar contexto externo
Use busca geral para perguntas da SERP e fontes primárias, salvando consulta, horário, URL e status da recuperação. - 4
Step 4: Coletar sinais de comunidades e issues somente leitura
Extraia formulações de perguntas do Reddit e atritos de erro, versão ou recurso dos issues do GitHub sem executar operações de escrita. - 5
Step 5: Normalizar e pontuar candidatos
Crie fichas e pontue oportunidade de busca, aderência ao site, valor adicional e verificabilidade. - 6
Step 6: Deduplicar e filtrar riscos
Normalize entidades e intenção; depois verifique sobreposição interna, níveis de evidência, risco de conteúdo em escala e fatos voláteis. - 7
Step 7: Revisar e admitir candidatos
Peça a uma pessoa que revise as fichas melhor classificadas, grave somente as aprovadas no backlog e registre se deve criar, atualizar, ampliar, fundir ou descartar.
FAQ
O agente deve extrair resultados do Google ou usar dados do Search Console?
Uma publicação popular do Reddit pode virar tema diretamente?
Que temas técnicos os issues do GitHub podem revelar?
Como diferenciar demanda real de uma reclamação isolada?
O fluxo deve parar quando a busca do GitHub ou o acesso ao Reddit falhar?
A Google Custom Search JSON API é adequada para um projeto novo?
O que deve ser revisado antes de um candidato entrar no backlog?
14 min de leitura · Publicado em: 13 nov 2026

Guia pratico de automacao de sites de conteudo com IA
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Conteúdo com IA ainda funciona para SEO? Regras do Google
O Google explica quando conteúdo com IA é aceitável, quando publicar em escala vira spam e quais revisões humanas reduzem o risco.
Parte 1 de 4
Próximo
Clustering de palavras-chave com IA: de consultas a séries e links internos
Combine consultas do GSC, ideias e artigos; agrupe por intenção, valide com SERPs e revisão humana e atribua cada cluster a página, atualização, FAQ ou link.
Parte 3 de 4


Comentários
Entre com GitHub para comentar