
Conteúdo com IA ainda funciona para SEO? Regras do Google
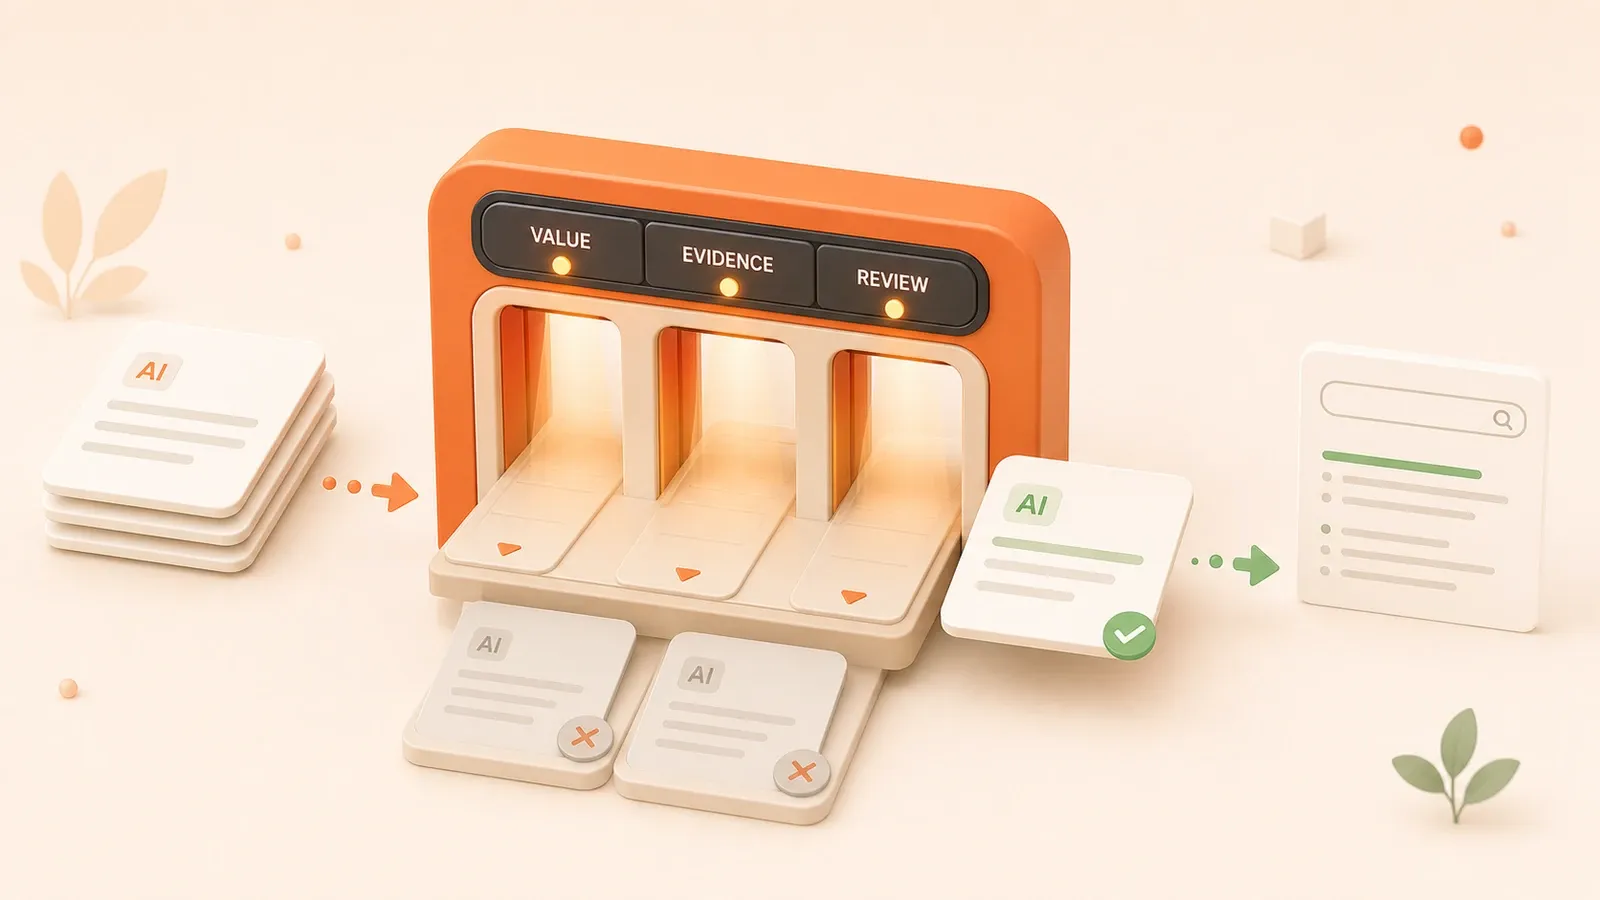
"A orientação do Google sobre conteúdo com IA generativa diz que a IA pode apoiar pesquisa e estruturação de conteúdo original, mas gerar muitas páginas sem valor para usuários pode violar a política de scaled content abuse."
Seu quadro editorial tem 20 temas já pesquisados e você está pronto para gerar todos os rascunhos de uma vez. Mesmo assim, depois de outra manchete dizendo que o Google “combate conteúdo com IA”, o cursor para sobre “Publicar em massa”. É seguro clicar?
A documentação do Google permite responder três perguntas: escrever com apoio de IA viola as regras? Onde fica o limite de publicar em escala? Como aplicar um controle de qualidade a cada artigo?
Posição do Google: a IA não é a infração
Em uma publicação oficial de fevereiro de 2023, o Google respondeu diretamente que o uso adequado de IA ou automação não viola suas diretrizes. A FAQ do Search Central resolve a principal preocupação: a IA, por si só, não torna um conteúdo irregular.
O problema é a finalidade. A mesma publicação explica que usar automação, inclusive IA, principalmente para manipular rankings de busca viola as spam policies. A ferramenta não é o critério decisivo; intenção e resultado são. Se o conteúdo existe principalmente para ajudar pessoas, e não para manipular rankings, a escrita assistida por IA não é proibida.
A IA também não recebe privilégio de ranking. O Google afirma que conteúdo com IA não ganha vantagem especial. Conteúdo útil, original e que demonstre aspectos de E-E-A-T pode ter bom desempenho; conteúdo fraco pode não ter. Um texto não sobe nem é punido automaticamente por usar IA. Seu desempenho depende de ser helpful, reliable e people-first.
As spam policies atuais do Google traçam um limite mais preciso: conteúdo produzido em escala principalmente para manipular rankings, e não para ajudar usuários, muitas vezes em grandes volumes de material pouco original com pouco ou nenhum valor. O uso de IA não é o teste central.
Os equívocos mais comuns ficam assim:
| Pergunta | Resposta do Google |
|---|---|
| O Google proíbe conteúdo com IA? | Não. O uso adequado de IA não viola as diretrizes. |
| Conteúdo com IA ranqueia melhor automaticamente? | Não. A IA não tem vantagem especial. |
| Conteúdo com IA é penalizado automaticamente? | Não. O risco é produzir em escala principalmente para manipular rankings, e não para ajudar. |
O alerta não é “você usou IA”, mas “como usou”. A IA pode apoiar pesquisa de temas, estrutura de material original e melhoria da redação. O risco surge quando muitas páginas são geradas para conquistar posições, com quase nenhum valor real para usuários.
Scaled content abuse: avaliar escala, finalidade e valor juntos
A March 2024 Core Update introduziu novas spam policies. Scaled content abuse ampliou a antiga política de automatically-generated content. O anúncio do Google de março de 2024 deixou claro que conteúdo de baixo valor em escala pode vir de automação, trabalho humano ou fluxo híbrido.
Portanto, páginas reformuladas por pessoas também podem violar a política. A ferramenta não importa; três dimensões devem ser avaliadas:
- Many pages: o fluxo produz páginas em grande escala?
- Primary purpose of manipulating rankings: manipular rankings é o objetivo principal?
- Little or no value to users: as páginas carecem de originalidade e valor?
A definição formal do Google reúne muitas páginas geradas, a finalidade principal de manipular rankings e a falta de ajuda aos usuários. Pouca originalidade e pouco ou nenhum valor são características típicas. Não transforme isso em uma saída mecânica na qual publicar menos páginas ou incluir um parágrafo único garanta conformidade.
Páginas separadas para recursos diferentes de um produto podem ser úteis se cada uma trouxer diferenças reais e ajudar a entender o recurso. O volume sozinho não as transforma em spam. Já 1.000 páginas que apenas variam uma palavra-chave, existem para cobrir buscas long tail e quase não ajudam reproduzem o padrão de scaled content abuse.
Comparação das três dimensões:
| Dimensão | Padrão de alto risco | Padrão mais seguro |
|---|---|---|
| Many pages | Um conjunto grande de páginas quase idênticas é publicado junto | A quantidade segue produtos, dados ou necessidades reais |
| Primary purpose | Manipular rankings ou respostas generativas | Ajudar um público definido a concluir uma tarefa |
| Little/no value | Apenas palavras-chave ou variáveis mudam | Cada página tem diferenças verificáveis e valor original |
Use esta lista:
✓ A finalidade principal é ajudar usuários, não manipular rankings
✓ Cada página oferece valor real, não apenas uma variação de palavra-chave
✓ O conteúdo adiciona algo original, em vez de apenas reescrever ou traduzir
→ Publicação sustentável em escala

✗ A finalidade principal é manipular rankings
✗ As páginas oferecem pouco ou nenhum valor
✗ Páginas sem diferenças são geradas em massa
→ Risco de scaled content abuse
A pergunta central não é se a publicação pode ser automatizada, mas se cada página resultante tem uma diferença real e um motivo para existir. Escalar a partir de dados e necessidades genuínas, com contribuição original em cada página, reduz o risco. Variações superficiais para cobrir mais palavras-chave repetem o padrão de spam.
Autoavaliação de conteúdo people-first
O documento do Google Creating helpful, reliable, people-first content organiza a autoavaliação em Who, How e Why. São perguntas para criadores, não notas para um algoritmo. Antes da publicação, ajudam a saber se uma página realmente serve às pessoas.

Who: para quem é o conteúdo?
- Existe um público definido ou a página tenta falar com todos?
- Ela mostra experiência direta ou conhecimento, ou apenas resume opiniões alheias?
- O leitor consegue aprender ou concluir uma tarefa, ou sai sem resultado?
- Ele sente que o texto foi escrito para sua situação ou que é apenas outro artigo intercambiável?
How: como foi produzido?
- Uma pessoa revisou e verificou?
- Fontes e autor estão claramente identificados ou ambos são desconhecidos?
- O conteúdo é preciso, completo e útil, ou tem erros e omissões visíveis?
- Há sinais de automação, como formato uniforme com pouca substância?
Why: por que existe?
- A finalidade principal é ajudar ou manipular rankings?
- Foi criado só para seguir uma tendência ou palavra-chave, ou há algo relevante para explicar?
- Foi escrito para atingir uma contagem de palavras, em vez de resolver um problema?
O Google também lista sinais de search engine-first content:
- Publicar sobre muitos temas sem foco claro
- Usar automação ampla sem revisão individual
- Resumir principalmente material alheio sem acrescentar ideias próprias
- Perseguir tendências e palavras-chave em vez de problemas reais
- Escrever para uma contagem de palavras, não para gerar valor
- Alterar a data sem atualização substancial para parecer recente
O contraste:
| Dimensão | People-First | Search Engine-First |
|---|---|---|
| Who | Público definido e experiência direta | Público pouco claro e resumos de outros conteúdos |
| How | Revisão humana e fontes claras | Automação ampla sem evidência de revisão |
| Why | Resolver um problema do usuário | Manipular rankings e perseguir palavras-chave |
Não é necessário pontuar cada artigo. As perguntas funcionam como controle final. Se Who, How e Why apontam para search engine-first, o conteúdo pode ter desempenho ruim mesmo sem cruzar claramente uma linha de spam.
Como conteúdo com IA pode demonstrar E-E-A-T
E-E-A-T significa Experience, Expertise, Authoritativeness e Trustworthiness, termos das Search Quality Rater Guidelines do Google. Primeiro é preciso remover uma confusão: E-E-A-T não é, por si só, um fator direto de ranking.
O Google diz explicitamente que E-E-A-T não é um specific ranking factor. Seus sistemas usam uma combinação de fatores para reconhecer essas qualidades, mas não existe uma pontuação única para otimizar. As Rater Guidelines orientam avaliadores; suas avaliações não alteram rankings diretamente, mas ajudam o Google a avaliar e melhorar seus sistemas.
E-E-A-T continua sendo um modelo útil de qualidade. Um fluxo editorial pode verificar se existem os sinais esperados pelos leitores. Em conteúdo assistido por IA, a pergunta prática é como preservar evidências deles.
Experience
Conteúdo com IA pode mostrar uso real? Um modelo consegue explicar princípios técnicos, mas não inventar experiência direta confiável. É preciso acrescentar casos reais, tentativas que falharam e problemas encontrados. Em um artigo sobre implantação com Docker, a IA pode preparar os passos, mas o incidente de produção e a investigação que o resolveu devem vir de quem os viveu.
Controle: há experiência direta? O texto inclui um caso real ou uma análise de falha?
Expertise
A especialização vem do histórico do autor, de evidências primárias e da profundidade técnica. A IA pode organizar detalhes, mas a página deve indicar quem os verificou e quais materiais confiáveis os sustentam. Uma explicação sobre Cloudflare Workers ainda precisa de documentação oficial ou testes e de uma pessoa responsável.
Controle: author_reviewed_by está preenchido? Há fontes confiáveis? Existe análise técnica?
Authoritativeness
A autoridade se constrói com recomendações de outros sites e reconhecimento de colegas. Um único artigo não consegue fabricá-la. Práticas reproduzíveis, argumentos originais, perspectivas distintas e dados reais podem conquistar links de qualidade.
Controle: outros sites recomendam o trabalho? A prática é reproduzível? Vale a pena recomendar o conteúdo?
Trustworthiness
A confiança vem de fontes claras, informações do autor e histórico de atualizações. É a parte mais simples de implementar. sources, last_updated e author_reviewed_by mostram que o conteúdo foi revisado, que as evidências estão acessíveis e que alguém responde por ele. O documento people-first do Google também afirma que trust é o aspecto mais importante de E-E-A-T.
Controle: sources está preenchido? last_updated é mantido? author_reviewed_by está identificado?
As quatro dimensões em uma tabela operacional:
| Dimensão | Como demonstrar com IA | Controle |
|---|---|---|
| Experience | Adicionar uso real e casos vividos | Há experiência direta? |
| Expertise | Identificar o autor e usar evidências confiáveis | author_reviewed_by está preenchido? |
| Authoritativeness | Obter links e reconhecimento | Outros sites recomendam o trabalho? |
| Trustworthiness | Mostrar fontes, responsabilidade e atualizações | sources e last_updated estão presentes? |
Equívocos frequentes:

- Equívoco 1: E-E-A-T pode ser otimizado como uma pontuação numérica
- Equívoco 2: E-E-A-T é um único fator direto de ranking
- Equívoco 3: conteúdo com IA nunca consegue demonstrar E-E-A-T
- Leitura correta: E-E-A-T é um modelo de qualidade; revisão humana, fontes e contribuição original permitem demonstrá-lo em conteúdo assistido por IA
Divulgação e transparência do conteúdo assistido por IA
O Google exige uma declaração sobre IA? Não em todas as páginas. A FAQ pública não exige um rótulo fixo de “gerado por IA” para todo conteúdo. Ela recomenda contexto quando o leitor puder querer saber como o material foi produzido: como a automação foi usada, de onde vieram as evidências e quem revisou o resultado.
A transparência tem quatro partes:
- Informação do autor: quem escreveu ou revisou?
- Fontes: quais documentos, dados e casos sustentam o conteúdo?
- Histórico: quando ocorreu a última atualização substancial?
- Uso de IA: em quais fases ela foi usada, como pesquisa, estrutura, rascunho ou edição?
Esses elementos não exigem um parágrafo padrão no começo de cada artigo. Podem aparecer nos metadados, em um painel de autor, na barra lateral ou em uma página de metodologia. Autor, lista de fontes e data de atualização já oferecem contexto importante.
Algumas áreas justificam uma explicação mais clara. Medicina, finanças e direito criam expectativas maiores de evidência e precisão. Deve ficar claro se um profissional revisou o conteúdo e como a IA participou. Um artigo fiscal pode citar documentação oficial do IRS, a revisão de um especialista e o uso de IA limitado à organização e à redação.
Páginas programáticas também precisam explicar sua lógica de geração. Um site com muitas páginas de produtos ou cidades pode documentar fonte de dados, processo e diferenças reais. Dizer que uma página usa dados autênticos e informações específicas do local a diferencia de uma simples troca de variável.
O princípio não é impor o mesmo modelo em todos os lugares. Transparência significa permitir que o leitor entenda evidências, revisor, método de produção e status de atualização.
Riscos de tradução em massa, reescrita e SEO programático
Sites costumam traduzir em massa, reescrever material existente ou gerar páginas de forma programática. Nenhuma operação é uma infração por natureza. A decisão depende de primary purpose e added value.
Tradução em massa
Uso mais seguro: traduzir conteúdo que as pessoas realmente precisam, como documentação de produto ou tutoriais técnicos. Preservar o valor do original, não resumir demais e localizar terminologia, expressão e intenção de busca, em vez de publicar tradução automática sem revisão.
Uso de risco: publicar sem revisão com erros gramaticais ou culturais; traduzir uma página de baixo valor para muitos idiomas apenas para cobrir palavras-chave; criar versões sem evidência de demanda ou controle humano.
Pergunta: o público precisa dessa versão? Ela preserva o valor do original? Foi realmente localizada?
Reescrita e substituição de sinônimos
Uso mais seguro: acrescentar ideias originais, experiência prática, novos dados ou casos. Reorganizar para um público realmente diferente, em vez de apenas trocar palavras.
Uso de risco: modificar algumas palavras de um artigo alheio para evitar detecção de duplicação; produzir quase o mesmo texto sem valor adicional; reformular páginas internas em massa apenas para capturar outras palavras-chave.
Pergunta: que valor novo a versão acrescenta? Inclui uma ideia ou caso original? Destina-se realmente a outro público?
SEO programático
Uso mais seguro: usar dados reais para que cada produto ou local tenha diferenças verificáveis. Cada página atende a uma intenção específica e tem motivo para existir separadamente.
Uso de risco: substituir apenas cidade, produto ou palavra-chave em um modelo; gerar muitas variações long tail sem diferenças materiais; extrair, combinar ou traduzir outras páginas sem acrescentar valor.
Pergunta: cada página tem uma diferença real? Usuários precisam de uma página separada? Ela atende a uma intenção específica?
Comparação:
| Operação | Limite mais seguro | Limite de risco |
|---|---|---|
| Tradução em massa | Demanda real, valor preservado, boa localização | Automática sem revisão, cobertura de palavras-chave, fonte fraca |
| Reescrita | Ideias próprias, outro público, novos dados | Evitar duplicação, sem valor, paráfrases em massa |
| SEO programático | Dados reais, diferenças úteis, intenção clara | Preenchimento de modelo, long tail, páginas quase idênticas |
O teste central combina primary purpose e added value. Três perguntas:
- A finalidade principal é ajudar ou manipular rankings?
- Cada página acrescenta valor real ou apenas diferença superficial?
- Os usuários realmente precisam dessas páginas ou a demanda é apenas presumida?
Se as três respostas têm evidências, a operação tem mais chance de ser sustentável. Se finalidade, valor ou necessidade não podem ser defendidos, o risco deve ser reavaliado.
Novo risco de AI Search e fan-out queries
A busca com IA cria outra tentação. As AI features e a busca generativa do Google podem decompor uma pergunta em várias buscas relacionadas, chamadas fan-out queries. Uma pergunta sobre desempenho do Docker pode abrir buscas sobre otimização, limites de recursos e ferramentas de monitoramento.
Alguns sites criam uma página separada para cada variação. Isso pode parecer cobertura cuidadosa de palavras-chave, mas se transformar em scaled content abuse.
O guia atual do Google para busca generativa alerta explicitamente para não criar muitas páginas para cada variação ou fan-out query. Se o objetivo principal for manipular rankings ou respostas generativas do Google Search, a prática viola a política de scaled content abuse.
Uma abordagem mais sustentável responde às perguntas relacionadas em uma só página. Um guia de desempenho do Docker pode reunir otimização, limites de recursos e monitoramento para que o usuário conclua a tarefa em um único lugar.
AI Search e GEO exigem uma estratégia mais ampla, que será tratada separadamente. A regra imediata é não gerar páginas de baixo valor em massa apenas para cobrir cada variação.
Campos de controle de qualidade para um pipeline de conteúdo com IA
O último passo transforma os princípios do Google em campos que um quadro editorial pode exigir. Cada campo registra um sinal de qualidade e deve ser preenchido antes da publicação.
Definição dos campos
| Campo | Finalidade | Obrigatório/opcional | Princípio do Google |
|---|---|---|---|
| sources | Links para todas as evidências usadas | Obrigatório | Trustworthiness, Expertise |
| author_reviewed_by | Identidade do autor ou revisor | Obrigatório | Expertise, Accountability |
| original_increment | Valor original adicionado, como análise, dados ou caso | Obrigatório | People-first, Added value |
| human_qa_status | Estado da revisão humana: rascunho, em revisão, aprovado | Obrigatório | How, Trustworthiness |
| gsc_feedback | Feedback de consultas e páginas do GSC após publicar | Opcional | Why, melhoria contínua |
| last_updated | Data da última atualização substancial | Obrigatório | Freshness, Trustworthiness |
| ai_usage | Fases com IA: pesquisa, estrutura, rascunho ou edição | Opcional | Transparency |
Controle de publicação
Antes de publicar, exija:
- sources não está vazio: pelo menos três itens confiáveis, como documentação oficial, publicação reconhecida ou teste prático
- author_reviewed_by está preenchido: uma pessoa específica assume a revisão
- original_increment menciona pelo menos uma ideia, um caso ou um dado original
- human_qa_status passa de “em revisão” para “aprovado” após o controle humano
- last_updated registra a data dessa revisão ou alteração substancial
Exemplo aprovado:
sources: ["https://developers.google.com/search/docs/fundamentals/using-gen-ai-content",
          "https://developers.google.com/search/docs/essentials/spam-policies",
          "https://developers.google.com/search/blog/2023/02/google-search-and-ai-content"]
author_reviewed_by: "Jane Zhang (editora do blog técnico)"
original_increment: "análise de políticas do Google + modelo de três eixos + desenho dos campos de controle"
human_qa_status: "aprovado"
last_updated: "2026-07-26"
ai_usage: "pesquisa, estrutura e melhoria do rascunho"
Exemplo de risco:
sources: []
author_reviewed_by: ""
original_increment: ""
human_qa_status: "rascunho" → publicar diretamente
last_updated: ""
ai_usage: "geração completa sem revisão"
Controles por fase
| Fase | Campos obrigatórios | Controle |
|---|---|---|
| Pesquisa | sources | Pelo menos três fontes confiáveis |
| Redação | original_increment | Pelo menos uma ideia, um caso ou um dado original |
| Revisão | author_reviewed_by, human_qa_status | Revisor registrado e estado “aprovado” |
| Depois da publicação | gsc_feedback, last_updated | Feedback do GSC registrado e data ligada a mudança substancial |
Esses campos não são requisitos diretos do Google. São uma prática operacional derivada dos princípios people-first. Os nomes podem variar, mas a lógica continua: cada artigo precisa de fontes, revisor responsável, valor original, aprovação humana e histórico de atualização mantido.
Conclusão
A IA em um fluxo editorial não é a infração. O risco é publicar conteúdo de baixo valor em escala para manipular rankings. Três perguntas decidem: a finalidade principal é ajudar? Cada página acrescenta valor real? Os usuários realmente precisam dela?
Antes de publicar em massa, revise o quadro. sources, author_reviewed_by e original_increment estão completos? O artigo passou pelo controle? Evidências, uma pessoa responsável e contribuição original devem existir antes da publicação.
Outro artigo aprofundará AI Search e GEO. O objetivo será tornar o conteúdo compreensível e citável pela busca com IA, em vez de gerar páginas fracas para cada variação de consulta.
Criar um controle mínimo de qualidade para conteúdo com IA
Da escolha do tema à revisão após a publicação, cada artigo mantém provas de valor para o usuário, base factual e responsabilidade humana.
- 1
Step 1: Definir o leitor e o limite temático
Indique quem se beneficia e qual problema o artigo resolve. Não entre em uma área desconhecida apenas por causa de tráfego potencial. - 2
Step 2: Verificar sobreposição interna
Pesquise conteúdo existente antes da apuração e decida criar, atualizar, mesclar ou interromper, em vez de produzir uma página quase duplicada. - 3
Step 3: Manter fontes primárias
Registre evidências oficiais ou diretas e datas de consulta para políticas, preços, versões e limites técnicos. - 4
Step 4: Definir a contribuição original
Documente o teste, a experiência, a análise, os dados ou o modelo de decisão acrescentado pelo artigo. Reformular material existente não basta. - 5
Step 5: Revisar fatos e apresentação
Confira fatos, exemplos, promessas do título, duplicação e sinais de automação, e adicione as verificações práticas necessárias. - 6
Step 6: Registrar responsabilidade humana
Salve revisor, fontes, uso de IA e notas de risco. Uma pessoa deve aprovar a publicação final. - 7
Step 7: Usar feedback real para atualizar
Use consultas e dados de página do GSC para decidir mudanças substanciais, em vez de alterar apenas a data ou o resumo.
FAQ
O Google penaliza automaticamente conteúdo gerado com IA?
O Google combate conteúdo com IA ou conteúdo de baixa qualidade em escala?
O que é scaled content abuse?
Um blog técnico assistido por IA ainda pode fazer SEO?
Tradução em massa e SEO programático sempre violam as regras?
Todo artigo assistido por IA precisa declarar o uso de IA?
15 min de leitura · Publicado em: 13 nov 2026

Guia pratico de automacao de sites de conteudo com IA
Você está lendo o primeiro post desta série. Continue para o próximo ou abra o hub da série para ver toda a trilha.


Comentários
Entre com GitHub para comentar