
¿El contenido con IA aún sirve para SEO? Reglas de Google
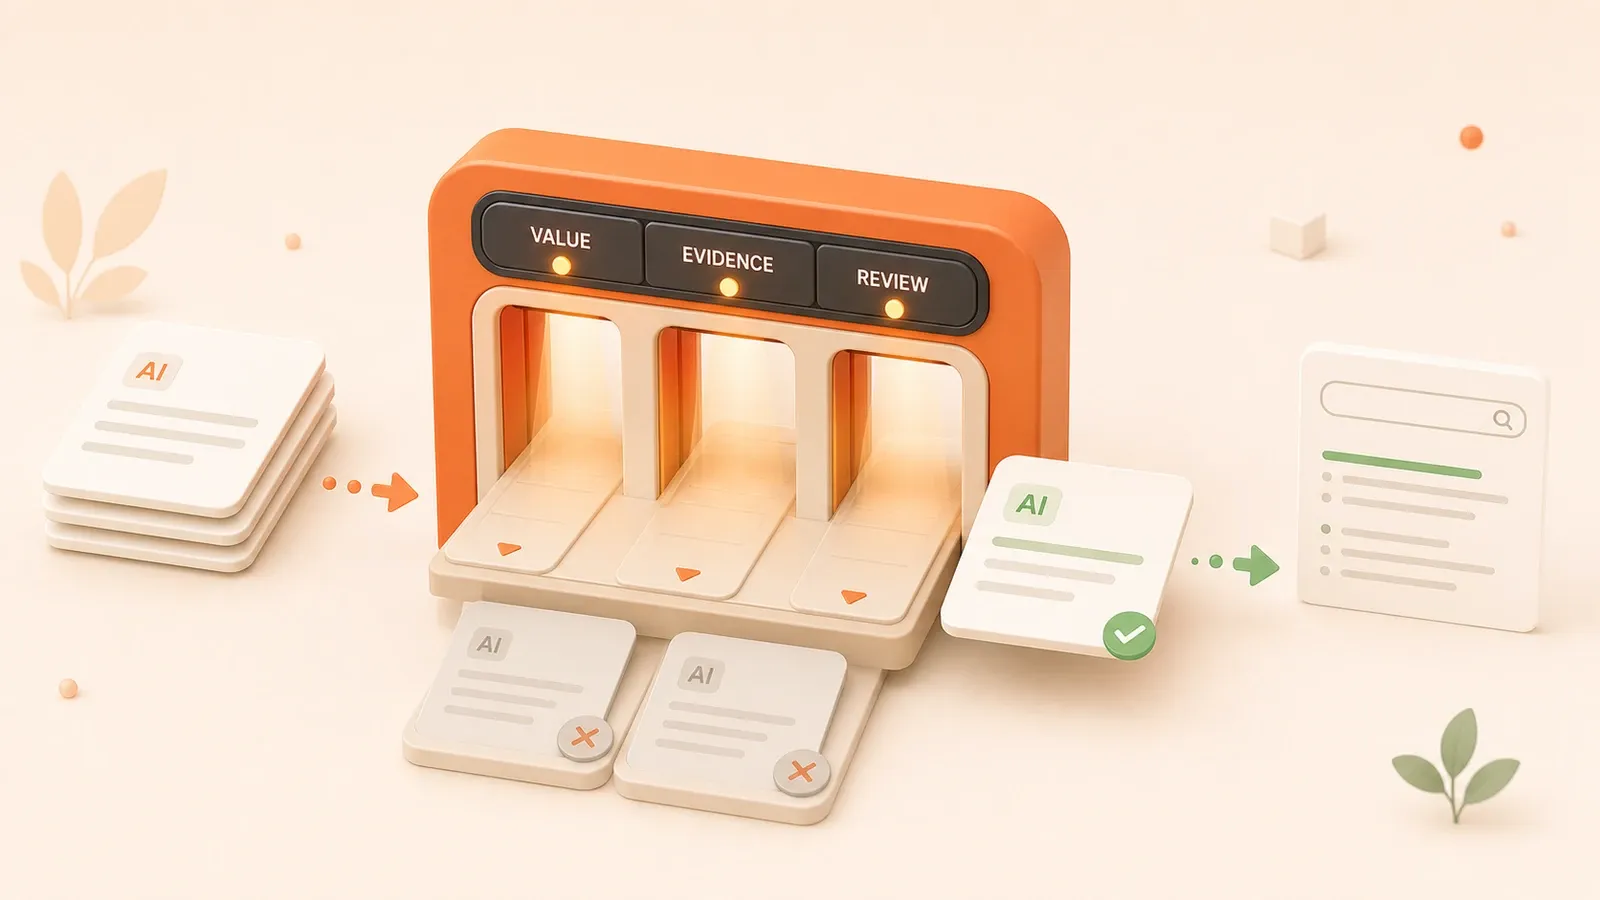
"La guía de Google sobre contenido con IA generativa dice que la IA puede apoyar la investigación y la estructura de contenido original, pero generar muchas páginas sin valor para los usuarios puede infringir la política de scaled content abuse."
Tu tablero editorial contiene 20 temas ya investigados y estás listo para generar todos los borradores de una vez. Sin embargo, después de otro titular sobre cómo Google «persigue el contenido con IA», el cursor se detiene sobre «Publicar en masa». ¿Es seguro hacer clic?
La documentación de Google permite responder tres preguntas: ¿es una infracción escribir con ayuda de IA? ¿Dónde está el límite de publicar a escala? ¿Cómo se aplica un control de calidad a cada artículo?
La posición de Google: la IA no es la infracción
En una publicación oficial de febrero de 2023, Google respondió de forma directa que el uso apropiado de IA o automatización no infringe sus directrices. La FAQ de Search Central resuelve la preocupación principal: la IA por sí sola no hace que un contenido incumpla las reglas.
El problema es el propósito. La misma publicación explica que usar automatización, incluida la IA, principalmente para manipular rankings de búsqueda infringe las spam policies. La herramienta no es el criterio decisivo; lo son la intención y el resultado. Si el contenido existe principalmente para ayudar a las personas y no para manipular el ranking, la escritura asistida por IA no está prohibida.
La IA tampoco recibe un privilegio de ranking. Google afirma que el contenido con IA no obtiene una ventaja especial. Un contenido útil, original y con aspectos de E-E-A-T puede rendir bien; uno débil puede no hacerlo. Un texto no sube ni recibe una sanción automática por usar IA. Su desempeño depende de que sea helpful, reliable y people-first.
Las spam policies actuales de Google trazan un límite más preciso: contenido producido a escala principalmente para manipular rankings en vez de ayudar a los usuarios, a menudo como grandes cantidades de material poco original con poco o ningún valor. El uso de IA no es la prueba central.
Las ideas equivocadas más comunes se resumen así:
| Pregunta | Respuesta de Google |
|---|---|
| ¿Google prohíbe el contenido con IA? | No. El uso apropiado de IA no infringe las directrices. |
| ¿El contenido con IA rankea mejor automáticamente? | No. La IA no tiene una ventaja especial. |
| ¿El contenido con IA recibe una penalización automática? | No. El riesgo es producir a escala principalmente para manipular rankings y no para ayudar. |
La advertencia no es «usaste IA», sino «cómo la usaste». La IA puede apoyar la investigación de temas, estructurar material original y mejorar la redacción. El riesgo surge cuando se generan muchas páginas para capturar rankings con muy poco valor real para los usuarios.
Scaled content abuse: evaluar escala, propósito y valor juntos
La March 2024 Core Update introdujo nuevas spam policies. El scaled content abuse amplió la antigua política de automatically-generated content. El anuncio de Google de marzo de 2024 dejó claro que el contenido de bajo valor a escala puede proceder de automatización, trabajo humano o un flujo mixto.
Por tanto, las páginas reformuladas por personas también pueden infringir la política. La herramienta no importa; hay que evaluar tres dimensiones:
- Many pages: ¿el flujo produce páginas a gran escala?
- Primary purpose of manipulating rankings: ¿manipular rankings es el objetivo principal?
- Little or no value to users: ¿las páginas carecen de originalidad y valor?
La definición formal de Google une muchas páginas generadas, el propósito principal de manipular rankings y la falta de ayuda a los usuarios. La poca originalidad y el valor escaso o nulo son características típicas. No debe convertirse en una salida mecánica donde publicar menos páginas o añadir un párrafo único garantice el cumplimiento.
Las páginas separadas para funciones distintas de un producto pueden ser útiles si cada una contiene diferencias reales y ayuda a comprender esa función. El volumen por sí solo no las convierte en spam. En cambio, 1.000 páginas que solo varían una palabra clave, existen para cubrir búsquedas long tail y apenas ayudan presentan el patrón de scaled content abuse.
Comparación de las tres dimensiones:
| Dimensión | Patrón de alto riesgo | Patrón más seguro |
|---|---|---|
| Many pages | Se publica un conjunto grande de páginas casi idénticas | El número responde a productos, datos o necesidades reales |
| Primary purpose | Manipular rankings o respuestas generativas | Ayudar a un público definido a completar una tarea |
| Little/no value | Solo cambian palabras clave o variables | Cada página tiene diferencias verificables y valor original |
Usa esta lista:
✓ El propósito principal es ayudar a los usuarios, no manipular rankings
✓ Cada página ofrece valor real, no solo una variante de palabra clave
✓ El contenido añade algo original, en lugar de limitarse a reescribir o traducir
→ Publicación sostenible a escala

✗ El propósito principal es manipular rankings
✗ Las páginas ofrecen poco o ningún valor
✗ Se generan páginas sin diferencias en masa
→ Riesgo de scaled content abuse
La pregunta central no es si la publicación puede automatizarse, sino si cada página resultante tiene una diferencia real y una razón para existir. Escalar a partir de datos y necesidades genuinas, con aporte original en cada página, reduce el riesgo. Las variantes superficiales para cubrir más palabras clave reproducen el patrón de spam.
Autoevaluación de contenido people-first
El documento de Google Creating helpful, reliable, people-first content organiza la autoevaluación en Who, How y Why. Son preguntas para creadores, no puntuaciones para un algoritmo. Antes de publicar ayudan a saber si una página sirve de verdad a las personas.
Who: ¿para quién es el contenido?
- ¿Existe un público definido o la página intenta dirigirse a todos?
- ¿Muestra experiencia directa o conocimiento, o solo resume opiniones ajenas?
- ¿El lector puede aprender o completar una tarea, o se marcha sin resultado?
- ¿Sentirá que el texto se escribió para su situación o que es otro artículo intercambiable?
How: ¿cómo se produjo?
- ¿Una persona lo revisó y verificó?
- ¿Las fuentes y el autor están claramente identificados o ambos son desconocidos?
- ¿Es preciso, completo y útil, o tiene errores y omisiones visibles?
- ¿Muestra rastros de automatización, como una forma uniforme con poco contenido?
Why: ¿por qué existe?
- ¿Su propósito principal es ayudar o manipular rankings?
- ¿Se creó solo para seguir una tendencia o palabra clave, o hay algo relevante que explicar?
- ¿Se escribió para alcanzar una cantidad de palabras en vez de resolver un problema?
Google también enumera señales de search engine-first content:
- Publicar sobre muchos temas sin un enfoque claro
- Usar automatización extensa sin revisión individual
- Resumir principalmente material ajeno sin añadir ideas propias
- Perseguir tendencias y palabras clave en lugar de problemas reales
- Escribir para una cantidad de palabras y no para el valor
- Cambiar la fecha sin una actualización sustancial para parecer reciente
El contraste:
| Dimensión | People-First | Search Engine-First |
|---|---|---|
| Who | Público definido y experiencia directa | Público poco claro y resúmenes de otros contenidos |
| How | Revisión humana y fuentes claras | Automatización amplia sin pruebas de revisión |
| Why | Resolver un problema del usuario | Manipular rankings y perseguir palabras clave |
No hace falta puntuar cada artículo. Las preguntas funcionan como control final. Si Who, How y Why se inclinan hacia search engine-first, el contenido puede rendir mal aunque no cruce claramente una línea de spam.
Cómo puede demostrar E-E-A-T el contenido con IA
E-E-A-T significa Experience, Expertise, Authoritativeness y Trustworthiness, términos de las Search Quality Rater Guidelines de Google. Primero hay que eliminar una confusión: E-E-A-T no es por sí mismo un factor de ranking directo.
Google dice de forma explícita que E-E-A-T no es un specific ranking factor. Sus sistemas usan una combinación de factores para reconocer estas cualidades, pero no hay una puntuación única que optimizar. Las Rater Guidelines guían a los evaluadores; sus valoraciones no cambian directamente rankings, sino que ayudan a Google a evaluar y mejorar sus sistemas.
E-E-A-T sigue siendo un marco de calidad útil. Un flujo editorial puede comprobar si existen las señales que esperan los lectores. En contenido asistido por IA, la pregunta práctica es cómo conservar pruebas de ellas.
Experience
¿Puede el contenido con IA mostrar uso real? Un modelo puede explicar principios técnicos, pero no inventar experiencia directa creíble. Hay que añadir casos reales, intentos fallidos y problemas encontrados. En un artículo sobre despliegue de Docker, la IA puede preparar los pasos, pero el problema de producción y la investigación que lo resolvió deben venir de quien los vivió.
Control: ¿hay experiencia directa? ¿Incluye un caso real o un análisis de fallo?
Expertise
La experiencia profesional procede del perfil del autor, las pruebas primarias y la profundidad técnica. La IA puede ordenar detalles, pero la página debe indicar quién los verificó y qué material autorizado los respalda. Una explicación sobre Cloudflare Workers todavía necesita documentación oficial o resultados de pruebas y una persona responsable.
Control: ¿author_reviewed_by está completo? ¿Hay fuentes autorizadas? ¿Existe análisis técnico?
Authoritativeness
La autoridad se construye con recomendaciones de otros sitios y reconocimiento de colegas. Un solo artículo no puede fabricarla. Las prácticas reproducibles, argumentos originales, perspectivas distintas y datos reales pueden merecer enlaces de calidad.
Control: ¿otros sitios recomiendan el trabajo? ¿La práctica es reproducible? ¿Vale la pena recomendar el contenido?
Trustworthiness
La confianza procede de fuentes claras, información del autor e historial de actualizaciones. Es la parte más fácil de implementar. sources, last_updated y author_reviewed_by muestran que el contenido fue revisado, que las pruebas son accesibles y que alguien responde por él. El documento people-first de Google también señala que trust es el aspecto más importante de E-E-A-T.
Control: ¿sources está completo? ¿se mantiene last_updated? ¿se identifica author_reviewed_by?
Las cuatro dimensiones en una tabla operativa:
| Dimensión | Cómo demostrarla con IA | Control |
|---|---|---|
| Experience | Añadir uso real y casos vividos | ¿Hay experiencia directa? |
| Expertise | Identificar al autor y usar pruebas autorizadas | ¿author_reviewed_by está completo? |
| Authoritativeness | Obtener enlaces y reconocimiento | ¿Otros sitios recomiendan el trabajo? |
| Trustworthiness | Mostrar fuentes, responsabilidad y actualizaciones | ¿sources y last_updated están presentes? |
Ideas equivocadas frecuentes:

- Error 1: E-E-A-T se puede optimizar como una puntuación numérica
- Error 2: E-E-A-T es un único factor de ranking directo
- Error 3: el contenido con IA nunca puede demostrar E-E-A-T
- Lectura correcta: E-E-A-T es un marco de calidad; la revisión humana, las fuentes y el aporte original permiten demostrarlo en contenido asistido por IA
Divulgación y transparencia del contenido asistido por IA
¿Google exige una declaración de IA? No en todas las páginas. La FAQ pública no requiere una etiqueta fija de «generado por IA» para todo el contenido. Sí recomienda dar contexto cuando el lector pueda querer saber cómo se produjo: cómo se usó la automatización, de dónde salieron las pruebas y quién revisó el resultado.
La transparencia tiene cuatro partes:
- Información del autor: ¿quién escribió o revisó?
- Fuentes: ¿qué documentos, datos y casos respaldan el contenido?
- Historial: ¿cuándo se actualizó sustancialmente por última vez?
- Uso de IA: ¿en qué fases se usó, como investigación, estructura, borrador o edición?
Estos elementos no exigen un párrafo estándar al comienzo de cada artículo. Pueden aparecer en metadatos, un panel de autor, una barra lateral o una página de metodología. Autor, lista de fuentes y fecha de actualización ya aportan contexto importante.
Algunos campos justifican una explicación más clara. Medicina, finanzas y derecho crean expectativas más altas sobre pruebas y precisión. Debe indicarse si un profesional revisó el contenido y cómo participó la IA. Un artículo fiscal puede citar documentación oficial del IRS, la revisión de un especialista y un uso de IA limitado a organizar información y mejorar el texto.
Las páginas programáticas también necesitan explicar su lógica de generación. Un sitio con muchas páginas de productos o ciudades puede documentar la fuente de datos, el proceso y las diferencias reales. Indicar que una página usa datos auténticos e información específica del lugar la distingue de un simple cambio de variable.
El principio no es imponer la misma plantilla en todas partes. Transparencia significa que el lector pueda entender las pruebas, el revisor, el método de producción y el estado de actualización.
Riesgos de traducción masiva, reescritura y SEO programático
Los sitios suelen traducir en masa, reescribir material existente o generar páginas programáticamente. Ninguna operación es una infracción por naturaleza. La decisión depende de primary purpose y added value.
Traducción masiva
Uso más seguro: traducir contenido que las personas realmente necesitan, como documentación de producto o tutoriales técnicos. Conservar el valor original, no resumir en exceso y localizar terminología, expresión e intención de búsqueda, en vez de publicar una traducción automática sin revisión.
Uso de riesgo: publicar sin revisión con errores gramaticales o culturales; traducir una página de bajo valor a muchos idiomas solo para cubrir palabras clave; crear versiones sin pruebas de demanda ni control humano.
Pregunta: ¿el público necesita esta versión? ¿conserva el valor del original? ¿se localizó de verdad?
Reescritura y sustitución de sinónimos
Uso más seguro: añadir ideas originales, experiencia práctica, nuevos datos o casos. Reorganizar para un público realmente distinto en lugar de cambiar solo las palabras.
Uso de riesgo: modificar unas palabras de un artículo ajeno para evitar la detección de duplicados; producir casi el mismo texto sin valor añadido; reformular páginas internas en masa solo para captar otras palabras clave.
Pregunta: ¿qué valor nuevo añade? ¿incluye una idea o un caso original? ¿se dirige de verdad a otro público?
SEO programático
Uso más seguro: usar datos reales para que cada producto o lugar tenga diferencias verificables. Cada página satisface una intención concreta y tiene una razón para existir por separado.
Uso de riesgo: sustituir solo una ciudad, producto o palabra clave en una plantilla; generar muchas variantes long tail sin diferencias materiales; extraer, combinar o traducir otras páginas sin aportar valor.
Pregunta: ¿cada página tiene una diferencia real? ¿los usuarios necesitan una página separada? ¿satisface una intención concreta?
Comparación:
| Operación | Límite más seguro | Límite de riesgo |
|---|---|---|
| Traducción masiva | Demanda real, valor conservado, buena localización | Automática sin revisar, cobertura de palabras clave, fuente débil |
| Reescritura | Ideas propias, otro público, nuevos datos | Evitar duplicados, sin valor, paráfrasis masivas |
| SEO programático | Datos reales, diferencias útiles, intención clara | Relleno de plantilla, long tail, páginas casi idénticas |
La prueba central combina primary purpose y added value. Tres preguntas:
- ¿El propósito principal es ayudar o manipular rankings?
- ¿Cada página añade valor real o solo una diferencia superficial?
- ¿Los usuarios necesitan de verdad estas páginas o la demanda es una suposición?
Si las tres respuestas se apoyan en pruebas, la operación tiene más posibilidades de ser sostenible. Si no se pueden defender el propósito, el valor o la necesidad, hay que reevaluar el riesgo.

Nuevo riesgo de AI Search y las fan-out queries
La búsqueda con IA crea otra tentación. Las AI features y la búsqueda generativa de Google pueden descomponer una pregunta en varias búsquedas relacionadas, llamadas fan-out queries. Una pregunta sobre rendimiento de Docker puede abrir búsquedas sobre optimización, límites de recursos y herramientas de monitorización.
Algunos sitios crean una página separada para cada variante. Puede parecer una cobertura metódica de palabras clave, pero convertirse en scaled content abuse.
La guía actual de Google para búsqueda generativa advierte expresamente que no se deben crear muchas páginas para cada variante o fan-out query. Si el objetivo principal es manipular rankings o respuestas generativas de Google Search, la práctica infringe la política de scaled content abuse.
Un enfoque más sostenible responde las preguntas relacionadas en una sola página. Una guía de rendimiento de Docker puede reunir optimización, límites de recursos y monitorización para que el usuario complete la tarea en un solo lugar.
AI Search y GEO necesitan una estrategia más amplia que se tratará por separado. La regla inmediata es no generar páginas de bajo valor en masa solo para cubrir cada variante.
Campos de control de calidad para un pipeline de contenido con IA
El último paso convierte los principios de Google en campos que un tablero editorial puede exigir. Cada campo registra una señal de calidad y debe completarse antes de publicar.
Definición de campos
| Campo | Propósito | Obligatorio/opcional | Principio de Google |
|---|---|---|---|
| sources | Enlaces a todas las pruebas usadas | Obligatorio | Trustworthiness, Expertise |
| author_reviewed_by | Identidad del autor o revisor | Obligatorio | Expertise, Accountability |
| original_increment | Valor original añadido, como análisis, datos o un caso | Obligatorio | People-first, Added value |
| human_qa_status | Estado de revisión humana: borrador, en revisión, aprobado | Obligatorio | How, Trustworthiness |
| gsc_feedback | Comentarios de consultas y páginas de GSC tras publicar | Opcional | Why, mejora continua |
| last_updated | Fecha de la última actualización sustancial | Obligatorio | Freshness, Trustworthiness |
| ai_usage | Fases con IA: investigación, estructura, borrador o edición | Opcional | Transparency |
Control de publicación
Antes de publicar, exige lo siguiente:
- sources no está vacío: al menos tres elementos confiables, como documentación oficial, una publicación autorizada o una prueba práctica
- author_reviewed_by está completo: una persona concreta asume la revisión
- original_increment menciona al menos una idea, un caso o un dato original
- human_qa_status pasa de «en revisión» a «aprobado» después del control humano
- last_updated registra la fecha de esa revisión o modificación sustancial
Ejemplo aprobado:
sources: ["https://developers.google.com/search/docs/fundamentals/using-gen-ai-content",
          "https://developers.google.com/search/docs/essentials/spam-policies",
          "https://developers.google.com/search/blog/2023/02/google-search-and-ai-content"]
author_reviewed_by: "Jane Zhang (editora del blog técnico)"
original_increment: "análisis de políticas de Google + modelo de tres ejes + diseño de campos de control"
human_qa_status: "aprobado"
last_updated: "2026-07-26"
ai_usage: "investigación, estructura y mejora del borrador"
Ejemplo de riesgo:
sources: []
author_reviewed_by: ""
original_increment: ""
human_qa_status: "borrador" → publicar directamente
last_updated: ""
ai_usage: "generación completa sin revisión"
Controles por fase
| Fase | Campos obligatorios | Control |
|---|---|---|
| Investigación | sources | Al menos tres fuentes confiables |
| Redacción | original_increment | Al menos una idea, un caso o un dato original |
| Revisión | author_reviewed_by, human_qa_status | Revisor registrado y estado «aprobado» |
| Después de publicar | gsc_feedback, last_updated | Comentarios de GSC registrados y fecha ligada a un cambio sustancial |
Estos campos no son requisitos directos de Google. Son una práctica operativa derivada de los principios people-first. Los nombres pueden variar, pero la lógica se mantiene: cada artículo necesita fuentes, un revisor responsable, valor original, aprobación humana y un historial de actualización mantenido.
Conclusión
La IA dentro de un flujo editorial no es la infracción. El riesgo es publicar contenido de bajo valor a escala para manipular rankings. Tres preguntas deciden: ¿el propósito principal es ayudar? ¿cada página añade valor real? ¿los usuarios necesitan de verdad esa página?
Antes de publicar en masa, revisa el tablero. ¿sources, author_reviewed_by y original_increment están completos? ¿el artículo superó su control? Las pruebas, una persona responsable y un aporte original deben existir antes de publicar.
Otro artículo profundizará en AI Search y GEO. El objetivo será hacer que el contenido sea comprensible y citable para la búsqueda con IA, no generar páginas débiles para cada variante de consulta.
Crear un control mínimo de calidad para contenido con IA
Desde la selección del tema hasta la revisión posterior, cada artículo conserva pruebas de valor para el usuario, base factual y responsabilidad humana.
- 1
Step 1: Definir al lector y el límite temático
Indica quién se beneficia y qué problema resuelve el artículo. No entres en un campo desconocido solo por el tráfico potencial. - 2
Step 2: Comprobar solapamientos internos
Busca contenido existente antes de investigar y decide si crear, actualizar, fusionar o detener, en lugar de producir una página casi duplicada. - 3
Step 3: Conservar fuentes primarias
Registra evidencias oficiales o directas y sus fechas de consulta para políticas, precios, versiones y límites técnicos. - 4
Step 4: Definir el aporte original
Documenta la prueba, experiencia, análisis, datos o marco de decisión que añade el artículo. Reformular material existente no basta. - 5
Step 5: Revisar hechos y presentación
Comprueba hechos, ejemplos, promesas del título, duplicados y rastros de automatización, y añade las verificaciones prácticas necesarias. - 6
Step 6: Registrar la responsabilidad humana
Guarda el revisor, las fuentes, el uso de IA y las notas de riesgo. Una persona debe aprobar la publicación final. - 7
Step 7: Usar comentarios reales para actualizar
Utiliza consultas y datos de páginas de GSC para decidir cambios sustanciales, en vez de modificar solo la fecha o el resumen.
FAQ
¿Google penaliza automáticamente el contenido generado con IA?
¿Google está en contra del contenido con IA o del contenido de baja calidad a escala?
¿Qué es scaled content abuse?
¿Un blog técnico asistido por IA todavía puede hacer SEO?
¿La traducción masiva y el SEO programático siempre infringen las reglas?
¿Cada artículo asistido por IA debe declarar el uso de IA?
16 min de lectura · Publicado el: 13 nov 2026

Guia practica de automatizacion de sitios de contenido con IA
Estás leyendo el primer artículo de esta serie. Continúa con el siguiente o abre el hub para ver toda la ruta.
Anterior
Estás al inicio de esta serie.
Siguiente
Agente de IA para investigar temas: ideas de blog con Google, Reddit y GitHub
Convierte consultas de GSC, preguntas de Reddit e issues de GitHub en temas técnicos con niveles de evidencia, puntuación, deduplicación, riesgos y revisión humana.
Parte 2 de 4


Comentarios
Inicia sesión con GitHub para dejar un comentario