
Clustering de palabras clave con IA: de consultas a series y enlaces internos
"Google Search Central: crear contenido útil, fiable y centrado en las personas"
Tienes un archivo keywords.csv con 300 consultas sobre Astro, Docker y Cloudflare. La IA genera 42 clusters, pero la revisión manual encuentra astro seo y astro vs next.js for seo juntos en el cluster #1. La primera consulta busca un tutorial; la segunda, una comparación. Una sola página difícilmente resolverá ambas tareas.
Ese es el fallo práctico del clustering: la IA puede fusionar expresiones semánticamente cercanas que tienen intenciones distintas. Así aumenta el riesgo de canibalización, porque varios artículos casi iguales compiten por la misma demanda. Una lista de «grupos de palabras clave» tampoco dice cuáles deben convertirse en un artículo nuevo, una actualización, una FAQ o un enlace interno.
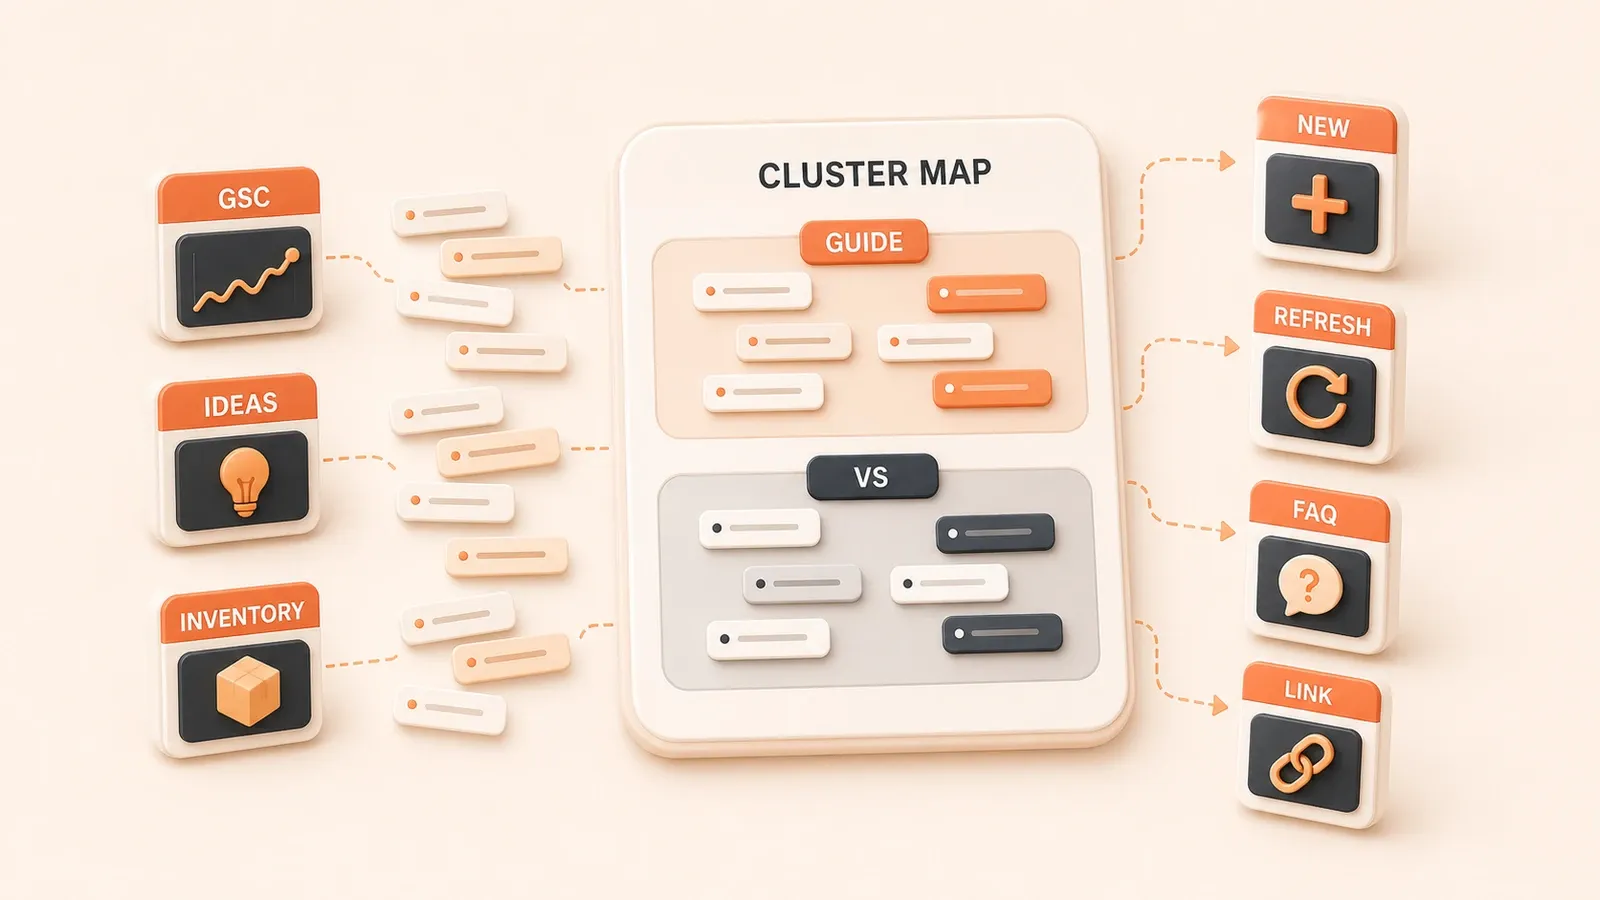
El flujo siguiente combina consultas de GSC, fichas de ideas e inventario del sitio. Normaliza y deduplica las filas, mantiene una revisión humana después del primer agrupamiento de la IA y asigna cada cluster a una acción: artículo nuevo, actualización, FAQ, enlace interno o discard. Los resultados incluyen fuentes, lógica de normalización, comparación de métodos, prompt, cluster map, marco de acciones y estructura de enlaces.
1. Reunir las fuentes correctas para el clustering
La entrada no es una lista inventada por la IA. Son datos query/page propios, fichas de ideas e inventario de contenidos. Juntos permiten ver qué temas merecen una página, cuáles ya tienen un artículo y qué preguntas proceden de comunidades reales.
La lista de fuentes queda así:
| Fuente | Campos | Cómo obtenerla | Atención |
|---|---|---|---|
| Datos GSC query/page | query, page, clicks, impressions, CTR, position | Search Console UI / Search Analytics API | El rowLimit de la API es 1.000 por defecto y 25.000 como máximo por solicitud; los límites internos hacen que devuelva top rows sin garantizar todas las filas |
| Fichas de ideas | título, intención, fuente (Reddit/GitHub/competidor), evidencia | Salida del agente de investigación | Revisar manualmente la calidad de la fuente |
| Inventario del sitio | título, URL, serie, fecha, tráfico, consultas posicionadas | Base del sitio / CMS | Marcar artículos coincidentes y serie |
| Métricas quickWins | consultas con muchas impresiones y CTR bajo, oportunidades de actualización | Análisis GSC quickWins | Apoyan la decisión de actualizar |
Pasos:
- Exportar datos query/page de GSC. El informe Performance muestra por defecto los últimos tres meses, aunque el periodo puede ajustarse.
- Añadir las fichas producidas por el agente de investigación.
- Extraer el inventario: artículos existentes, series y rendimiento.
- Marcar quick wins: muchas impresiones, CTR bajo y oportunidades de actualización.
- Generar una tabla con query, intención inicial, fuente, coincidencia con artículo existente y marca quickWins.
2. Normalizar las palabras clave antes de agruparlas
La tabla combinada contiene duplicados, variantes y diferencias de escritura. Si no se procesan, la IA puede considerarlos términos distintos y dividir una sola intención entre varios clusters.
Lista de deduplicación:

- Duplicado exacto:
astro seovsastro seo→ conservar una fila - Variantes de escritura o configuración:
docker host.docker.internalvsdocker host-gatewayvsdocker 127.0.0.1→ marcar como candidatos de la misma intención y esperar confirmación humana - Sinónimos:
cloudflare pricingvsprecio cloudflarevscloudflare cost→ marcar como una intención - Cambio de forma:
astro blogvsastro blogs→ marcar como una intención
Reglas de normalización:
- Unificar términos:
nextjs→next.js,cloudflare workers→Cloudflare Workers - Unificar mayúsculas:
Astrovsastro→astro - Unificar puntuación:
astro, seovsastro seo→astro seo
Etiquetas iniciales de intención:
- Informativa: how to, what is, guide, tutorial
- Navegacional: marca, producto, URL concreta
- Comparativa: vs, compare, alternative
- Transaccional: pricing, cost, buy, download
Pasos:
- Eliminar duplicados exactos de la tabla combinada.
- Detectar variantes y sinónimos, y marcarlos como candidatos de la misma intención.
- Normalizar términos, mayúsculas y puntuación.
- Etiquetar cada query como informativa, navegacional, comparativa o transaccional.
- Exportar una tabla con query, normalized_query, intent_tag, source y old_post_match.
3. Comparar tres métodos de clustering
La elección debe equilibrar costo, precisión y riesgo. Los tres enfoques principales encajan en etapas distintas.
| Método | Costo | Precisión | Escenario adecuado | Riesgo |
|---|---|---|---|---|
| SERP-based | Alto: muchas consultas SERP y posibles límites anti-bot | Alta: usa resultados reales y ayuda a decidir si unir páginas | Contenido publicado, análisis de solapamiento y presupuesto de SERP API | Costoso; los cambios de SERP reducen la estabilidad |
| Semantic | Bajo: solo llamadas a una API de embeddings | Media: puede ignorar la intención real y unir tareas distintas | Primer mapa temático, presupuesto limitado y agrupamiento rápido | Puede unir palabras próximas en significado pero distintas en intención |
| Hybrid | Medio: primer paso semántico + validación SERP/GSC + revisión humana | Alta: equilibra costo y precisión | Operación continua con datos de GSC y tiempo de revisión | Requiere capacidad de revisión humana |
Flujo recomendado:
- Equipo pequeño / etapa inicial: primer paso Semantic + validación GSC/page + revisión humana de clusters de riesgo
- Equipo mayor / contenido establecido: Hybrid con agrupamiento semántico, validación SERP/GSC y revisión humana
- Presupuesto suficiente + decisión sobre solapamiento: SERP-based + revisión humana
Uso la opción Hybrid: la similitud semántica produce el primer agrupamiento, los datos de GSC page muestran qué consultas ya tienen página y una persona resuelve los conflictos de intención.
4. Ejecutar clustering con IA y una salida definida
Al enviar las palabras normalizadas a la IA, el prompt debe definir los campos y las reglas de intención. Esta es la estructura que utilizo.
Ejemplo de prompt para IA:
Eres especialista en planificación de contenidos SEO. Agrupa las palabras clave normalizadas siguientes en clusters según su intención de búsqueda. Para cada cluster, entrega:
1. primary_intent
2. canonical_page (tipo recomendado: new article / old post refresh / FAQ / discard)
3. suggested_action
4. internal_link_targets (artículos o series existentes que deben enlazarse)
5. risk_notes (posible canibalización o revisión humana necesaria)

Palabras clave:
- astro seo
- astro vs next js for seo
- cloudflare pricing
- docker host.docker.internal
- docker host-gateway
...

Devuelve un array JSON. Cada cluster debe seguir:
{
  "cluster_id": 1,
  "keywords": ["astro seo", ...],
  "primary_intent": "informativa - tutorial",
  "canonical_page": "new article",
  "suggested_action": "Crear un tutorial de Astro SEO",
  "internal_link_targets": ["serie astro-guide", "serie cloudflare-bindui"],
  "risk_notes": "Revisión humana: astro vs next js for seo tiene intención comparativa y no debe unirse"
}
Ejemplo de cluster map:
| cluster_id | keywords | primary_intent | canonical_page | suggested_action | internal_link_targets | risk_notes |
|---|---|---|---|---|---|---|
| 1 | astro seo, astro blog seo | Informativa - tutorial | new article | Crear tutorial de Astro SEO | serie astro-guide, serie cloudflare-bindui | Ninguno |
| 2 | astro vs next js for seo | Comparativa | new article | Crear comparativa SEO Astro vs Next.js | serie astro-guide, nextjs-blog-series | Ninguno |
| 3 | cloudflare pricing, cloudflare cost, precio cloudflare | Transaccional | old post refresh | Actualizar artículo de precios de Cloudflare | serie cloudflare-bindui | Existe /cloudflare-pricing; actualizarlo |
| 4 | docker host.docker.internal, docker host-gateway, docker 127.0.0.1 | Informativa - configuración | FAQ | Añadir FAQ a un artículo de Docker | serie docker-practice | Variantes de la misma intención; unir en una FAQ |
Lista de revisión humana:
- Intención mezclada: un cluster contiene tutorial y comparación → separar
- Conflicto con página existente: el cluster indica «new article», pero existe un artículo relacionado → cambiar a old post refresh o FAQ
- Fragmentación excesiva: una intención aparece en varios clusters → unir
- Unión excesiva: varias intenciones aparecen en un cluster → separar
Pasos:
- Enviar la tabla normalizada a Claude, ChatGPT o un flujo interno de clustering.
- Ejecutar el primer agrupamiento con el prompt anterior.
- Exportar el cluster map.
- Revisar conflictos de intención, coincidencias con artículos, fragmentación y unión excesivas.
- Corregir el mapa y marcar clusters de riesgo.
5. Asignar cada cluster a una acción de contenido
Un cluster terminado necesita una acción ejecutable, no otra lista de palabras. Uso esta tabla de decisión.

| Factor | Artículo nuevo | Página pilar | Actualización | FAQ | Enlazado interno | discard |
|---|---|---|---|---|---|---|
| Número de query | Muchas (5+) | Muchas (5+) | Pocas (1–3) | Pocas (1–3) | Pocas (1–3) | Una |
| Variación de intención | Alta | Alta | Baja | Baja | Baja | Baja |
| Artículo existente | No | No | Sí | Sí | Sí | Sí |
| Competencia | Alta | Alta | Media | Media | Baja | Baja |
| Encaje temático | Alto | Alto | Alto | Medio | Medio | Bajo |
| Espacio para valor original | Alto | Alto | Bajo | Bajo | Bajo | Ninguno |
| Ejemplo | tutorial astro seo | serie astro | cloudflare pricing | docker host.docker.internal | enlaces entre artículos | variante de marca |
Definición de acciones:
- Artículo nuevo: crear una página que cubra todas las consultas de la misma intención.
- Página pilar: crear un hub de serie enlazado con las demás páginas del cluster.
- Actualización: ampliar una página existente para cubrir nuevas consultas.
- FAQ: añadir una respuesta concreta a un artículo existente.
- Enlazado interno: añadir enlaces contextuales hacia la página canónica.
- Discard: no crear contenido y marcar la consulta como poco valiosa o fuera de público.
Pasos:
- Puntuar cada cluster con los factores de decisión.
- Convertir la puntuación en una acción.
- Exportar una lista cluster_id → suggested_action.
- Revisar manualmente las acciones de riesgo: artículos nuevos y páginas pilar.
Las cantidades de query son señales de ejemplo, no umbrales automáticos. La acción final también depende de intención, inventario, valor original y costo de mantenimiento.
6. Diseñar enlaces internos como mapa de navegación
Las relaciones entre clusters deben convertirse en enlaces ejecutables, no en un bloque genérico de «artículos relacionados». Esta es la estructura.
Principios de enlazado interno:
- Enlaces bidireccionales pillar/cluster: la página pillar enlaza a todas las cluster y cada cluster vuelve a la pillar.
- Texto de anclaje descriptivo: explicar la intención de destino en vez de escribir «haz clic aquí».
- Objetivo canónico: evitar páginas duplicadas o casi iguales y enlazar a la URL canónica preferida.
- Sin artículos huérfanos: planificar al menos un enlace contextual entrante por artículo y añadir rutas según la arquitectura y el recorrido de lectura.
- Campo
internal_link_targets: registrar qué artículos o series deben recibir enlaces.
Plan de enlaces internos:
| cluster_id | pillar_page | cluster_pages | internal_link_targets | Ancla sugerida |
|---|---|---|---|---|
| 1 | Guía completa de Astro SEO | tutorial astro seo, astro blog seo | serie astro-guide, serie cloudflare-bindui | «optimización SEO de Astro», «optimización de rendimiento con Cloudflare» |
| 2 | - | astro vs next.js for seo | serie astro-guide, nextjs-blog-series | «comparativa Astro vs Next.js» |
| 3 | - | cloudflare pricing | serie cloudflare-bindui | «precios de Cloudflare explicados» |
Pasos:
- Identificar páginas pillar y cluster.
- Diseñar la estructura bidireccional.
- Elegir un ancla descriptiva por enlace.
- Comprobar artículos huérfanos.
- Exportar el plan a la tabla de tareas.
Google considera actualmente las redirecciones y rel="canonical" señales fuertes, mientras que la inclusión en sitemap es más débil. Las señales pueden reforzarse, pero Google sigue eligiendo la canónica. Los enlaces internos deben apuntar de manera coherente a la URL preferida.
7. Definir límites antes de que el clustering produzca páginas en masa
El clustering no debe convertirse en un generador masivo de páginas. Ese patrón se aleja rápido del contenido centrado en las personas.
Límites de riesgo:
- No crear una página por variante. Las query de la misma intención convergen en una página o destino canónico.
- Exigir una evaluación de valor original. Cada cluster debe responder a un problema del lector, al foco del sitio y a una aportación real frente al contenido existente.
- Consolidar query de la misma intención alrededor de una canónica. En páginas duplicadas o muy similares, redirecciones,
rel="canonical"y sitemaps expresan una preferencia, pero tienen fuerza distinta y no garantizan la elección de Google. - Evitar contenido search-engine-first. El propósito principal es ayudar al lector, no manipular posiciones.
- Reducir el riesgo de canibalización. Muchas páginas para palabras casi idénticas pueden hacer competir varias URL por la misma intención.
- Marcar clusters de riesgo. El campo risk_notes exige revisión humana.
Líneas rojas de calidad:
- Si existe un artículo coincidente, priorizar actualización o FAQ frente a otra página similar.
- Toda salida debe evaluar encaje temático y valor original.
- Los enlaces internos deben apuntar al artículo canónico, no a páginas duplicadas o cercanas.
8. Probar el flujo con Astro SEO, Cloudflare Pricing y Docker
Tres escenarios hacen concreto el proceso.
Ejemplo 1: astro seo vs astro vs next.js for seo (intenciones distintas, hay que separar)
- Query originales:
astro seo,astro vs next.js for seo,astro blog seo - Normalización:
astro seo,astro vs next js for seo,astro blog seo - Primer paso de IA: cluster_id=1, keywords=[astro seo, astro vs next js for seo, astro blog seo]
- Revisión humana:
astro seotiene intención de tutorial yastro vs next js for seo, de comparación; deben separarse. - Cluster map final:
- cluster_id=1: [astro seo, astro blog seo] → crear tutorial de Astro SEO
- cluster_id=2: [astro vs next js for seo] → crear comparativa SEO Astro vs Next.js
Ejemplo 2: cloudflare pricing (existe un artículo, hay que actualizar)
- Query originales:
cloudflare pricing,cloudflare cost,precio cloudflare - Normalización:
cloudflare pricing,cloudflare pricing,cloudflare pricing - Primer paso de IA: cluster_id=3, keywords=[cloudflare pricing, cloudflare pricing, cloudflare pricing]
- Coincidencia en inventario: artículo
/cloudflare-pricing - Cluster map final:
- cluster_id=3: [cloudflare pricing, cloudflare cost, precio cloudflare] → actualizar
/cloudflare-pricing
- cluster_id=3: [cloudflare pricing, cloudflare cost, precio cloudflare] → actualizar
Ejemplo 3: docker host.docker.internal (normalizar consultas técnicas relacionadas)
- Query originales:
docker host.docker.internal,docker host-gateway,docker 127.0.0.1 - Normalización: marcarlas como grupo candidato para la misma intención de configuración.
- Primer paso de IA: cluster_id=4, keywords=[docker host.docker.internal, docker host-gateway, docker 127.0.0.1]
- Coincidencia en inventario: existe una serie Docker
- Cluster map final:
- cluster_id=4: [docker host.docker.internal, docker host-gateway, docker 127.0.0.1] → tras validar la intención, añadir una FAQ o sección a un artículo de Docker
9. Entregar el mapa de contenidos al siguiente flujo
Cuando termine el clustering, el cluster map pasa a la tabla de tareas, donde se definen campos, puntuación, estados y calendario. El artículo siguiente, «Diseño de una tabla de tareas de contenido: campos, puntuación, estados y publicación», cubre ese paso.
Para transformar un cluster map en una estructura redactable, continúa con «Generación de esquemas con IA: del cluster map al esquema». «Enlazado interno automático: generar enlaces por lotes y evitar errores» detallará luego la inserción.
La actualización de artículos existentes tiene su propia guía: «Estrategia GSC de actualización: de quick wins a mejoras de contenido».
Artículos relacionados ya publicados:
- Planificación trimestral de contenidos para blogs técnicos con Pillar-Cluster
- SOP semanal de GA/GSC: de los datos a las acciones
- Técnicas avanzadas de GSC para encontrar oportunidades de contenido
Convertir palabras clave en un mapa de contenidos ejecutable
Flujo mínimo desde varias fuentes hasta el cluster map, las acciones de contenido y el plan de enlaces internos.
⏱️ Estimated time: 60 min
- 1
Step 1: Unificar las tres fuentes
Reúne datos query/page de GSC, fichas de ideas e inventario de artículos en una tabla, conservando la fuente, la coincidencia con contenido existente y la marca quickWins. - 2
Step 2: Normalizar las palabras clave
Resuelve duplicados, variantes, sinónimos, mayúsculas y puntuación; después etiqueta cada consulta como informativa, navegacional, comparativa o transaccional. - 3
Step 3: Ejecutar el primer agrupamiento semántico
Pide a la IA que agrupe por intención y entregue primary_intent, canonical_page, suggested_action, internal_link_targets y risk_notes para cada cluster. - 4
Step 4: Validar los clusters de riesgo
Usa GSC page, algunas SERP y criterio humano para detectar mezclas de tutorial y comparación, conflictos con artículos existentes, exceso de unión o fragmentación. - 5
Step 5: Asignar una acción principal
Asigna cada cluster a artículo nuevo, página pilar, actualización, FAQ, enlazado interno o discard y guarda la justificación. - 6
Step 6: Crear el plan de enlaces internos
Define enlaces bidireccionales pillar/cluster, objetivos canónicos y anclas descriptivas; después revisa artículos huérfanos y riesgos de duplicación.
FAQ
¿El clustering agrupa términos parecidos o consultas con la misma intención?
¿Cuándo una palabra clave merece un artículo en lugar de un H2 o una FAQ?
¿Se pueden mezclar consultas de GSC, preguntas de Reddit, issues de GitHub y títulos de competidores?
¿Por qué la IA fusiona palabras semánticamente cercanas con intenciones diferentes?
¿Cómo elegir entre clustering SERP-based, semantic e hybrid?
¿Conviene crear una página nueva si ya existe un artículo sobre el tema?
¿El clustering puede terminar en producción masiva de páginas de bajo valor?
12 min de lectura · Publicado el: 13 nov 2026

Guia practica de automatizacion de sitios de contenido con IA
Si llegaste desde búsqueda, lo más rápido es ir al artículo anterior o siguiente de esta misma serie.
Anterior
Agente de IA para investigar temas: ideas de blog con Google, Reddit y GitHub
Convierte consultas de GSC, preguntas de Reddit e issues de GitHub en temas técnicos con niveles de evidencia, puntuación, deduplicación, riesgos y revisión humana.
Parte 2 de 4
Siguiente
Cómo escribir un blog técnico con IA: investigación, validación de código y revisión humana
Conecta fuentes, ejecución de código, verificación de hechos y QA en un flujo editorial fiable que devuelve cada error a la etapa responsable.
Parte 4 de 4


Comentarios
Inicia sesión con GitHub para dejar un comentario