
AI 키워드 클러스터링: 검색어를 콘텐츠 시리즈와 내부 링크로 설계하기
"Google Search Central: 유용하고 신뢰할 수 있으며 사람을 우선하는 콘텐츠 만들기"
Astro, Docker, Cloudflare를 다루는 300행짜리 keywords.csv가 있습니다. AI는 42개 cluster로 나눴지만 사람이 확인해 보니 cluster #1에 astro seo와 astro vs next.js for seo가 함께 들어 있습니다. 앞의 쿼리는 튜토리얼을, 뒤의 쿼리는 비교를 원합니다. 한 페이지로 두 목적을 모두 만족시키기는 어렵습니다.
키워드 클러스터링의 실제 실패 지점이 여기에 있습니다. AI는 의미가 비슷하지만 의도가 다른 문구를 합칠 수 있고, 그 결과 여러 유사 글이 같은 수요를 놓고 경쟁하는 콘텐츠 카니발리제이션 위험이 커집니다. “키워드 그룹” 목록만으로는 어떤 그룹이 새 글, 기존 글 업데이트, FAQ, 내부 링크가 되어야 하는지도 알 수 없습니다.
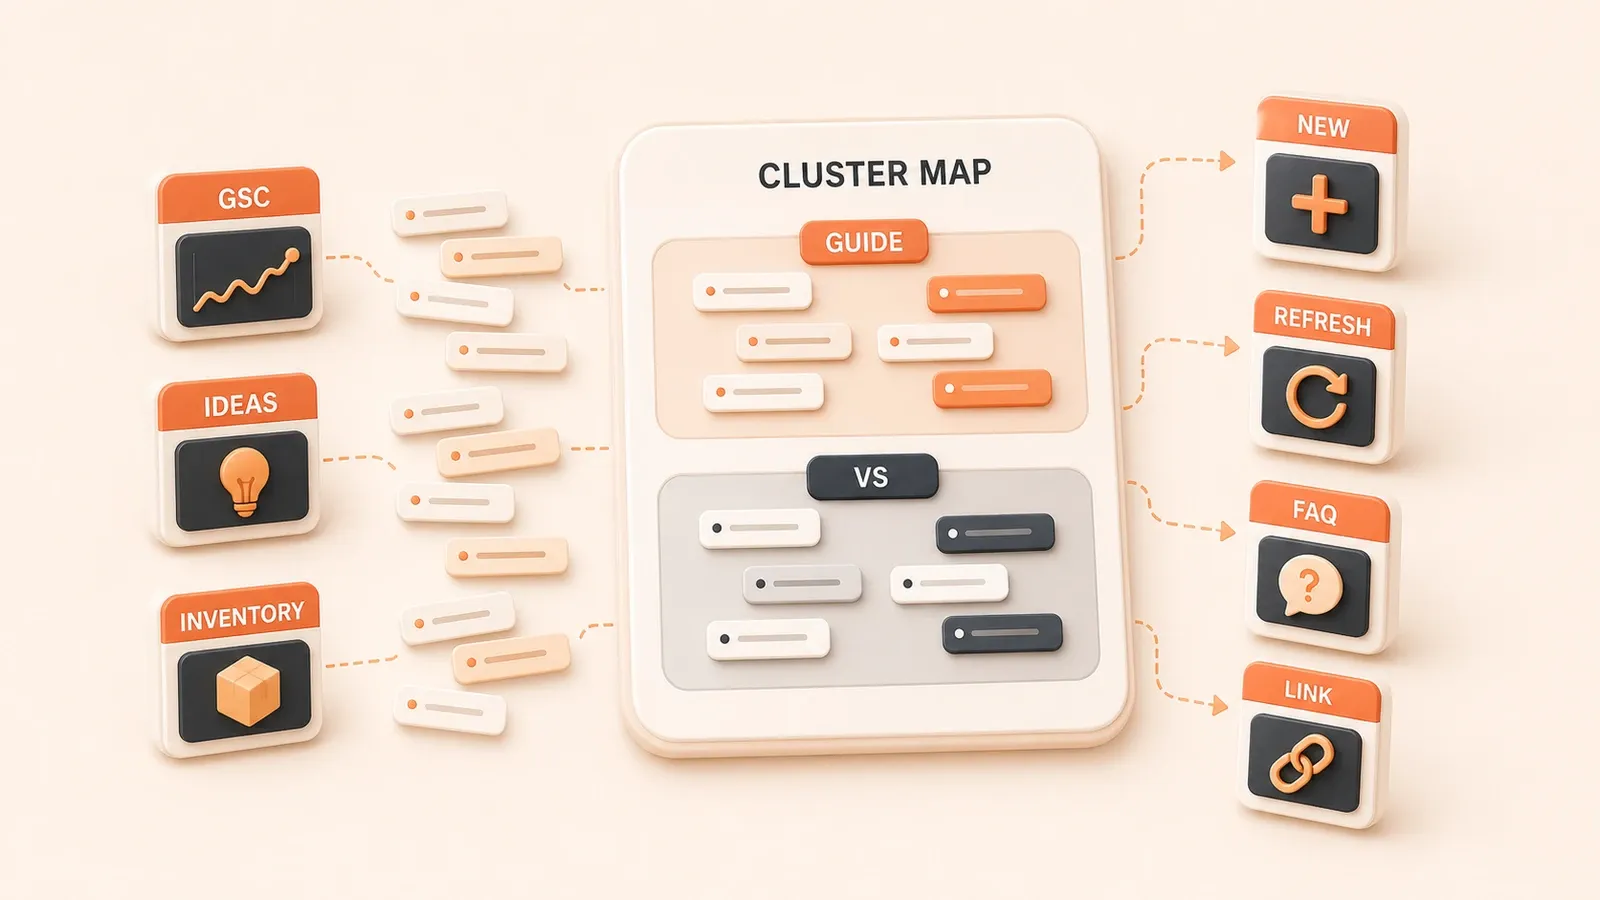
아래 흐름은 GSC 쿼리, 주제 카드, 사이트 콘텐츠 목록을 한 표로 합치는 데서 시작합니다. 행을 정규화하고 중복을 제거한 뒤 AI 초벌 분류를 사람이 검토하고, 각 cluster를 새 글, 업데이트, FAQ, 내부 링크, discard로 연결합니다. 입력 데이터, 중복 제거, 방법 비교, AI prompt, cluster map, 작업 판단, 내부 링크 구조가 결과물입니다.
1. 키워드 클러스터링에 필요한 입력을 모으기
입력은 “AI가 추측한 키워드”가 아닙니다. 사이트의 query/page 데이터, 주제 카드, 기존 글 목록입니다. 세 가지를 함께 봐야 어떤 주제를 쓸 가치가 있는지, 어떤 쿼리를 기존 글이 받을 수 있는지, 어떤 표현이 실제 커뮤니티 질문인지 판단할 수 있습니다.
입력 데이터는 다음과 같습니다.
| 데이터 소스 | 필드 | 가져오는 방법 | 주의 사항 |
|---|---|---|---|
| GSC query/page 데이터 | query, page, clicks, impressions, CTR, position | Search Console UI / Search Analytics API | API rowLimit 기본값은 1,000이고 요청당 최대 25,000입니다. 내부 제한 때문에 전체 행이 보장되지 않고 top rows가 반환됩니다 |
| 주제 카드 | 제목, 의도, 출처(Reddit/GitHub/경쟁사), 근거 | 주제 조사 Agent 출력 | 출처 품질을 사람이 검토합니다 |
| 사이트 콘텐츠 목록 | 글 제목, URL, 시리즈, 게시일, 트래픽, 순위 쿼리 | 사이트 DB / CMS | 일치하는 기존 글과 시리즈를 표시합니다 |
| quickWins 지표 | 노출은 높고 CTR은 낮은 키워드, 업데이트 기회 | GSC quickWins 분석 | 기존 글 업데이트 판단에 사용합니다 |
단계:
- GSC query/page 데이터를 내보냅니다. Performance report는 기본적으로 최근 3개월을 보여 주지만 작업에 맞게 기간을 조정할 수 있습니다.
- 주제 조사 Agent가 만든 주제 카드를 합칩니다.
- 기존 글, 시리즈, 성과를 포함한 사이트 목록을 추출합니다.
- 노출은 높고 CTR은 낮은 쿼리와 기존 글 업데이트 기회에 quickWins 표시를 붙입니다.
- query, 초기 의도, 출처, 기존 글 일치, quickWins 표시가 있는 통합 표를 출력합니다.
2. 클러스터링 전에 키워드를 정규화하기
통합 표에는 중복, 유사 표현, 표기 변형이 많습니다. 처리하지 않으면 AI가 서로 다른 단어로 보고 하나의 의도를 여러 cluster로 나눌 수 있습니다.
중복 제거 목록:

- 완전 중복:
astro seovsastro seo→ 한 행만 유지 - 표기 또는 설정 변형:
docker host.docker.internalvsdocker host-gatewayvsdocker 127.0.0.1→ 같은 의도 후보로 표시하고 사람이 확인 - 동의어:
cloudflare pricingvscloudflare 가격vscloudflare cost→ 하나의 의도로 표시 - 단어 형태 변화:
astro blogvsastro blogs→ 하나의 의도로 표시
정규화 규칙:
- 용어 통일:
nextjs→next.js,cloudflare workers→Cloudflare Workers - 대소문자 통일:
Astrovsastro→astro - 문장부호 통일:
astro, seovsastro seo→astro seo
초기 의도 라벨:
- 정보형: how to, what is, guide, tutorial
- 탐색형: 브랜드명, 제품명, 특정 URL
- 비교형: vs, compare, alternative
- 거래형: pricing, cost, buy, download
단계:
- 통합 표에서 완전 중복을 제거합니다.
- 표기 변형과 동의어를 찾아 같은 의도 후보로 표시합니다.
- 용어, 대소문자, 문장부호를 정규화합니다.
- 각 query에 정보형, 탐색형, 비교형, 거래형 의도를 표시합니다.
- query, normalized_query, intent_tag, source, old_post_match가 있는 정규화 표를 출력합니다.
3. 세 가지 클러스터링 방법 비교하기
방법을 고를 때 비용, 정확도, 위험을 함께 봐야 합니다. 대표적인 세 방식은 운영 단계에 따라 쓰임이 다릅니다.
| 방법 | 비용 | 정확도 | 적합한 상황 | 위험 |
|---|---|---|---|---|
| SERP-based | 높음. 많은 SERP 조회와 봇 방지 제한 가능성 | 높음. 실제 검색 결과로 페이지 병합 여부를 판단하는 데 도움 | 게시된 콘텐츠, 페이지 중복 판단, SERP API 예산이 있는 운영 | 비용이 높고 SERP 변동으로 안정성이 떨어짐 |
| Semantic | 낮음. embedding API 호출만 필요 | 중간. 실제 검색 의도를 놓치고 다른 의도를 합칠 수 있음 | 초기 주제 맵, 제한된 예산, 빠른 초벌 분류 | 의미는 비슷하지만 의도가 다른 단어를 합칠 수 있음 |
| Hybrid | 중간. 의미 기반 초벌 분류 + SERP/GSC 검증 + 사람의 검토 | 높음. 비용과 정확도의 균형 | GSC 데이터와 검토 시간이 있는 지속적 콘텐츠 운영 | 사람의 검토 시간이 필요 |
권장 흐름:
- 소규모 팀 / 초기: Semantic 초벌 분류 + GSC/page 검증 + 위험 cluster 사람 검토
- 중대형 팀 / 게시된 콘텐츠가 많은 사이트: 의미 분류, SERP/GSC 검증, 사람의 검토를 결합한 Hybrid
- 충분한 예산 + 페이지 병합 판단: SERP-based + 사람의 검토
저는 Hybrid를 사용합니다. 먼저 의미 유사도로 초벌 분류하고, GSC page 데이터로 어떤 쿼리를 기존 글이 받고 있는지 확인한 다음, 사람이 의도 충돌을 해결합니다.
4. 출력 형식을 정해 AI 클러스터링 실행하기
정규화된 키워드를 AI에 보낼 때는 출력 필드와 의도 규칙을 명확히 써야 합니다. 다음 prompt 구조를 사용할 수 있습니다.
AI prompt 예시:
당신은 SEO 콘텐츠 플래너입니다. 아래 정규화된 키워드를 검색 의도별 cluster로 분류하고 각 cluster에 다음을 제공하세요.
1. primary_intent
2. canonical_page (권장 대상 유형: new article / old post refresh / FAQ / discard)
3. suggested_action
4. internal_link_targets (링크할 기존 글 또는 시리즈)
5. risk_notes (카니발리제이션 가능성 또는 사람 검토 필요 여부)

키워드:
- astro seo
- astro vs next js for seo
- cloudflare pricing
- docker host.docker.internal
- docker host-gateway
...

JSON 배열로 출력하세요. 각 cluster 형식:
{
  "cluster_id": 1,
  "keywords": ["astro seo", ...],
  "primary_intent": "정보형 - 튜토리얼",
  "canonical_page": "new article",
  "suggested_action": "Astro SEO 튜토리얼 새로 작성",
  "internal_link_targets": ["astro-guide 시리즈", "cloudflare-bindui 시리즈"],
  "risk_notes": "사람 검토 필요: astro vs next js for seo는 비교 의도이므로 합치면 안 됨"
}
cluster map 예시:
| cluster_id | keywords | primary_intent | canonical_page | suggested_action | internal_link_targets | risk_notes |
|---|---|---|---|---|---|---|
| 1 | astro seo, astro blog seo | 정보형 - 튜토리얼 | new article | Astro SEO 튜토리얼 작성 | astro-guide 시리즈, cloudflare-bindui 시리즈 | 없음 |
| 2 | astro vs next js for seo | 비교형 | new article | Astro와 Next.js SEO 비교 글 작성 | astro-guide 시리즈, nextjs-blog-series | 없음 |
| 3 | cloudflare pricing, cloudflare cost, cloudflare 가격 | 거래형 | old post refresh | 기존 Cloudflare 가격 글 업데이트 | cloudflare-bindui 시리즈 | 기존 /cloudflare-pricing 업데이트 |
| 4 | docker host.docker.internal, docker host-gateway, docker 127.0.0.1 | 정보형 - 설정 | FAQ | Docker 시리즈 글에 FAQ 추가 | docker-practice 시리즈 | 같은 의도 변형을 FAQ로 합침 |
사람의 검토 목록:
- 의도 혼합: 한 cluster에 튜토리얼과 비교 쿼리가 있음 → 분리
- 기존 페이지 충돌: “new article”로 분류했지만 관련 글이 이미 있음 → old post refresh 또는 FAQ로 변경
- 과도한 분할: 하나의 의도가 여러 cluster로 나뉨 → 병합
- 과도한 병합: 서로 다른 의도가 한 cluster에 들어감 → 분리
단계:
- 정규화 표를 Claude, ChatGPT 또는 내부 AI 클러스터링 흐름에 전달합니다.
- 위 prompt로 초벌 분류합니다.
- cluster map을 출력합니다.
- 의도 충돌, 기존 글 일치, 과도한 분할과 병합을 검토합니다.
- cluster map을 수정하고 위험 cluster를 표시합니다.
5. 각 클러스터를 하나의 콘텐츠 작업에 연결하기
완성된 cluster에는 또 다른 키워드 목록이 아니라 실행 가능한 작업이 필요합니다. 다음 판단표를 사용합니다.

| 판단 요소 | 새 글 | 필러 페이지 | 기존 글 업데이트 | FAQ | 내부 링크 개선 | discard |
|---|---|---|---|---|---|---|
| query 수 | 많음(5+) | 많음(5+) | 적음(1~3) | 적음(1~3) | 적음(1~3) | 1개 |
| 의도 변화 | 큼 | 큼 | 작음 | 작음 | 작음 | 작음 |
| 일치하는 기존 글 | 없음 | 없음 | 있음 | 있음 | 있음 | 있음 |
| 경쟁 강도 | 높음 | 높음 | 중간 | 중간 | 낮음 | 낮음 |
| 사이트 주제 적합성 | 높음 | 높음 | 높음 | 중간 | 중간 | 낮음 |
| 독창적 가치 공간 | 큼 | 큼 | 작음 | 작음 | 작음 | 없음 |
| 예 | astro seo 튜토리얼 | astro 시리즈 | cloudflare pricing | docker host.docker.internal | 관련 글 링크 | 브랜드명 변형 |
작업 정의:
- 새 글: cluster 안의 같은 의도 쿼리를 모두 다루는 페이지를 만듭니다.
- 필러 페이지: cluster의 다른 글로 연결되는 시리즈 hub를 만듭니다.
- 기존 글 업데이트: 새 쿼리를 다루도록 기존 페이지를 확장합니다.
- FAQ: 기존 글에 구체적인 답변을 추가합니다.
- 내부 링크 개선: canonical 페이지로 가는 문맥 링크를 추가합니다.
- Discard: 콘텐츠를 만들지 않고 가치가 낮거나 대상 독자 밖으로 표시합니다.
단계:
- 판단 요소에 따라 각 cluster를 평가합니다.
- 평가를 작업으로 변환합니다.
- cluster_id → suggested_action 형식으로 작업 목록을 출력합니다.
- 새 글과 필러 페이지 같은 위험 작업을 사람이 검토합니다.
표의 query 수는 예시 신호이며 자동 기준이 아닙니다. 최종 작업은 검색 의도, 기존 목록, 독창적 가치, 유지 비용을 함께 판단해야 합니다.
6. 내부 링크를 클러스터의 탐색 지도로 설계하기
cluster 사이 관계는 일반적인 “관련 글” 블록이 아니라 실행 가능한 내부 링크가 되어야 합니다. 다음 구조를 사용합니다.
내부 링크 원칙:
- pillar/cluster 양방향 링크: pillar 페이지는 모든 cluster 페이지로 연결하고, 각 cluster 페이지는 pillar로 돌아갑니다.
- 설명형 앵커 텍스트: “여기를 클릭” 대신 대상 의도를 설명합니다.
- canonical 대상: 중복 또는 유사 페이지를 피하고 선호하는 canonical URL로 연결합니다.
- 고립된 글 방지: 각 글에 문맥이 맞는 유입 링크를 최소 하나 계획하고 사이트 구조와 독자 경로에 따라 더 추가합니다.
- cluster map의
internal_link_targets: 링크할 기존 글 또는 시리즈를 기록합니다.
내부 링크 목록:
| cluster_id | pillar_page | cluster_pages | internal_link_targets | 앵커 텍스트 제안 |
|---|---|---|---|---|
| 1 | Astro SEO 종합 가이드 | astro seo 튜토리얼, astro blog seo | astro-guide 시리즈, cloudflare-bindui 시리즈 | “Astro SEO 최적화”, “Cloudflare 성능 최적화” |
| 2 | - | astro vs next.js for seo | astro-guide 시리즈, nextjs-blog-series | “Astro와 Next.js 비교” |
| 3 | - | cloudflare pricing | cloudflare-bindui 시리즈 | “Cloudflare 가격 설명” |
단계:
- pillar 페이지와 cluster 페이지를 식별합니다.
- 양방향 링크 구조를 설계합니다.
- 각 링크에 설명형 앵커 텍스트를 정합니다.
- 고립된 글이 있는지 확인합니다.
- 내부 링크 목록을 콘텐츠 작업표로 내보냅니다.
Google은 현재 redirect와 rel="canonical"을 강한 canonical 신호로, sitemap 포함을 더 약한 신호로 봅니다. 여러 신호를 함께 쓸 수 있지만 최종 canonical은 Google이 선택합니다. 내부 링크는 canonical로 선호하는 URL을 일관되게 가리켜야 합니다.
7. 클러스터링이 페이지 대량 생성이 되지 않도록 품질 기준 세우기
키워드 클러스터링은 일괄 페이지 생성기가 되어서는 안 됩니다. 그런 흐름은 사람을 우선하는 콘텐츠 원칙에서 빠르게 멀어집니다.
위험 경계:
- 키워드 변형마다 페이지를 만들지 않습니다. 같은 의도의 query는 한 페이지 또는 canonical 대상에 모읍니다.
- 독창적 가치 판단을 필수로 합니다. 각 cluster는 독자의 문제, 사이트 주제, 기존 콘텐츠에 없는 추가 가치를 연결해야 합니다.
- 같은 의도의 query를 canonical로 통합합니다. 중복 또는 매우 유사한 페이지에서 redirect,
rel="canonical", sitemap으로 선호를 표현할 수 있지만 신호 강도는 다르고 Google의 선택을 보장하지 않습니다. - search engine-first 콘텐츠를 피합니다. 주 목적은 순위 조작이 아니라 독자의 문제 해결입니다.
- 카니발리제이션 위험을 줄입니다. 거의 같은 키워드로 많은 페이지를 게시하면 여러 URL이 같은 의도를 놓고 경쟁할 수 있습니다.
- 위험 cluster를 표시합니다. cluster map의 risk_notes로 사람의 검토를 요구합니다.
품질 금지선:
- 일치하는 기존 글이 있으면 유사 페이지를 추가하기 전에 업데이트 또는 FAQ를 우선합니다.
- 모든 클러스터링 출력에는 사이트 주제 적합성과 독창적 가치 판단이 있어야 합니다.
- 내부 링크는 중복 또는 유사 페이지가 아니라 canonical 글로 향해야 합니다.
8. Astro SEO, Cloudflare Pricing, Docker 예시로 확인하기
세 가지 상황에 적용하면 전체 흐름을 이해하기 쉽습니다.
예시 1: astro seo와 astro vs next.js for seo(의도가 달라 분리)
- 원본 query:
astro seo,astro vs next.js for seo,astro blog seo - 정규화:
astro seo,astro vs next js for seo,astro blog seo - AI 초벌 분류: cluster_id=1, keywords=[astro seo, astro vs next js for seo, astro blog seo]
- 사람의 검토:
astro seo는 튜토리얼,astro vs next js for seo는 비교 의도이므로 분리합니다. - 최종 cluster map:
- cluster_id=1: [astro seo, astro blog seo] → Astro SEO 튜토리얼 작성
- cluster_id=2: [astro vs next js for seo] → Astro와 Next.js SEO 비교 글 작성
예시 2: cloudflare pricing(기존 글을 업데이트)
- 원본 query:
cloudflare pricing,cloudflare cost,cloudflare 가격 - 정규화:
cloudflare pricing,cloudflare pricing,cloudflare pricing - AI 초벌 분류: cluster_id=3, keywords=[cloudflare pricing, cloudflare pricing, cloudflare pricing]
- 기존 목록 일치:
/cloudflare-pricing글이 있음 - 최종 cluster map:
- cluster_id=3: [cloudflare pricing, cloudflare cost, cloudflare 가격] →
/cloudflare-pricing업데이트
- cluster_id=3: [cloudflare pricing, cloudflare cost, cloudflare 가격] →
예시 3: docker host.docker.internal(관련 기술 쿼리 정규화)
- 원본 query:
docker host.docker.internal,docker host-gateway,docker 127.0.0.1 - 정규화: 같은 설정 의도의 후보 그룹으로 표시합니다.
- AI 초벌 분류: cluster_id=4, keywords=[docker host.docker.internal, docker host-gateway, docker 127.0.0.1]
- 기존 목록 일치: Docker 시리즈가 있음
- 최종 cluster map:
- cluster_id=4: [docker host.docker.internal, docker host-gateway, docker 127.0.0.1] → 사람이 의도를 확인한 뒤 Docker 시리즈 글에 FAQ 또는 섹션으로 추가
9. 콘텐츠 맵을 다음 흐름으로 넘기기
클러스터링이 끝나면 cluster map을 콘텐츠 작업표로 옮기고 필드, 점수, 상태 흐름, 게시 계획을 설계합니다. 다음 시리즈 글 “콘텐츠 작업표 설계: 필드, 점수, 상태, 게시 계획”에서 이 단계를 다룹니다.
cluster map을 작성 가능한 구성으로 바꾸는 방법은 “AI 구성 생성: cluster map에서 작성 가능한 아웃라인으로”에서 설명합니다. 링크 일괄 삽입은 이후 글 “내부 링크 자동화: 관련 링크 일괄 생성과 주의점”에서 자세히 다룹니다.
기존 글 업데이트에는 “GSC 기존 글 업데이트 전략: quickWins에서 콘텐츠 개선까지”라는 별도 가이드가 있습니다.
이미 게시된 관련 글:
키워드를 실행 가능한 콘텐츠 맵으로 바꾸는 절차
여러 입력을 cluster map, 콘텐츠 작업, 내부 링크 목록으로 바꾸는 최소 흐름입니다.
⏱️ Estimated time: 60 min
- 1
Step 1: 세 가지 입력을 합치기
GSC query/page 데이터, 주제 카드, 기존 글 목록을 한 표에 넣고 출처, 기존 글 일치 여부, quickWins 표시를 유지합니다. - 2
Step 2: 키워드 정규화하기
중복, 표기 변형, 동의어, 대소문자, 문장부호를 처리하고 각 쿼리에 정보형, 탐색형, 비교형, 거래형 의도를 표시합니다. - 3
Step 3: 의미 기반 초벌 분류하기
AI가 검색 의도로 분류하고 각 클러스터에 primary_intent, canonical_page, suggested_action, internal_link_targets, risk_notes를 출력하게 합니다. - 4
Step 4: 위험한 클러스터 검증하기
GSC page, 필요한 SERP, 사람의 판단으로 튜토리얼과 비교 의도 혼합, 기존 글 충돌, 과도한 병합과 분할을 확인합니다. - 5
Step 5: 주 작업 하나 배정하기
각 클러스터를 새 글, 필러 페이지, 기존 글 업데이트, FAQ, 내부 링크 개선, discard에 배정하고 이유를 기록합니다. - 6
Step 6: 내부 링크 목록 만들기
pillar와 cluster의 양방향 링크, canonical 대상, 설명형 앵커를 정한 뒤 고립된 글과 중복 페이지 위험을 확인합니다.
FAQ
키워드 클러스터링은 비슷한 단어를 묶나요, 같은 검색 의도를 묶나요?
키워드를 새 글로 만들지 기존 글의 H2나 FAQ로 넣을지는 어떻게 판단하나요?
GSC 쿼리, Reddit 질문, GitHub issue, 경쟁사 제목을 한 표에 넣어도 되나요?
AI는 왜 의미가 비슷하지만 의도가 다른 키워드를 잘못 합치나요?
SERP-based, semantic, hybrid clustering은 어떻게 선택하나요?
같은 주제의 기존 글이 있으면 새 페이지를 만들어야 하나요?
키워드 클러스터링이 저가치 페이지 대량 생성으로 이어질 수 있나요?
3분 읽기 · 게시일: 2026년 11월 13일


댓글
GitHub로 로그인하여 댓글을 남기세요