
Clustering delle keyword con IA: dalle query alle serie e ai link interni
"Google Search Central: creare contenuti utili, affidabili e pensati per le persone"
Hai un file keywords.csv con 300 query su Astro, Docker e Cloudflare. L’IA produce 42 cluster, ma la verifica manuale trova astro seo e astro vs next.js for seo insieme nel cluster #1. La prima query richiede un tutorial; la seconda, un confronto. Una sola pagina difficilmente soddisferà entrambi i compiti.
Questo è il punto debole concreto del clustering: l’IA può unire espressioni semanticamente vicine che hanno intenti diversi. Aumenta così il rischio di cannibalizzazione, perché più articoli quasi uguali competono per la stessa domanda. Un elenco di «gruppi di keyword» non indica nemmeno quali gruppi richiedano un nuovo articolo, un aggiornamento, una FAQ o un link interno.
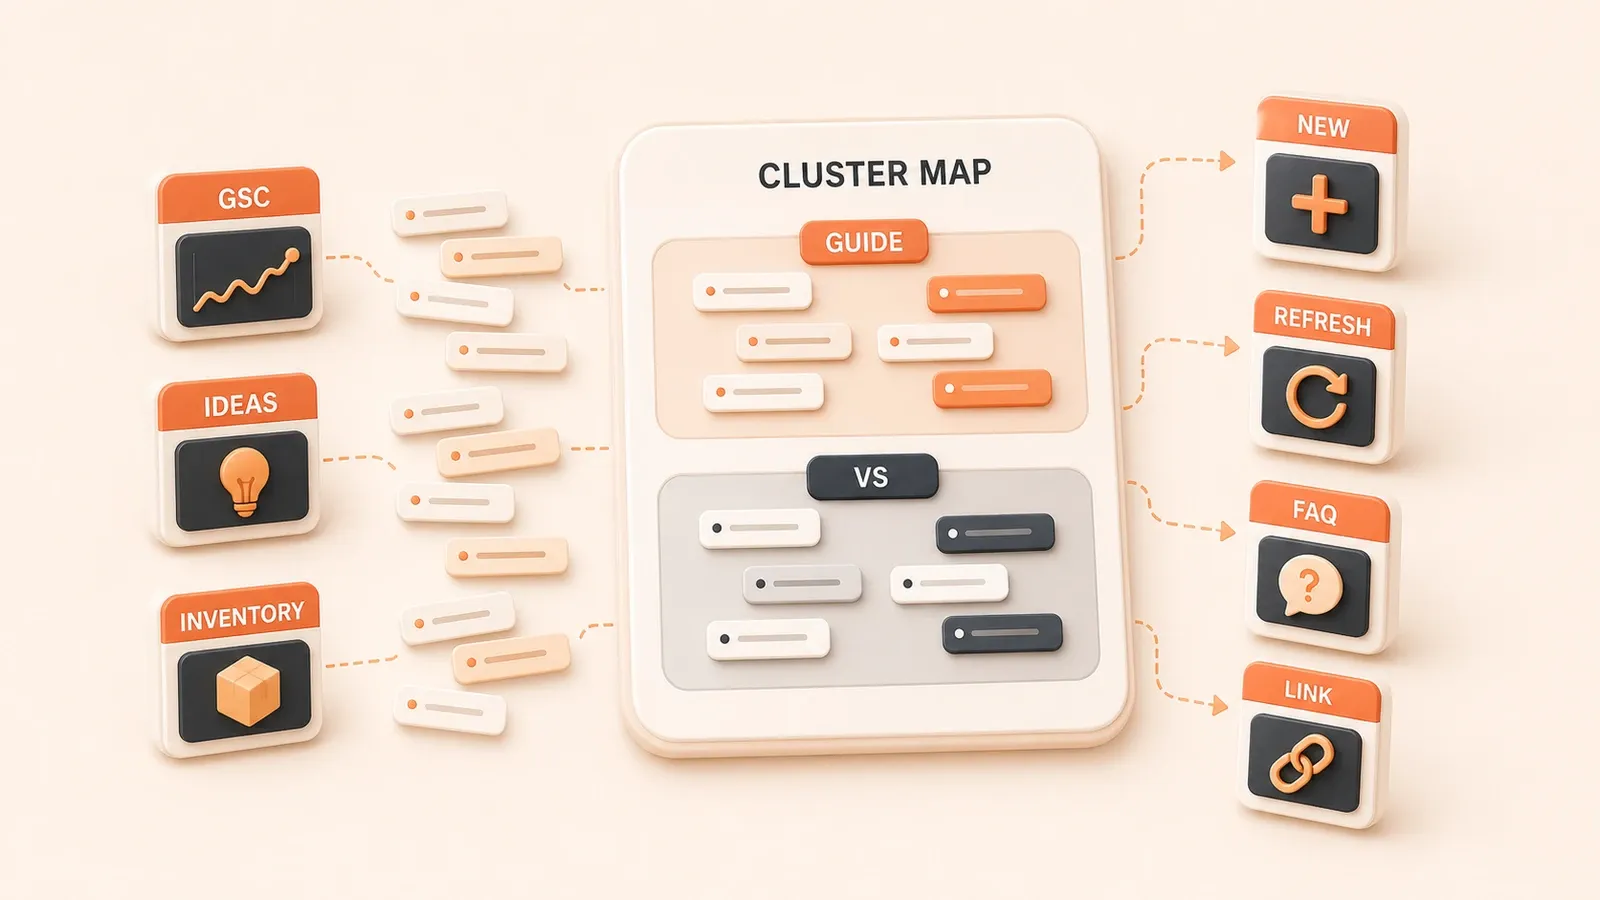
Il flusso seguente combina query GSC, schede delle idee e inventario del sito. Normalizza e deduplica le righe, mantiene una revisione umana dopo il primo passaggio dell’IA e associa ogni cluster a un’azione: nuovo articolo, aggiornamento, FAQ, link interno o discard. Gli output comprendono fonti, logica di normalizzazione, confronto dei metodi, prompt, cluster map, criteri di azione e struttura dei link.
1. Riunire le fonti corrette per il clustering
L’input non è un elenco inventato dall’IA. È formato dai dati query/page del sito, dalle schede delle idee e dall’inventario dei contenuti. Insieme mostrano quali temi meritano una pagina, quali hanno già un articolo e quali domande provengono davvero dalle community.
Le fonti si organizzano così:
| Fonte | Campi | Come ottenerla | Attenzione |
|---|---|---|---|
| Dati GSC query/page | query, page, clicks, impressions, CTR, position | Search Console UI / Search Analytics API | Il rowLimit dell’API è 1.000 per impostazione predefinita e 25.000 al massimo per richiesta; i limiti interni fanno restituire top rows senza garantire tutte le righe |
| Schede delle idee | titolo, intento, fonte (Reddit/GitHub/concorrente), prova | Output dell’agente di ricerca | Verificare manualmente la qualità della fonte |
| Inventario del sito | titolo, URL, serie, data, traffico, query posizionate | Database del sito / CMS | Segnare articoli corrispondenti e serie |
| Metriche quickWins | query con molte impressions e CTR basso, opportunità di aggiornamento | Analisi GSC quickWins | Supportano la decisione di aggiornare |
Passaggi:
- Esporta i dati query/page da GSC. Il report Performance mostra per impostazione predefinita gli ultimi tre mesi, ma puoi modificare l’intervallo.
- Aggiungi le schede prodotte dall’agente di ricerca.
- Estrai l’inventario: articoli esistenti, serie e prestazioni.
- Segna i quick win: molte impressions, CTR basso e opportunità di aggiornamento.
- Genera una tabella con query, intento iniziale, fonte, corrispondenza con articolo esistente e indicatore quickWins.
2. Normalizzare le keyword prima di raggrupparle
La tabella combinata contiene duplicati, varianti e differenze di scrittura. Senza elaborazione, l’IA può considerarli termini distinti e dividere un solo intento tra più cluster.
Elenco di deduplicazione:

- Duplicato esatto:
astro seovsastro seo→ conserva una riga - Varianti di scrittura o configurazione:
docker host.docker.internalvsdocker host-gatewayvsdocker 127.0.0.1→ segna come candidate allo stesso intento e attendi conferma umana - Sinonimi:
cloudflare pricingvsprezzi cloudflarevscloudflare cost→ segna come un intento - Variazione di forma:
astro blogvsastro blogs→ segna come un intento
Regole di normalizzazione:
- Uniforma i termini:
nextjs→next.js,cloudflare workers→Cloudflare Workers - Uniforma maiuscole e minuscole:
Astrovsastro→astro - Uniforma la punteggiatura:
astro, seovsastro seo→astro seo
Label iniziali dell’intento:
- Informativo: how to, what is, guide, tutorial
- Navigazionale: brand, prodotto, URL specifico
- Comparativo: vs, compare, alternative
- Transazionale: pricing, cost, buy, download
Passaggi:
- Rimuovi i duplicati esatti dalla tabella.
- Rileva varianti e sinonimi e segnali come candidati allo stesso intento.
- Normalizza termini, maiuscole e punteggiatura.
- Etichetta ogni query come informativa, navigazionale, comparativa o transazionale.
- Esporta una tabella con query, normalized_query, intent_tag, source e old_post_match.
3. Confrontare tre metodi di clustering
La scelta deve bilanciare costo, precisione e rischio. I tre approcci principali sono adatti a fasi diverse.
| Metodo | Costo | Precisione | Scenario adatto | Rischio |
|---|---|---|---|---|
| SERP-based | Alto: molte query SERP e possibili limiti anti-bot | Alta: usa risultati reali e aiuta a decidere se unire pagine | Contenuti pubblicati, analisi delle sovrapposizioni e budget SERP API | Costoso; le variazioni delle SERP riducono la stabilità |
| Semantic | Basso: solo chiamate a un’API di embedding | Media: può ignorare l’intento reale e unire compiti diversi | Prima topic map, budget limitato e raggruppamento rapido | Può unire parole vicine per significato ma diverse per intento |
| Hybrid | Medio: primo passaggio semantico + verifica SERP/GSC + revisione umana | Alta: bilancia costo e precisione | Operazioni continue con dati GSC e tempo di revisione | Richiede capacità di revisione umana |
Flusso consigliato:
- Team piccolo / fase iniziale: primo passaggio Semantic + verifica GSC/page + revisione umana dei cluster rischiosi
- Team più grande / contenuti consolidati: Hybrid con raggruppamento semantico, verifica SERP/GSC e revisione umana
- Budget sufficiente + decisione sulla sovrapposizione: SERP-based + revisione umana
Uso Hybrid: la somiglianza semantica crea il primo raggruppamento, i dati GSC page mostrano quali query hanno già una pagina e una persona risolve i conflitti di intento.
4. Eseguire il clustering con IA e un output definito
Quando invii le keyword normalizzate all’IA, il prompt deve definire campi e regole dell’intento. Questa è la struttura usata.
Esempio di prompt per l’IA:
Sei uno specialista della pianificazione di contenuti SEO. Raggruppa le keyword normalizzate seguenti in cluster per intento di ricerca. Per ogni cluster fornisci:
1. primary_intent
2. canonical_page (tipo consigliato: new article / old post refresh / FAQ / discard)
3. suggested_action
4. internal_link_targets (articoli o serie esistenti da collegare)
5. risk_notes (possibile cannibalizzazione o revisione umana necessaria)

Keyword:
- astro seo
- astro vs next js for seo
- cloudflare pricing
- docker host.docker.internal
- docker host-gateway
...

Restituisci un array JSON. Ogni cluster segue:
{
  "cluster_id": 1,
  "keywords": ["astro seo", ...],
  "primary_intent": "informativo - tutorial",
  "canonical_page": "new article",
  "suggested_action": "Creare un tutorial Astro SEO",
  "internal_link_targets": ["serie astro-guide", "serie cloudflare-bindui"],
  "risk_notes": "Revisione umana: astro vs next js for seo ha intento comparativo e non va unito"
}
Esempio di cluster map:
| cluster_id | keywords | primary_intent | canonical_page | suggested_action | internal_link_targets | risk_notes |
|---|---|---|---|---|---|---|
| 1 | astro seo, astro blog seo | Informativo - tutorial | new article | Creare tutorial Astro SEO | serie astro-guide, serie cloudflare-bindui | Nessuno |
| 2 | astro vs next js for seo | Comparativo | new article | Creare confronto SEO Astro vs Next.js | serie astro-guide, nextjs-blog-series | Nessuno |
| 3 | cloudflare pricing, cloudflare cost, prezzi cloudflare | Transazionale | old post refresh | Aggiornare l’articolo sui prezzi Cloudflare | serie cloudflare-bindui | Esiste /cloudflare-pricing; aggiornarlo |
| 4 | docker host.docker.internal, docker host-gateway, docker 127.0.0.1 | Informativo - configurazione | FAQ | Aggiungere FAQ a un articolo Docker | serie docker-practice | Varianti dello stesso intento; unire in una FAQ |
Elenco di revisione umana:
- Intenti mescolati: un cluster contiene tutorial e confronto → separare
- Conflitto con pagina esistente: il cluster è “new article”, ma esiste un articolo correlato → cambiare in old post refresh o FAQ
- Frammentazione eccessiva: un intento appare in più cluster → unire
- Aggregazione eccessiva: più intenti appaiono in un cluster → separare
Passaggi:
- Invia la tabella normalizzata a Claude, ChatGPT o a un flusso interno di clustering.
- Esegui il primo raggruppamento con il prompt precedente.
- Esporta la cluster map.
- Controlla conflitti di intento, corrispondenze con articoli, frammentazione e aggregazione eccessive.
- Correggi la mappa e segna i cluster rischiosi.
5. Assegnare ogni cluster a un’azione editoriale
Un cluster completato richiede un’azione operativa, non un altro elenco di parole. Uso questa tabella decisionale.
| Fattore | Nuovo articolo | Pagina pillar | Aggiornamento | FAQ | Link interni | discard |
|---|---|---|---|---|---|---|
| Numero di query | Molte (5+) | Molte (5+) | Poche (1–3) | Poche (1–3) | Poche (1–3) | Una |
| Variazione di intento | Alta | Alta | Bassa | Bassa | Bassa | Bassa |
| Articolo esistente | No | No | Sì | Sì | Sì | Sì |
| Concorrenza | Alta | Alta | Media | Media | Bassa | Bassa |
| Coerenza tematica | Alta | Alta | Alta | Media | Media | Bassa |
| Spazio per valore originale | Alto | Alto | Basso | Basso | Basso | Nessuno |
| Esempio | tutorial astro seo | serie astro | cloudflare pricing | docker host.docker.internal | link tra articoli | variante del brand |
Definizione delle azioni:
- Nuovo articolo: crea una pagina che copra tutte le query con lo stesso intento.
- Pagina pillar: crea un hub di serie collegato alle altre pagine del cluster.
- Aggiornamento: amplia una pagina esistente per coprire nuove query.
- FAQ: aggiungi una risposta specifica a un articolo esistente.
- Link interni: aggiungi link contestuali alla pagina canonica.
- Discard: non creare contenuto e segna la query come poco utile o fuori target.
Passaggi:
- Valuta ogni cluster secondo i fattori decisionali.
- Converti la valutazione in un’azione.
- Esporta un elenco cluster_id → suggested_action.
- Revisiona manualmente le azioni rischiose: nuovi articoli e pagine pillar.
Le quantità di query sono segnali di esempio, non soglie automatiche. L’azione finale dipende anche da intento, inventario, valore originale e costo di manutenzione.
6. Progettare i link interni come mappa di navigazione
Le relazioni tra cluster devono diventare link operativi, non un blocco generico di “articoli correlati”. Questa è la struttura.
Principi dei link interni:
- Link bidirezionali pillar/cluster: la pagina pillar collega tutte le cluster e ogni cluster torna alla pillar.
- Anchor text descrittivo: descrivere l’intento di destinazione invece di scrivere “clicca qui”.
- Destinazione canonica: evitare pagine duplicate o quasi uguali e collegare la URL canonica preferita.
- Nessun articolo orfano: pianificare almeno un link contestuale in ingresso per articolo e aggiungere percorsi in base all’architettura e alla lettura.
- Campo
internal_link_targets: registrare quali articoli o serie devono ricevere link.
Piano dei link interni:
| cluster_id | pillar_page | cluster_pages | internal_link_targets | Anchor text suggerito |
|---|---|---|---|---|
| 1 | Guida Astro SEO | tutorial astro seo, astro blog seo | serie astro-guide, serie cloudflare-bindui | “ottimizzazione SEO di Astro”, “ottimizzazione delle prestazioni con Cloudflare” |
| 2 | - | astro vs next.js for seo | serie astro-guide, nextjs-blog-series | “confronto Astro vs Next.js” |
| 3 | - | cloudflare pricing | serie cloudflare-bindui | “prezzi Cloudflare spiegati” |
Passaggi:
- Identifica pagine pillar e cluster.
- Progetta la struttura bidirezionale.
- Scegli un anchor text descrittivo per ogni link.
- Controlla gli articoli orfani.
- Esporta il piano nella tabella delle attività.
Google considera attualmente redirect e rel="canonical" segnali forti, mentre l’inclusione in sitemap è più debole. I segnali possono rafforzarsi, ma Google continua a scegliere la canonica. I link interni devono puntare in modo coerente alla URL preferita.
7. Impostare limiti prima che il clustering produca pagine in massa
Il clustering non deve diventare un generatore di pagine. Questo schema si allontana rapidamente dai contenuti pensati per le persone.
Limiti di rischio:
- Non creare una pagina per variante. Le query con lo stesso intento convergono su una pagina o destinazione canonica.
- Richiedere una valutazione del valore originale. Ogni cluster deve rispondere a un problema del lettore, al focus del sito e a un apporto reale rispetto ai contenuti esistenti.
- Consolidare query con lo stesso intento attorno a una canonica. Per pagine duplicate o molto simili, redirect,
rel="canonical"e sitemap esprimono una preferenza, ma hanno forza diversa e non garantiscono la scelta di Google. - Evitare contenuti search-engine-first. Lo scopo principale è aiutare il lettore, non manipolare il ranking.
- Ridurre il rischio di cannibalizzazione. Molte pagine per parole quasi identiche possono mettere più URL in competizione sullo stesso intento.
- Segnare i cluster rischiosi. Il campo risk_notes richiede revisione umana.
Linee rosse qualitative:

- Se esiste un articolo corrispondente, preferire aggiornamento o FAQ a un’altra pagina simile.
- Ogni output deve valutare coerenza tematica e valore originale.
- I link interni devono puntare all’articolo canonico, non a pagine duplicate o vicine.
8. Verificare il flusso con Astro SEO, Cloudflare Pricing e Docker
Tre scenari rendono concreto il processo.
Esempio 1: astro seo vs astro vs next.js for seo (intenti diversi, quindi separare)
- Query originali:
astro seo,astro vs next.js for seo,astro blog seo - Normalizzazione:
astro seo,astro vs next js for seo,astro blog seo - Primo passaggio IA: cluster_id=1, keywords=[astro seo, astro vs next js for seo, astro blog seo]
- Revisione umana:
astro seoha intento tutorial,astro vs next js for seointento comparativo; vanno separati. - Cluster map finale:
- cluster_id=1: [astro seo, astro blog seo] → creare tutorial Astro SEO
- cluster_id=2: [astro vs next js for seo] → creare confronto SEO Astro vs Next.js
Esempio 2: cloudflare pricing (esiste un articolo, quindi aggiornare)
- Query originali:
cloudflare pricing,cloudflare cost,prezzi cloudflare - Normalizzazione:
cloudflare pricing,cloudflare pricing,cloudflare pricing - Primo passaggio IA: cluster_id=3, keywords=[cloudflare pricing, cloudflare pricing, cloudflare pricing]
- Corrispondenza inventario: articolo
/cloudflare-pricing - Cluster map finale:
- cluster_id=3: [cloudflare pricing, cloudflare cost, prezzi cloudflare] → aggiornare
/cloudflare-pricing
- cluster_id=3: [cloudflare pricing, cloudflare cost, prezzi cloudflare] → aggiornare
Esempio 3: docker host.docker.internal (normalizzare query tecniche correlate)
- Query originali:
docker host.docker.internal,docker host-gateway,docker 127.0.0.1 - Normalizzazione: segnarle come gruppo candidato per lo stesso intento di configurazione.
- Primo passaggio IA: cluster_id=4, keywords=[docker host.docker.internal, docker host-gateway, docker 127.0.0.1]
- Corrispondenza inventario: esiste una serie Docker
- Cluster map finale:
- cluster_id=4: [docker host.docker.internal, docker host-gateway, docker 127.0.0.1] → dopo la verifica umana dell’intento, aggiungere una FAQ o sezione a un articolo Docker
9. Consegnare la content map al flusso successivo
Quando il clustering è completo, la cluster map passa alla tabella delle attività, dove si definiscono campi, punteggi, stati e calendario. Il prossimo articolo, “Progettare una tabella delle attività di contenuto: campi, punteggi, stati e pubblicazione”, copre questo passaggio.
Per trasformare una cluster map in una struttura scrivibile, prosegui con “Generare la struttura con l’IA: dalla cluster map alla scaletta”. “Link interni automatici: generare collegamenti in blocco ed evitare errori” approfondirà poi l’inserimento.
L’aggiornamento degli articoli esistenti ha una guida dedicata: “Strategia GSC di aggiornamento: dai quick win alle revisioni”.
Articoli correlati già pubblicati:
- Pianificazione trimestrale per blog tecnici con Pillar-Cluster
- SOP settimanale GA/GSC: dai dati alle azioni
- Tecniche avanzate GSC per trovare opportunità di contenuto
Trasformare le keyword in una content map operativa
Flusso minimo da più fonti alla cluster map, alle azioni editoriali e al piano dei link interni.
⏱️ Estimated time: 60 min
- 1
Step 1: Unire le tre fonti
Raccogli dati query/page di GSC, schede delle idee e inventario degli articoli in una tabella, conservando fonte, corrispondenza con contenuti esistenti e indicatore quickWins. - 2
Step 2: Normalizzare le keyword
Risolvi duplicati, varianti, sinonimi, maiuscole e punteggiatura, poi assegna a ogni query un intento informativo, navigazionale, comparativo o transazionale. - 3
Step 3: Eseguire il primo raggruppamento semantico
Chiedi all’IA di raggruppare per intento e produrre primary_intent, canonical_page, suggested_action, internal_link_targets e risk_notes per ogni cluster. - 4
Step 4: Validare i cluster rischiosi
Usa GSC page, alcune SERP e il giudizio umano per rilevare tutorial e confronti mescolati, conflitti con articoli esistenti, aggregazioni o frammentazioni eccessive. - 5
Step 5: Assegnare un’azione principale
Associa ogni cluster a nuovo articolo, pagina pillar, aggiornamento, FAQ, link interno o discard e registra la motivazione. - 6
Step 6: Creare il piano dei link interni
Definisci link bidirezionali pillar/cluster, destinazioni canoniche e anchor text descrittivi, poi controlla articoli orfani e rischi di duplicazione.
FAQ
Il clustering raggruppa termini simili o query con lo stesso intento?
Quando una keyword merita un articolo invece di un H2 o una FAQ?
Query GSC, domande Reddit, issue GitHub e titoli dei concorrenti possono stare nella stessa tabella?
Perché l’IA unisce keyword semanticamente vicine ma con intenti diversi?
Come scegliere tra clustering SERP-based, semantic e hybrid?
Conviene creare una pagina nuova se esiste già un articolo sul tema?
Il clustering può portare alla produzione di massa di pagine di scarso valore?
11 min di lettura · Pubblicato il: 13 nov 2026

Guida pratica all automazione dei siti di contenuti AI
Se arrivi dalla ricerca, il modo più veloce per orientarti è passare all’articolo precedente o successivo della stessa serie.
Precedente
Agente IA per la ricerca dei temi: idee per blog da Google, Reddit e GitHub
Trasforma query GSC, domande Reddit e issue GitHub in temi tecnici con livelli di prova, punteggio, deduplicazione, rischi e revisione umana.
Parte 2 di 4
Successivo
Come scrivere un blog tecnico con l’AI: ricerca, verifica del codice e revisione umana
Collega fonti, esecuzione del codice, verifica dei fatti e QA in un flusso editoriale affidabile che riporta ogni errore alla fase responsabile.
Parte 4 di 4


Commenti
Accedi con GitHub per lasciare un commento