
关键词聚类自动化:用 AI 把搜索词整理成系列、文章和内链结构
"Google Search Central:创建有用、可靠、以用户为先的内容"
手里有一张 keywords.csv,300 行 query,覆盖 Astro、Docker、Cloudflare 这些主题。AI 初分出了 42 个 cluster,但人工检查时发现 cluster #1 同时放着 astro seo 和 astro vs next.js for seo——前者是教程意图,后者是对比意图。混在一起,写出来的文章很难同时满足两种需求。
关键词聚类的问题就在这里:AI 容易把语义相近但意图不同的词合并,进而增加内容 cannibalization 风险,让多篇近似文章互相竞争。更麻烦的是,看着一堆“关键词组”,仍然不知道哪些该写成新文、哪些应该补旧文、哪些只适合 FAQ 或内链。
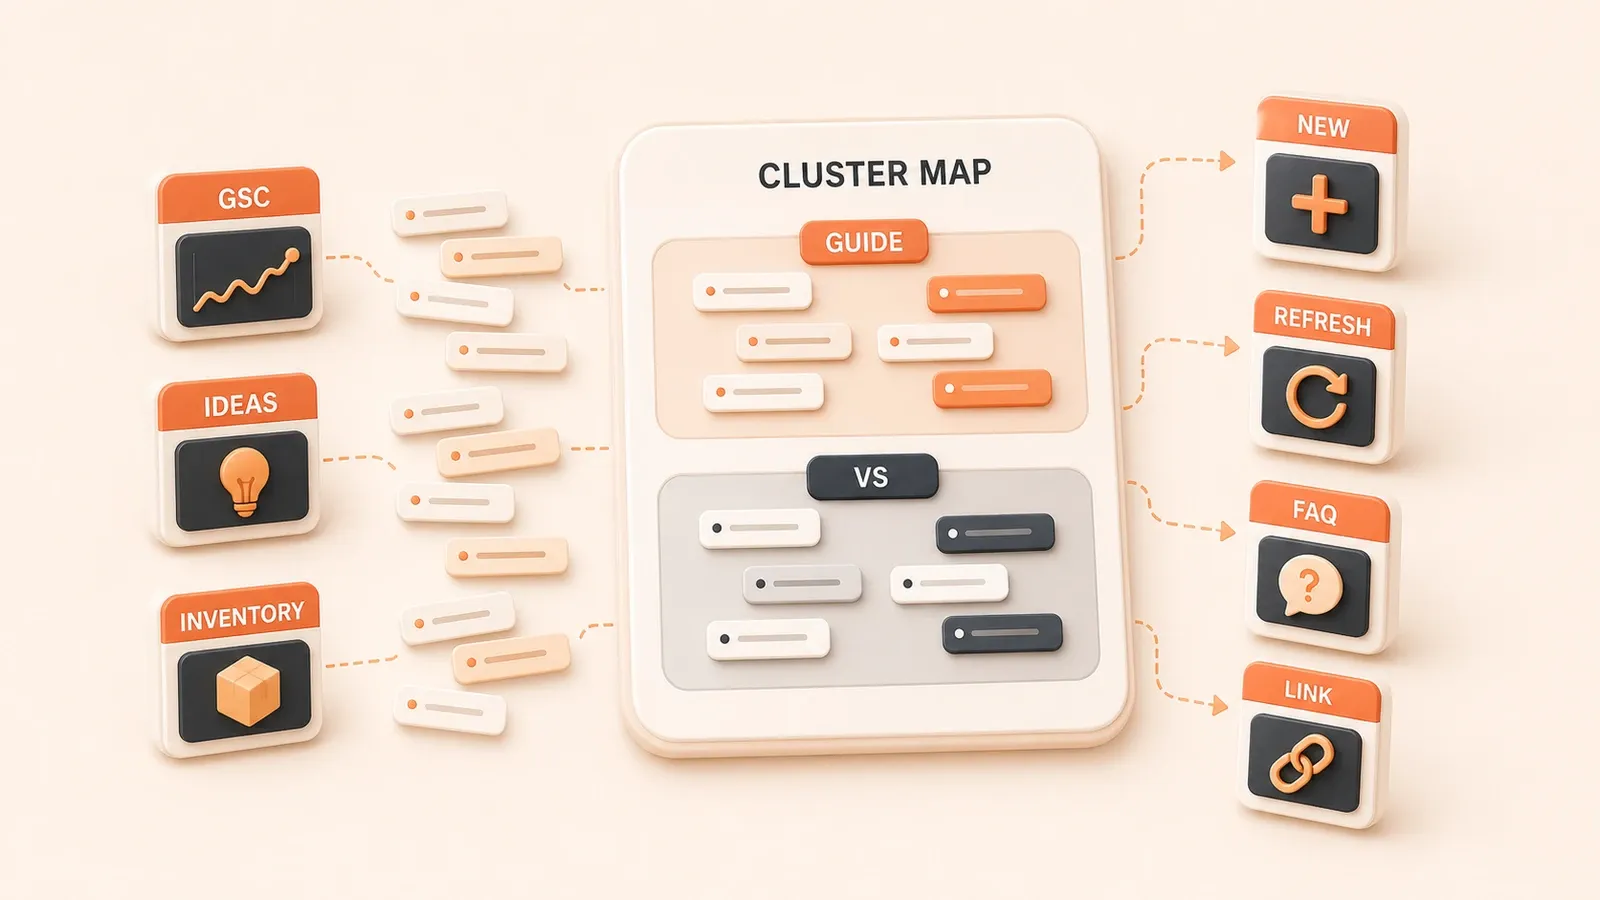
下面的流程从 GSC query、候选题卡片和站内库存整理成合并表开始,归一化去重,AI 初分保留人工审核,最后把每个 cluster 映射到具体动作(新文/旧文刷新/FAQ/内链/discard)。重点是数据源、去重逻辑、聚类方法对比、AI prompt 示例、cluster map 表格、动作判断框架和内链结构设计。
一、关键词聚类流程入口:数据源清单
聚类的输入不是“AI 猜词”,而是自有 query/page 数据、候选题卡片和站内库存。这三样东西组合起来,才能判断哪些词值得写、哪些已经有旧文承接、哪些是社区真实问题。
数据源清单如下:
| 数据源 | 字段 | 获取方式 | 注意事项 |
|---|---|---|---|
| GSC query/page 数据 | query, page, clicks, impressions, CTR, position | Search Console UI / Search Analytics API | API rowLimit 默认 1,000、单次最大 25,000;受内部限制影响,不保证返回全部行,只返回 top rows |
| 候选题卡片 | 标题, 意图, 来源(Reddit/GitHub/竞品), 证据 | 选题调研 Agent 输出 | 需人工审核来源质量 |
| 站内库存 | 文章标题, URL, 系列, 发布日期, 流量, 关键词排名 | 站内数据库 / CMS | 标记已有旧文和系列归属 |
| quickWins 指标 | 低 CTR 高 impression 关键词, 旧文刷新机会 | GSC quickWins 分析 | 用于旧文刷新动作判断 |
步骤块:
- 导出 GSC query/page 数据;Performance report 默认展示近三个月,也可以按任务调整日期范围
- 合并选题调研 Agent 输出的候选题卡片
- 提取站内库存:已有文章、系列、流量表现
- 标记 quickWins:低 CTR 高 impression 关键词、旧文刷新机会
- 输出合并表:每行包含 query、意图初判、来源、已有旧文匹配、quickWins 标记
二、关键词归一化:去重、标准化、意图初判
合并表里会有大量重复、相似、拼写变体。如果不处理,AI 初分时会把这些当成不同词,拆成多个 cluster,造成过度拆分。
去重逻辑清单:
- 完全重复:
astro seovsastro seo→ 保留一条 - 拼写变体:
docker host.docker.internalvsdocker host-gatewayvsdocker 127.0.0.1→ 标记为同一意图候选,等待人工确认 - 同义词:
cloudflare pricingvscloudflare 价格vscloudflare cost→ 标记为同一意图 - 实体词形变化:
astro blogvsastro blogs→ 标记为同一意图
标准化规则:
- 统一术语:
nextjs→next.js,cloudflare workers→Cloudflare Workers - 统一大小写:
Astrovsastro→astro - 统一标点:
astro, seovsastro seo→astro seo
意图初判标记:
- 信息型:how to, what is, guide, tutorial
- 导航型:品牌名、产品名、特定 URL
- 对比型:vs, compare, alternative
- 交易型:pricing, cost, buy, download
步骤块:
- 对合并表进行完全重复去重
- 识别拼写变体和同义词,标记为同一意图候选
- 标准化术语、大小写、标点
- 为每个 query 标记意图初判(信息型/导航型/对比型/交易型)
- 输出归一化表:每行包含 query、normalized_query、intent_tag、source、old_post_match
三、聚类方法选择:三种方法对比判断表
选择聚类方法时,要平衡成本、准确度和风险。三种主流方法各有适用场景。
| 方法 | 成本 | 准确度 | 适用场景 | 风险 |
|---|---|---|---|---|
| SERP-based | 高(需要大量 SERP 查询,可能触发反爬) | 高(基于真实搜索结果,适合辅助判断是否合并页面) | 内容已上线、需要判断页面重合、有 SERP API 预算 | 成本高、SERP 波动影响稳定性 |
| Semantic | 低(只需 embedding API 调用) | 中(可能忽略真实搜索意图,误合并不同意图) | 早期主题地图、预算有限、快速初分 | 可能误合并语义相近但意图不同的词 |
| Hybrid | 中(语义初分 + SERP/GSC 校验 + 人工审核) | 高(兼顾成本和准确度) | 持续内容运营、有 GSC 数据、有人工审核时间 | 需要人工审核投入 |
推荐流程:
- 小团队 / 早期:Semantic 初分 + GSC/page 校验 + 人工合并高风险 cluster
- 中大型团队 / 已上线内容:Hybrid(语义初分 + SERP/GSC 校验 + 人工审核)
- 预算充足 + 需要判断页面是否合并:SERP-based + 人工审核
我目前用的是 Hybrid:先用语义相似度初分,然后用 GSC page 数据校验(看哪些 query 已经有旧文承接),最后人工审核意图冲突。
四、AI 辅助聚类执行流程:prompt 示例、cluster map 表格
把归一化后的关键词交给 AI 初分,关键是 prompt 要明确输出字段和意图标记。下面是我用的 prompt 示例。
AI prompt 示例:
你是一个 SEO 内容规划师,以下是一组归一化后的关键词,请按搜索意图将它们分成多个 cluster,并为每个 cluster 提供:
1. primary_intent(主要搜索意图)
2. canonical_page(建议合并到的目标页面类型:new article / old post refresh / FAQ / discard)
3. suggested_action(建议动作)
4. internal_link_targets(应该链接到哪些已有文章或系列)
5. risk_notes(风险提示:是否可能 cannibalization、是否需要人工审核)

关键词列表:
- astro seo
- astro vs next js for seo
- cloudflare pricing
- docker host.docker.internal
- docker host-gateway
...

输出格式:
JSON 数组,每个 cluster 包含:
{
  "cluster_id": 1,
  "keywords": ["astro seo", ...],
  "primary_intent": "信息型 - 教程",
  "canonical_page": "new article",
  "suggested_action": "新建 Astro SEO 教程文章",
  "internal_link_targets": ["astro-guide 系列", "cloudflare-bindui 系列"],
  "risk_notes": "需要人工审核:astro vs next js for seo 是对比意图,不应合并"
}
cluster map 表格示例:
| cluster_id | keywords | primary_intent | canonical_page | suggested_action | internal_link_targets | risk_notes |
|---|---|---|---|---|---|---|
| 1 | astro seo, astro blog seo | 信息型 - 教程 | new article | 新建 Astro SEO 教程 | astro-guide 系列, cloudflare-bindui 系列 | 无 |
| 2 | astro vs next js for seo | 对比型 | new article | 新建 Astro vs Next.js SEO 对比文 | astro-guide 系列, nextjs-blog-series | 无 |
| 3 | cloudflare pricing, cloudflare cost, cloudflare 价格 | 交易型 | old post refresh | 刷新已有 Cloudflare 价格文章 | cloudflare-bindui 系列 | 已有旧文 /cloudflare-pricing,建议刷新 |
| 4 | docker host.docker.internal, docker host-gateway, docker 127.0.0.1 | 信息型 - 配置 | FAQ | 在 Docker 系列文章中补充 FAQ | docker-practice 系列 | 同意图变体,合并到 FAQ |
人工审核清单:
- 意图不同:同一 cluster 中包含教程意图和对比意图 → 拆分
- 同主题已有旧文:cluster 映射到“新建文章”,但站内已有相关旧文 → 改为“旧文刷新”或“FAQ 补充”
- 过度拆分:一个意图被拆成多个 cluster → 合并
- 过度合并:不同意图的词被 AI 合并 → 拆分
步骤块:
- 将归一化表导入 AI 聚类工具(Claude / ChatGPT / 自建脚本)
- 使用上述 prompt 进行初分
- 输出 cluster map 表格
- 人工审核:检查意图冲突、旧文匹配、过度拆分/合并
- 修正 cluster map,标记高风险 cluster
五、聚类结果映射决策框架:动作判断表
聚类完成后,每个 cluster 要映射到具体动作,而不是停留在“关键词组”。下面这张表是我用的判断框架。

| 判断维度 | 新文 | 系列支柱页 | 旧文刷新 | FAQ 补充 | 内链优化 | discard |
|---|---|---|---|---|---|---|
| query 数量 | 多(5+) | 多(5+) | 少(1-3) | 少(1-3) | 少(1-3) | 单个 |
| 意图变化度 | 高 | 高 | 低 | 低 | 低 | 低 |
| 已有旧文匹配 | 无 | 无 | 有 | 有 | 有 | 有 |
| 竞争强度 | 高 | 高 | 中 | 中 | 低 | 低 |
| 站点主题匹配 | 高 | 高 | 高 | 中 | 中 | 低 |
| 原创增量空间 | 高 | 高 | 低 | 低 | 低 | 无 |
| 示例 | astro seo 教程 | astro 系列 | cloudflare pricing | docker host.docker.internal | 相关文章内链 | 品牌名变体 |
动作定义:
- 新文:创建新文章,覆盖 cluster 中所有同意图 query
- 系列支柱页:创建系列 hub 页面,链接到系列内其他文章
- 旧文刷新:在已有旧文中补充内容,覆盖新 query
- FAQ 补充:在已有文章中补充 FAQ
- 内链优化:在相关文章中添加内链,指向 canonical 页面
- discard:不创建内容,标记为低价值或非目标用户
步骤块:
- 根据判断维度为每个 cluster 评分
- 根据评分映射到动作
- 输出动作列表:cluster_id → suggested_action
- 人工复核高风险动作(新文、系列支柱页)
表中的 query 数量只是示例信号,不是机械阈值。最终动作仍要结合搜索意图、站内库存、原创增量和维护成本判断。
六、内链结构设计:双向链接、canonical 指向
cluster 之间的关系要变成可执行的内链,不只是“相关阅读”。下面是我用的内链清单。
内链结构设计原则:
- pillar/cluster 双向链接:pillar 页面链接到所有 cluster 页面,cluster 页面链接回 pillar 页面
- anchor text 描述性:使用描述性 anchor text,避免“点击这里”
- 链接指向 canonical URL:避免指向重复或近似页面,链接应指向 canonical 页面
- 避免孤立文章:每篇文章至少安排一条上下文相关的入链,并按站点规模和读者路径补充更多入口
- cluster map 中的 internal_link_targets 字段:记录应该链接到哪些已有文章或系列
内链清单:
| cluster_id | pillar_page | cluster_pages | internal_link_targets | anchor_text 建议 |
|---|---|---|---|---|
| 1 | Astro SEO 完全指南 | astro seo 教程, astro blog seo | astro-guide 系列, cloudflare-bindui 系列 | “Astro SEO 优化”, “Cloudflare 性能优化” |
| 2 | - | astro vs next.js for seo | astro-guide 系列, nextjs-blog-series | “Astro vs Next.js 对比” |
| 3 | - | cloudflare pricing | cloudflare-bindui 系列 | “Cloudflare 价格解析” |
步骤块:
- 识别 pillar 页面和 cluster 页面
- 设计双向链接结构
- 为每个内链设计描述性 anchor text
- 检查是否有孤立文章
- 输出内链清单,导入内容任务表
Google 当前把 redirect 和 rel="canonical" 视为较强 canonical 信号,把 sitemap inclusion 视为较弱信号;这些信号可以叠加,但 Google 仍会自行选择 canonical。站内链接应一致指向你希望作为 canonical 的 URL。
七、风险边界与质量红线:避免批量页面生成器
关键词聚类不能变成批量页面生成器,否则很容易偏离 people-first 内容原则。
风险边界清单:
- 不是每个关键词变体一页:同意图 query 应合并到一个页面或一个 canonical 目标,不应拆成多个近似页面
- cluster 必须有原创增量判断:每个 cluster 都要回到读者问题、站点主题和原创增量,不能只是重写已有内容
- 合并同意图 query 到 canonical:对重复或非常相似页面,可以用 redirect、
rel="canonical"和 sitemap 等信号表达偏好,但它们的强度不同,也不能保证 Google 必然采用 - 避免 search engine-first 内容:内容优先服务用户,而不是主要为了操纵排名
- 降低 cannibalization 风险:过去为近似关键词建立大量单页,可能让多个页面竞争同一搜索意图
- 标记高风险 cluster:在 cluster map 中用 risk_notes 字段标记需要人工审核的 cluster
质量红线:

- 同主题已有旧文时,优先旧文刷新或 FAQ 补充,避免新建近似页面
- 聚类输出必须附带原创增量和站点主题匹配判断
- 内链生成时优先指向 canonical 文章,避免指向重复或近似页面
八、示例演示:astro seo、cloudflare pricing、docker
通过三个场景理解整个流程。
示例 1:astro seo vs astro vs next.js for seo(意图不同,必须拆分)
- 原始 query:
astro seo,astro vs next.js for seo,astro blog seo - 归一化:
astro seo,astro vs next js for seo,astro blog seo - AI 初分:cluster_id=1, keywords=[astro seo, astro vs next js for seo, astro blog seo]
- 人工审核:
astro seo是教程意图,astro vs next js for seo是对比意图,必须拆分 - 最终 cluster map:
- cluster_id=1: [astro seo, astro blog seo] → 新建 Astro SEO 教程文章
- cluster_id=2: [astro vs next js for seo] → 新建 Astro vs Next.js SEO 对比文
示例 2:cloudflare pricing(已有旧文,刷新而非新建)
- 原始 query:
cloudflare pricing,cloudflare cost,cloudflare 价格 - 归一化:
cloudflare pricing,cloudflare pricing,cloudflare pricing - AI 初分:cluster_id=3, keywords=[cloudflare pricing, cloudflare pricing, cloudflare pricing]
- 站内库存匹配:已有旧文
/cloudflare-pricing - 最终 cluster map:
- cluster_id=3: [cloudflare pricing, cloudflare cost, cloudflare 价格] → 旧文刷新
/cloudflare-pricing
- cluster_id=3: [cloudflare pricing, cloudflare cost, cloudflare 价格] → 旧文刷新
示例 3:docker host.docker.internal(技术关键词,归一化后合并)
- 原始 query:
docker host.docker.internal,docker host-gateway,docker 127.0.0.1 - 归一化:标记为可能相同配置意图的候选组
- AI 初分:cluster_id=4, keywords=[docker host.docker.internal, docker host-gateway, docker 127.0.0.1]
- 站内库存匹配:已有 Docker 系列文章
- 最终 cluster map:
- cluster_id=4: [docker host.docker.internal, docker host-gateway, docker 127.0.0.1] → 人工确认意图后,作为 FAQ 或小节补充到 Docker 系列文章
九、下一步与延伸阅读
聚类完成后,下一步是把 cluster map 落进内容任务表,设计字段、评分、状态机和发布计划。这部分会在系列后续文章“内容任务表设计:字段、评分、状态机与发布计划”中详细讲。
如果你想知道如何从 cluster map 生成可写大纲,可以看系列后续文章“AI 大纲生成:从 cluster map 到可写大纲的自动化流程”。批量生成内链的细节,会在“自动内链系统:批量生成相关文章链接与避坑指南”中展开。
旧文刷新策略也有专文:“GSC 旧文刷新策略:从 quickWins 到内容更新”。
已发布的相关文章:
把关键词整理成可执行内容地图
从多源输入到 cluster map、动作映射和内链清单的最小流程。
⏱️ 预计耗时: 60 分钟
- 1
步骤 1: 合并三类输入
把 GSC query/page、候选题卡片和站内文章库存放入同一张表,并保留来源、旧文匹配和 quickWins 标记。 - 2
步骤 2: 归一化关键词
处理重复、拼写变体、同义词、大小写和标点,为每条 query 标注信息型、导航型、对比型或交易型意图。 - 3
步骤 3: 运行语义初分
让 AI 按意图生成 cluster,并为每组输出 primary_intent、canonical_page、suggested_action、internal_link_targets 和 risk_notes。 - 4
步骤 4: 校验高风险 cluster
用 GSC page、必要的 SERP 结果和人工判断检查教程与对比意图混合、旧文冲突、过度合并和过度拆分。 - 5
步骤 5: 映射唯一主动作
把每个 cluster 分配到新文、系列支柱页、旧文刷新、FAQ、内链优化或 discard,并记录判断依据。 - 6
步骤 6: 输出内链清单
确定 pillar 与 cluster 的双向链接、canonical 目标和描述性锚文本,再检查孤立文章和重复页面风险。
常见问题
关键词聚类是把相似词放一起,还是按搜索意图分组?
一个关键词应该单独写一篇,还是放进已有文章的 H2 或 FAQ?
GSC query、Reddit 问法、GitHub issue 和竞品标题能放在同一张聚类表吗?
AI 为什么容易把语义相近但意图不同的词合并错?
SERP-based、semantic 和 hybrid clustering 怎么选?
同一主题已经有旧文时,应该新建页面还是更新旧文?
关键词聚类会不会变成低价值的批量页面生成?
13 分钟阅读 · 发布于: 2026年11月13日


评论
使用 GitHub 账号登录后即可评论