
Clustering de mots-clés par IA : transformer les requêtes en séries et liens internes
"Google Search Central : créer du contenu utile, fiable et centré sur les internautes"
Un fichier keywords.csv contient 300 requêtes sur Astro, Docker et Cloudflare. L’IA produit 42 clusters, mais la vérification manuelle révèle que le cluster #1 réunit astro seo et astro vs next.js for seo. Le premier correspond à une intention de tutoriel, le second à une intention de comparaison. Une seule page répondra difficilement aux deux attentes.
C’est le piège concret du clustering : l’IA peut fusionner des expressions proches sur le plan sémantique mais différentes par leur intention. Le risque de cannibalisation augmente alors, car plusieurs articles proches se disputent la même demande. Une liste de « groupes de mots-clés » ne dit pas non plus lesquels doivent devenir un article, une mise à jour, une FAQ ou un lien interne.
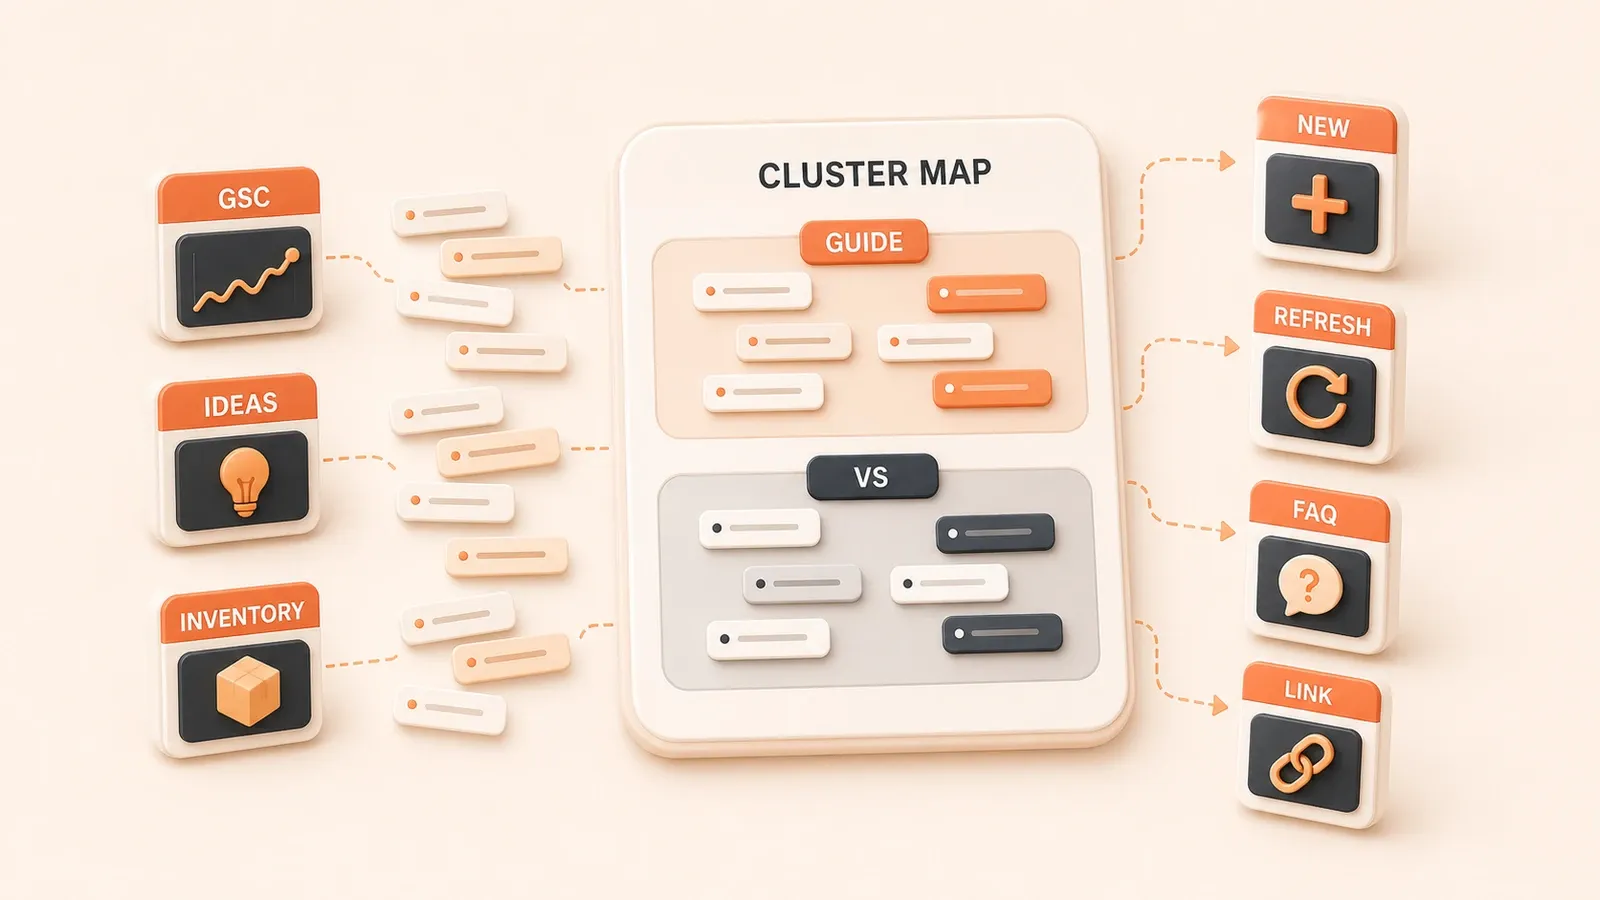
Le flux ci-dessous commence par réunir les requêtes GSC, les fiches d’idées et l’inventaire du site. Il normalise et déduplique les lignes, maintient une revue humaine après le premier passage de l’IA, puis associe chaque cluster à une action : nouvel article, mise à jour, FAQ, lien interne ou discard. Les livrables couvrent les sources, la normalisation, la comparaison des méthodes, le prompt, la cluster map, le cadre de décision et le maillage interne.
1. Réunir les bonnes sources pour le clustering de mots-clés
L’entrée n’est pas une liste inventée par l’IA. Elle combine les données query/page du site, les fiches d’idées et l’inventaire des contenus. Ensemble, ces sources indiquent les sujets utiles, les pages existantes capables de répondre à la demande et les questions réellement formulées par les communautés.
Voici le tableau des sources :
| Source | Champs | Méthode d’obtention | Points d’attention |
|---|---|---|---|
| Données GSC query/page | query, page, clicks, impressions, CTR, position | Search Console UI / Search Analytics API | Le rowLimit de l’API vaut 1 000 par défaut et 25 000 au maximum par requête ; les limites internes signifient qu’elle renvoie des top rows, sans garantir toutes les lignes |
| Fiches d’idées | titre, intention, source (Reddit/GitHub/concurrent), preuve | Sortie de l’agent de recherche | Vérifier manuellement la qualité de la source |
| Inventaire du site | titre, URL, série, date, trafic, requêtes classées | Base du site / CMS | Marquer les articles correspondants et la série |
| Indicateurs quickWins | requêtes à fortes impressions et faible CTR, possibilités d’actualisation | Analyse GSC quickWins | Aident à choisir l’action de mise à jour |
Étapes :
- Exporter les données GSC query/page. Le rapport Performance affiche par défaut les trois derniers mois, mais la période peut être adaptée.
- Ajouter les fiches produites par l’agent de recherche.
- Extraire l’inventaire : articles existants, séries et performances.
- Marquer les quick wins : impressions élevées avec faible CTR et possibilités d’actualisation.
- Produire un tableau où chaque ligne contient query, intention initiale, source, correspondance avec un article et marqueur quickWins.
2. Normaliser les mots-clés avant de les regrouper
Le tableau fusionné contient de nombreux doublons, variantes et écarts d’écriture. Sans traitement, l’IA peut les considérer comme des mots distincts et répartir une seule intention entre plusieurs clusters.
Liste de déduplication :

- Doublon exact :
astro seovsastro seo→ conserver une ligne - Variantes d’écriture ou de configuration :
docker host.docker.internalvsdocker host-gatewayvsdocker 127.0.0.1→ marquer comme candidats de même intention avant validation humaine - Synonymes :
cloudflare pricingvsprix cloudflarevscloudflare cost→ marquer comme une seule intention - Variation de forme :
astro blogvsastro blogs→ marquer comme une seule intention
Règles de normalisation :
- Unifier les termes :
nextjs→next.js,cloudflare workers→Cloudflare Workers - Unifier la casse :
Astrovsastro→astro - Unifier la ponctuation :
astro, seovsastro seo→astro seo
Labels d’intention initiaux :
- Informationnelle : how to, what is, guide, tutorial
- Navigationnelle : marque, produit, URL précise
- Comparative : vs, compare, alternative
- Transactionnelle : pricing, cost, buy, download
Étapes :
- Supprimer les doublons exacts du tableau fusionné.
- Détecter variantes et synonymes, puis les marquer comme candidats de même intention.
- Normaliser termes, casse et ponctuation.
- Attribuer à chaque query un label informationnel, navigationnel, comparatif ou transactionnel.
- Exporter un tableau normalisé avec query, normalized_query, intent_tag, source et old_post_match.
3. Comparer trois méthodes de clustering
Le choix doit équilibrer coût, précision et risque. Les trois approches principales conviennent à des stades différents.
| Méthode | Coût | Précision | Cas adapté | Risque |
|---|---|---|---|---|
| SERP-based | Élevé : nombreuses requêtes SERP et possibles limites anti-bot | Élevée : repose sur les résultats réels et aide à décider si des pages doivent fusionner | Contenu en ligne, analyse des chevauchements, budget SERP API | Coûteux ; les variations de SERP réduisent la stabilité |
| Semantic | Faible : seulement des appels d’API d’embedding | Moyenne : peut ignorer l’intention réelle et fusionner des tâches différentes | Première topic map, budget limité, premier passage rapide | Peut fusionner des termes proches mais d’intentions distinctes |
| Hybrid | Moyen : premier passage sémantique + validation SERP/GSC + revue humaine | Élevée : équilibre coût et précision | Opération continue avec données GSC et temps de revue | Demande du temps de validation humaine |
Flux recommandé :
- Petite équipe / début : premier passage Semantic + validation GSC/page + revue humaine des clusters risqués
- Équipe plus grande / contenu établi : Hybrid avec regroupement sémantique, validation SERP/GSC et revue humaine
- Budget suffisant + décision sur le chevauchement de pages : SERP-based + revue humaine
J’utilise l’option Hybrid : la proximité sémantique crée le premier regroupement, les données GSC page montrent quelles requêtes possèdent déjà une page, puis une personne résout les conflits d’intention.
4. Exécuter le clustering par IA avec une sortie définie
Lorsqu’on transmet les mots-clés normalisés à l’IA, le prompt doit préciser les champs et les règles d’intention. Voici la structure utilisée.
Exemple de prompt IA :
Vous êtes spécialiste de la planification de contenu SEO. Regroupez les mots-clés normalisés ci-dessous en clusters selon l’intention de recherche. Pour chaque cluster, fournissez :
1. primary_intent
2. canonical_page (type cible : new article / old post refresh / FAQ / discard)
3. suggested_action
4. internal_link_targets (articles ou séries existants à lier)
5. risk_notes (cannibalisation possible ou revue humaine nécessaire)

Mots-clés :
- astro seo
- astro vs next js for seo
- cloudflare pricing
- docker host.docker.internal
- docker host-gateway
...

Retournez un tableau JSON. Chaque cluster suit ce format :
{
  "cluster_id": 1,
  "keywords": ["astro seo", ...],
  "primary_intent": "informationnelle - tutoriel",
  "canonical_page": "new article",
  "suggested_action": "Créer un tutoriel Astro SEO",
  "internal_link_targets": ["série astro-guide", "série cloudflare-bindui"],
  "risk_notes": "Revue humaine : astro vs next js for seo a une intention comparative et ne doit pas être fusionné"
}
Exemple de cluster map :
| cluster_id | keywords | primary_intent | canonical_page | suggested_action | internal_link_targets | risk_notes |
|---|---|---|---|---|---|---|
| 1 | astro seo, astro blog seo | Informationnelle - tutoriel | new article | Créer un tutoriel Astro SEO | série astro-guide, série cloudflare-bindui | Aucun |
| 2 | astro vs next js for seo | Comparative | new article | Créer un comparatif SEO Astro vs Next.js | série astro-guide, nextjs-blog-series | Aucun |
| 3 | cloudflare pricing, cloudflare cost, prix cloudflare | Transactionnelle | old post refresh | Actualiser l’article sur les tarifs Cloudflare | série cloudflare-bindui | Article /cloudflare-pricing existant ; l’actualiser |
| 4 | docker host.docker.internal, docker host-gateway, docker 127.0.0.1 | Informationnelle - configuration | FAQ | Ajouter une FAQ à un article Docker | série docker-practice | Variantes de même intention à réunir dans une FAQ |
Liste de revue humaine :
- Intentions mélangées : tutoriel et comparaison dans le même cluster → séparer
- Conflit avec une page existante : cluster classé « new article » alors qu’un article proche existe → passer à old post refresh ou FAQ
- Sur-segmentation : une intention répartie entre plusieurs clusters → fusionner
- Sur-regroupement : plusieurs intentions dans un cluster → séparer
Étapes :
- Envoyer le tableau normalisé à Claude, ChatGPT ou un flux de clustering interne.
- Lancer le premier passage avec le prompt ci-dessus.
- Exporter la cluster map.
- Vérifier les conflits d’intention, les correspondances avec les anciens articles, la sur-segmentation et le sur-regroupement.
- Corriger la map et marquer les clusters à risque.
5. Associer chaque cluster à une action de contenu
Un cluster terminé doit produire une action exploitable, pas une nouvelle liste de mots-clés. Voici le tableau de décision utilisé.

| Critère | Nouvel article | Page pilier | Mise à jour | FAQ | Maillage interne | discard |
|---|---|---|---|---|---|---|
| Nombre de query | Élevé (5+) | Élevé (5+) | Faible (1–3) | Faible (1–3) | Faible (1–3) | Une |
| Variation d’intention | Élevée | Élevée | Faible | Faible | Faible | Faible |
| Article correspondant | Aucun | Aucun | Oui | Oui | Oui | Oui |
| Concurrence | Élevée | Élevée | Moyenne | Moyenne | Faible | Faible |
| Cohérence thématique | Élevée | Élevée | Élevée | Moyenne | Moyenne | Faible |
| Potentiel de valeur originale | Élevé | Élevé | Faible | Faible | Faible | Aucun |
| Exemple | tutoriel astro seo | série astro | cloudflare pricing | docker host.docker.internal | liens entre articles | variante de marque |
Définition des actions :
- Nouvel article : créer une page couvrant toutes les requêtes de même intention du cluster.
- Page pilier : créer un hub de série relié aux autres pages du cluster.
- Mise à jour : étendre une page existante pour couvrir les nouvelles requêtes.
- FAQ : ajouter une réponse ciblée à un article existant.
- Maillage interne : ajouter des liens contextuels vers la page canonique.
- Discard : ne pas créer de contenu et marquer la requête comme peu utile ou hors cible.
Étapes :
- Évaluer chaque cluster selon les critères.
- Associer l’évaluation à une action.
- Exporter la liste sous la forme cluster_id → suggested_action.
- Faire valider manuellement les actions à risque : nouveaux articles et pages piliers.
Le nombre de requêtes est un signal d’exemple, pas un seuil automatique. L’action finale dépend toujours de l’intention, de l’inventaire, de la valeur originale et du coût de maintenance.
6. Concevoir les liens internes comme une carte de navigation
Les relations entre clusters doivent devenir des liens exécutables, pas un bloc générique « articles associés ». Voici la structure utilisée.
Principes du maillage interne :
- Liens bidirectionnels pillar/cluster : la page pillar lie toutes les pages cluster, et chaque page cluster revient vers la pillar.
- Ancre descriptive : décrire l’intention cible plutôt qu’écrire « cliquez ici ».
- Cible canonique : éviter les pages dupliquées ou très proches et pointer vers l’URL canonique souhaitée.
- Pas d’article orphelin : prévoir au moins un lien contextuel entrant pour chaque article, puis ajouter d’autres chemins selon l’architecture et le parcours du lecteur.
- Champ
internal_link_targets: noter les articles ou séries existants qui doivent recevoir un lien.
Plan de maillage :
| cluster_id | pillar_page | cluster_pages | internal_link_targets | Ancre suggérée |
|---|---|---|---|---|
| 1 | Guide Astro SEO | tutoriel astro seo, astro blog seo | série astro-guide, série cloudflare-bindui | « optimiser le SEO d’Astro », « optimiser les performances Cloudflare » |
| 2 | - | astro vs next.js for seo | série astro-guide, nextjs-blog-series | « comparatif Astro et Next.js » |
| 3 | - | cloudflare pricing | série cloudflare-bindui | « tarifs Cloudflare expliqués » |
Étapes :
- Identifier les pages pillar et cluster.
- Concevoir la structure bidirectionnelle.
- Choisir une ancre descriptive pour chaque lien.
- Rechercher les articles orphelins.
- Exporter le plan vers le tableau des tâches de contenu.
Google considère actuellement les redirections et rel="canonical" comme des signaux forts, tandis que l’inclusion dans un sitemap est plus faible. Ces signaux peuvent se renforcer, mais Google choisit toujours la canonique. Les liens internes doivent pointer de façon cohérente vers l’URL préférée.
7. Poser des limites avant que le clustering ne produise des pages en masse
Le clustering ne doit pas devenir un générateur de pages. Ce fonctionnement s’éloigne vite des principes de contenu centré sur les internautes.
Limites de risque :
- Ne pas créer une page par variante. Les query partageant une intention convergent vers une page ou une cible canonique.
- Exiger une décision de valeur originale. Chaque cluster doit répondre à un problème du lecteur, au thème du site et à un apport réel par rapport au contenu existant.
- Consolider les query de même intention autour d’une canonique. Pour des pages dupliquées ou très proches, les redirections,
rel="canonical"et sitemaps expriment une préférence, mais leur force varie et le choix de Google n’est pas garanti. - Éviter le contenu search-engine-first. L’objectif principal est d’aider le lecteur, pas de manipuler le classement.
- Réduire la cannibalisation. Publier plusieurs pages pour des mots presque identiques peut faire concurrencer plusieurs URL sur la même intention.
- Marquer les clusters risqués. Le champ risk_notes impose une revue humaine.
Lignes rouges de qualité :
- Quand un article correspondant existe, préférer sa mise à jour ou une FAQ à une nouvelle page proche.
- Chaque sortie doit évaluer la cohérence thématique et la valeur originale.
- Les liens internes pointent vers l’article canonique et non vers des pages dupliquées ou proches.
8. Vérifier le flux avec Astro SEO, Cloudflare Pricing et Docker
Trois scénarios rendent le processus concret.
Exemple 1 : astro seo vs astro vs next.js for seo (intentions différentes, donc séparation)
- Query d’origine :
astro seo,astro vs next.js for seo,astro blog seo - Normalisation :
astro seo,astro vs next js for seo,astro blog seo - Premier passage IA : cluster_id=1, keywords=[astro seo, astro vs next js for seo, astro blog seo]
- Revue humaine :
astro seovise un tutoriel,astro vs next js for seoun comparatif ; il faut les séparer. - Cluster map finale :
- cluster_id=1: [astro seo, astro blog seo] → créer un tutoriel Astro SEO
- cluster_id=2: [astro vs next js for seo] → créer un comparatif SEO Astro vs Next.js
Exemple 2 : cloudflare pricing (un article existe, donc mise à jour)
- Query d’origine :
cloudflare pricing,cloudflare cost,prix cloudflare - Normalisation :
cloudflare pricing,cloudflare pricing,cloudflare pricing - Premier passage IA : cluster_id=3, keywords=[cloudflare pricing, cloudflare pricing, cloudflare pricing]
- Correspondance inventaire : article
/cloudflare-pricingexistant - Cluster map finale :
- cluster_id=3: [cloudflare pricing, cloudflare cost, prix cloudflare] → actualiser
/cloudflare-pricing
- cluster_id=3: [cloudflare pricing, cloudflare cost, prix cloudflare] → actualiser
Exemple 3 : docker host.docker.internal (normaliser des requêtes techniques proches)
- Query d’origine :
docker host.docker.internal,docker host-gateway,docker 127.0.0.1 - Normalisation : les marquer comme groupe candidat pour la même intention de configuration.
- Premier passage IA : cluster_id=4, keywords=[docker host.docker.internal, docker host-gateway, docker 127.0.0.1]
- Correspondance inventaire : une série Docker existe
- Cluster map finale :
- cluster_id=4: [docker host.docker.internal, docker host-gateway, docker 127.0.0.1] → après validation humaine de l’intention, ajouter une FAQ ou une section à un article Docker
9. Transmettre la content map au flux suivant
Une fois le clustering terminé, la cluster map rejoint le tableau des tâches de contenu, avec ses champs, scores, états et calendrier de publication. L’article suivant de la série, « Concevoir un tableau de tâches de contenu : champs, scores, états et publication », traite cette étape.
Pour transformer une cluster map en plan rédactionnel, poursuivez avec « Génération de plan par IA : de la cluster map à une structure exploitable ». « Maillage interne automatisé : produire des liens en lot et éviter les pièges » détaillera ensuite l’insertion des liens.
La mise à jour d’anciens articles dispose de son propre guide : « Stratégie GSC d’actualisation : des quick wins aux mises à jour ».
Articles associés déjà publiés :
- Planification trimestrielle pour blogs techniques avec le modèle Pillar-Cluster
- SOP hebdomadaire GA/GSC : des données aux actions
- Techniques GSC avancées pour trouver des opportunités de contenu
Transformer des mots-clés en content map exploitable
Un flux minimal depuis plusieurs sources jusqu’à la cluster map, aux actions de contenu et au plan de maillage interne.
⏱️ Estimated time: 60 min
- 1
Step 1: Réunir les trois sources
Placez les données query/page de GSC, les fiches d’idées et l’inventaire des articles dans un même tableau, en conservant la source, l’article correspondant et le marqueur quickWins. - 2
Step 2: Normaliser les mots-clés
Traitez les doublons, variantes, synonymes, différences de casse et ponctuation, puis attribuez une intention informationnelle, navigationnelle, comparative ou transactionnelle. - 3
Step 3: Lancer un premier regroupement sémantique
Demandez à l’IA de regrouper par intention et de produire primary_intent, canonical_page, suggested_action, internal_link_targets et risk_notes pour chaque cluster. - 4
Step 4: Valider les clusters à risque
Utilisez GSC page, quelques SERP et un jugement humain pour repérer le mélange tutoriel/comparatif, les conflits avec des articles existants et les regroupements trop larges ou trop fins. - 5
Step 5: Attribuer une action principale
Affectez chaque cluster à un nouvel article, une page pilier, une mise à jour, une FAQ, une optimisation des liens ou discard, puis consignez la justification. - 6
Step 6: Produire le plan de liens internes
Définissez les liens bidirectionnels pillar/cluster, les cibles canoniques et les ancres descriptives, puis recherchez les articles orphelins et les risques de doublon.
FAQ
Le clustering regroupe-t-il les termes similaires ou les requêtes partageant la même intention ?
Quand un mot-clé mérite-t-il un article plutôt qu’un H2 ou une FAQ ?
Peut-on mélanger requêtes GSC, questions Reddit, issues GitHub et titres concurrents dans le même tableau ?
Pourquoi l’IA fusionne-t-elle des mots proches mais porteurs d’intentions différentes ?
Comment choisir entre clustering SERP-based, semantic et hybrid ?
Faut-il créer une nouvelle page si un article existe déjà sur le thème ?
Le clustering peut-il conduire à produire en masse des pages de faible valeur ?
12 min de lecture · Publié le: 13 nov. 2026

Guide pratique de l automatisation des sites de contenu IA
Si vous arrivez depuis la recherche, le plus rapide est de passer à l’article précédent ou suivant de cette série.
Précédent
Agent IA de recherche de sujets : trouver des idées de blogs avec Google, Reddit et GitHub
Transformez les requêtes GSC, les questions Reddit et les issues GitHub en sujets techniques avec niveaux de preuve, score, déduplication, risques et validation humaine.
Partie 2 sur 4
Suivant
Écrire un blog technique avec l’IA : recherche, validation du code et relecture humaine
Reliez sources, exécution du code, contrôle des faits et QA dans un processus éditorial fiable, avec un retour clair vers l’étape qui a échoué.
Partie 4 sur 4


Commentaires
Connectez-vous avec GitHub pour laisser un commentaire