
Clustering de palavras-chave com IA: de consultas a séries e links internos
"Google Search Central: criar conteúdo útil, confiável e focado nas pessoas"
Você tem um arquivo keywords.csv com 300 consultas sobre Astro, Docker e Cloudflare. A IA produz 42 clusters, mas a revisão manual encontra astro seo e astro vs next.js for seo juntos no cluster #1. A primeira consulta pede tutorial; a segunda, comparação. Uma única página dificilmente resolverá as duas tarefas.
Essa é a falha prática do clustering: a IA pode juntar expressões semanticamente próximas que carregam intenções diferentes. Isso aumenta o risco de canibalização, pois vários artigos quase iguais passam a disputar a mesma demanda. Uma lista de “grupos de palavras-chave” também não diz quais grupos precisam de artigo novo, atualização, FAQ ou link interno.
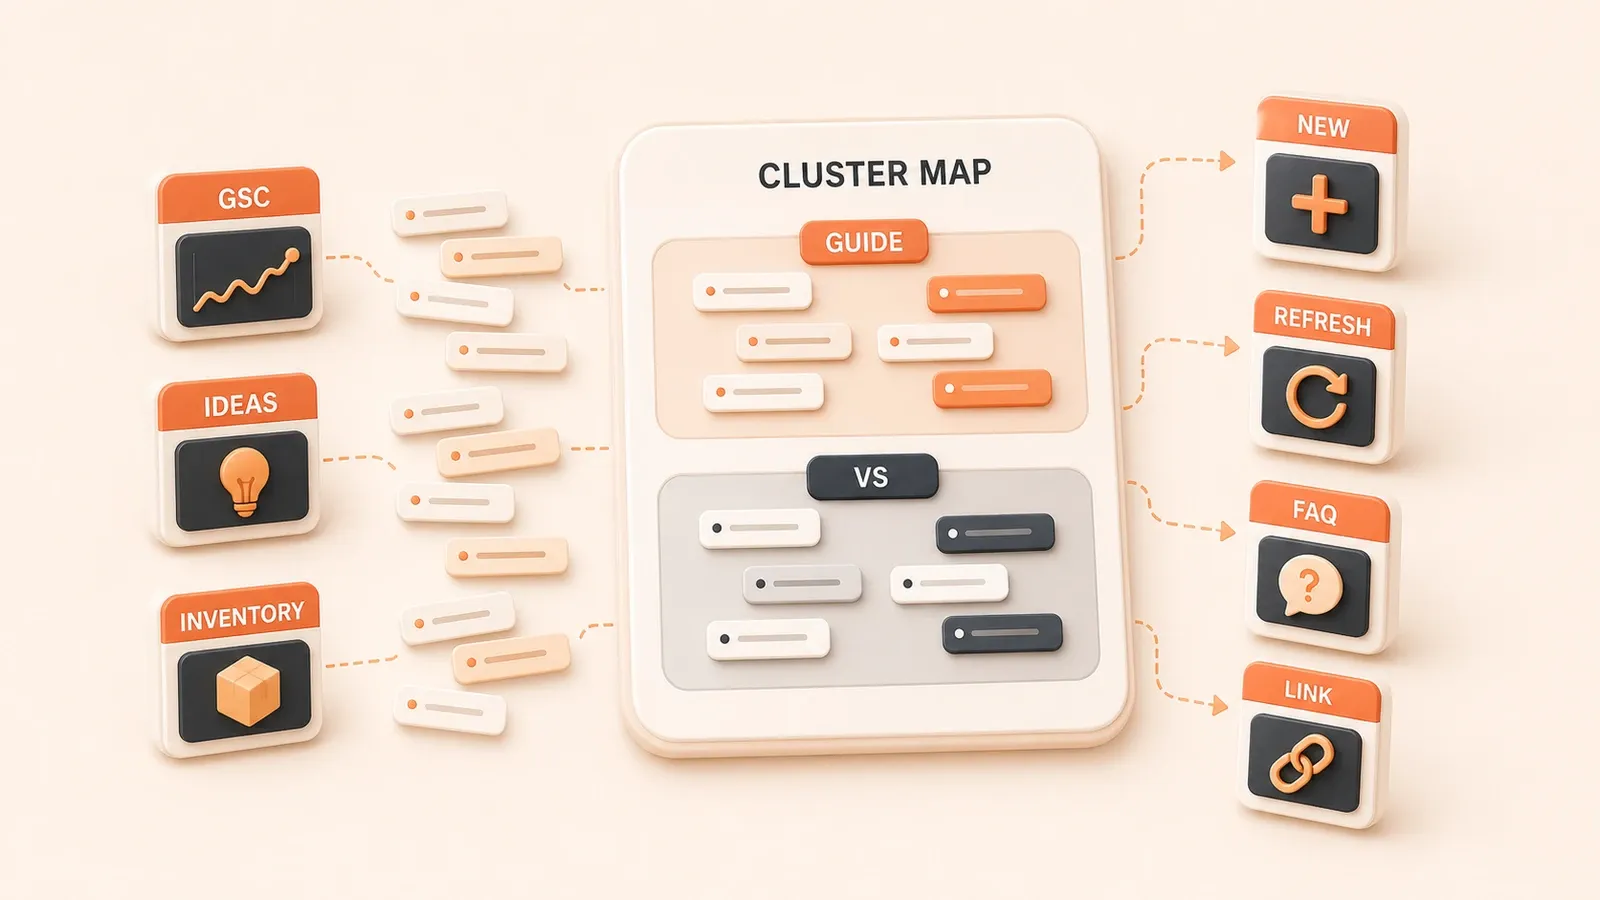
O fluxo abaixo começa reunindo consultas do GSC, fichas de ideias e inventário do site. Ele normaliza e remove duplicatas, mantém revisão humana após o primeiro agrupamento da IA e associa cada cluster a uma ação: artigo novo, atualização, FAQ, link interno ou discard. As entregas incluem fontes, lógica de normalização, comparação de métodos, prompt, cluster map, critérios de ação e estrutura de links.
1. Reunir as fontes corretas para o clustering
A entrada não é uma lista inventada pela IA. Ela reúne dados query/page próprios, fichas de ideias e inventário de conteúdo. Juntas, essas fontes mostram quais temas valem uma página, quais já têm artigo e quais perguntas aparecem de verdade nas comunidades.
Use esta lista de fontes:
| Fonte | Campos | Como obter | Atenção |
|---|---|---|---|
| Dados GSC query/page | query, page, clicks, impressions, CTR, position | Search Console UI / Search Analytics API | O rowLimit da API é 1.000 por padrão e 25.000 por solicitação no máximo; limites internos fazem com que ela retorne top rows sem garantir todas as linhas |
| Fichas de ideias | título, intenção, fonte (Reddit/GitHub/concorrente), evidência | Saída do agente de pesquisa | Revisar manualmente a qualidade da fonte |
| Inventário do site | título, URL, série, data, tráfego, consultas posicionadas | Banco do site / CMS | Marcar artigos correspondentes e série |
| Métricas quickWins | consultas com muitas impressions e CTR baixo, oportunidades de atualização | Análise GSC quickWins | Ajudam na decisão de atualizar |
Etapas:
- Exporte dados query/page do GSC. O relatório Performance mostra por padrão os últimos três meses, mas o período pode ser ajustado.
- Adicione as fichas produzidas pelo agente de pesquisa.
- Extraia o inventário: artigos existentes, séries e desempenho.
- Marque quick wins: muitas impressions, CTR baixo e oportunidades de atualização.
- Gere uma tabela com query, intenção inicial, fonte, correspondência com artigo existente e marca quickWins.
2. Normalizar palavras-chave antes de agrupá-las
A tabela combinada contém duplicatas, variações e diferenças de escrita. Sem tratamento, a IA pode considerá-las termos distintos e dividir uma intenção entre vários clusters.
Lista de deduplicação:
- Duplicata exata:
astro seovsastro seo→ manter uma linha - Variações de escrita ou configuração:
docker host.docker.internalvsdocker host-gatewayvsdocker 127.0.0.1→ marcar como candidatas à mesma intenção e aguardar confirmação humana - Sinônimos:
cloudflare pricingvspreço cloudflarevscloudflare cost→ marcar como uma intenção - Variação de forma:
astro blogvsastro blogs→ marcar como uma intenção
Regras de normalização:
- Padronizar termos:
nextjs→next.js,cloudflare workers→Cloudflare Workers - Padronizar maiúsculas:
Astrovsastro→astro - Padronizar pontuação:
astro, seovsastro seo→astro seo
Rótulos iniciais de intenção:
- Informacional: how to, what is, guide, tutorial
- Navegacional: marca, produto, URL específica
- Comparativa: vs, compare, alternative
- Transacional: pricing, cost, buy, download
Etapas:
- Remova duplicatas exatas da tabela combinada.
- Detecte variações e sinônimos e marque como candidatas à mesma intenção.
- Normalize termos, maiúsculas e pontuação.
- Rotule cada query como informacional, navegacional, comparativa ou transacional.
- Exporte uma tabela com query, normalized_query, intent_tag, source e old_post_match.
3. Comparar três métodos de clustering
A escolha deve equilibrar custo, precisão e risco. Os três métodos principais se encaixam em etapas diferentes.
| Método | Custo | Precisão | Cenário adequado | Risco |
|---|---|---|---|---|
| SERP-based | Alto: muitas consultas SERP e possíveis limites anti-bot | Alta: usa resultados reais e ajuda a decidir se páginas devem ser unidas | Conteúdo publicado, análise de sobreposição e orçamento de SERP API | Caro; mudanças na SERP reduzem estabilidade |
| Semantic | Baixo: apenas chamadas a API de embeddings | Média: pode ignorar intenção real e unir tarefas diferentes | Primeiro mapa temático, orçamento limitado e agrupamento rápido | Pode unir palavras próximas no significado, mas diferentes na intenção |
| Hybrid | Médio: primeira etapa semântica + validação SERP/GSC + revisão humana | Alta: equilibra custo e precisão | Operação contínua com dados do GSC e tempo de revisão | Exige capacidade de revisão humana |
Fluxo recomendado:
- Equipe pequena / início: primeira etapa Semantic + validação GSC/page + revisão humana de clusters de risco
- Equipe maior / conteúdo estabelecido: Hybrid com agrupamento semântico, validação SERP/GSC e revisão humana
- Orçamento suficiente + decisão sobre sobreposição: SERP-based + revisão humana
Eu uso Hybrid: a similaridade semântica produz o primeiro agrupamento, os dados GSC page mostram quais consultas já têm página e uma pessoa resolve conflitos de intenção.
4. Executar clustering com IA e uma saída definida
Ao enviar palavras normalizadas para a IA, o prompt deve definir campos e regras de intenção. Esta é a estrutura usada.
Exemplo de prompt para IA:
Você é especialista em planejamento de conteúdo SEO. Agrupe as palavras-chave normalizadas abaixo em clusters por intenção de busca. Para cada cluster, entregue:
1. primary_intent
2. canonical_page (tipo recomendado: new article / old post refresh / FAQ / discard)
3. suggested_action
4. internal_link_targets (artigos ou séries existentes que devem receber links)
5. risk_notes (possível canibalização ou revisão humana necessária)

Palavras-chave:
- astro seo
- astro vs next js for seo
- cloudflare pricing
- docker host.docker.internal
- docker host-gateway
...

Retorne um array JSON. Cada cluster deve seguir:
{
  "cluster_id": 1,
  "keywords": ["astro seo", ...],
  "primary_intent": "informacional - tutorial",
  "canonical_page": "new article",
  "suggested_action": "Criar tutorial de Astro SEO",
  "internal_link_targets": ["série astro-guide", "série cloudflare-bindui"],
  "risk_notes": "Revisão humana: astro vs next js for seo tem intenção comparativa e não deve ser unido"
}
Exemplo de cluster map:
| cluster_id | keywords | primary_intent | canonical_page | suggested_action | internal_link_targets | risk_notes |
|---|---|---|---|---|---|---|
| 1 | astro seo, astro blog seo | Informacional - tutorial | new article | Criar tutorial de Astro SEO | série astro-guide, série cloudflare-bindui | Nenhum |
| 2 | astro vs next js for seo | Comparativa | new article | Criar comparativo SEO Astro vs Next.js | série astro-guide, nextjs-blog-series | Nenhum |
| 3 | cloudflare pricing, cloudflare cost, preço cloudflare | Transacional | old post refresh | Atualizar artigo de preços do Cloudflare | série cloudflare-bindui | Existe /cloudflare-pricing; atualizar |
| 4 | docker host.docker.internal, docker host-gateway, docker 127.0.0.1 | Informacional - configuração | FAQ | Adicionar FAQ a um artigo de Docker | série docker-practice | Variações da mesma intenção; unir em uma FAQ |
Lista de revisão humana:
- Intenção misturada: um cluster contém tutorial e comparação → separar
- Conflito com página existente: cluster marcado como “new article”, mas existe artigo relacionado → mudar para old post refresh ou FAQ
- Fragmentação excessiva: uma intenção aparece em vários clusters → unir
- União excessiva: várias intenções aparecem em um cluster → separar
Etapas:
- Envie a tabela normalizada ao Claude, ChatGPT ou fluxo interno de clustering.
- Execute o primeiro agrupamento com o prompt acima.
- Exporte o cluster map.
- Revise conflitos de intenção, correspondências com artigos, fragmentação e união excessivas.
- Corrija o mapa e marque clusters de risco.
5. Atribuir cada cluster a uma ação de conteúdo
Um cluster concluído precisa de ação executável, não de outra lista de palavras. Uso esta tabela de decisão.

| Fator | Artigo novo | Página pilar | Atualização | FAQ | Links internos | discard |
|---|---|---|---|---|---|---|
| Número de query | Muitas (5+) | Muitas (5+) | Poucas (1–3) | Poucas (1–3) | Poucas (1–3) | Uma |
| Variação de intenção | Alta | Alta | Baixa | Baixa | Baixa | Baixa |
| Artigo existente | Não | Não | Sim | Sim | Sim | Sim |
| Concorrência | Alta | Alta | Média | Média | Baixa | Baixa |
| Aderência temática | Alta | Alta | Alta | Média | Média | Baixa |
| Espaço para valor original | Alto | Alto | Baixo | Baixo | Baixo | Nenhum |
| Exemplo | tutorial astro seo | série astro | cloudflare pricing | docker host.docker.internal | links entre artigos | variação de marca |
Definição das ações:
- Artigo novo: criar uma página que cubra todas as consultas com a mesma intenção.
- Página pilar: criar um hub de série que se conecte às demais páginas do cluster.
- Atualização: ampliar uma página existente para cobrir novas consultas.
- FAQ: adicionar resposta específica a um artigo existente.
- Links internos: adicionar links contextuais para a página canônica.
- Discard: não criar conteúdo e marcar a consulta como pouco valiosa ou fora do público.
Etapas:
- Pontue cada cluster com os fatores de decisão.
- Converta a pontuação em uma ação.
- Exporte uma lista cluster_id → suggested_action.
- Revise manualmente ações de risco: artigos novos e páginas pilar.
As quantidades de query são exemplos, não limites automáticos. A ação final também depende de intenção, inventário, valor original e custo de manutenção.
6. Projetar links internos como mapa de navegação
As relações entre clusters devem virar links executáveis, não um bloco genérico de “artigos relacionados”. Esta é a estrutura.
Princípios de links internos:
- Links bidirecionais pillar/cluster: a página pillar aponta para todas as cluster e cada cluster volta para a pillar.
- Texto de âncora descritivo: explicar a intenção de destino em vez de escrever “clique aqui”.
- Destino canônico: evitar páginas duplicadas ou quase iguais e apontar para a URL canônica preferida.
- Sem artigos órfãos: planejar pelo menos um link contextual de entrada por artigo e adicionar caminhos conforme arquitetura e jornada de leitura.
- Campo
internal_link_targets: registrar quais artigos ou séries precisam de links.
Plano de links internos:
| cluster_id | pillar_page | cluster_pages | internal_link_targets | Âncora sugerida |
|---|---|---|---|---|
| 1 | Guia completo de Astro SEO | tutorial astro seo, astro blog seo | série astro-guide, série cloudflare-bindui | “otimização de SEO no Astro”, “otimização de desempenho com Cloudflare” |
| 2 | - | astro vs next.js for seo | série astro-guide, nextjs-blog-series | “comparativo Astro vs Next.js” |
| 3 | - | cloudflare pricing | série cloudflare-bindui | “preços do Cloudflare explicados” |
Etapas:
- Identifique páginas pillar e cluster.
- Projete a estrutura bidirecional.
- Escolha uma âncora descritiva para cada link.
- Verifique artigos órfãos.
- Exporte o plano para a tabela de tarefas.
O Google considera atualmente redirecionamentos e rel="canonical" sinais fortes, enquanto inclusão em sitemap é sinal mais fraco. Os sinais podem se reforçar, mas o Google continua escolhendo a canônica. Links internos devem apontar de forma consistente para a URL preferida.
7. Definir limites antes que o clustering produza páginas em massa
O clustering não deve virar um gerador em massa de páginas. Esse padrão se afasta rapidamente de conteúdo focado nas pessoas.
Limites de risco:
- Não criar uma página por variação. Query com a mesma intenção converge para uma página ou destino canônico.
- Exigir avaliação de valor original. Cada cluster deve responder a um problema do leitor, ao foco do site e a uma contribuição real em relação ao conteúdo existente.
- Consolidar query de mesma intenção ao redor de uma canônica. Em páginas duplicadas ou muito parecidas, redirecionamentos,
rel="canonical"e sitemaps expressam preferência, mas têm forças diferentes e não garantem a escolha do Google. - Evitar conteúdo search-engine-first. O objetivo principal é ajudar o leitor, não manipular posições.
- Reduzir risco de canibalização. Muitas páginas para palavras quase iguais podem fazer várias URLs competir pela mesma intenção.
- Marcar clusters de risco. O campo risk_notes exige revisão humana.
Linhas vermelhas de qualidade:

- Se existe artigo correspondente, priorizar atualização ou FAQ antes de outra página parecida.
- Toda saída precisa avaliar aderência temática e valor original.
- Links internos devem apontar para o artigo canônico, não para páginas duplicadas ou próximas.
8. Testar o fluxo com Astro SEO, Cloudflare Pricing e Docker
Três cenários tornam o processo concreto.
Exemplo 1: astro seo vs astro vs next.js for seo (intenções diferentes, separar)
- Query originais:
astro seo,astro vs next.js for seo,astro blog seo - Normalização:
astro seo,astro vs next js for seo,astro blog seo - Primeiro passo da IA: cluster_id=1, keywords=[astro seo, astro vs next js for seo, astro blog seo]
- Revisão humana:
astro seotem intenção de tutorial eastro vs next js for seo, de comparação; precisam ser separados. - Cluster map final:
- cluster_id=1: [astro seo, astro blog seo] → criar tutorial de Astro SEO
- cluster_id=2: [astro vs next js for seo] → criar comparativo SEO Astro vs Next.js
Exemplo 2: cloudflare pricing (existe artigo, atualizar)
- Query originais:
cloudflare pricing,cloudflare cost,preço cloudflare - Normalização:
cloudflare pricing,cloudflare pricing,cloudflare pricing - Primeiro passo da IA: cluster_id=3, keywords=[cloudflare pricing, cloudflare pricing, cloudflare pricing]
- Correspondência no inventário: artigo
/cloudflare-pricing - Cluster map final:
- cluster_id=3: [cloudflare pricing, cloudflare cost, preço cloudflare] → atualizar
/cloudflare-pricing
- cluster_id=3: [cloudflare pricing, cloudflare cost, preço cloudflare] → atualizar
Exemplo 3: docker host.docker.internal (normalizar consultas técnicas relacionadas)
- Query originais:
docker host.docker.internal,docker host-gateway,docker 127.0.0.1 - Normalização: marcar como grupo candidato para a mesma intenção de configuração.
- Primeiro passo da IA: cluster_id=4, keywords=[docker host.docker.internal, docker host-gateway, docker 127.0.0.1]
- Correspondência no inventário: existe uma série Docker
- Cluster map final:
- cluster_id=4: [docker host.docker.internal, docker host-gateway, docker 127.0.0.1] → após validar a intenção, adicionar FAQ ou seção a um artigo de Docker
9. Entregar o mapa de conteúdo ao próximo fluxo
Quando o clustering terminar, o cluster map vai para a tabela de tarefas, onde serão definidos campos, pontuação, estados e calendário. O próximo artigo, “Projetar uma tabela de tarefas de conteúdo: campos, pontuação, estados e publicação”, cobre essa etapa.
Para transformar um cluster map em estrutura pronta para redação, continue com “Geração de estrutura com IA: do cluster map ao roteiro”. “Links internos automáticos: gerar links em lote e evitar erros” detalhará depois a inserção.
A atualização de artigos existentes tem um guia próprio: “Estratégia GSC de atualização: de quick wins a melhorias de conteúdo”.
Artigos relacionados já publicados:
- Planejamento trimestral para blogs técnicos com Pillar-Cluster
- SOP semanal de GA/GSC: dos dados às ações
- Técnicas avançadas de GSC para encontrar oportunidades de conteúdo
Transformar palavras-chave em um mapa de conteúdo executável
Fluxo mínimo de várias fontes até o cluster map, as ações de conteúdo e o plano de links internos.
⏱️ Estimated time: 60 min
- 1
Step 1: Unificar as três fontes
Reúna dados query/page do GSC, fichas de ideias e inventário de artigos em uma tabela, preservando a fonte, a correspondência com conteúdo existente e a marca quickWins. - 2
Step 2: Normalizar as palavras-chave
Resolva duplicatas, variações, sinônimos, letras maiúsculas e pontuação; depois marque cada consulta como informacional, navegacional, comparativa ou transacional. - 3
Step 3: Executar o agrupamento semântico inicial
Peça à IA que agrupe por intenção e entregue primary_intent, canonical_page, suggested_action, internal_link_targets e risk_notes para cada cluster. - 4
Step 4: Validar clusters de risco
Use GSC page, algumas SERPs e análise humana para detectar mistura de tutorial e comparação, conflito com artigos existentes, junção excessiva ou fragmentação. - 5
Step 5: Atribuir uma ação principal
Associe cada cluster a artigo novo, página pilar, atualização, FAQ, link interno ou discard e registre a justificativa. - 6
Step 6: Criar o plano de links internos
Defina links bidirecionais pillar/cluster, destinos canônicos e âncoras descritivas; depois verifique artigos órfãos e risco de duplicação.
FAQ
O clustering agrupa termos parecidos ou consultas com a mesma intenção?
Quando uma palavra-chave merece um artigo em vez de um H2 ou FAQ?
Consultas do GSC, perguntas do Reddit, issues do GitHub e títulos de concorrentes podem ficar na mesma tabela?
Por que a IA junta palavras semanticamente próximas com intenções diferentes?
Como escolher entre clustering SERP-based, semantic e hybrid?
Vale criar página nova quando já existe um artigo sobre o tema?
O clustering pode levar à produção em massa de páginas de baixo valor?
11 min de leitura · Publicado em: 13 nov 2026

Guia pratico de automacao de sites de conteudo com IA
Se você chegou pela busca, o caminho mais rápido é ir para o post anterior ou próximo desta série.
Anterior
Agente de IA para pesquisar temas: ideias de blog com Google, Reddit e GitHub
Transforme consultas do GSC, perguntas do Reddit e issues do GitHub em temas técnicos com evidências, pontuação, deduplicação, riscos e revisão humana.
Parte 2 de 4
Próximo
Como escrever um blog técnico com IA: pesquisa, validação de código e revisão humana
Conecte fontes, execução de código, verificação de fatos e QA em um fluxo editorial confiável que devolve cada falha à etapa responsável.
Parte 4 de 4


Comentários
Entre com GitHub para comentar