
Le contenu IA peut-il encore être référencé ? Règles de Google
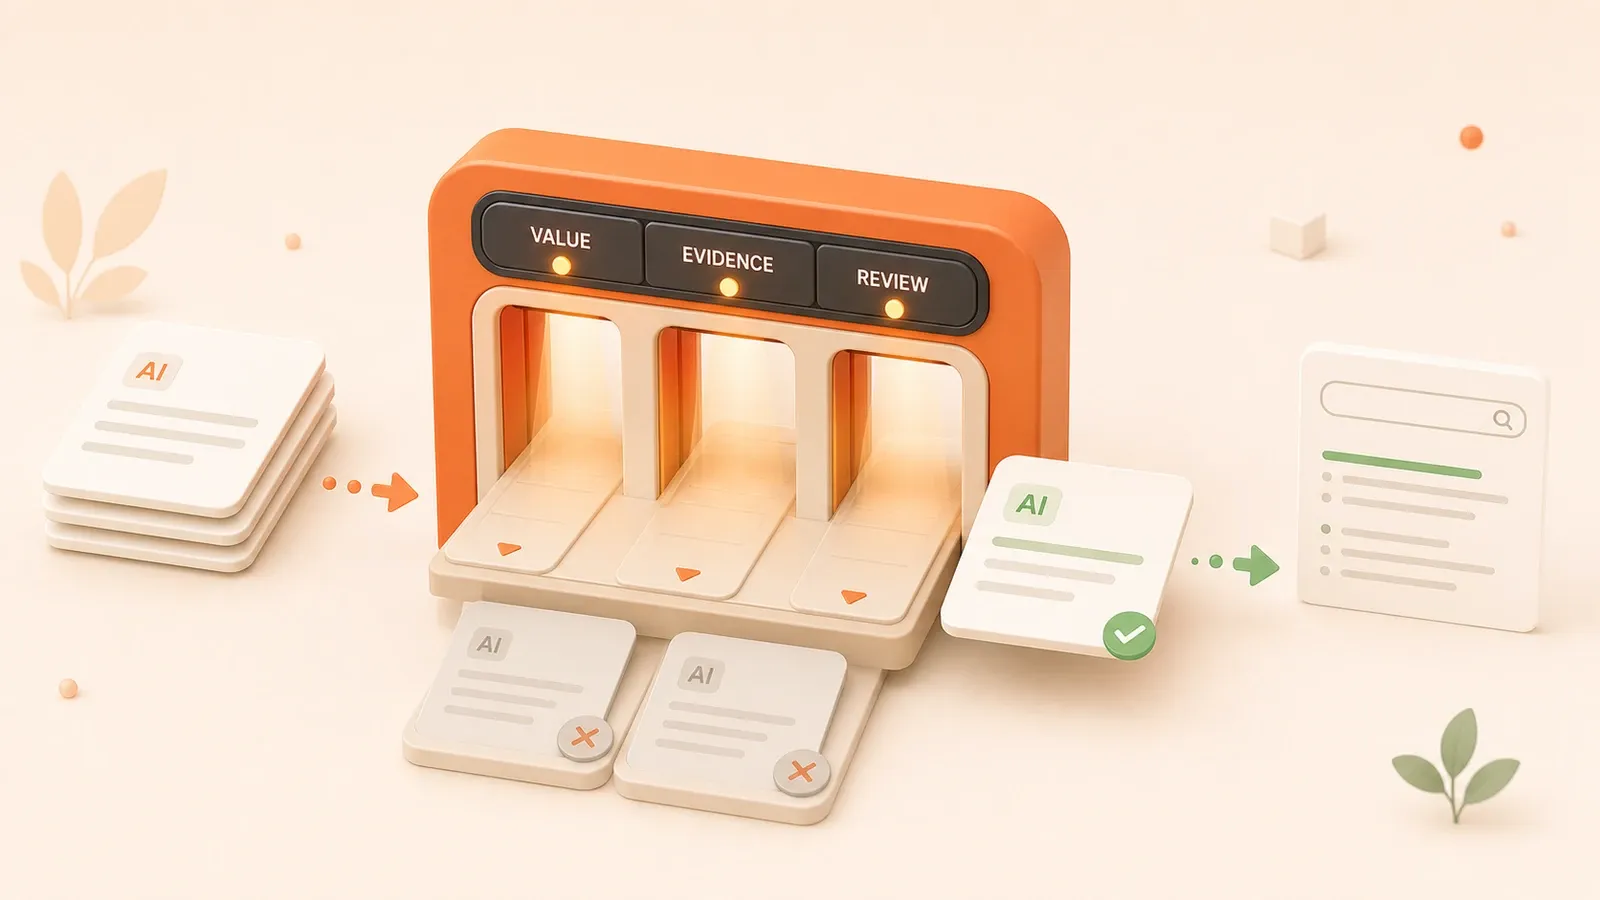
"Les recommandations de Google sur le contenu généré par IA indiquent que l’IA peut aider à rechercher et structurer un contenu original, mais que générer de nombreuses pages sans valeur pour les internautes peut enfreindre la politique sur le scaled content abuse."
Votre tableau éditorial contient 20 sujets déjà étudiés et vous êtes prêt à générer tous les brouillons en une fois. Pourtant, après un nouveau titre annonçant que Google « s’attaque au contenu IA », le curseur s’arrête sur « Publier en masse ». Peut-on cliquer ?
La documentation de Google conduit à trois questions : l’écriture assistée par IA enfreint-elle les règles ? Où se situe la limite de la publication à grande échelle ? Comment appliquer un contrôle qualité à chaque article ?
Position de Google : l’IA n’est pas le problème en soi
Dans un billet officiel de février 2023, Google a répondu clairement qu’un usage approprié de l’IA ou de l’automatisation n’enfreint pas ses consignes. La FAQ de Search Central répond ainsi à la principale inquiétude : l’IA seule ne rend pas un contenu contraire aux règles.
Le but est déterminant. Le même billet explique que l’automatisation, y compris l’IA, enfreint les spam policies lorsqu’elle sert principalement à manipuler le classement. L’outil n’est donc pas le critère ; l’intention et le résultat le sont. Si le contenu aide d’abord les internautes au lieu de contourner le classement, l’assistance de l’IA n’est pas interdite.
L’IA ne bénéficie pas non plus d’un avantage de classement. Google précise que le contenu IA n’obtient aucun bonus particulier. Un contenu utile, original et conforme aux dimensions d’E-E-A-T peut bien fonctionner ; un contenu faible peut échouer. Le texte n’est ni favorisé ni puni automatiquement parce qu’une IA l’a produit. Il doit être helpful, reliable et people-first.
Les spam policies actuelles de Google tracent une limite plus précise : produire de nombreuses pages principalement pour manipuler le classement plutôt que pour aider les internautes, souvent sous la forme d’un grand volume de contenu peu original et de faible valeur. L’usage de l’IA n’est pas le test central.
Les idées fausses les plus courantes peuvent être résumées ainsi :
| Question | Réponse de Google |
|---|---|
| Google interdit-il le contenu IA ? | Non. Un usage approprié de l’IA n’enfreint pas les consignes. |
| Le contenu IA est-il automatiquement mieux classé ? | Non. L’IA n’a pas d’avantage particulier. |
| Le contenu IA est-il automatiquement pénalisé ? | Non. Le risque concerne la production en masse destinée à manipuler le classement plutôt qu’à aider les internautes. |
L’avertissement ne porte pas sur le fait d’avoir utilisé l’IA, mais sur la manière de l’utiliser. Elle peut soutenir la recherche, structurer un contenu original et améliorer l’expression. En revanche, générer de nombreuses pages pour capter des positions avec presque aucune valeur réelle peut relever des spam policies.
Scaled content abuse : évaluer ensemble volume, objectif et valeur
La March 2024 Core Update a introduit de nouvelles spam policies. Le scaled content abuse a élargi l’ancienne règle sur l’automatically-generated content. L’annonce de Google en mars 2024 précise que le contenu de faible valeur produit à grande échelle peut venir de l’automatisation, d’humains ou d’un processus mixte.
Des pages réécrites par des humains peuvent donc aussi enfreindre la règle. L’outil importe peu ; trois dimensions doivent être évaluées ensemble :
- Many pages : le processus génère-t-il des pages à grande échelle ?
- Primary purpose of manipulating rankings : la manipulation du classement est-elle l’objectif principal ?
- Little or no value to users : les pages manquent-elles d’originalité et de valeur ?
La définition formelle de Google associe la production de nombreuses pages, le but principal de manipuler le classement et l’absence d’aide aux internautes. Le manque d’originalité et la valeur faible ou nulle sont des signes typiques. Il ne faut pas transformer cette définition en échappatoire mécanique où publier moins de pages ou ajouter un court paragraphe unique garantirait la conformité.
Des pages distinctes pour les fonctions d’un produit peuvent être légitimes si chacune présente de vraies différences et aide à comprendre la fonction concernée. Le volume seul n’en fait pas du spam. À l’inverse, 1 000 pages qui ne changent qu’un mot-clé, ciblent la longue traîne et aident à peine le lecteur présentent le schéma du scaled content abuse.
Comparaison des trois dimensions :
| Dimension | Situation risquée | Situation plus sûre |
|---|---|---|
| Many pages | Un grand nombre de pages presque identiques est publié simultanément | Le nombre découle de produits, données ou besoins réels |
| Primary purpose | Manipuler le classement ou les réponses génératives | Aider un public défini à accomplir une tâche |
| Little/no value | Seuls les mots-clés ou variables changent | Chaque page présente des différences vérifiables et un apport original |
Cette liste sert de contrôle :
✓ Le but principal est d’aider les internautes, pas de manipuler le classement
✓ Chaque page apporte une vraie valeur, pas seulement une variante de mot-clé
✓ Le contenu ajoute quelque chose d’original, au lieu de seulement reformuler ou traduire
→ Publication durable à grande échelle

✗ Le but principal est de manipuler le classement
✗ Les pages offrent peu ou pas de valeur
✗ Des pages sans différence sont générées en masse
→ Risque de scaled content abuse
La vraie question n’est pas de savoir si la publication peut être automatisée, mais si chaque page obtenue présente une différence réelle et une raison d’exister. Une échelle fondée sur des données et besoins réels, avec un apport original par page, réduit le risque. Des différences superficielles destinées uniquement à couvrir davantage de mots-clés reproduisent le schéma du spam.
Autoévaluation d’un contenu people-first
Le document Creating helpful, reliable, people-first content de Google organise l’autoévaluation autour de Who, How et Why. Ce sont des questions pour les créateurs, pas des scores attribués par un algorithme. Elles permettent de vérifier avant publication qu’une page sert réellement les internautes.
Who : à qui s’adresse le contenu ?
- Le public est-il défini, ou la page tente-t-elle de parler à tout le monde ?
- Montre-t-elle une expérience directe ou une expertise, ou résume-t-elle seulement les avis d’autrui ?
- Le lecteur peut-il apprendre ou accomplir une tâche, ou repart-il sans résultat ?
- A-t-il le sentiment que le texte répond à sa situation, ou qu’il s’agit d’un article interchangeable ?
How : comment le contenu a-t-il été produit ?
- Une personne l’a-t-elle relu et vérifié ?
- Les sources et l’auteur sont-ils clairement identifiés, ou restent-ils inconnus ?
- Le contenu est-il exact, complet et utile, ou présente-t-il des erreurs et omissions visibles ?
- Montre-t-il des traces d’automatisation, comme une forme uniforme avec peu de substance ?
Why : pourquoi ce contenu existe-t-il ?
- Son but principal est-il d’aider les internautes ou de manipuler le classement ?
- A-t-il été créé uniquement pour suivre une tendance ou un mot-clé, ou parce qu’un sujet mérite une explication ?
- A-t-il été écrit pour atteindre un nombre de mots plutôt que résoudre un problème ?
Google cite aussi des signaux search engine-first :
- Publier sur de nombreux sujets sans objectif clair
- Utiliser une automatisation étendue sans contrôle individuel
- Résumer principalement d’autres contenus sans analyse originale
- Suivre tendances et mots-clés plutôt que des problèmes réels
- Écrire pour une longueur plutôt que pour l’utilité
- Changer la date sans mise à jour substantielle pour paraître récent
Le contraste se résume ainsi :
| Dimension | People-First | Search Engine-First |
|---|---|---|
| Who | Public défini et expérience directe | Public flou et résumés d’autres contenus |
| How | Contrôle humain et sources claires | Automatisation large sans preuve de relecture |
| Why | Résoudre un problème pour l’internaute | Manipuler le classement et suivre les mots-clés |
Il n’est pas nécessaire de noter chaque article. Ces questions servent de dernier contrôle. Si Who, How et Why penchent tous vers une logique search engine-first, le contenu peut mal fonctionner même sans franchir clairement une limite de spam.
Comment le contenu IA peut démontrer E-E-A-T
E-E-A-T signifie Experience, Expertise, Authoritativeness et Trustworthiness, termes employés dans les Search Quality Rater Guidelines de Google. Une confusion doit d’abord être écartée : E-E-A-T n’est pas en soi un facteur de classement direct.
Google indique explicitement qu’E-E-A-T n’est pas un specific ranking factor. Ses systèmes utilisent plusieurs facteurs pour reconnaître ces qualités, mais il n’existe pas de score E-E-A-T unique à optimiser. Les Rater Guidelines orientent les évaluateurs ; leurs notes ne changent pas directement le classement, mais aident Google à évaluer et améliorer ses systèmes.
E-E-A-T reste un cadre de qualité utile. Un workflow éditorial peut vérifier si les signaux attendus par les lecteurs sont présents. Pour un contenu assisté par IA, la question pratique est de conserver des preuves de ces signaux.
Experience
Le contenu IA peut-il montrer un usage réel ? Un modèle peut expliquer des principes techniques, mais il ne peut pas inventer une expérience directe crédible. Il faut ajouter des cas réels, des échecs et des problèmes rencontrés. Pour un déploiement Docker, l’IA peut préparer les étapes, mais l’incident de production et l’enquête qui l’a résolu doivent venir de la personne qui les a vécus.
Contrôle : l’article contient-il une expérience directe ? Présente-t-il un cas réel ou un retour d’échec ?
Expertise
L’expertise vient du parcours de l’auteur, des preuves primaires et de la profondeur technique. L’IA peut organiser les détails, mais la page doit indiquer qui les a vérifiés et quelles sources les soutiennent. Une explication de Cloudflare Workers doit encore s’appuyer sur la documentation officielle ou des tests et nommer la personne responsable de la vérification.
Contrôle : author_reviewed_by est-il rempli ? Les sources font-elles autorité ? Une analyse technique est-elle présente ?
Authoritativeness
L’autorité se construit par les recommandations d’autres sites et la reconnaissance des pairs. Un seul article ne peut pas la fabriquer. Des pratiques reproductibles, des arguments originaux, un point de vue distinct et des données réelles peuvent mériter des liens de qualité.
Contrôle : le travail est-il recommandé ailleurs ? La pratique est-elle reproductible ? Le contenu mérite-t-il d’être recommandé ?
Trustworthiness
La confiance vient de sources claires, de l’identité de l’auteur et de l’historique des mises à jour. C’est la partie la plus simple à mettre en œuvre. sources, last_updated et author_reviewed_by montrent que le contenu a été vérifié, que ses preuves sont accessibles et que quelqu’un en répond. Le document people-first de Google précise aussi que trust est l’aspect le plus important d’E-E-A-T.
Contrôle : sources est-il renseigné ? last_updated est-il maintenu ? author_reviewed_by est-il identifié ?
Les quatre dimensions dans un tableau opérationnel :
| Dimension | Mise en œuvre avec l’IA | Contrôle |
|---|---|---|
| Experience | Ajouter l’usage réel et des cas vécus | Une expérience directe est-elle présente ? |
| Expertise | Identifier l’auteur et utiliser des preuves reconnues | author_reviewed_by est-il rempli ? |
| Authoritativeness | Obtenir des liens et la reconnaissance des pairs | D’autres sites recommandent-ils le travail ? |
| Trustworthiness | Montrer sources, responsabilité et mises à jour | sources et last_updated sont-ils présents ? |
Idées fausses fréquentes :

- Idée fausse 1 : E-E-A-T peut être optimisé sous forme d’un score numérique
- Idée fausse 2 : E-E-A-T est un facteur de classement direct unique
- Idée fausse 3 : un contenu IA ne peut jamais démontrer E-E-A-T
- Bonne lecture : E-E-A-T est un cadre de qualité que la relecture humaine, les sources et l’apport original peuvent rendre visible dans un contenu assisté par IA
Divulgation et transparence du contenu assisté par IA
Google impose-t-il une déclaration sur l’IA ? Pas sur chaque page. La FAQ publique n’exige pas une étiquette fixe « généré par IA » pour tous les contenus. Elle recommande toutefois de fournir du contexte lorsque le lecteur peut raisonnablement vouloir comprendre la méthode : comment l’automatisation a été utilisée, d’où viennent les preuves et qui a contrôlé le résultat.
La transparence comporte quatre éléments :
- Identité de l’auteur : qui a écrit ou relu ?
- Sources : quels documents, données et cas soutiennent le contenu ?
- Historique : quand la dernière mise à jour substantielle a-t-elle eu lieu ?
- Usage de l’IA : quelles étapes ont utilisé l’IA, par exemple recherche, structure, brouillon ou révision ?
Ces éléments ne nécessitent pas un paragraphe standard au début de chaque article. Ils peuvent figurer dans les métadonnées, un encadré auteur, une barre latérale ou une page de méthode. Un auteur, une liste de sources et une date de mise à jour donnent déjà un contexte utile.
Certains domaines justifient une explication plus claire. La médecine, la finance et le droit créent des attentes plus fortes sur les preuves et l’exactitude. Il convient d’indiquer si un professionnel a relu le contenu et comment l’IA a participé. Un article fiscal peut citer les documents officiels de l’IRS, la validation d’un fiscaliste et un usage de l’IA limité à la structuration et à l’expression.
Les pages programmatiques doivent aussi expliquer leur logique de génération. Un site comptant de nombreuses pages de produits ou de villes peut documenter la source des données, le processus et les différences réelles. Dire qu’une page repose sur des données authentiques et contient des informations locales spécifiques permet de la distinguer d’un simple remplacement de variable.
Le principe n’est pas d’imposer le même modèle partout. La transparence consiste à rendre compréhensibles les preuves, le relecteur, la méthode de génération et le statut de mise à jour.
Risques de la traduction en masse, de la réécriture et du SEO programmatique
Les sites traduisent souvent en masse, réécrivent des contenus ou génèrent des pages de façon programmatique. Aucune de ces opérations n’est une violation par nature. La décision dépend du primary purpose et de l’added value.
Traduction en masse
Usage plus sûr : traduire ce dont les internautes ont réellement besoin, comme une documentation produit ou un tutoriel technique. Conserver la valeur de la source, ne pas la réduire excessivement et localiser les termes, le style et l’intention de recherche au lieu de publier une traduction automatique non relue.
Usage risqué : publier sans relecture avec des erreurs de grammaire ou de contexte culturel ; traduire un article de faible valeur en plusieurs langues seulement pour couvrir des mots-clés ; créer des versions sans preuve de besoin ni contrôle humain.
Question : le public a-t-il besoin de cette version ? Conserve-t-elle la valeur de la source ? A-t-elle été réellement localisée ?
Réécriture et remplacement par synonymes
Usage plus sûr : ajouter des idées originales, une expérience pratique, de nouvelles données ou de nouveaux cas. Réorganiser pour un public réellement différent plutôt que changer uniquement les mots.
Usage risqué : modifier quelques mots d’un article tiers pour contourner la détection de doublons ; produire presque le même texte sans valeur ajoutée ; réécrire en masse des pages internes uniquement pour viser d’autres mots-clés.
Question : quelle nouvelle valeur apporte la version ? Contient-elle une idée ou un cas original ? S’adresse-t-elle vraiment à un autre public ?
SEO programmatique
Usage plus sûr : utiliser des données réelles afin que chaque produit ou lieu présente des différences vérifiables. Chaque page répond à une intention précise et possède une raison d’exister séparément.
Usage risqué : remplacer seulement une ville, un produit ou un mot-clé dans un modèle ; générer de nombreuses variantes longue traîne sans différence réelle ; scraper, combiner ou traduire d’autres pages sans ajouter de valeur.
Question : chaque page présente-t-elle une différence réelle ? Les internautes ont-ils besoin d’une page séparée ? Répond-elle à une intention précise ?
Comparaison :
| Opération | Limite plus sûre | Limite risquée |
|---|---|---|
| Traduction en masse | Demande réelle, valeur préservée, bonne localisation | Automatique non relue, couverture de mots-clés, source faible |
| Réécriture | Analyse originale, autre public, nouvelles données | Contournement des doublons, aucune valeur, paraphrases en masse |
| SEO programmatique | Données réelles, différences utiles, intention précise | Remplissage de modèle, longue traîne, pages presque identiques |
Le test central combine primary purpose et added value. Trois questions :
- Le but principal est-il d’aider les internautes ou de manipuler le classement ?
- Chaque page ajoute-t-elle une vraie valeur ou seulement une différence superficielle ?
- Les internautes ont-ils réellement besoin de ces pages, ou le besoin est-il supposé ?
Si les trois réponses sont soutenues par des preuves, l’opération a davantage de chances d’être durable. Si le but, la valeur ou le besoin ne peuvent pas être défendus, le risque doit être réévalué.

Nouveau risque lié à AI Search et aux fan-out queries
La recherche par IA crée une nouvelle tentation. Les AI features et la recherche générative de Google peuvent décomposer une question en plusieurs recherches liées, souvent appelées fan-out queries. Une demande sur les performances de Docker peut conduire à l’optimisation, aux limites de ressources et aux outils de surveillance.
Certains sites créent une page distincte pour chaque variante. Cela ressemble à une couverture méthodique des mots-clés, mais peut devenir du scaled content abuse.
Le guide actuel de Google pour la recherche générative déconseille explicitement de créer de nombreuses pages pour chaque variante ou fan-out query. Lorsque le but principal est de manipuler le classement ou les réponses génératives de Google Search, cette pratique enfreint la politique sur le scaled content abuse.
Une approche plus durable consiste à répondre complètement aux questions liées sur une même page. Un guide sur les performances Docker peut réunir optimisation, limites de ressources et surveillance afin que l’internaute termine sa tâche au même endroit.
AI Search et GEO nécessitent une stratégie plus approfondie qui sera traitée séparément. La règle immédiate est de ne pas générer en masse des pages de faible valeur uniquement pour couvrir chaque variante.
Champs de contrôle qualité pour un pipeline de contenu IA
La dernière étape consiste à convertir les principes de Google en champs qu’un tableau éditorial peut imposer. Chaque champ consigne un signal de qualité et doit être traité avant publication.
Définition des champs
| Champ | Rôle | Obligatoire/facultatif | Principe Google |
|---|---|---|---|
| sources | Liens vers toutes les preuves utilisées | Obligatoire | Trustworthiness, Expertise |
| author_reviewed_by | Identité de l’auteur ou du relecteur | Obligatoire | Expertise, Accountability |
| original_increment | Valeur originale ajoutée, comme une analyse, des données ou un cas | Obligatoire | People-first, Added value |
| human_qa_status | État du contrôle humain : brouillon, en révision, approuvé | Obligatoire | How, Trustworthiness |
| gsc_feedback | Retours de requêtes et de pages GSC après publication | Facultatif | Why, amélioration continue |
| last_updated | Date de la dernière modification substantielle | Obligatoire | Freshness, Trustworthiness |
| ai_usage | Étapes où l’IA a servi : recherche, structure, brouillon, révision | Facultatif | Transparency |
Contrôle de publication
Avant publication, imposer les conditions suivantes :
- sources n’est pas vide : au moins trois éléments fiables, comme une documentation officielle, une publication reconnue ou un test pratique
- author_reviewed_by est rempli : une personne précise assume la relecture
- original_increment mentionne au moins une idée, un cas ou une donnée originale
- human_qa_status passe de « en révision » à « approuvé » après le contrôle humain
- last_updated indique la date de cette révision ou modification substantielle
Exemple conforme :
sources: ["https://developers.google.com/search/docs/fundamentals/using-gen-ai-content",
          "https://developers.google.com/search/docs/essentials/spam-policies",
          "https://developers.google.com/search/blog/2023/02/google-search-and-ai-content"]
author_reviewed_by: "Jane Zhang (éditrice du blog technique)"
original_increment: "analyse des règles Google + modèle de décision à trois axes + conception des champs de contrôle"
human_qa_status: "approuvé"
last_updated: "2026-07-26"
ai_usage: "recherche, structure et amélioration du brouillon"
Exemple risqué :
sources: []
author_reviewed_by: ""
original_increment: ""
human_qa_status: "brouillon" → publication directe
last_updated: ""
ai_usage: "génération intégrale sans relecture"
Contrôles par étape
| Étape | Champs obligatoires | Contrôle |
|---|---|---|
| Recherche | sources | Au moins trois sources fiables |
| Rédaction | original_increment | Au moins une idée, un cas ou une donnée originale |
| Révision | author_reviewed_by, human_qa_status | Relecteur consigné et état « approuvé » |
| Après publication | gsc_feedback, last_updated | Retour GSC enregistré et date liée à une modification substantielle |
Ces champs ne sont pas des exigences directes de Google. Ils constituent une pratique opérationnelle dérivée des principes people-first. Les noms peuvent changer, mais la logique demeure : chaque article a besoin de sources, d’un relecteur responsable, d’une valeur originale, d’une approbation humaine et d’un historique de mise à jour entretenu.
Conclusion
L’IA dans un workflow éditorial n’est pas le problème. La publication de faible valeur à grande échelle pour manipuler le classement est le risque. Trois questions suffisent : le but principal est-il d’aider ? Chaque page ajoute-t-elle une vraie valeur ? Les internautes ont-ils réellement besoin de cette page ?
Avant une publication en masse, contrôlez le tableau éditorial. sources, author_reviewed_by et original_increment sont-ils complets ? L’article a-t-il franchi son contrôle ? Les preuves, une personne responsable et un apport original doivent être présents avant de publier.
Un autre article approfondira AI Search et GEO. Il s’agira de rendre le contenu compréhensible et citable par la recherche IA, plutôt que de générer des pages faibles pour chaque variante de requête.
Mettre en place un contrôle qualité minimal pour le contenu IA
De la sélection du sujet au suivi après publication, chaque article conserve des preuves d’utilité, de fondement factuel et de responsabilité humaine.
- 1
Step 1: Définir le lecteur et le périmètre du site
Indiquez qui bénéficie du contenu et quel problème il résout. N’entrez pas dans un domaine inconnu uniquement pour un trafic potentiel. - 2
Step 2: Vérifier les chevauchements internes
Recherchez les articles existants avant l’étude et décidez de créer, actualiser, fusionner ou arrêter au lieu de produire une page presque identique. - 3
Step 3: Conserver les sources primaires
Consignez les preuves officielles ou directes et leurs dates de consultation pour les politiques, prix, versions et limites techniques. - 4
Step 4: Décrire l’apport original
Notez le test, l’expérience, l’analyse, les données ou le cadre de décision ajouté par l’article. Une simple reformulation ne suffit pas. - 5
Step 5: Contrôler les faits et la présentation
Vérifiez les faits, exemples, promesses du titre, doublons et traces d’automatisation, puis ajoutez les validations pratiques nécessaires. - 6
Step 6: Consigner la responsabilité humaine
Enregistrez le relecteur, les sources, l’usage de l’IA et les notes de risque. Une personne doit approuver la publication finale. - 7
Step 7: Déclencher les mises à jour avec des retours réels
Utilisez les requêtes et données de page de GSC pour décider d’une mise à jour substantielle, au lieu de modifier seulement la date ou le résumé.
FAQ
Google pénalise-t-il automatiquement le contenu généré par IA ?
Google s’oppose-t-il au contenu IA ou au contenu de faible qualité produit en masse ?
Qu’est-ce que le scaled content abuse ?
Un blog technique assisté par IA peut-il encore faire du SEO ?
La traduction en masse et le SEO programmatique sont-ils toujours contraires aux règles ?
Chaque article assisté par IA doit-il déclarer l’usage de l’IA ?
16 min de lecture · Publié le: 13 nov. 2026

Guide pratique de l automatisation des sites de contenu IA
Vous lisez le premier article de cette série. Continuez avec le suivant ou ouvrez le hub de la série pour voir tout le parcours.
Précédent
Vous êtes au début de cette série.
Suivant
Agent IA de recherche de sujets : trouver des idées de blogs avec Google, Reddit et GitHub
Transformez les requêtes GSC, les questions Reddit et les issues GitHub en sujets techniques avec niveaux de preuve, score, déduplication, risques et validation humaine.
Partie 2 sur 4


Commentaires
Connectez-vous avec GitHub pour laisser un commentaire