
Kann KI-Content noch ranken? Googles Regeln für Masse und Qualität
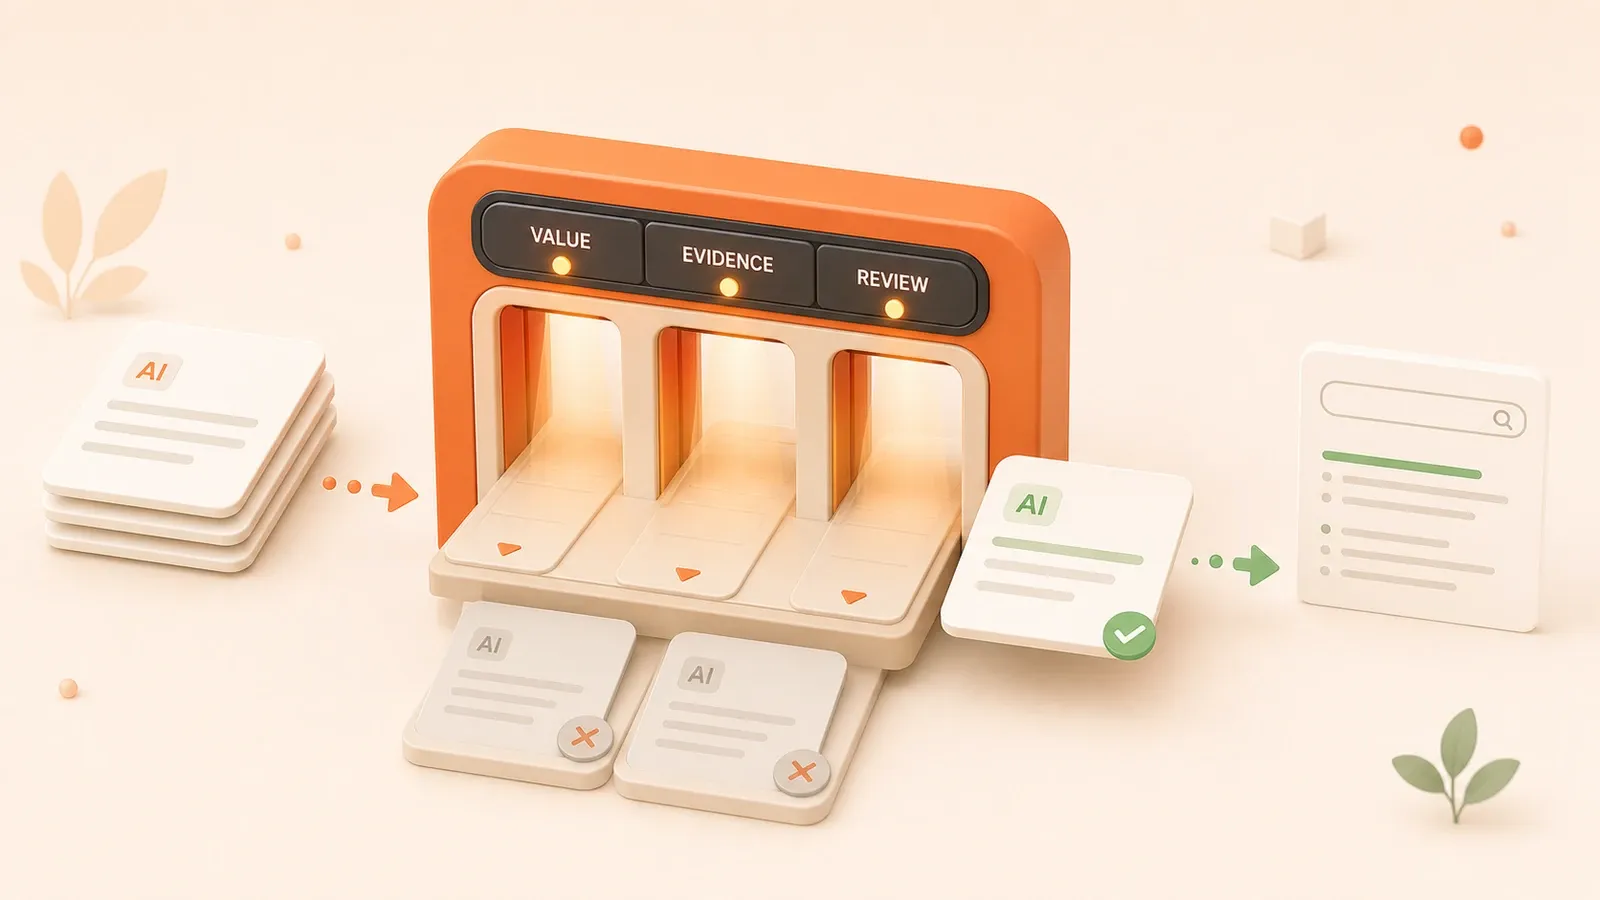
"Googles Leitlinie zu generativen KI-Inhalten erklärt, dass KI Recherche und Struktur origineller Inhalte unterstützen kann, während viele Seiten ohne Nutzwert gegen die Richtlinie zu scaled content abuse verstoßen können."
Auf dem Content-Board stehen 20 fertig recherchierte Themen, und alle Entwürfe sollen mit einem Klick erzeugt werden. Doch nach einer weiteren Schlagzeile über Googles Vorgehen gegen KI-Content bleibt der Mauszeiger über „Massenhaft veröffentlichen“ stehen. Darf man klicken?
Googles eigene Dokumentation führt zu drei Fragen: Verstößt KI-gestütztes Schreiben gegen Richtlinien? Wo liegt die Grenze beim Publizieren in großem Maßstab? Wie lässt sich eine Qualitätsschranke für jeden Artikel umsetzen?
Googles Position: KI selbst ist nicht der Verstoß
Google erklärte in einem offiziellen Blogbeitrag vom Februar 2023 ausdrücklich, dass der angemessene Einsatz von KI oder Automatisierung nicht gegen die Richtlinien verstößt. Die FAQ von Search Central beantwortet damit die zentrale Sorge: KI allein macht einen Inhalt nicht regelwidrig.
Entscheidend ist der Zweck. Derselbe Beitrag erklärt, dass Automatisierung einschließlich KI gegen die Spamrichtlinien verstößt, wenn sie hauptsächlich Suchrankings manipulieren soll. Nicht das Werkzeug, sondern Absicht und Ergebnis werden bewertet. Dient ein Inhalt vor allem Menschen und nicht dem Austricksen des Rankings, ist KI-gestütztes Schreiben nicht grundsätzlich verboten.
KI besitzt auch keinen Ranking-Bonus. Google sagt, dass KI-Inhalte keinen besonderen Vorteil erhalten. Nützliche, originelle Inhalte, die Aspekte von E-E-A-T zeigen, können gut abschneiden; schwache Inhalte möglicherweise nicht. KI-Texte werden weder automatisch bevorzugt noch bestraft. Maßgeblich ist, ob sie helpful, reliable und people-first sind.
Googles aktuelle Spamrichtlinien ziehen die Grenze genauer: Inhalte werden in großer Menge vor allem zur Manipulation von Rankings und nicht zur Hilfe für Menschen produziert. Häufig handelt es sich um große Mengen unorigineller Seiten mit wenig oder keinem Nutzwert. Der KI-Einsatz ist nicht der zentrale Test.
Die häufigsten Missverständnisse lassen sich so auflösen:
| Frage | Googles Antwort |
|---|---|
| Verbietet Google KI-Content? | Nein. Ein angemessener KI-Einsatz verstößt nicht gegen die Richtlinien. |
| Rankt KI-Content automatisch besser? | Nein. KI hat keinen besonderen Ranking-Vorteil. |
| Wird KI-Content automatisch bestraft? | Nein. Riskant sind skalierte Inhalte, die vor allem Rankings manipulieren und Nutzern nicht helfen. |
Die Warnung lautet nicht „KI wurde verwendet“, sondern „Wie wurde sie verwendet?“. KI kann Themenrecherche, die Struktur origineller Inhalte und sprachliche Verbesserung unterstützen. Werden jedoch viele Seiten nur für Rankings erzeugt und liefern fast keinen realen Wert, können die Spamrichtlinien greifen.
Scaled content abuse: Umfang, Zweck und Nutzwert gemeinsam bewerten
Mit dem March 2024 Core Update kamen neue Spamrichtlinien. Scaled content abuse erweiterte dabei die frühere Richtlinie zu automatically-generated content. Googles Ankündigung vom März 2024 stellte klar, dass minderwertiger Massen-Content aus Automatisierung, menschlicher Arbeit oder einem Mischprozess stammen kann.
Auch von Menschen umgeschriebene Seiten können daher gegen die Richtlinie verstoßen. Das Werkzeug ist unwichtig; drei Dimensionen müssen gemeinsam betrachtet werden:
- Many pages: Werden Seiten in großem Maßstab produziert?
- Primary purpose of manipulating rankings: Ist Ranking-Manipulation das Hauptziel?
- Little or no value to users: Fehlen Originalität und Nutzwert?
Googles formale Definition verbindet viele erzeugte Seiten mit dem Hauptzweck der Ranking-Manipulation und dem fehlenden Nutzen für Menschen. Geringe Originalität und wenig oder kein Nutzwert sind typische Merkmale. Daraus darf kein mechanischer Freibrief werden, nach dem wenige Seiten oder ein zusätzlicher Absatz automatisch sicher wären.
Einzelne Seiten für verschiedene Produktfunktionen können sinnvoll sein, wenn jede Seite echte Unterschiede erklärt und Nutzern beim Verständnis hilft. Eine hohe Anzahl allein macht sie nicht zu Spam. Anders sieht es bei 1.000 Seiten aus, die nur Keywords variieren, Long-Tail-Suchen abdecken sollen und kaum helfen: Dieses Muster entspricht dem Risiko von scaled content abuse.
Die drei Dimensionen im Vergleich:
| Dimension | Hohes Risiko | Eher sichere Ausprägung |
|---|---|---|
| Many pages | Viele nahezu identische Seiten gehen gleichzeitig online | Die Zahl folgt echten Produkten, Daten oder Nutzerbedürfnissen |
| Primary purpose | Rankings oder generative KI-Antworten manipulieren | Einer definierten Zielgruppe beim Erledigen einer Aufgabe helfen |
| Little/no value | Nur Keywords oder Variablen unterscheiden sich | Jede Seite hat überprüfbare Unterschiede und eigenen Mehrwert |
Diese Checkliste hilft:
✓ Hauptzweck ist die Hilfe für Nutzer, nicht Ranking-Manipulation
✓ Jede Seite bietet echten Wert, nicht nur eine Keyword-Variante
✓ Der Inhalt ergänzt etwas Eigenes, statt nur umzuschreiben oder zu übersetzen
→ Nachhaltige Skalierung

✗ Hauptzweck ist Ranking-Manipulation
✗ Die Seiten bieten wenig oder keinen Nutzwert
✗ Nahezu identische Seiten werden massenhaft erzeugt
→ Risiko von scaled content abuse
Die Kernfrage ist nicht, ob sich Veröffentlichung automatisieren lässt, sondern ob jede Seite einen echten Unterschied und einen Grund zu existieren hat. Skalierung aus realen Daten und Nutzerbedürfnissen mit eigenem Mehrwert ist weniger riskant. Oberflächliche Varianten nur zur Keyword-Abdeckung bilden das Spam-Muster.
Selbstprüfung für people-first content
Googles Dokument Creating helpful, reliable, people-first content ordnet die Selbstprüfung nach Who, How und Why. Das sind Fragen für Content-Verantwortliche, keine Punktwerte für einen Algorithmus. Vor der Veröffentlichung zeigen sie, ob eine Seite tatsächlich Menschen dient.

Who: Für wen ist der Inhalt?
- Gibt es eine definierte Zielgruppe oder soll die Seite alle erreichen?
- Zeigt der Inhalt eigene Erfahrung oder Fachwissen oder fasst er nur fremde Aussagen zusammen?
- Können Leser etwas lernen oder eine Aufgabe erledigen, oder bleibt nichts Verwertbares?
- Wirkt der Text für ihre Situation geschrieben oder wie ein austauschbarer Artikel?
How: Wie wurde der Inhalt erstellt?
- Wurde er von einem Menschen geprüft und verifiziert?
- Sind Quellen und Autor klar angegeben oder bleiben beide unklar?
- Ist der Inhalt korrekt, vollständig und hilfreich oder enthält er offensichtliche Fehler und Lücken?
- Zeigt er Automatisierungsspuren, etwa gleichförmige Absätze ohne Substanz?
Why: Warum existiert der Inhalt?
- Ist der Hauptzweck Nutzerhilfe oder Ranking-Manipulation?
- Entstand er nur wegen eines Trends oder Keywords oder gibt es etwas Relevantes zu erklären?
- Wurde er für eine Wortzahl statt zur Lösung eines Problems geschrieben?
Google nennt außerdem Warnzeichen für search engine-first content:
- Viele Themen ohne klaren Schwerpunkt veröffentlichen
- Umfangreiche Automatisierung ohne individuelle Prüfung
- Andere Quellen überwiegend zusammenfassen, ohne eigene Erkenntnisse
- Trends und Keywords statt reale Probleme verfolgen
- Für eine Wortzahl statt für den Nutzen schreiben
- Nur das Datum ändern, um ohne substanzielle Aktualisierung frisch zu wirken
Der Vergleich:
| Dimension | People-First | Search Engine-First |
|---|---|---|
| Who | Klare Zielgruppe und eigene Erfahrung | Keine klare Zielgruppe, Zusammenfassungen fremder Inhalte |
| How | Menschliche Prüfung und klare Quellen | Breite Automatisierung ohne Prüfbelege |
| Why | Ein Nutzerproblem lösen | Rankings manipulieren und Keywords verfolgen |
Nicht jeder Artikel braucht eine Punktzahl. Die Fragen dienen als letzte Veröffentlichungskontrolle. Wenn Who, How und Why alle in Richtung search engine-first weisen, kann der Inhalt schwach abschneiden, auch ohne eine eindeutige Spamgrenze zu überschreiten.
Wie KI-Content E-E-A-T zeigen kann
E-E-A-T steht für Experience, Expertise, Authoritativeness und Trustworthiness und stammt aus Googles Search Quality Rater Guidelines. Zuerst muss ein Missverständnis ausgeräumt werden: E-E-A-T selbst ist kein direkter Rankingfaktor.
Google erklärt ausdrücklich, dass E-E-A-T kein specific ranking factor ist. Die Systeme nutzen einen Mix von Faktoren, um Inhalte mit diesen Eigenschaften zu erkennen. Es gibt aber keinen einzelnen E-E-A-T-Wert, den man optimieren könnte. Die Rater Guidelines richten sich an Prüfer; deren Bewertungen verändern Rankings nicht direkt, sondern helfen Google bei der Bewertung und Verbesserung der Systeme.
Als Qualitätsrahmen bleibt E-E-A-T nützlich. Ein Workflow kann damit prüfen, ob erwartete Vertrauenssignale vorhanden sind. Bei KI-gestützten Inhalten lautet die praktische Frage, wie Nachweise für diese Signale entstehen.
Experience
Kann KI reale Nutzungserfahrung darstellen? Ein Modell kann technische Prinzipien erklären, aber keine glaubwürdige eigene Erfahrung erfinden. Ergänzt werden müssen echte Fälle, Fehlversuche und Probleme aus der Praxis. Bei einem Docker-Deployment kann KI die Schritte entwerfen; das Produktionsproblem und dessen Untersuchung müssen von der Person kommen, die es erlebt hat.
Prüfung: Enthält der Artikel eigene Erfahrung? Gibt es einen realen Fall oder eine Fehleranalyse?
Expertise
Fachwissen entsteht aus Hintergrund, Primärbelegen und technischer Tiefe. KI kann Details ordnen, doch der Text sollte nennen, wer sie geprüft hat und welche maßgeblichen Quellen sie stützen. Bei Cloudflare Workers braucht eine KI-gestützte Funktionsbeschreibung weiterhin offizielle Dokumentation oder Testergebnisse und eine verantwortliche Person.
Prüfung: Ist author_reviewed_by ausgefüllt? Gibt es maßgebliche Quellen? Enthält der Text technische Analyse?
Authoritativeness
Autorität wächst durch Empfehlungen anderer Websites und Anerkennung durch Fachkollegen. Ein einzelner Artikel kann sie nicht herstellen. Reproduzierbare Praxis, originelle Argumente, besondere Perspektiven und reale Daten können hochwertige Verweise verdienen.
Prüfung: Wurde die Arbeit anderswo empfohlen? Ist die Praxis reproduzierbar? Ist der Inhalt empfehlenswert?
Trustworthiness
Vertrauen entsteht durch klare Quellen, Autorendaten und Aktualisierungshistorie. Das lässt sich am einfachsten umsetzen. sources, last_updated und author_reviewed_by zeigen, dass der Inhalt geprüft wurde, Belege auffindbar sind und jemand Verantwortung trägt. Googles people-first-Dokument bezeichnet trust zudem als wichtigsten Teil von E-E-A-T.
Prüfung: Sind sources vorhanden? Wird last_updated gepflegt? Ist author_reviewed_by angegeben?
Die vier Dimensionen als Arbeitstabelle:
| Dimension | Umsetzung bei KI-Content | Prüfung |
|---|---|---|
| Experience | Reale Nutzung und echte Fälle ergänzen | Ist eigene Erfahrung vorhanden? |
| Expertise | Autor nennen und maßgebliche Belege verwenden | Ist author_reviewed_by ausgefüllt? |
| Authoritativeness | Links und Anerkennung erwerben | Empfehlen andere Websites die Arbeit? |
| Trustworthiness | Quellen, Verantwortung und Updates zeigen | Sind sources und last_updated vorhanden? |
Häufige Missverständnisse:

- Missverständnis 1: E-E-A-T lässt sich als numerischer Wert optimieren
- Missverständnis 2: E-E-A-T ist ein einzelner direkter Rankingfaktor
- Missverständnis 3: KI-Content kann E-E-A-T grundsätzlich nicht zeigen
- Richtige Einordnung: E-E-A-T ist ein Qualitätsrahmen; menschliche Prüfung, Quellen und eigener Mehrwert machen ihn auch bei KI-gestützten Inhalten sichtbar
Offenlegung und Transparenz bei KI-gestützten Inhalten
Verlangt Google einen KI-Hinweis? Nicht auf jeder Seite. Die öffentliche FAQ fordert keine feste Kennzeichnung „von KI erzeugt“ für alle Inhalte. Sie empfiehlt jedoch Kontext, wenn Leser vernünftigerweise wissen möchten, wie der Inhalt entstand: Wie wurde Automatisierung verwendet, woher stammen die Belege und wer hat geprüft?
Transparenz besteht aus vier Teilen:
- Autoreninformation: Wer hat geschrieben oder geprüft?
- Quellen: Welche Dokumente, Daten und Fälle stützen den Inhalt?
- Aktualisierung: Wann wurde zuletzt substanziell aktualisiert?
- KI-Einsatz: In welchen Phasen wurde KI genutzt, etwa Recherche, Struktur, Entwurf oder sprachliche Überarbeitung?
Diese Angaben brauchen keinen Standardabsatz am Anfang jedes Artikels. Sie können in Metadaten, einer Autorenbox, der Seitenleiste oder einer Methodenseite stehen. Autor, Quellenliste und Aktualisierungsdatum geben Lesern bereits wichtigen Kontext.
In manchen Bereichen ist eine deutlichere Erklärung sinnvoll. Medizin, Finanzen und Recht erzeugen höhere Erwartungen an Belege und Genauigkeit. Dort sollte erkennbar sein, ob eine Fachperson geprüft hat und wie KI beteiligt war. Ein Steuerartikel kann etwa offizielle IRS-Dokumente, die Prüfung durch eine Steuerfachkraft und KI nur für Struktur und Sprache nennen.
Auch programmatische Seiten brauchen eine Erklärung ihrer Erzeugungslogik. Eine Website mit vielen Produkt- oder Stadtseiten kann Datenquelle, Prozess und reale Unterschiede dokumentieren. Der Hinweis auf echte Nutzerdaten und ortsspezifische Informationen macht den Unterschied zu bloßem Variablentausch sichtbar.
Das Prinzip ist nicht ein identischer Hinweis überall. Transparenz bedeutet, dass Leser Belege, Prüfer, Erzeugungsmethode und Aktualisierungsstatus verstehen können.
Risiken bei Massenübersetzung, Umschreiben und programmatischem SEO
Websites übersetzen oft in großer Menge, schreiben vorhandenes Material um oder erzeugen Seiten programmatisch. Keine dieser Methoden ist von sich aus ein Verstoß. Entscheidend sind primary purpose und added value.
Massenübersetzung
Eher sicher: Inhalte übersetzen, die Menschen wirklich brauchen, etwa Produktdokumentation oder technische Tutorials. Den Wert des Originals erhalten, nicht übermäßig kürzen und Terminologie, Ausdruck sowie Suchintention lokalisieren, statt ungeprüfte Maschinenübersetzung zu veröffentlichen.
Riskant: Ohne Prüfung veröffentlichen, Grammatik- und Kulturfehler stehen lassen oder einen minderwertigen Artikel nur für Keywords in viele Sprachen übertragen. Sprachversionen ohne Nachfragebeleg und menschliche Kontrolle sind problematisch.
Frage: Braucht die Zielgruppe diese Sprachversion? Bleibt der Wert erhalten? Wurde wirklich lokalisiert?
Umschreiben und Synonymtausch
Eher sicher: Eigene Erkenntnisse, Praxiserfahrung, neue Daten oder Fälle ergänzen. Für eine tatsächlich andere Zielgruppe neu strukturieren, statt nur Wörter auszutauschen.
Riskant: Fremde Artikel leicht ändern, um Duplikaterkennung zu umgehen; nahezu denselben Inhalt ohne Mehrwert erzeugen; interne Seiten massenhaft nur für weitere Keywords umformulieren.
Frage: Welchen neuen Wert bringt die Fassung? Enthält sie eigene Erkenntnisse oder neue Fälle? Richtet sie sich wirklich an ein anderes Publikum?
Programmatisches SEO
Eher sicher: Echte Daten verwenden, sodass Produkte oder Orte überprüfbare Unterschiede besitzen. Jede Seite erfüllt eine konkrete Suchintention und hat einen Grund, separat zu existieren.
Riskant: In Vorlagen nur Stadt, Produkt oder Keyword ersetzen; viele Long-Tail-Varianten ohne materielle Unterschiede erzeugen; andere Seiten scrapen, kombinieren oder übersetzen, ohne Wert hinzuzufügen.
Frage: Enthält jede Seite einen echten Unterschied? Brauchen Nutzer eine eigene Seite? Erfüllt sie eine konkrete Intention?
Die drei Methoden im Vergleich:
| Methode | Eher sichere Grenze | Risikogrenze |
|---|---|---|
| Massenübersetzung | Echte Nachfrage, Werterhalt, gute Lokalisierung | Ungeprüfte Maschine, Keyword-Abdeckung, minderwertige Quellen |
| Umschreiben | Eigene Erkenntnis, andere Zielgruppe, neue Daten | Duplikatvermeidung, kein Mehrwert, Massenparaphrasen |
| Programmatisches SEO | Echte Daten, relevante Unterschiede, klare Intention | Vorlagenfüllung, Long-Tail-Abdeckung, nahezu gleiche Seiten |
Der Kern ist primary purpose plus added value. Drei Fragen:
- Soll vor allem Nutzern geholfen oder das Ranking manipuliert werden?
- Bringt jede Seite echten Mehrwert oder nur oberflächliche Unterschiede?
- Brauchen Nutzer diese Seiten wirklich oder wird der Bedarf nur angenommen?
Wenn alle Antworten mit Belegen gestützt werden können, ist die Skalierung eher nachhaltig. Lassen sich Zweck, Seitenwert oder Bedarf nicht verteidigen, muss das Risiko neu bewertet werden.

Neues Risiko durch AI Search und fan-out queries
KI-Suche schafft eine weitere Versuchung. Googles AI features und generative Suche können eine Frage in mehrere verwandte Suchen auffächern, häufig fan-out queries genannt. Eine Frage zur Docker-Performance kann etwa Optimierung, Ressourcenlimits und Monitoringwerkzeuge auslösen.
Manche Websites erstellen für jede Variante eine eigene Seite. Das wirkt wie sorgfältige Keyword-Abdeckung, kann aber zu scaled content abuse werden.
Googles aktueller Leitfaden zur Optimierung für generative KI-Suche warnt ausdrücklich vor vielen Seiten für jede Suchvariante oder fan-out query. Werden sie hauptsächlich erzeugt, um Rankings oder generative KI-Antworten in Google Search zu manipulieren, verletzt das die Richtlinie zu scaled content abuse.
Nachhaltiger ist es, verwandte Fragen auf einer Seite vollständig zu beantworten. Ein Leitfaden zur Docker-Performance kann Optimierung, Ressourcenlimits und Monitoring zusammenführen, damit Nutzer die Aufgabe an einem Ort erledigen.
AI Search und GEO brauchen eine eigene vertiefte Strategie. Die unmittelbare Regel lautet: Keine minderwertigen Seiten nur für jede Suchvariante massenhaft erzeugen.
Qualitätsschranken-Felder für eine KI-Content-Pipeline
Zum Schluss werden Googles Qualitätsprinzipien in Felder übersetzt, die ein Content-Board erzwingen kann. Jedes Feld dokumentiert ein Qualitätssignal und muss vor Veröffentlichung bearbeitet sein.
Felddefinitionen
| Feld | Zweck | Pflicht/optional | Google-Prinzip |
|---|---|---|---|
| sources | Links zu allen Belegen des Artikels | Pflicht | Trustworthiness, Expertise |
| author_reviewed_by | Identität von Autor oder Prüfer | Pflicht | Expertise, Accountability |
| original_increment | Eigener Mehrwert gegenüber bestehenden Inhalten, etwa Analyse, Daten oder Fall | Pflicht | People-first, Added value |
| human_qa_status | Status der menschlichen Qualitätsprüfung: Entwurf, in Prüfung, genehmigt | Pflicht | How, Trustworthiness |
| gsc_feedback | GSC-Abfrage- und Seitenfeedback nach Veröffentlichung | Optional | Why, kontinuierliche Verbesserung |
| last_updated | Datum der letzten substanziellen Aktualisierung | Pflicht | Freshness, Trustworthiness |
| ai_usage | KI-Einsatz in Recherche, Struktur, Entwurf oder Überarbeitung | Optional | Transparency |
Veröffentlichungsschranke
Vor Veröffentlichung gilt:
- sources ist nicht leer: mindestens drei belastbare Belege wie offizielle Dokumentation, maßgebliche Publikation oder praktische Tests
- author_reviewed_by ist ausgefüllt: eine konkrete Person trägt Prüfverantwortung
- original_increment nennt mindestens eine eigene Erkenntnis, einen Fall oder einen Datenpunkt
- human_qa_status wechselt nach menschlicher Prüfung von „in Prüfung“ zu „genehmigt“
- last_updated enthält das Datum dieser substanziellen Prüfung oder Änderung
Beispiel, das die Schranke passiert:
sources: ["https://developers.google.com/search/docs/fundamentals/using-gen-ai-content",
          "https://developers.google.com/search/docs/essentials/spam-policies",
          "https://developers.google.com/search/blog/2023/02/google-search-and-ai-content"]
author_reviewed_by: "Jane Zhang (Redakteurin des Technikblogs)"
original_increment: "Google-Richtlinienanalyse + Drei-Achsen-Modell + Entwurf der Qualitätsschranken"
human_qa_status: "genehmigt"
last_updated: "2026-07-26"
ai_usage: "Recherche, Struktur und sprachliche Entwurfsüberarbeitung"
Risikobeispiel:
sources: []
author_reviewed_by: ""
original_increment: ""
human_qa_status: "Entwurf" → direkt veröffentlichen
last_updated: ""
ai_usage: "vollständig ohne menschliche Prüfung erzeugt"
Prüfungen nach Phase
| Phase | Pflichtfelder | Prüfung |
|---|---|---|
| Recherche | sources | Mindestens drei belastbare Quellen |
| Schreiben | original_increment | Mindestens eine eigene Erkenntnis, ein Fall oder Datenpunkt |
| Prüfung | author_reviewed_by, human_qa_status | Prüfer ist dokumentiert und Status lautet „genehmigt“ |
| Nach Veröffentlichung | gsc_feedback, last_updated | GSC-Feedback ist erfasst und das Datum gehört zu einer substanziellen Änderung |
Diese Felder sind keine direkten Vorgaben von Google. Sie sind eine Betriebspraxis, die aus den people-first-Prinzipien abgeleitet wurde. Andere Feldnamen sind möglich; die Logik bleibt: Jeder Artikel braucht Quellen, einen verantwortlichen Prüfer, eigenen Mehrwert, menschliche Genehmigung und eine gepflegte Aktualisierungshistorie.
Fazit
KI im Content-Prozess ist nicht der Verstoß. Minderwertige Massenveröffentlichung zur Ranking-Manipulation ist das Risiko. Drei Fragen entscheiden: Hilft der Hauptzweck Menschen? Fügt jede Seite echten Wert hinzu? Brauchen Nutzer die Seite tatsächlich?
Vor der Massenveröffentlichung wird das Content-Board geprüft. Sind sources, author_reviewed_by und original_increment vollständig? Hat der Artikel seine Schranke passiert? Belege, verantwortliche Prüfung und eigener Mehrwert müssen vorhanden sein, bevor veröffentlicht wird.
Ein eigener Beitrag wird AI Search und GEO vertiefen. Im Mittelpunkt steht dann, Inhalte für KI-Suche verständlich und zitierfähig zu machen, statt minderwertige Seiten für jede Suchvariante zu erzeugen.
Eine minimale Qualitätsschranke für KI-Content aufbauen
Von der Themenwahl bis zur Nachkontrolle werden für jeden Artikel Belege für Nutzwert, Faktenbasis und menschliche Verantwortung gespeichert.
- 1
Step 1: Zielgruppe und Themengrenze bestimmen
Lege fest, wem der Artikel hilft und welches Problem er löst. Wechsle nicht nur wegen möglichem Traffic in ein Gebiet ohne eigene Erfahrung. - 2
Step 2: Interne Überschneidungen prüfen
Suche vor der Recherche nach bestehenden Artikeln und entscheide zwischen neu erstellen, aktualisieren, zusammenführen oder stoppen. - 3
Step 3: Primärquellen sichern
Dokumentiere offizielle oder unmittelbare Belege und Abrufdaten für Richtlinien, Preise, Versionen und technische Grenzen. - 4
Step 4: Eigenen Beitrag benennen
Halte Tests, Erfahrungen, Analysen, Daten oder Entscheidungsmodelle fest, die der Artikel ergänzt. Reines Umformulieren reicht nicht. - 5
Step 5: Fakten und Darstellung prüfen
Kontrolliere Fakten, Beispiele, Titelversprechen, Duplikate und Automatisierungsspuren und ergänze nötige Praxisprüfungen. - 6
Step 6: Menschliche Verantwortung festhalten
Speichere Prüfer, Quellen, KI-Einsatz und Risikohinweise. Ein Mensch muss die finale Veröffentlichung genehmigen. - 7
Step 7: Echtes Feedback als Update-Auslöser nutzen
Nutze GSC-Abfragen und Seitendaten für substanzielle Aktualisierungen, statt nur Datum oder Zusammenfassung zu ändern.
FAQ
Bestraft Google KI-generierte Inhalte automatisch?
Lehnt Google KI-Content oder minderwertigen Massen-Content ab?
Was ist scaled content abuse?
Kann ein KI-gestützter Technikblog weiterhin SEO betreiben?
Sind Massenübersetzung und programmatisches SEO immer ein Verstoß?
Muss jeder KI-gestützte Artikel den KI-Einsatz offenlegen?
13 Min. Lesezeit · Veröffentlicht am: 13. Nov. 2026

Leitfaden zur Automatisierung von KI-Content-Sites
Du liest den ersten Beitrag dieser Serie. Lies den nächsten Beitrag oder öffne die Serienübersicht, um den gesamten Pfad zu sehen.


Kommentare
Melde dich mit GitHub an, um einen Kommentar zu hinterlassen