
KI-Themen-Agent in der Praxis: Blogideen aus Google, Reddit und GitHub finden
"Die Google Search Analytics API unterstützt Dimensionen wie query und page, einen rowLimit von 1 bis 25.000 sowie startRow-Paginierung und weist darauf hin, dass nicht alle Datenzeilen garantiert werden."
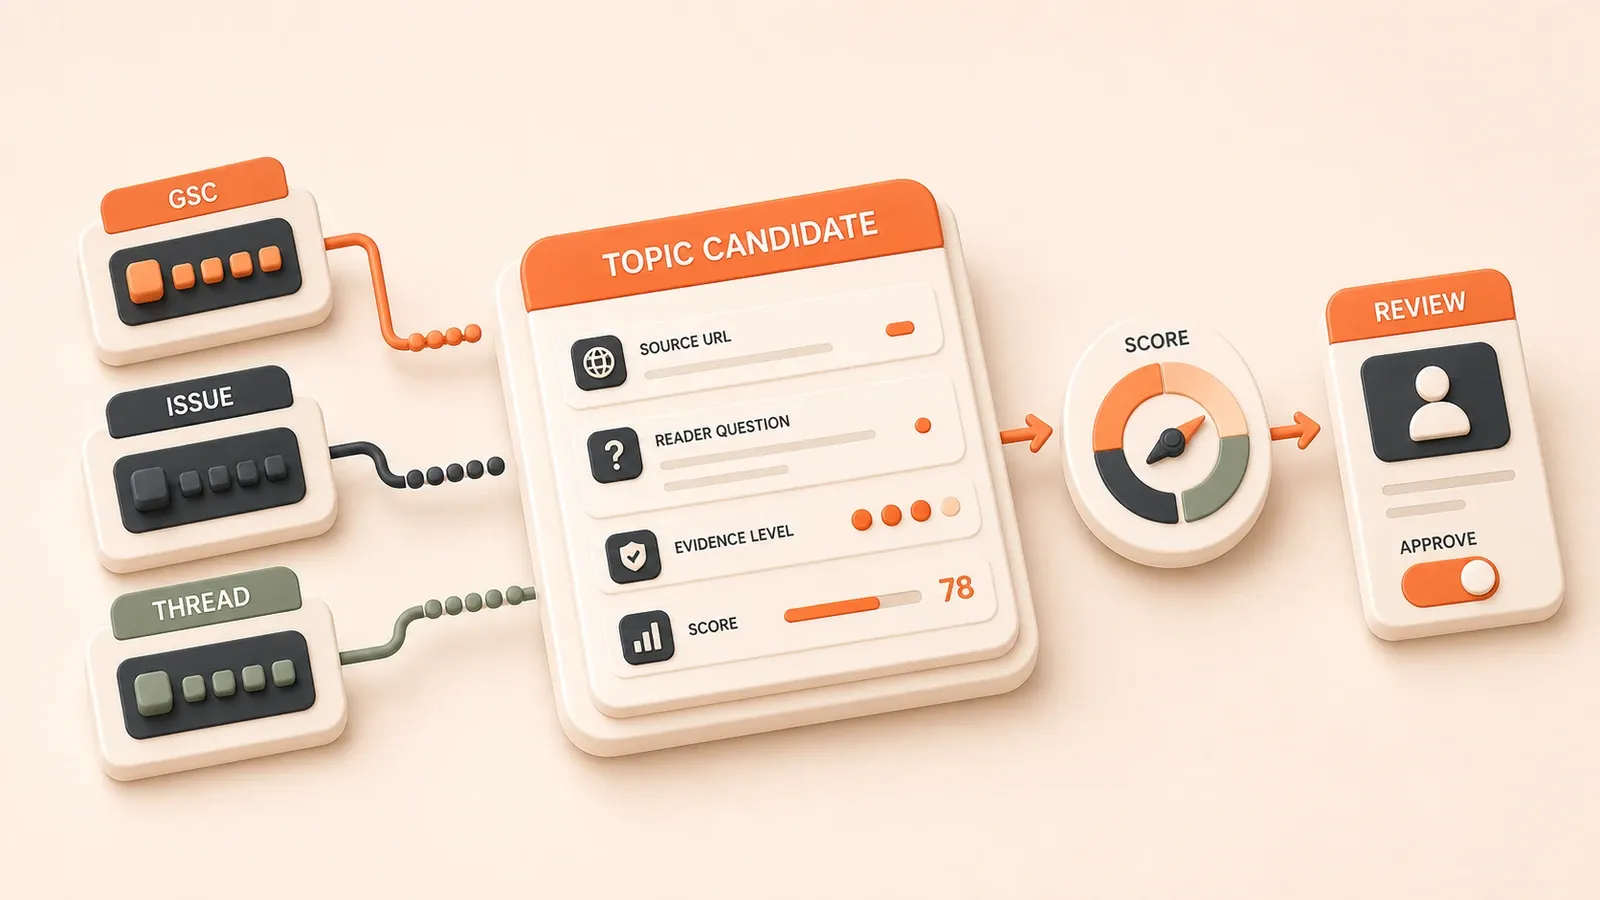
Eine Tabelle für Themenkandidaten beginnt meist mit drei Spalten: source_url speichert die Quelle, reader_question fasst die Formulierung der Lesenden zusammen und evidence_level kennzeichnet die Belastbarkeit der Evidenz. Ein Hinweis aus einem Forum gehört in die zweite Spalte, nicht in fact_claim; technische Fakten brauchen weiterhin offizielle Dokumentation oder einen reproduzierten Fehler.
Ein Themen-Agent jagt keinen Trends hinterher. Er verwandelt echte Suchanfragen aus Google Search Console, technische Hürden aus GitHub-Issues und Problemformulierungen aus Reddit oder HN in überprüfbare Kandidatenkarten. Bewertung, Deduplizierung und Risikofilter bestimmen, was den Content-Backlog erreicht. So bleibt der Ablauf wiederholbar und prüfbar.
Eingabeschichten für einen Themen-Agenten entwerfen
Google-Eigene Daten: Performance report und API-Grenzen
Die erste Eingabeschicht sollte aus den Suchdaten der eigenen Website stammen, nicht aus einem Trendwert eines Drittanbieters. Der Performance report der Google Search Console stellt vier Kernmetriken und sechs Dimensionen bereit.
Dimensionen im Performance report
| Dimension | Feld | Zweck |
|---|---|---|
| Suchanfrage | queries | Zeigt echte Suchbegriffe und findet Kandidaten mit vielen Impressionen, aber wenigen Klicks |
| Seite | pages | Zeigt Seiten mit vorhandenem Traffic und verhindert doppelte Inhalte |
| Land oder Region | countries | Erfasst regionale Unterschiede bei Themen für einzelne Märkte |
| Gerät | devices | Trennt mobile und desktop und beeinflusst Format und Detailtiefe |
| Darstellung in der Suche | search appearance | Zeigt Rich-Result-Typen und mögliche Lücken bei strukturierten Daten |
| Datum | dates | Definiert Stichproben- und Vergleichszeiträume |
Die vier Metriken sind clicks, impressions, CTR und average position. Für die Themenwahl sind impressions besonders nützlich: Erzielt eine query Impressionen, aber keine Klicks, suchen Menschen danach, während die Website das Anliegen womöglich noch nicht klar genug beantwortet.
Abfragedesign und Grenzen der Search Console API
Der programmgesteuerte Zugriff verwendet searchAnalytics.query. Laut Google-Dokumentation vom Juli 2026 erfordert die Methode OAuth, akzeptiert einen rowLimit von 1 bis 25.000 und unterstützt dimensions wie query oder page, filters wie country oder device sowie aggregationType.
Zwei Grenzen sind wichtig. Erstens garantiert die API nicht jede Datenzeile; interne Grenzen der Search Console bevorzugen Top-Zeilen. Zweitens können Abfragen aktueller Daten Metadaten zu noch nicht vollständig verarbeiteten Tagen oder Stunden enthalten. Der Agent sollte paginieren, Ergebnisse zwischenspeichern und einen Hinweis auf unvollständige Daten behalten, statt einen Export als vollständigen Datensatz zu behandeln.
Migrationshinweis zur Custom Search JSON API
Die Google Custom Search JSON API wurde häufig für programmatische Websuchen eingesetzt. Die offizielle Seite sagt inzwischen, dass sie für Neukunden geschlossen ist und Bestandskunden bis zum 1. Januar 2027 migrieren müssen. Neue Systeme sollten stattdessen ein unterstütztes Suchprodukt oder ein allgemeines Such-Gateway verwenden.
Nutzt ein bestehendes Projekt die API noch, sollte der Anbieter in der Konfiguration austauschbar sein und die Migration früh beginnen.
GitHub als Eingabe: Search-API-Grenzen und Issue-Abfragen
GitHub ist eine ergiebige Quelle für technische Themen. Issue-Titel beschreiben oft reale Fehler oder Funktionshürden; Release Notes und Discussions zeigen Versionsänderungen und Bedarf an Best Practices. Gleichzeitig besitzt die GitHub Search API feste Grenzen.
Grenzen und Ratenlimits der GitHub Search API
| Typ | Ratenlimit | Hinweis |
|---|---|---|
| authentifizierte Suche ohne code | 30 requests/min | Benötigt ein Token und eignet sich für laufende Sammlung |
| nicht authentifizierte Suche | 10 requests/min | Nur für seltene Tests mit öffentlichen Daten |
| code search | 10 requests/min | Erfordert Authentifizierung für Quellcodesuche |
Jede Suche liefert höchstens 1.000 Ergebnisse; weitere Ergebnisse können nicht per Paginierung abgerufen werden. Komplexe Abfragen können außerdem ein Timeout erreichen. Dann enthält die JSON-Antwort incomplete_results: true, was auf potenziell unvollständige Daten hinweist.
Issue-Abfragen und Zuordnung zu Artikeltypen
GitHub Search erlaubt kombinierbare Qualifier:

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
is:issue und is:pr trennen Ressourcentypen, in:title, in:body und in:comments begrenzen Felder, repo:, user: und org: den Suchraum. Hinzu kommen state:, label: und reason:.
Verschiedene Muster weisen auf unterschiedliche Artikelformate hin:
| Abfragemuster | Möglicher Artikeltyp | Beispielrichtung |
|---|---|---|
| bug + in:title + Fehlerbegriff | Fehlerbehebung | „Häufige Fehler nach einem Upgrade“ |
| enhancement + in:title | Vergleich oder Migration | „Neue Funktion versus alter Ansatz im Praxistest“ |
| discussion + in:body + “best practice” | Best Practices | „Praktische Ansätze aus einem Maintainer-Forum“ |
| closed + reason:“completed” | Versionsanalyse | „Neu in v2.0: verifizierte Issues und Migrationshinweise“ |
Umgang mit Ratenlimits und incomplete_results
Lies nach jedem API-Aufruf zuerst die x-ratelimit-*-Header. Verwende GET /rate_limit, wenn eine Übersicht über mehrere Ressourcen-Buckets nötig ist. Bei einer Begrenzung wird bis retry-after oder x-ratelimit-reset gewartet; wiederholte Fehlschläge führen zu exponentiellem Backoff und schließlich zum Abbruch.
Bei incomplete_results: true erhält die Kandidatenkarte den Vermerk „Daten möglicherweise unvollständig; manuelle Ergänzung erforderlich“. Das Ergebnis gilt nicht als vollständig. Sterne und Antwortzahlen bleiben ergänzende Signale und werden nicht zum einzigen Ranking-Faktor.
Reddit als Eingabe: Nur-Lese-Positivliste und Zugriffsrisiken
Community-Beiträge liefern natürliche Formulierungen und Problembeschreibungen. Richtlinien und Schutzmechanismen der Reddit API können sich jedoch ändern, wodurch der Abruf weniger zuverlässig ist. Diese Daten dienen nur der Formulierung von Suchintention und FAQ-Kandidaten; technische Aussagen benötigen offizielle Dokumentation oder reproduzierte Fehler.
Positivliste für schreibgeschützte Endpunkte
BetterLink-Recherche erlaubt nur Abruf und Suche, keine Schreiboperationen:
Erlaubte schreibgeschützte Endpunkte:
listing: Beitragslisten abrufencomments: Kommentare eines Beitrags abrufeninfo: Metadaten eines Beitrags oder Nutzers abrufensearch: Beiträge durchsuchen
Verbotene Schreibendpunkte:
comment: einen Kommentar veröffentlichensubmit: einen Beitrag veröffentlichenvote: abstimmensaveundhide: Beiträge speichern oder ausblenden
Beim Zugriff auf die Reddit API sollte diese Positivliste im Code festgelegt sein, damit kein Workflow versehentlich einen Schreibendpunkt aufruft.
Zugriffsrisiken und Ausweichwege
Häufige Ursachen sind abgelaufene oder unzureichende Tokens, temporäre Sperren nach zu vielen Anfragen und Änderungen an der Developer Platform, durch die Endpunkte entfallen.
Die Ausweichkette lautet:
- Reddit API aufrufen → bei Fehler den Fehler protokollieren
- Auf zugängliche Suchergebnisse zu Community-Problemen ausweichen
- Formulierungen und Problembeschreibungen extrahieren → FAQ-Kandidaten erzeugen
- Bewertung und Deduplizierung fortsetzen, ohne den gesamten Ablauf zu stoppen
Fällt Reddit aus, kann der Agent weiterhin GSC und GitHub verarbeiten. Es fehlt dann lediglich ein Teil der Formulierungs- und Problemsignale.
Daten als Formulierung, nicht als Beweis einordnen
Die drei Spalten der Kandidatentabelle verdeutlichen die Rolle:
| Spalte | Zweck | Zulässige Reddit-Daten |
|---|---|---|
source_url | Originalquelle | zulässig |
reader_question | normalisierte Leserfrage | zulässig und Hauptzweck |
evidence_level | Evidenzvertrauen | darf fact_claim nicht befüllen, nur reader_signal |
Aus „How to fix X error after upgrading to v2?“ entsteht beispielsweise eine Karte mit reader_question: "Wie behebe ich den Fehler nach dem Upgrade auf v2?" und evidence_level: "community". Die Evidenz erhält weniger Gewicht, und die Prüfung verlangt offizielle Dokumentation oder einen reproduzierten Fall.
Diese Trennung verhindert unbelegte Aussagen wie „Viele Menschen auf Reddit fragen danach“. Community-Beiträge liefern Sprache für die Suchintention, aber keinen Beweis für technische Fakten.
Themenkandidaten extrahieren und klassifizieren
Die Kernaufgabe besteht darin, GSC, GitHub und Reddit in einheitliche Kandidatenkarten zu überführen und danach Bewertung, Deduplizierung und Risikofilter anzuwenden. Der Ablauf umfasst fünf Schritte.
Fünf Schritte
Schritt 1: Google-Eigene Daten

queriesder letzten 30–90 Tage über die Search Console API abrufen- Suchanfragen mit vielen Impressionen und wenigen Klicks erkennen, etwa mit dem Beispielschwellwert impressions > 100 und CTR < 2%
- Seiten mit Traffic, aber ohne ausreichenden FAQ-Abschnitt finden
- Ausgabe: GSC-Kandidatentabelle mit
query,impressions,CTRundexisting_page
Schritt 2: GitHub-Issues klassifizieren
- Issues mithilfe der Vorlagen nach Repository oder Organisation gebündelt suchen
label:bugals Fehlerbehebung,label:enhancementals Vergleich und Discussions als Best Practices einordnen- Fehlerbegriffe, Versionsnummern und Funktionsnamen aus Issue-Titeln extrahieren
- Ausgabe: GitHub-Kandidatentabelle mit
issue_url,suggested_typeundkeywords
Schritt 3: Problembeschreibungen aus Reddit/HN
- Ausgewählte Subreddits oder HN durchsuchen und wiederkehrende Formulierungen extrahieren
- Muster wie „How to fix X“, „Why does X happen“ und „Best way to do X“ normalisieren
- Beiträge nur für die Formulierung verwenden, nicht als Beleg technischer Fakten
- Ausgabe: Tabelle mit
source_url,reader_questionundevidence_level: community
Schritt 4: Deduplizierung und interne Suche
- Website mit den Schlüsselwörtern jedes Kandidaten durchsuchen
- Prüfen, ob eine vorhandene Seite die Suchintention einer GSC-query bereits abdeckt
- Titelähnlichkeit berechnen, damit „Fehler nach einem Upgrade“ und „Umgang mit Upgrade-Fehlern“ nicht doppelt entstehen
- Ausgabe: deduplizierte Karten mit
duplicate_check_result
Schritt 5: Menschliche Prüfung
- Vor der Aufnahme prüfen:
- Sind die Werte für Suchchance, Website-Fit, Mehrwert und Überprüfbarkeit plausibel?
- Sind Titelrichtung und Schlüsselwörter korrekt?
- Braucht es einen neuen Artikel oder ein FAQ-Update in einem bestehenden Beitrag?
- Ausgabe: freigegebene Kandidatenkarten in den Content-Backlog übernehmen
Der Ablauf ist nicht vollständig autonom. Der Agent automatisiert Sammlung und Strukturierung, ein Mensch trifft die redaktionelle Entscheidung.
Suchchance, Website-Fit, Mehrwert und Überprüfbarkeit bewerten
Popularität allein macht ein Thema nicht veröffentlichungswürdig. Bewertet werden Passung zur Website, zusätzlicher Nutzen gegenüber bestehenden Inhalten und die Verfügbarkeit überprüfbarer Quellen.
Bewertungsdimensionen
| Dimension | Gewicht | Signale | Datenquelle |
|---|---|---|---|
| Suchchance | w1, zum Beispiel 0,3 | GSC impressions, query volume, Wettbewerberabdeckung | Search Console, externe SEO-Tools |
| Website-Fit | w2, zum Beispiel 0,25 | Themenbereich, Serienzuordnung, Tag-Passung | Website-Konfiguration, Serienliste, Tag-Bibliothek |
| Mehrwert | w3, zum Beispiel 0,25 | ähnliche interne Artikel und Qualität vorhandener SERP-Inhalte | interne Suche, Wettbewerbsrecherche |
| Überprüfbarkeit | w4, zum Beispiel 0,2 | offizielle docs, Issues, Releases, reproduzierbare Tests | Quellenmetadaten, evidence_level |
Formel: total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
Jede Dimension erhält einen Wert von 0 bis 1, sodass auch total_score in diesem Bereich liegt. Ein Beispielgrenzwert von 0,6 kann schwächere Kandidaten als „zur Prüfung zurückstellen“ markieren, statt sie automatisch aufzunehmen.
Bewertungsbeispiel: „Fehler nach einem Upgrade beheben“
Der Kandidat stamme aus is:issue state:open label:bug in:title error after upgrading to v2. Die Website behandelt DevOps und Container, der normalisierte Kandidat lautet „Häufige Fehler nach einem Upgrade“.
| Dimension | Wert | Begründung |
|---|---|---|
| Suchchance | 0,7 | GSC enthält eine ähnliche query mit mittleren impressions; konkurrierende Beiträge sind lückenhaft |
| Website-Fit | 0,8 | Eine Container-Upgrade-Serie und ein DevOps-Tag sind vorhanden; der Kandidat schließt eine Serienlücke |
| Mehrwert | 0,6 | Ein vorhandener Beitrag zu Upgrade-Hinweisen enthält keine Fehlerbehebung; Erweiterung oder fokussierter Unterartikel sind möglich |
| Überprüfbarkeit | 0,9 | GitHub-Issue und offizieller Release Note beschreiben die Breaking Change; der Fehler ist reproduzierbar |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
Da 0,74 > 0,6 ist, geht der Kandidat in die menschliche Prüfung. Zusätzlich erscheint die Empfehlung, zuerst den bestehenden Artikel zu erweitern oder bei eigenständigem Umfang einen Unterartikel zu erstellen.
Das Modell verhindert, dass unpassende Nachfrage verfolgt oder inhaltsgleiche Beiträge ohne neue Evidenz und Erfahrung veröffentlicht werden.
Deduplizierungs-, Evidenz- und Risikogates anwenden
Vor der Aufnahme durchläuft ein Kandidat drei Gates: interne Deduplizierung, Klassifizierung der Quellenzuverlässigkeit und Prüfung des Google-Qualitätsrisikos. Dadurch werden Duplikate, schwache Evidenz und Risiken skalierter Inhalte sichtbar.
Checkliste der drei Gates
Gate 1: Interne Deduplizierung
- Prüfen, ob eine GSC-query bereits eine eigene Seite besitzt
- Nach ähnlichen Titeln auf der Website suchen
- Titelähnlichkeit vergleichen, damit „Upgrade-Fehler beheben“ und „Fehler nach einem Upgrade behandeln“ nicht als getrennte Ideen gelten
unique,similar_to_existingoderduplicateinduplicate_check_resultschreiben
Gate 2: Evidenzvertrauen

evidence_levelfestlegen:high: offizielle Hilfe oder Dokumentation, ein Issue mit offizieller Antwort oder eigene Testdatenmedium: Community-Beitrag oder unabhängige Veröffentlichung ohne Maintainer-Bestätigunglow: unbekannte Quelle, fehlender Link oder unbelegte Schlussfolgerung
evidence_levelfür jede Kandidatenkarte verlangen
Gate 3: Google-Qualitätsrisiko
- Prüfen, ob der Kandidat skalierte Inhalte mit geringem Wert begünstigt:
- Ist er nur derselbe Artikel mit geändertem Parameter, etwa nahezu identische Anleitungen für Cloudflare Workers und Cloudflare Pages?
- Liefert er eine neue Perspektive, einen reproduzierbaren Test oder eine operative Entscheidung über gute vorhandene Inhalte hinaus?
- Trennt der Faktencheck Community-Formulierungen von offizieller Evidenz oder Testergebnissen?
safe,batch_risk,no_value_addedoderfact_check_neededinrisk_flagschreiben
Referenz für Evidenzstufen
| evidence_level | Quellentyp | Beispiel | Folgeschritt |
|---|---|---|---|
| high | official/help/docs | Google-Search-Console-Hilfe oder GitHub-Issue mit Maintainer-Antwort | Kann mit gespeicherter URL eine Aussage stützen |
| medium | community/blog | Forum, unabhängiger Beitrag oder technischer Blog | Für Leserformulierungen nutzen und Primärquelle ergänzen |
| low | unknown | Keine URL, reine Schlussfolgerung oder erfundene Daten | Ablehnen oder in eine Recherche-Warteschlange verschieben |
Mit evidence_level erkennen Prüfende sofort, welche Ideen stärkere Quellen benötigen. Ein Issue mit Maintainer-Antwort kann high sein, ein Austausch ausschließlich unter Nutzenden bleibt medium.
Die Gates löschen riskante Kandidaten nicht stillschweigend. Sie weisen sichtbare Zustände zu, damit ein Mensch über die nächste Aktion entscheiden kann.
Kandidatenkarten speichern und in den Backlog aufnehmen
Die endgültige Ausgabe ist eine Kandidatenkarte, kein Artikel. Nach menschlicher Freigabe wird sie zu einem Backlog-Eintrag für Keyword-Clustering und Schreib-Agenten.
Felder einer Kandidatenkarte
| Feld | Typ | Beschreibung | Beispiel |
|---|---|---|---|
source_url | string | ursprüngliche Quelle | https://github.com/user/repo/issues/123 |
reader_question | string | normalisierte Leserfrage | „Wie behebe ich Fehler nach dem Upgrade auf v2?“ |
evidence_level | enum | Quellenvertrauen | high / medium / low |
search_value_score | number | Suchchance von 0 bis 1 | 0,7 |
site_match_score | number | Website-Fit von 0 bis 1 | 0,8 |
value_score | number | Mehrwert von 0 bis 1 | 0,6 |
verify_score | number | Überprüfbarkeit von 0 bis 1 | 0,9 |
total_score | number | gewichtete Summe von 0 bis 1 | 0,74 |
suggested_type | enum | empfohlenes Format | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | empfohlene Serie | cloudflare-bindui, wenn diese Serie existiert |
duplicate_check_result | enum | Ergebnis der internen Prüfung | unique / similar_to_existing / duplicate |
risk_flag | enum | Qualitätsrisiko | safe / batch_risk / no_value_added / fact_check_needed |
Kandidatenkarten lassen sich als JSON oder Datenbankeintrag speichern. Prüfende sehen alle Felder und entscheiden nicht nur anhand von Titel und Popularität.
Felder im Content-Backlog
Ein freigegebener Kandidat wird zu einem Eintrag mit:
- Titel, der bei der menschlichen Prüfung finalisiert wird
- primären und sekundären Keywords
- Status
to_write,writing,reviewoderpublished total_scoredes Kandidaten- Sprache wie zh oder en gemäß Website-Konfiguration
- Serie, wenn
suggested_seriesgültig ist - geplantem Veröffentlichungsdatum und Priorität
Ein Folgeartikel kann das vollständige Schema und die API definieren. Dieser Ablauf behandelt nur die Aufnahme der Kandidatenkarte.
Ablauf der menschlichen Prüfung
Vor der Aufnahme prüft eine Person:
- Bewertung: Ist
total_scoreplausibel, und erfordert ein niedriger Wert wieverify_score = 0.2zusätzliche Evidenz? - Titel und Keywords: Erfasst
reader_questiondas Problem korrekt, und sollten Keywords geändert werden? - Zweite interne Suche: Hat die automatische Deduplizierung einen ähnlichen Beitrag übersehen?
- Aufnahmeentscheidung: Freigeben, ablehnen oder weitere Evidenz anfordern und den Grund dokumentieren
Der Ablauf lautet Agent-Extraktion → strukturierte Bewertung und Filterung → menschliche Prüfung → Aufnahme. Die Automatisierung ordnet verstreute Signale zu vergleichbaren Karten, während die redaktionelle Verantwortung beim Menschen bleibt.
Nächste Schritte und verwandte Artikel
Nach Bewertung und Freigabe folgen meist Keyword-Clustering, Backlog-Verwaltung und Schreibplanung. Diese Beiträge bieten passenden Implementierungskontext:
- KI-Recherche-Agent: von der plattformübergreifenden Suche zum Evidenzbericht
- Wöchentliche GA/GSC-SOP für Seiten mit vielen Impressionen und wenigen Klicks
- Fortgeschrittene Techniken für Google Search Console
- Quartalsplanung für Themen in technischen Blogs
Ein Themen-Agent ist nur die erste Stufe der Content-Automatisierung. Er verwandelt Signale aus mehreren Quellen in überprüfbare Kandidaten; Clustering, Aufgabenverwaltung, Schreibprüfung und Inhaltsaktualisierung bleiben getrennte nachgelagerte Schritte.
Einen minimalen KI-Themen-Agenten aufbauen
Normalisiere Nachfragesignale aus mehreren Quellen zu Kandidatenkarten, bewerte und dedupliziere sie und übernimm nur menschlich freigegebene Einträge.
- 1
Step 1: Content-Inventar laden
Lies vorhandene Beiträge, Serienpläne und Tags als Grundlage für Deduplizierung und Website-Fit. - 2
Step 2: GSC-Daten abrufen
Rufe clicks, impressions, CTR und average position nach query und page ab und markiere bestehende Nachfrage und Inhaltslücken. - 3
Step 3: Externen Kontext ergänzen
Nutze eine allgemeine Suche für SERP-Fragen und Primärquellen und speichere Suchbegriff, Zeitpunkt, URL und Abrufstatus. - 4
Step 4: Community- und Issue-Signale nur lesend sammeln
Extrahiere Leserformulierungen aus Reddit sowie Fehler-, Versions- und Funktionsprobleme aus GitHub-Issues, ohne Schreiboperationen auszuführen. - 5
Step 5: Kandidaten normalisieren und bewerten
Erstelle Kandidatenkarten und bewerte Suchchance, Website-Fit, Mehrwert und Überprüfbarkeit. - 6
Step 6: Duplikate und Risiken filtern
Normalisiere Entitäten und Suchintention und prüfe interne Überschneidungen, Evidenzstufen, Risiken skalierter Inhalte und volatile Fakten. - 7
Step 7: Menschlich prüfen und aufnehmen
Lass die bestbewerteten Karten prüfen, übernimm nur freigegebene Einträge und dokumentiere Erstellen, Aktualisieren, FAQ-Ergänzung, Zusammenführen oder Verwerfen.
FAQ
Soll ein Themen-Agent Google-Suchergebnisse oder Search-Console-Daten bevorzugen?
Kann ein beliebter Reddit-Beitrag direkt zum Blogthema werden?
Welche technischen Themen lassen sich aus GitHub-Issues ableiten?
Wie unterscheidet man echte Nachfrage von einer einmaligen Beschwerde?
Muss der Ablauf bei einem Ausfall von GitHub Search oder Reddit stoppen?
Eignet sich die Google Custom Search JSON API für neue Projekte?
Was muss vor der Aufnahme in den Content-Backlog geprüft werden?
11 Min. Lesezeit · Veröffentlicht am: 13. Nov. 2026

Leitfaden zur Automatisierung von KI-Content-Sites
Wenn du über die Suche hier gelandet bist, kommst du am schnellsten weiter, indem du zum vorherigen oder nächsten Beitrag dieser Serie springst.
Vorheriger
Kann KI-Content noch ranken? Googles Regeln für Masse und Qualität
Googles Dokumentation erklärt, wann KI-Content zulässig ist, wann skalierte Veröffentlichung zu Spam wird und welche menschlichen Prüfungen Risiken senken.
Teil 1 von 4
Nächster
KI-Keyword-Clustering: Suchanfragen in Content-Serien und interne Links überführen
GSC-Suchanfragen, Themenideen und Beiträge semantisch gruppieren, mit SERPs prüfen und jedem Cluster eine Seite, Aktualisierung, FAQ oder Verlinkung zuweisen.
Teil 3 von 4


Kommentare
Melde dich mit GitHub an, um einen Kommentar zu hinterlassen