
AI 주제 조사 에이전트: Google, Reddit, GitHub에서 기술 블로그 아이디어 찾기
"Google Search Analytics API는 검색어와 페이지 차원, 1~25,000의 rowLimit, startRow 페이지 이동을 지원하지만 모든 데이터 행을 보장하지 않는다고 명시합니다."
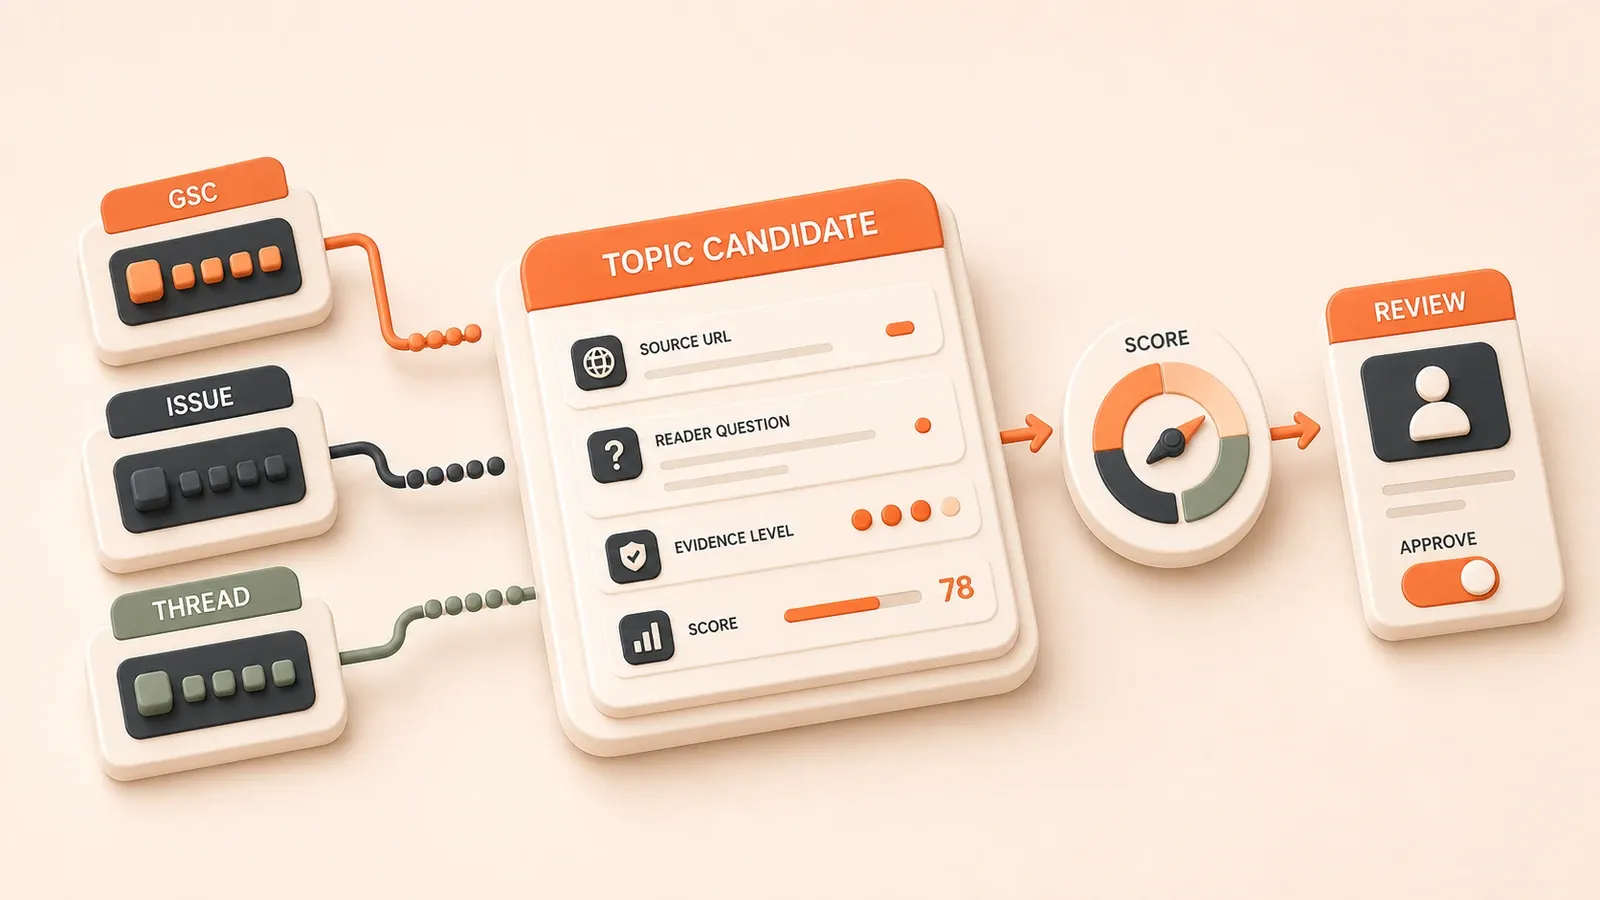
주제 후보 표는 보통 세 열로 시작합니다. source_url에는 출처를, reader_question에는 독자가 문제를 표현한 방식을, evidence_level에는 근거의 신뢰도를 기록합니다. 포럼에서 얻은 질문은 두 번째 열에 들어가며 fact_claim에 넣지 않습니다. 기술 사실은 여전히 공식 문서나 재현한 오류가 뒷받침해야 합니다.
주제 조사 에이전트는 유행을 쫓는 봇이 아닙니다. 실제 Google Search Console 검색어와 GitHub 이슈의 기술 마찰을 감사 가능한 후보 카드로 바꿉니다. 별도의 포럼 입력은 독자가 문제를 표현하는 언어를 제공합니다. 점수, 중복 제거, 위험 필터가 백로그에 들어갈 항목을 결정하므로 영감에 기대지 않고 반복하고 검토할 수 있습니다.
주제 조사 에이전트의 입력 계층 설계
Google 자체 데이터: 실적 보고서와 API 경계
첫 입력 계층은 제3자 추세 점수가 아니라 자체 사이트 검색 데이터여야 합니다. Google Search Console 실적 보고서는 네 가지 핵심 측정항목과 여섯 가지 측정기준을 제공합니다.
실적 보고서 측정기준
| 측정기준 유형 | 필드 | 용도 |
|---|---|---|
| 검색어 | queries | 독자가 실제 입력한 표현과 노출은 높지만 클릭이 낮은 후보를 보여 줍니다 |
| 페이지 | pages | 이미 트래픽을 받는 페이지를 찾아 중복 작성을 막습니다 |
| 국가 또는 지역 | countries | 특정 시장에만 해당하는 주제의 지역 차이를 기록합니다 |
| 기기 | devices | 형식과 깊이에 영향을 줄 수 있는 모바일과 데스크톱 행동을 구분합니다 |
| 검색 노출 형태 | search appearance | 리치 결과 유형과 구조화 데이터 공백을 찾습니다 |
| 날짜 | dates | 표본과 비교 기간을 정합니다 |
네 측정항목은 clicks, impressions, CTR, average position입니다. 특히 impressions는 주제 발견에 유용합니다. 검색어가 노출되지만 클릭되지 않는다면 독자가 찾는 내용을 사이트가 충분히 명확하게 다루지 않았을 수 있습니다.
Search Console API 쿼리 설계와 제한
프로그램 접근에는 searchAnalytics.query 메서드를 사용합니다. 2026년 7월 기준 Google 문서에 따르면 OAuth 승인이 필요하고 rowLimit은 1~25,000이며 검색어나 페이지 같은 dimensions, 국가나 기기 같은 filters, aggregationType을 지원합니다.
두 가지 제약이 중요합니다. 첫째, API는 모든 데이터 행을 보장하지 않으며 Search Console 내부 제한은 상위 행을 우선합니다. 둘째, 최근 데이터를 요청하면 아직 처리 중인 날짜나 시간을 알리는 메타데이터가 포함될 수 있습니다. 에이전트는 페이지를 이동하고 결과를 캐시하며, 내보내기를 완전한 데이터셋으로 간주하지 말고 불완전 상태를 보존해야 합니다.
Custom Search JSON API 이전 경고
Google Custom Search JSON API는 한때 프로그램에서 웹 검색을 실행하는 일반적인 방법이었지만, 현재 공식 페이지는 신규 고객에게 닫혀 있고 기존 고객도 2027년 1월 1일까지 이전해야 한다고 안내합니다. 새 시스템은 이 API에 의존하지 말고 지원되는 검색 제품이나 일반 검색 게이트웨이를 사용해야 합니다.
기존 프로젝트가 아직 Custom Search JSON API를 사용한다면 일찍 이전을 계획하고 구성에서 검색 공급자를 교체할 수 있게 유지합니다.
GitHub 입력: Search API 경계와 이슈 쿼리 템플릿
GitHub는 기술 주제 아이디어를 찾기 좋은 출처입니다. 이슈 제목은 실제 오류나 제품 제약을 설명하고, 릴리스 노트와 토론은 버전 변경과 모범 사례 요청을 보여 줍니다. GitHub Search API에도 명확한 한도가 있습니다.
GitHub Search API 제한과 요청 한도
| 유형 | 요청 한도 | 설명 |
|---|---|---|
| 인증 검색, 코드 제외 | 분당 30회 | 토큰이 필요하며 연속 수집에 적합합니다 |
| 비인증 검색 | 분당 10회 | 공개 접근이며 낮은 빈도의 테스트에만 적합합니다 |
| 코드 검색 | 분당 10회 | 소스 코드 검색에는 인증이 필요합니다 |
검색 한 번은 최대 1,000개 결과를 제공하며 페이지 이동으로도 그 이상을 노출할 수 없습니다. 쿼리가 시간 초과되면 JSON 응답에 incomplete_results: true가 설정되어 반환 집합이 불완전할 수 있음을 알립니다.
이슈 쿼리 템플릿과 글 유형 매핑
GitHub 검색은 조합 가능한 한정자를 지원합니다.
is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
일반 한정자에는 리소스 유형을 정하는 is:issue, is:pr, 필드를 정하는 in:title, in:body, in:comments, 범위를 정하는 repo:, user:, org:, 그리고 state:, label:, reason:이 있습니다.
패턴에 따라 적합한 글 형식도 달라집니다.
| 쿼리 패턴 | 후보 글 유형 | 제목 방향 예시 |
|---|---|---|
| bug + in:title + 오류 키워드 | 문제 해결 | ”업그레이드 후 자주 발생하는 오류” |
| enhancement + in:title | 비교 또는 이전 | ”새 기능과 기존 방식 비교: 실무 기준” |
| discussion + in:body + “best practice” | 모범 사례 | ”유지관리자 포럼에서 찾은 실무 접근법” |
| closed + reason:“completed” | 릴리스 분석 | ”v2.0의 변경점: 확인된 이슈와 이전 참고사항” |
요청 한도와 incomplete_results 대체 처리
각 API 호출 뒤에는 먼저 x-ratelimit-* 응답 헤더를 읽습니다. 리소스 버킷 전체 요약이 필요할 때 GET /rate_limit을 호출합니다. 한도를 넘으면 retry-after 또는 x-ratelimit-reset까지 기다리고, 계속 실패하면 지수 백오프를 적용하다가 재시도를 중단합니다.
incomplete_results: true가 나타나면 결과를 완전한 것으로 취급하지 말고 후보 카드에 “데이터가 불완전할 수 있으며 수동 확인이 필요함”을 표시합니다. 별 수와 답변 수는 보조 신호로 쓸 수 있지만 단독 순위 기준이 되어서는 안 됩니다.
Reddit 입력: 읽기 전용 허용 목록과 접근 위험
포럼 게시물은 실제 독자의 표현과 문제 용어를 제공하지만 Reddit API 정책과 오용 방지 제어는 바뀔 수 있어 수집 안정성이 낮습니다. 이 신호는 의도와 FAQ 후보에만 사용하고, 글의 기술 주장은 공식 문서나 재현한 오류로 확인합니다.
읽기 전용 엔드포인트 허용 목록
BetterLink 조사는 가져오기와 검색만 허용하며 쓰기 작업은 허용하지 않습니다.
허용된 읽기 전용 엔드포인트:
listing: 게시물 목록 가져오기comments: 게시물 댓글 가져오기info: 게시물 또는 사용자 메타데이터 가져오기search: 게시물 검색하기
금지된 쓰기 엔드포인트:
comment: 댓글 게시하기submit: 게시물 게시하기vote: 투표하기save와hide: 게시물 저장 또는 숨기기
에이전트가 Reddit API에 접근한다면 코드에 읽기 전용 허용 목록을 넣어 워크플로가 실수로 쓰기 엔드포인트를 호출하지 못하게 합니다.
접근 위험과 대체 경로
Reddit 접근이 실패하는 일반적인 이유는 세 가지입니다. 만료되거나 권한이 부족한 토큰으로 인한 승인 실패, 과도한 트래픽 뒤의 일시적 오용 방지 차단, 엔드포인트를 비활성화하는 Developer Platform 정책 변경입니다.
다음 순서를 사용합니다.
- Reddit API 요청 시도 → 실패하면 오류 기록
- 접근 가능한 커뮤니티 질문 검색 결과로 대체
- 질문 표현과 문제 용어 추출 → FAQ 후보 생성
- 워크플로를 멈추지 않고 점수와 중복 검사 계속
Reddit 수집이 실패해도 에이전트는 GSC와 GitHub를 계속 사용할 수 있으며, 독자 표현과 문제 신호 일부만 잃습니다.
데이터를 증거가 아닌 질문 입력으로 배치하기
세 개의 후보 표 열이 Reddit의 역할을 명확히 보여 줍니다.
| 열 | 용도 | Reddit 데이터에 허용되는 내용 |
|---|---|---|
source_url | 원본 출처 | 허용 |
reader_question | 정규화한 독자 질문 | 허용되며 주된 용도 |
evidence_level | 근거 신뢰도 | fact_claim을 채우지 말고 reader_signal로만 기록 |
예를 들어 “How to fix X error after upgrading to v2?”라는 게시물은 reader_question: "v2로 업그레이드한 뒤 오류를 어떻게 해결하나요?", evidence_level: "community"인 후보 카드가 됩니다. 점수에서는 근거 가중치를 낮추고 검토 화면에서 공식 문서나 재현 사례를 요구합니다.
이 구분은 “Reddit에서 많은 사람이 묻고 있다” 같은 근거 없는 주장을 막습니다. Reddit은 기술 사실의 증거가 아니라 검색 의도의 표현을 제공합니다.
후보 주제 추출과 분류
에이전트의 핵심 작업은 GSC, GitHub, Reddit 세 입력을 후보 카드로 정규화한 뒤 점수, 중복, 위험 필터를 통과시키는 것입니다. 워크플로는 다섯 단계입니다.
5단계 워크플로
1단계: Google 자체 데이터

- Search Console API에서 최근 30~90일의
queries조회 - 노출 > 100, CTR < 2% 같은 예시 기준으로 노출은 높고 클릭은 낮은 검색어 식별
- 트래픽은 있지만 FAQ 섹션이 없는 페이지 찾기
query,impressions,CTR,existing_page가 있는 GSC 후보 표 출력
2단계: GitHub 이슈 분류
- 위 템플릿을 사용해 저장소 또는 조직별로 이슈를 묶어서 검색
label:bug는 문제 해결,label:enhancement는 비교, 토론은 모범 사례 후보로 분류- 이슈 제목에서 오류 용어, 버전 번호, 기능 이름 추출
issue_url,suggested_type,keywords가 있는 GitHub 후보 표 출력
3단계: Reddit과 HN 문제 표현 추출
- 선택한 subreddit 또는 HN을 검색하고 반복되는 독자 표현 추출
- “X를 해결하는 방법”, “X가 발생하는 이유”, “X를 하는 가장 좋은 방법” 같은 패턴 정규화
- 게시물은 질문 표현에만 사용하고 기술 사실의 증명에는 사용하지 않음
source_url,reader_question,evidence_level: community가 있는 질문 표 출력
4단계: 중복 제거와 내부 검색
- 후보의 키워드로 사이트 검색
- GSC 검색어의 의도를 이미 다루는 페이지가 있는지 확인
- “업그레이드 뒤 오류”와 “업그레이드 오류 처리”가 별도 중복이 되지 않도록 제목 유사도 계산
duplicate_check_result가 있는 중복 제거 카드 출력
5단계: 사람 검토
- 카드를 등록하기 전에 다음 항목 검토:
- 검색 기회, 사이트 적합성, 추가 가치, 검증 가능성 점수가 타당한지
- 제목 방향과 키워드가 정확한지
- 새 글과 기존 글 FAQ 갱신 중 어떤 조치가 맞는지
- 승인한 후보 카드를 콘텐츠 백로그로 출력
완전 자율 워크플로가 아닙니다. 에이전트가 수집을 자동화하고 구조화한 결과를 만들지만 최종 편집 결정은 사람이 내립니다.
검색 기회, 사이트 적합성, 추가 가치, 검증 가능성 평가
주제가 인기 있다는 이유만으로 게시할 가치는 없습니다. 사이트에 맞는지, 아직 다루지 않은 가치를 더하는지, 검증 가능한 출처로 뒷받침할 수 있는지를 평가해야 합니다.
평가 차원
| 차원 | 가중치 | 평가 신호 | 데이터 출처 |
|---|---|---|---|
| 검색 기회 | w1, 예: 0.3 | GSC 노출, 검색량, 경쟁 콘텐츠 범위 | Search Console, 제3자 SEO 도구 |
| 사이트 적합성 | w2, 예: 0.25 | 사이트 범위, 시리즈 포함 여부, 태그 정렬 | 사이트 구성, 시리즈 목록, 태그 라이브러리 |
| 추가 가치 | w3, 예: 0.25 | 비슷한 내부 글과 기존 SERP 콘텐츠 품질 | 내부 검색, 경쟁 조사 |
| 검증 가능성 | w4, 예: 0.2 | 공식 문서, 이슈, 릴리스, 재현 가능한 테스트 | 출처 메타데이터, evidence_level |
공식: total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
각 차원을 0~1로 평가하면 total_score도 같은 범위에 남습니다. 예시 임계값 0.6보다 낮은 후보는 자동 등록하지 않고 “검토 대기”로 표시할 수 있습니다.
평가 예시: “업그레이드 후 오류 해결”
후보가 is:issue state:open label:bug in:title error after upgrading to v2에서 왔다고 가정합니다. 사이트는 DevOps와 컨테이너를 다루며 정규화한 주제는 “업그레이드 후 자주 발생하는 오류”입니다.
| 차원 | 점수 | 근거 |
|---|---|---|
| 검색 기회 | 0.7 | GSC에 중간 수준 노출의 관련 검색어가 있고 경쟁 글은 내용이 분산되어 있습니다 |
| 사이트 적합성 | 0.8 | 컨테이너 업그레이드 시리즈와 DevOps 태그가 있으며 후보가 시리즈 공백을 채웁니다 |
| 추가 가치 | 0.6 | 기존 업그레이드 노트에 오류 해결이 없어 글을 확장하거나 집중된 하위 글을 만들 수 있습니다 |
| 검증 가능성 | 0.9 | GitHub 이슈와 공식 릴리스 노트가 호환성 변경을 설명하고 오류를 재현할 수 있습니다 |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
0.74 > 0.6이므로 후보는 사람 검토로 이동합니다. 검토자는 기존 글을 먼저 갱신할지, 범위가 충분하면 집중된 하위 글을 만들지도 추천으로 확인합니다.
이 모델은 사이트에 맞지 않는 수요를 쫓는 오류와, 의미 있는 근거나 경험을 더하지 않는 중복 게시를 막습니다.
중복 제거, 근거 등급, 위험 게이트 적용
후보는 백로그에 들어가기 전에 내부 중복 제거, 출처 신뢰도 분류, Google 품질 위험 확인이라는 세 게이트를 통과해야 합니다. 세 검사는 중복, 약한 근거, 대량 콘텐츠 위험을 드러냅니다.
세 가지 게이트 체크리스트
게이트 1: 내부 중복 제거
- GSC 검색어에 전용 페이지가 이미 있는지 확인
- 사이트에서 비슷한 제목 검색
- “업그레이드 오류 해결”과 “업그레이드 뒤 오류 처리”를 다른 아이디어로 보지 않도록 유사도 비교
duplicate_check_result에unique,similar_to_existing,duplicate중 하나 기록
게이트 2: 근거 신뢰도

evidence_level설정:high: 공식 도움말이나 문서, 공식 답변이 있는 이슈, 직접 테스트 데이터medium: 유지관리자 확인이 없는 커뮤니티 게시물이나 독립 출판물low: 출처 불명, 링크 없음, 뒷받침 없는 추론
- 모든 후보 카드에
evidence_level요구
게이트 3: Google 품질 위험
- 후보가 가치 낮은 대량 콘텐츠를 유도하는지 확인:
- Cloudflare Workers와 Cloudflare Pages 설정 글처럼 매개변수만 바꾼 거의 같은 글인가?
- 기존의 강한 콘텐츠를 넘어 새 관점, 재현 테스트, 운영 판단을 더하는가?
- 사실 확인 계획이 Reddit 질문을 공식 근거나 테스트 결과와 분리하는가?
risk_flag에safe,batch_risk,no_value_added,fact_check_needed중 하나 기록
근거 등급 참고표
| evidence_level | 출처 유형 | 예시 | 후속 조치 |
|---|---|---|---|
| high | 공식/도움말/문서 | Google Search Console 도움말 또는 유지관리자 답변이 있는 이슈 | 출처 URL을 보관하면 주장을 뒷받침할 수 있습니다 |
| medium | 커뮤니티/블로그 | 포럼 글, 독립 게시물, 기술 블로그 | 독자 표현에 사용하고 글에는 1차 출처를 추가합니다 |
| low | 불명 | 출처 URL 없음, 순수 추론, 조작된 데이터 | 거절하거나 추가 조사 큐로 이동합니다 |
모든 후보 카드에 evidence_level이 있어야 검토자가 더 강한 출처가 필요한 아이디어를 즉시 알 수 있습니다. 유지관리자 답변이 있는 GitHub 이슈는 high일 수 있지만 사용자끼리의 토론은 medium입니다.
이 게이트는 위험한 후보를 조용히 삭제하지 않고 눈에 보이는 상태를 부여합니다. 표시된 카드는 검토 큐에 들어갈 수 있지만 사람은 문제를 확인한 뒤 결정합니다.
후보 카드를 저장하고 백로그에 등록
에이전트의 최종 출력은 글이 아니라 후보 카드입니다. 사람의 승인 뒤 카드는 후속 키워드 클러스터링과 작성 에이전트가 사용할 콘텐츠 백로그 레코드가 됩니다.
후보 카드 필드
| 필드 | 유형 | 설명 | 예시 |
|---|---|---|---|
source_url | string | 원본 출처 | https://github.com/user/repo/issues/123 |
reader_question | string | 정규화한 독자 질문 | ”v2 업그레이드 뒤 오류를 어떻게 해결하나요?” |
evidence_level | enum | 출처 신뢰도 | high / medium / low |
search_value_score | number | 0~1의 검색 기회 | 0.7 |
site_match_score | number | 0~1의 사이트 적합성 | 0.8 |
value_score | number | 0~1의 추가 가치 | 0.6 |
verify_score | number | 0~1의 검증 가능성 | 0.9 |
total_score | number | 0~1의 가중 합계 | 0.74 |
suggested_type | enum | 권장 형식 | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | 권장 시리즈 | 사이트에 시리즈가 있을 때 cloudflare-bindui |
duplicate_check_result | enum | 내부 중복 결과 | unique / similar_to_existing / duplicate |
risk_flag | enum | 품질 위험 표시 | safe / batch_risk / no_value_added / fact_check_needed |
후보 카드는 JSON이나 데이터베이스 레코드로 저장할 수 있습니다. 검토자는 제목과 인기 지표만 보지 않고 모든 필드를 확인합니다.
백로그 필드
승인된 후보는 다음 필드가 있는 백로그 레코드가 됩니다.
- 사람 검토에서 확정한 제목
- 기본 및 보조 키워드
- 상태:
to_write,writing,review,published - 후보의
total_score - 사이트 구성에 따른 zh 또는 en 같은 locale
suggested_series가 유효할 때 시리즈- 예정 게시일과 우선순위
다음 글에서 전체 백로그 스키마와 API를 정의할 수 있습니다. 이 워크플로는 후보 카드가 등록 자격을 얻는 과정만 다룹니다.
사람 검토 워크플로
등록 전에 사람이 다음 항목을 확인합니다.
- 점수 검토:
total_score가 타당하며verify_score = 0.2처럼 낮은 차원에 더 많은 근거가 필요한가? - 제목과 키워드 검토:
reader_question이 문제를 정확히 나타내며 키워드를 바꿔야 하는가? - 두 번째 내부 검색: 자동 중복 제거가 비슷한 글을 놓치지 않았는가?
- 등록 결정: 승인, 거절, 추가 근거 요청 중 하나를 선택하고 이유를 기록
흐름은 에이전트 추출 → 구조화한 점수와 필터 → 사람 검토 → 등록입니다. 자동화는 흩어진 신호를 비교 가능한 카드로 정리하지만 편집 책임은 사람에게 남습니다.
다음 단계와 관련 글
점수와 검토 뒤에는 보통 키워드 클러스터링, 백로그 관리, 작성 계획이 이어집니다. 다음 글에서 구현 맥락을 확인할 수 있습니다.
- AI 조사 에이전트: 여러 플랫폼 검색에서 근거 보고서까지
- 노출은 높고 클릭은 낮은 페이지를 위한 주간 GA/GSC 운영 절차
- Google Search Console 고급 활용법
- 기술 블로그 분기별 주제 계획
주제 조사 에이전트는 콘텐츠 사이트 자동화의 첫 단계일 뿐입니다. 여러 출처의 신호를 검토 가능한 후보로 바꾸며, 클러스터링, 작업 관리, 작성 검증, 콘텐츠 갱신은 별도의 후속 책임으로 남습니다.
최소 기능 AI 주제 조사 에이전트 만들기
여러 출처의 신호를 후보 카드로 정규화하고 점수와 중복을 확인한 뒤 사람이 승인한 항목만 콘텐츠 백로그에 기록합니다.
- 1
Step 1: 콘텐츠 인벤토리 불러오기
기존 글, 시리즈 계획, 태그를 읽어 중복 검사와 사이트 적합성 평가의 기준을 만듭니다. - 2
Step 2: GSC 데이터 가져오기
검색어와 페이지별 클릭, 노출, CTR, 평균 순위를 가져와 기존 수요와 콘텐츠 공백을 표시합니다. - 3
Step 3: 외부 맥락 추가하기
일반 검색에서 SERP 질문과 1차 출처를 찾고 검색어, 시각, URL, 가져오기 상태를 저장합니다. - 4
Step 4: 커뮤니티와 이슈 신호를 읽기 전용으로 수집하기
쓰기 작업 없이 Reddit 질문 표현과 GitHub 이슈의 오류, 버전, 기능 마찰을 추출합니다. - 5
Step 5: 후보 정규화 및 평가하기
후보 카드를 만들고 검색 기회, 사이트 적합성, 추가 가치, 검증 가능성을 평가합니다. - 6
Step 6: 중복과 위험 걸러내기
개체와 의도를 정규화한 뒤 내부 중복, 근거 등급, 대량 콘텐츠 위험, 변동 사실을 확인합니다. - 7
Step 7: 후보 검토 및 등록하기
사람이 상위 카드를 검토하고 승인 항목만 백로그에 기록하며 생성, 갱신, 확장, 병합, 폐기 중 조치를 남깁니다.
FAQ
주제 조사 에이전트는 Google 결과를 스크래핑해야 하나요, Search Console 데이터를 써야 하나요?
인기 있는 Reddit 게시물을 바로 블로그 주제로 만들 수 있나요?
GitHub 이슈에서 어떤 기술 주제를 찾을 수 있나요?
실제 수요와 일회성 불만은 어떻게 구분하나요?
GitHub Search나 Reddit 접근이 실패하면 워크플로를 중단해야 하나요?
Google Custom Search JSON API는 새 프로젝트에 적합한가요?
후보가 콘텐츠 백로그에 들어가기 전에 무엇을 검토해야 하나요?
2분 읽기 · 게시일: 2026년 11월 13일


댓글
GitHub로 로그인하여 댓글을 남기세요