
AI 选题 Agent 实战:从 Google、Reddit、GitHub 找技术博客选题
"Google Search Analytics API 支持 query/page 等维度、1 到 25,000 的 rowLimit 和 startRow 分页,同时明确不保证返回全部数据行。"
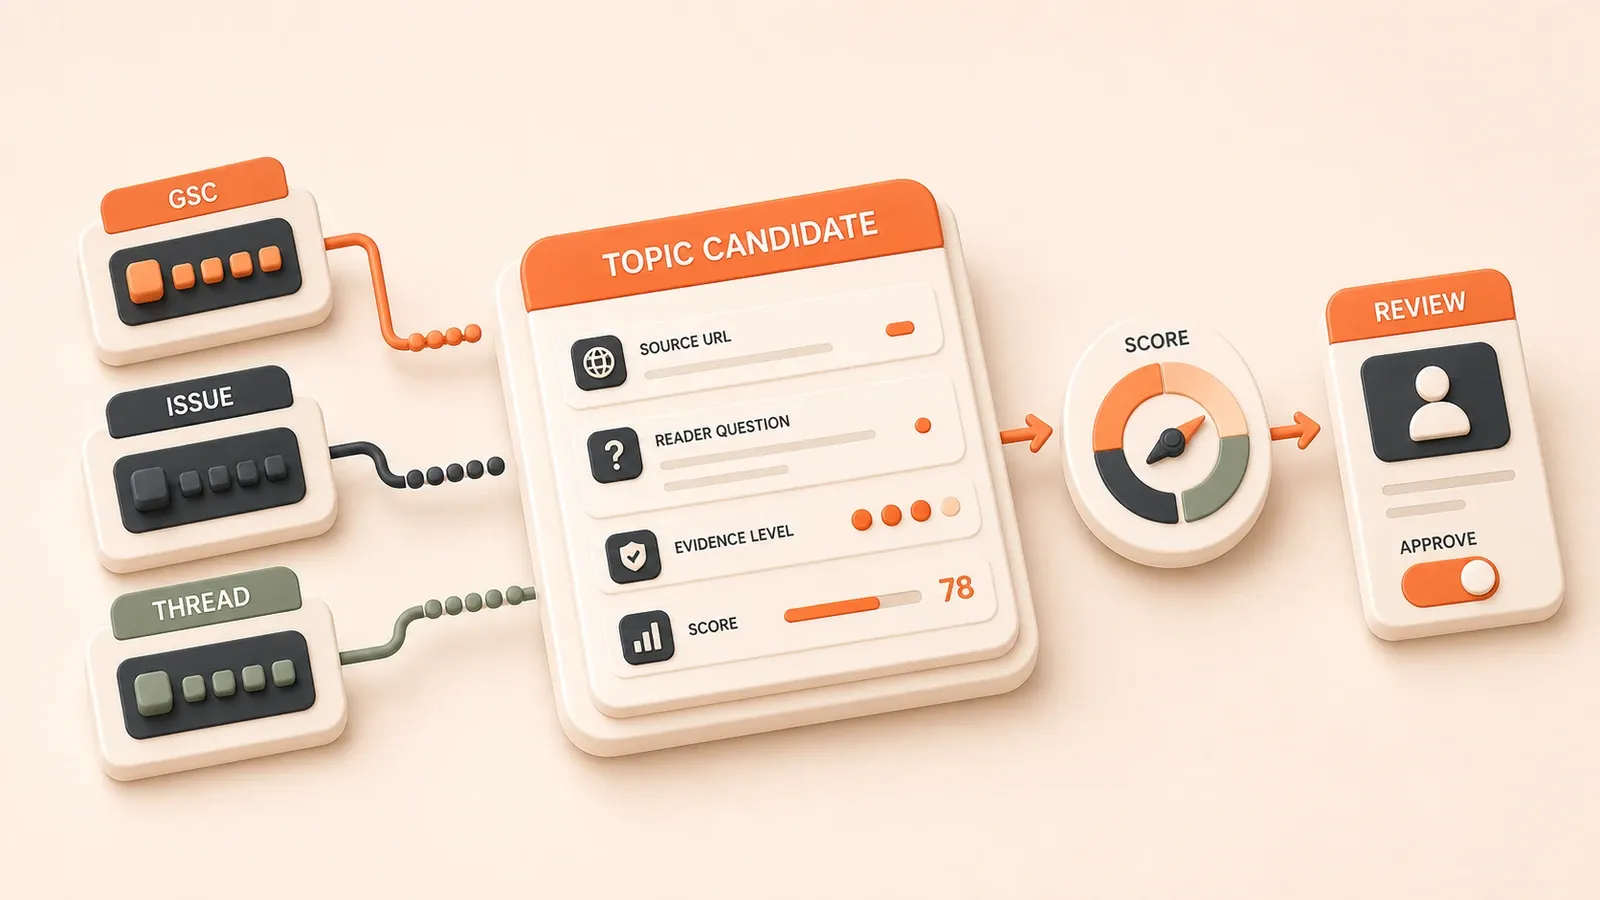
一张候选题表通常有三列:source_url 记录来源链接,reader_question 提炼读者问法,evidence_level 标注证据置信度。Reddit 的问题只能进第二列,不能进 fact_claim;技术事实仍要由官方文档或实测报错支撑。
选题 Agent 不是帮你”刷热点”,而是把 Google Search Console 的真实查询词、GitHub issue 的技术卡点和 Reddit/HN 的问法痛点,统一转成可审计的候选题卡片,再通过评分、去重和风险过滤进入内容任务表。整个过程可重复、可复查,而不是每次都靠灵感。
选题 Agent 的输入层设计
Google 自有数据层:Search Console Performance report 与 API 边界
选题 Agent 的第一层输入应该来自你自己站点的真实搜索数据,而不是第三方趋势工具。Google Search Console 的 Performance report 提供了四个核心指标和六个维度。
Performance report 数据维度
| 维度类型 | 包含字段 | 用途 |
|---|---|---|
| 查询词 | queries | 读者真实输入的搜索词,能发现”高曝光低点击”的候选 |
| 页面 | pages | 判断哪些页面已经有流量,避免重复造文 |
| 国家/地区 | countries | 地域差异,部分选题可能只适合特定市场 |
| 设备 | devices | mobile vs desktop,影响内容格式和深度 |
| 搜索外观 | search appearance | 富媒体结果类型,可反向推导结构化数据缺口 |
| 时间 | dates | 时间范围,用于采样和对比 |
四个指标分别是 clicks(点击次数)、impressions(曝光次数)、CTR(点击率)和 average position(平均排名)。其中 impressions 最适合选题判断:某个 query 有曝光但没有点击,说明读者在找但你还没写或者写得不够清楚。
Search Console API 查询设计与限制
程序化调用需要用 searchAnalytics.query 接口。根据 Google API 文档(截至 2026 年 7 月),该接口需要 OAuth 授权,rowLimit 参数范围是 1 到 25,000,可以按 dimensions(如 query、page)、filters(如 country、device)和 aggregationType 查询。
需要注意两点:一是 API 不保证返回所有数据行,而是受 Search Console 内部限制影响,优先返回 top rows;二是请求 recent data 时,返回元数据可能标出仍在处理的不完整日期或小时。Agent 设计时要考虑分页、缓存和”数据可能不完整”的提示,不能把导出结果当成绝对全量。
Custom Search JSON API 迁移提醒
Google Custom Search JSON API 曾被广泛用于程序化 web 搜索,但官方文档已标注对新客户不可用,现有客户需要在 2027-01-01 前迁移。新系统不建议依赖该 API,可用通用搜索网关或其他受支持的搜索产品兜底。
如果现有项目仍在使用 Custom Search JSON API,需要提前规划迁移,至少要在配置文件里预留替换接口的入口。
GitHub 输入层:Search API 边界与 issue 查询模板
GitHub 是技术选题的重要来源:issue 标题往往是读者真实遇到的报错或功能卡点,release note 和 discussion 能反映版本变化和最佳实践需求。但 GitHub Search API 有明确的硬性限制。
GitHub Search API 边界与速率限制
| 类型 | 速率限制 | 说明 |
|---|---|---|
| authenticated search(除 code) | 30 requests/min | 需要配置 token,适合持续采集 |
| unauthenticated search | 10 requests/min | 无 token,仅适合低频测试 |
| code search | 10 requests/min | 必须认证,搜索代码片段 |
每次搜索最多返回 1,000 个结果,超出部分无法通过分页获取。查询可能因为复杂度过高而超时,此时返回的 JSON 会包含 incomplete_results: true,表示数据可能不完整。
Issue 查询模板与文章类型映射
GitHub 搜索语法支持多种限定符,例如:

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
常用限定符包括 is:issue/is:pr(区分类型)、in:title/in:body/in:comments(限定字段)、repo:/user:/org:(限定仓库或组织)、state:(状态)、label:(标签)、reason:(关闭原因)。
不同查询能对应不同文章类型:
| 查询模式 | 文章类型候选 | 示例标题生成 |
|---|---|---|
| bug + in:title + 报错关键词 | 排障型 | ”升级后常见报错排查” |
| enhancement + in:title | 对比型/迁移型 | ”新功能 vs 旧方案:XX 实战对比” |
| discussion + in:body + “best practice” | 最佳实践型 | ”XX 最佳实践:来自 GitHub Discussion 的真实方案” |
| closed + reason:“completed” | 版本更新解读 | ”XX v2.0 新特性解读:issue 验证与迁移要点” |
速率限制与 incomplete_results 降级策略
Agent 调用 GitHub API 后应优先读取响应头里的 x-ratelimit-* 字段;需要汇总各类配额时再调用 GET /rate_limit。遇到速率限制时等待 retry-after 或 x-ratelimit-reset 指定的时间,持续失败时采用指数退避并停止重试。
如果返回 incomplete_results: true,标记候选题卡片”数据可能不完整,需要手动补充”,而不是把现有结果当成全量。评分时不把 GitHub stars 或 issue 评论数当成唯一权重,只作为参考信号之一。
Reddit 输入层:只读白名单与访问风险
Reddit 能提供真实的读者问法和痛点词,但 Reddit API 的访问政策和反爬机制容易变化,调用失败的风险较高。这些信息只能作为”问法”和”FAQ 候选”输入;正文里的技术事实仍需官方文档或实测报错支撑。
只读白名单端点
BetterLink 调研只允许读取和搜索,禁止任何写操作:
允许的只读端点:
listing:获取帖子列表comments:获取帖子评论info:获取帖子或用户元信息search:搜索帖子
禁止的写操作端点:
comment:发表评论submit:发布帖子vote:投票save、hide:保存或隐藏帖子
如果 Agent 调用 Reddit API,必须在代码层面硬编码只读白名单,避免误触发写操作。
访问风险与降级策略
Reddit API 调用可能遇到三类问题:授权失败(token 过期或权限不足)、反爬限制(频率过高被临时拦截)、Developer Platform 政策变化(部分端点可能被停用)。
降级策略如下:
- 尝试 Reddit API 调用 → 失败时记录错误日志
- 降级到允许访问的社区问题搜索结果
- 提取问法和痛点词 → 转成 FAQ 候选
- 继续后续的评分和去重流程,不中断整个工作流
即使 Reddit 数据获取失败,选题 Agent 仍能从 GSC 和 GitHub 获取输入,只损失一部分问法参考。
数据定位:问法/痛点输入,不作为事实证明
候选题表的三列设计能体现 Reddit 的定位:
| 列名 | 用途 | Reddit 数据允许进入 |
|---|---|---|
source_url | 来源链接 | 允许 |
reader_question | 读者问法提炼 | 允许(主要用途) |
evidence_level | 证据置信度 | 不允许进入 fact_claim 列,只作为 reader_signal |
示例:Reddit 问题 “How to fix X error after upgrading to v2?” → Agent 提炼问法 → 生成候选题卡片:reader_question: "升级到 v2 后报错怎么排查",evidence_level: "community"。后续评分会降低该候选的置信权重,人工审核时会提示”需要补充官方文档或实测验证”。
这种分层设计能避免”最近 Reddit 上很多人在问”这类假热度表述,把 Reddit 归位为搜索意图输入,而不是事实来源。
候选题提取与分类流程
选题 Agent 的核心不是”刷热点”,而是把三个输入源(GSC、GitHub、Reddit)的数据统一转成候选题卡片,再通过评分、去重和风险过滤进入任务表。整个流程可以拆成五个步骤。
5 步工作流概览
Step 1:Google 自有数据层

- 调用 Search Console API,提取过去 30-90 天的
queries数据 - 识别”高曝光低点击”的 query(例如 impressions > 100 且 CTR < 2%)
- 提取已有流量但缺少 FAQ 段落的页面
- 输出:GSC query 候选表,标注
query、impressions、CTR、existing_page
Step 2:GitHub issue 分类
- 按仓库或组织批量搜索 issue,使用查询模板(见前文)
- 自动分类:
label:bug→ 排障型、label:enhancement→ 对比型、discussion → 最佳实践型 - 提取 issue 标题中的报错关键词、版本号、功能名
- 输出:GitHub issue 候选表,标注
issue_url、suggested_type、keywords
Step 3:Reddit/HN 痛点词提取
- 搜索指定 subreddit 或 HN,提取问法关键词
- 提炼常见问题格式:“How to fix X”、“Why does X happen”、“Best way to do X”
- 这些帖子只用于提炼问法,不能证明技术事实
- 输出:Reddit/HN 问法表,标注
source_url、reader_question、evidence_level: community
Step 4:去重与站内检索
- 用候选题的关键词在站内搜索,检查是否已有相似文章
- 用 GSC query 检查是否已有覆盖该意图的页面
- 计算标题相似度,避免”升级后报错排查”和”升级后错误处理”这种重复候选
- 输出:去重后的候选题表,标注
duplicate_check_result
Step 5:人工审核点
- 候选题卡片落库前,人工需要审核:
- 评分是否合理(搜索价值、站点匹配、新增价值、可验证性)
- 标题和关键词是否准确
- 是否真的需要新建文章,还是补旧文 FAQ
- 输出:审核通过的候选题卡片,进入内容任务表
整个流程不是全自动,而是”自动化采集 + 结构化输出 + 人工审核”。Agent 的价值在于把手工浏览变成程序化提取,把散落的信号变成统一的候选题卡片,但最终判断仍需要人工。
评分框架:搜索价值 + 站点匹配 + 新增价值 + 可验证性
候选题不是只要有”热度”就值得写。选题 Agent 需要用四维评分框架判断:该候选题是否匹配站点定位、是否能写出新增价值、是否有人工可验证的来源。
评分维度说明
| 维度 | 权重 | 判断依据 | 数据来源 |
|---|---|---|---|
| 搜索价值 | w1(例如 0.3) | GSC impressions、query volume、竞品覆盖程度 | Search Console、第三方 SEO 工具 |
| 站点匹配 | w2(例如 0.25) | 站点主题范围、系列归属、标签匹配度 | 站点配置、系列列表、标签库 |
| 新增价值 | w3(例如 0.25) | 站内是否已有相似内容、竞品是否已有高质量覆盖 | 站内搜索、竞品检索 |
| 可验证性 | w4(例如 0.2) | 是否有官方文档、issue、release note、实测数据可用 | 来源标注、evidence_level |
评分公式:total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
每个维度用 0-1 评分,最终 total_score 也是 0-1。可以设定阈值(例如 0.6),低于阈值的候选题自动标记为”暂不进入任务表”,等待人工二次判断。
评分示例:候选题”升级后报错排查”
假设候选题来自 GitHub issue is:issue state:open label:bug in:title error after upgrading to v2,站点主题是 DevOps 和容器技术,候选题提炼为”升级后常见报错排查”。
| 维度 | 得分 | 判断理由 |
|---|---|---|
| 搜索价值 | 0.7 | GSC 里已有相似 query,impressions 中等;竞品有零散文章但质量一般 |
| 站点匹配 | 0.8 | 站点已有容器升级系列,标签有 DevOps;该候选题能补全系列缺口 |
| 新增价值 | 0.6 | 站内已有一篇”升级注意事项”,但缺少报错排查段落;可以补旧文或新写子篇 |
| 可验证性 | 0.9 | 有 GitHub issue 链接、官方 release note 提到 breaking changes;能实测验证 |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
该候选题 total_score = 0.74 > 0.6,进入人工审核队列。审核时人工会看到:建议补旧文 FAQ 或新写子篇,优先补旧文。
这种评分框架能避免两个问题:一是只看热度不看站点匹配,导致文章和站点定位脱节;二是只看搜索量不看新增价值,导致重复造文或低质量搬运。
去重、证据分层与风险过滤门禁
候选题卡片进入任务表前,需要通过三层门禁:站内去重、来源置信度分层、Google 质量风险检查。这三层门禁能避免重复造文、低质量候选和规模化内容滥用风险。
三层门禁清单
门禁 1:站内去重
- 用 GSC query 检查:该 query 是否已有专门页面覆盖
- 用站内搜索检查:相似标题是否已存在
- 用标题相似度算法检查:“升级后报错排查”和”升级后错误处理”是否重复
- 结果:
duplicate_check_result字段标注”unique”/“similar_to_existing”/“duplicate”
门禁 2:来源置信度分层
evidence_level字段标注来源置信度:high:official/help/docs、issue with official response、实测数据medium:community/blog、HN discussion、GitHub discussion without official responselow:unknown source、无链接、纯推断
- 结果:
evidence_level列必须出现在候选题表
门禁 3:Google 质量风险检查
- 检查候选题是否会导致批量生成风险:
- 是否只是”换个参数重复写”?例如”Cloudflare Workers 配置教程”和”Cloudflare Pages 配置教程”如果结构完全一样,可能被判定为批量内容
- 是否有新增价值?如果竞品已有高质量覆盖,你只是重复,没有新增视角或实测
- 是否有事实核查机制?Reddit 问法不能作为事实,必须有官方来源或实测验证
- 结果:
risk_flag字段标注”safe”/“batch_risk”/“no_value_added”/“fact_check_needed”
证据分层标准表
| evidence_level | 来源类型 | 示例 | 后续处理 |
|---|---|---|---|
| high | official/help/docs | Google Search Console 帮助页、GitHub issue with maintainer comment | 可以直接引用,需要标注来源链接 |
| medium | community/blog | Reddit discussion、HN post、技术博客 | 只作为问法参考,正文需要补充官方来源 |
| low | unknown | 无来源链接、纯推断、编造数据 | 不进入任务表,或降级为”待调研” |
候选题卡片必须包含 evidence_level 列,人工审核时能一眼看到哪些候选需要补充来源。例如 GitHub issue 如果有官方 maintainer 评论,evidence_level 标注 high;如果只是普通用户讨论,标注 medium。
这三层门禁不是一次性过滤,而是逐层标记。即使某候选题命中风险,仍可以进入任务表,但会带着风险标记等待人工判断。Agent 的价值在于把风险提前暴露,而不是替人工做最终决定。
输出产物:候选题卡片与任务表落库
选题 Agent 的最终输出是候选题卡片,而不是直接生成文章。候选题卡片通过人工审核后进入内容任务表,后续由关键词聚类 Agent 和写作 Agent 处理。
候选题卡片字段
| 字段名 | 类型 | 说明 | 示例值 |
|---|---|---|---|
source_url | string | 来源链接 | https://github.com/user/repo/issues/123 |
reader_question | string | 读者问法提炼 | ”升级到 v2 后报错怎么排查” |
evidence_level | enum | 来源置信度 | high / medium / low |
search_value_score | number | 搜索价值评分(0-1) | 0.7 |
site_match_score | number | 站点匹配评分(0-1) | 0.8 |
value_score | number | 新增价值评分(0-1) | 0.6 |
verify_score | number | 可验证性评分(0-1) | 0.9 |
total_score | number | 总评分(0-1) | 0.74 |
suggested_type | enum | 建议文章类型 | 排障型 / 对比型 / 最佳实践型 / 迁移型 / 版本更新型 |
suggested_series | string | 建议系列归属 | cloudflare-bindui(如果站点有相关系列) |
duplicate_check_result | enum | 去重检查结果 | unique / similar_to_existing / duplicate |
risk_flag | enum | 风险标记 | safe / batch_risk / no_value_added / fact_check_needed |
候选题卡片是结构化数据,可以存成 JSON 或数据库记录。人工审核时能看到所有字段,而不是只看标题和热度。
任务表字段(简要说明)
候选题卡片审核通过后,会转成任务表记录,字段包括:
- 标题(人工审核后最终确定)
- 关键词(主关键词、次要关键词)
- 状态(
待写作/写作中/审核中/已发布) - 评分(继承候选题的
total_score) - 语言(zh/en,根据站点配置)
- 系列(如果
suggested_series有效) - 发布计划(预计发布时间、优先级)
任务表的具体字段设计和 API 操作会在后续文章单独展开,本篇只说明候选题卡片如何进入任务表。
人工审核点流程
候选题卡片落库前,人工需要审核:
- 评分审核:
total_score是否合理?如果某个维度得分过低(例如verify_score = 0.2),是否需要补充来源? - 标题和关键词审核:
reader_question提炼是否准确?关键词是否需要调整? - 站内检索二次确认:虽然 Agent 已做过去重,人工需要再次确认是否真的没有相似文章
- 落库决策:通过审核 → 进入任务表;不通过 → 标记原因(需要补充来源、重复、低价值等)
整个流程是:Agent 提取候选题 → 结构化评分和过滤 → 人工审核 → 落库。Agent 把手工浏览变成程序化提取,把散落的信号变成结构化卡片,但最终判断仍需要人工。这种设计能避免”一键批量生成选题”的风险,确保每个进入任务表的候选题都经过人工确认。
下一步与延伸阅读
完成候选题评分和人工审核后,下一阶段通常是关键词聚类、内容任务表管理和写作规划。相关实现可以继续参考:
- AI 调研 Agent 实战:从多平台搜索到证据报告
- GA/GSC 每周运营 SOP:修复高曝光低点击
- Google Search Console 高级技巧
- 技术博客季度选题指南
选题 Agent 只是内容站自动化的第一环。它把多来源信号变成可审核的候选题;后续聚类、任务管理、写作验证和旧文更新仍应在各自阶段完成。
搭建最小可执行的 AI 选题 Agent
把多来源需求信号归一成候选题卡片,经过评分、去重和人工审核后再写入内容任务表。
- 1
步骤 1: 读取站内库存
加载现有文章、系列计划和标签,建立后续去重与站点匹配的基线。 - 2
步骤 2: 拉取 GSC 数据
按 query 和 page 获取 clicks、impressions、CTR 与 average position,标出已有曝光和内容缺口。 - 3
步骤 3: 补充外部语境
用通用搜索查 SERP 问法和官方来源,保存查询词、时间、URL 与抓取状态。 - 4
步骤 4: 只读收集社区与 issue 信号
从 Reddit 提炼问法,从 GitHub issue 提取报错、版本和功能卡点,不执行任何写操作。 - 5
步骤 5: 归一并评分
生成候选题卡片,按搜索价值、站点匹配、新增价值和可验证性评分。 - 6
步骤 6: 去重和风险过滤
归一实体与搜索意图,检查站内重叠、证据等级、批量内容风险和易变事实。 - 7
步骤 7: 人工审核入库
人工检查排名靠前的候选,只把通过项写入内容任务表,并记录新建、刷新、补 FAQ 或丢弃等动作。
常见问题
AI 选题 Agent 应该抓 Google 搜索结果,还是 Search Console 自有数据?
Reddit 上的热门帖子能直接变成博客选题吗?
GitHub issue 适合找什么类型的技术博客选题?
怎样判断一个社区问题是真实需求,而不是一次性吐槽?
GitHub Search API 或 Reddit 访问失败时,选题流程要中断吗?
Google Custom Search JSON API 适合新项目吗?
选题 Agent 输出到任务表前,人工要审核什么?
16 分钟阅读 · 发布于: 2026年11月13日


评论
使用 GitHub 账号登录后即可评论