
Agente de IA para investigar temas: ideas de blog con Google, Reddit y GitHub
"Google Search Analytics API admite dimensiones como query y page, un rowLimit de 1 a 25 000 y paginación con startRow, y aclara que no garantiza todas las filas."
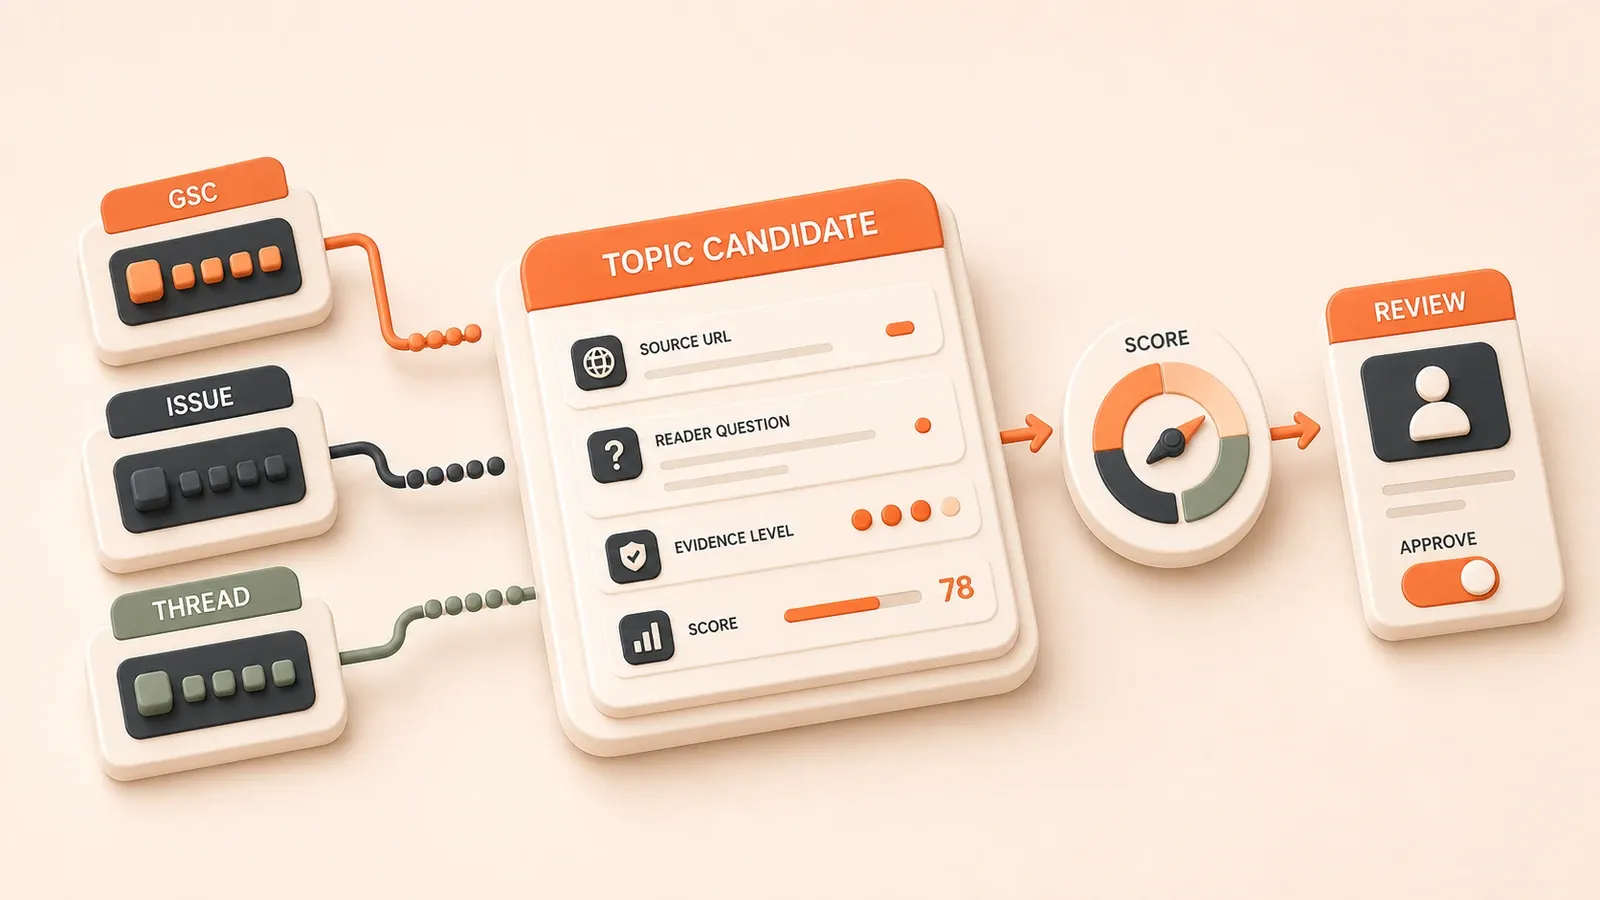
Una tabla de temas candidatos suele comenzar con tres columnas: source_url guarda el origen, reader_question resume cómo formula el problema el lector y evidence_level indica la solidez de la evidencia. Una expresión tomada de un foro pertenece a la segunda columna, no a fact_claim; los hechos técnicos aún necesitan documentación oficial o un error reproducido.
Un agente de investigación de temas no persigue tendencias. Convierte consultas reales de Google Search Console, bloqueos técnicos de issues de GitHub y expresiones de problemas de Reddit o HN en fichas candidatas auditables. La puntuación, deduplicación y filtros de riesgo determinan qué llega al backlog. El proceso es repetible y revisable.
Diseñar las capas de entrada del agente
Datos propios de Google: Performance report y límites de API
La primera capa debe provenir de los datos de búsqueda del sitio, no de una puntuación de tendencias de terceros. El Performance report de Google Search Console ofrece cuatro métricas principales y seis dimensiones.
Dimensiones del Performance report
| Dimensión | Campo | Uso |
|---|---|---|
| Consulta | queries | Muestra los términos reales y descubre candidatos con muchas impresiones y pocos clics |
| Página | pages | Identifica páginas que ya tienen tráfico y evita cobertura duplicada |
| País o región | countries | Detecta diferencias geográficas para temas de mercados específicos |
| Dispositivo | devices | Separa mobile y desktop, lo que influye en formato y profundidad |
| Apariencia en búsqueda | search appearance | Identifica resultados enriquecidos y posibles vacíos de datos estructurados |
| Fecha | dates | Define ventanas de muestreo y comparación |
Las cuatro métricas son clicks, impressions, CTR y average position. impressions resulta especialmente útil para elegir temas: si una query obtiene impresiones pero ningún clic, existe demanda y el sitio quizá no la responde con suficiente claridad.
Diseño de consultas y límites de Search Console API
El acceso programático utiliza searchAnalytics.query. Según la documentación de Google en julio de 2026, el método requiere OAuth, acepta un rowLimit de 1 a 25 000 y admite dimensions como query o page, filters como country o device y aggregationType.
Importan dos límites. Primero, la API no garantiza todas las filas; los límites internos de Search Console priorizan las filas superiores. Segundo, una solicitud de datos recientes puede incluir metadatos de días u horas que todavía se procesan. El agente debe paginar, almacenar en caché y conservar un indicador de datos incompletos en vez de tratar la exportación como exhaustiva.
Aviso de migración de Custom Search JSON API
Google Custom Search JSON API fue una opción habitual para búsquedas web programáticas. La página oficial ahora indica que está cerrada para clientes nuevos y que los clientes existentes deben migrar antes del 1 de enero de 2027. Un sistema nuevo debe usar un producto de búsqueda compatible o una pasarela de búsqueda general.
Si un proyecto existente aún depende de esa API, conviene planear pronto la migración y permitir que el proveedor se cambie desde la configuración.
Entrada de GitHub: límites de Search API y plantillas de issues
GitHub es una fuente sólida de temas técnicos. Los títulos de issues suelen describir errores reales o bloqueos de funciones, mientras que release notes y discussions muestran cambios de versión y necesidades de buenas prácticas. GitHub Search API también tiene límites firmes.
Límites y cuotas de GitHub Search API
| Tipo | Límite | Nota |
|---|---|---|
| búsqueda autenticada, excepto code | 30 requests/min | Requiere token y sirve para recopilación continua |
| búsqueda no autenticada | 10 requests/min | Solo para pruebas poco frecuentes con datos públicos |
| code search | 10 requests/min | Requiere autenticación para buscar código fuente |
Cada búsqueda devuelve como máximo 1 000 resultados y la paginación no permite ir más allá. Una consulta compleja también puede agotar el tiempo; entonces la respuesta JSON incluye incomplete_results: true, que señala un conjunto posiblemente incompleto.
Plantillas de consulta y tipos de artículo
GitHub Search admite calificadores combinables:

is:issue state:open label:bug in:title error repo:user/repo-name
is:issue state:closed reason:"completed" in:body "how to" repo:user/repo-name
is:pr state:open label:"enhancement" in:title repo:user/repo-name
is:issue e is:pr separan tipos, in:title, in:body e in:comments limitan campos y repo:, user: y org: definen el alcance. También pueden añadirse state:, label: y reason:.
Cada patrón sugiere un formato distinto:
| Patrón | Tipo candidato | Dirección de título |
|---|---|---|
| bug + in:title + término de error | Solución de problemas | «Errores comunes después de actualizar» |
| enhancement + in:title | Comparación o migración | «Función nueva frente al enfoque anterior: comparación práctica» |
| discussion + in:body + “best practice” | Buenas prácticas | «Enfoques prácticos de un foro de mantenedores» |
| closed + reason:“completed” | Análisis de versión | «Novedades de v2.0: issues verificados y notas de migración» |
Degradación ante cuotas e incomplete_results
Después de cada llamada, lee primero los encabezados x-ratelimit-*. Llama a GET /rate_limit cuando necesites un resumen de varios presupuestos. Si se alcanza un límite, espera hasta retry-after o x-ratelimit-reset; si los fallos continúan, aplica retroceso exponencial y termina.
Con incomplete_results: true, marca la ficha como «datos posiblemente incompletos; se necesita complemento manual». No trates el resultado como exhaustivo. Las estrellas y el número de respuestas son señales secundarias, nunca el único factor de clasificación.
Entrada de Reddit: lista de solo lectura y riesgos de acceso
Las publicaciones comunitarias aportan expresiones naturales y términos de dolor. Sin embargo, las políticas y protecciones de Reddit API pueden cambiar, por lo que la recuperación es menos fiable. Estas señales solo sirven para intención y candidatos de FAQ; las afirmaciones técnicas necesitan documentación oficial o errores reproducidos.
Lista permitida de endpoints de solo lectura
La investigación de BetterLink solo permite lectura y búsqueda, sin escrituras:
Endpoints de solo lectura permitidos:
listing: obtener listas de publicacionescomments: obtener comentarios de una publicacióninfo: obtener metadatos de una publicación o usuariosearch: buscar publicaciones
Endpoints de escritura prohibidos:
comment: publicar un comentariosubmit: publicar un postvote: votarsaveyhide: guardar u ocultar publicaciones
Cuando el agente usa Reddit API, la lista permitida debe codificarse de forma explícita para que ningún flujo active por accidente una escritura.
Riesgos de acceso y rutas de degradación
Los fallos habituales son una autorización caducada o insuficiente, un bloqueo temporal por exceso de solicitudes o un cambio de Developer Platform que elimina un endpoint.
La secuencia de degradación es:
- Llamar a Reddit API → registrar el error si falla
- Pasar a resultados accesibles sobre problemas comunitarios
- Extraer expresiones y términos de dolor → crear candidatos de FAQ
- Continuar puntuación y deduplicación sin detener todo el flujo
Aunque falle Reddit, el agente puede seguir usando GSC y GitHub. Solo pierde una parte de las señales de lenguaje y dificultades.
Tratar los datos como lenguaje, no como prueba
Las tres columnas muestran claramente el papel de esta fuente:
| Columna | Uso | Datos permitidos de Reddit |
|---|---|---|
source_url | Fuente original | permitidos |
reader_question | Pregunta normalizada del lector | permitida y uso principal |
evidence_level | Confianza en la evidencia | no debe completar fact_claim, solo reader_signal |
Por ejemplo, «How to fix X error after upgrading to v2?» se convierte en una ficha con reader_question: "¿Cómo soluciono el error después de actualizar a v2?" y evidence_level: "community". La evidencia recibe menor peso y la revisión exige documentación oficial o una reproducción.
Esta separación evita afirmaciones sin respaldo como «muchas personas en Reddit tienen este problema». La comunidad aporta el vocabulario de intención, no una prueba de hechos técnicos.
Extraer y clasificar temas candidatos
La tarea central consiste en normalizar las tres entradas —GSC, GitHub y Reddit— en fichas candidatas y aplicar puntuación, deduplicación y filtros de riesgo. El flujo tiene cinco pasos.
Flujo de cinco pasos
Paso 1: datos propios de Google

- Consultar Search Console API para obtener
queriesde los últimos 30–90 días - Detectar queries con muchas impresiones y CTR bajo, usando un umbral de ejemplo como impressions > 100 y CTR < 2%
- Encontrar páginas con tráfico pero sin una sección de FAQ suficiente
- Salida: tabla de GSC con
query,impressions,CTRyexisting_page
Paso 2: clasificación de issues de GitHub
- Buscar issues por repositorio u organización con las plantillas anteriores
- Clasificar
label:bugcomo solución,label:enhancementcomo comparación y discussions como buenas prácticas - Extraer términos de error, números de versión y nombres de funciones de los títulos
- Salida: tabla de GitHub con
issue_url,suggested_typeykeywords
Paso 3: extracción de puntos de dolor de Reddit/HN
- Buscar en subreddits elegidos o HN y extraer expresiones recurrentes
- Normalizar patrones como «How to fix X», «Why does X happen» y «Best way to do X»
- Usar publicaciones para formular intención, no para demostrar hechos técnicos
- Salida: tabla con
source_url,reader_questionyevidence_level: community
Paso 4: deduplicación y búsqueda interna
- Buscar en el sitio con las palabras clave de cada candidato
- Comprobar si una página ya cubre la intención de una query de GSC
- Calcular similitud de títulos para que «errores después de actualizar» y «gestión de errores de actualización» no sean dos temas
- Salida: fichas deduplicadas con
duplicate_check_result
Paso 5: revisión humana
- Antes de admitir una ficha, revisar:
- ¿Son razonables las puntuaciones de oportunidad, encaje, valor y verificabilidad?
- ¿Son correctos el enfoque del título y las palabras clave?
- ¿Hace falta un artículo nuevo o una FAQ en uno existente?
- Salida: fichas aprobadas al backlog de contenido
El flujo no es totalmente autónomo. El agente automatiza recopilación y estructura; una persona conserva la decisión editorial final.
Puntuar oportunidad, encaje, valor añadido y verificabilidad
La popularidad no basta para justificar una publicación. El agente evalúa si el tema encaja con el sitio, añade valor que no existe y dispone de fuentes verificables.
Dimensiones de puntuación
| Dimensión | Peso | Señales | Fuente |
|---|---|---|---|
| Oportunidad de búsqueda | w1, por ejemplo 0,3 | GSC impressions, query volume, cobertura de competidores | Search Console, herramientas SEO externas |
| Encaje con el sitio | w2, por ejemplo 0,25 | alcance, pertenencia a series, coincidencia de etiquetas | configuración, lista de series, biblioteca de etiquetas |
| Valor añadido | w3, por ejemplo 0,25 | artículos internos similares y calidad de resultados existentes | búsqueda interna, investigación de competidores |
| Verificabilidad | w4, por ejemplo 0,2 | docs oficiales, issues, releases y pruebas reproducibles | metadatos de fuente, evidence_level |
Fórmula: total_score = w1*search_value + w2*site_match + w3*value_added + w4*verify
Cada dimensión se puntúa de 0 a 1, por lo que total_score se mantiene en ese rango. Un umbral de ejemplo de 0,6 puede marcar candidatos débiles como «pendientes de revisión» en lugar de admitirlos automáticamente.
Ejemplo: «solucionar errores después de actualizar»
Supongamos que el candidato procede de is:issue state:open label:bug in:title error after upgrading to v2. El sitio trata DevOps y contenedores, y el tema normalizado es «errores comunes después de actualizar».
| Dimensión | Puntuación | Motivo |
|---|---|---|
| Oportunidad de búsqueda | 0,7 | GSC contiene una query relacionada con impresiones medias; los artículos competidores son fragmentarios |
| Encaje con el sitio | 0,8 | Existe una serie de actualización de contenedores y una etiqueta DevOps; el candidato cubre un vacío |
| Valor añadido | 0,6 | Un artículo de «notas de actualización» no incluye solución de errores; puede ampliarse o crear un artículo hijo |
| Verificabilidad | 0,9 | Un issue de GitHub y una release note oficial describen el cambio incompatible y el error puede reproducirse |
total_score = 0.3*0.7 + 0.25*0.8 + 0.25*0.6 + 0.2*0.9 = 0.21 + 0.2 + 0.15 + 0.18 = 0.74
Como 0,74 > 0,6, el candidato pasa a revisión humana. La ficha también recomienda ampliar primero el artículo existente o crear un artículo hijo si el alcance es independiente.
Este marco evita perseguir demanda ajena al sitio y publicar cobertura duplicada sin experiencia ni evidencia nueva.
Aplicar controles de duplicados, evidencia y riesgo
Antes de la admisión, cada candidato pasa tres controles: deduplicación interna, clasificación de confianza de la fuente y riesgo de calidad de Google. Así quedan visibles duplicados, evidencia débil y riesgos de contenido escalado.
Lista de tres controles
Control 1: deduplicación interna
- Comprobar si una query de GSC ya tiene una página dedicada
- Buscar títulos similares en el sitio
- Comparar similitud para no separar «solución de errores de actualización» y «gestión de errores después de actualizar»
- Escribir
unique,similar_to_existingoduplicateenduplicate_check_result
Control 2: confianza de evidencia
- Definir
evidence_level:high: ayuda o docs oficiales, issue con respuesta oficial o datos de pruebas propiasmedium: publicación comunitaria o independiente sin confirmación de mantenedorlow: fuente desconocida, sin enlace o inferencia sin respaldo
- Exigir
evidence_levelen cada ficha
Control 3: riesgo de calidad de Google
- Comprobar si el candidato fomenta contenido escalado de bajo valor:
- ¿Es el mismo artículo con un parámetro distinto, como procedimientos casi idénticos de Cloudflare Workers y Cloudflare Pages?
- ¿Añade una perspectiva, prueba reproducible o criterio operativo frente al buen contenido existente?
- ¿El plan de verificación separa el lenguaje comunitario de la evidencia oficial o de pruebas?
- Escribir
safe,batch_risk,no_value_addedofact_check_neededenrisk_flag
Referencia de niveles de evidencia
| evidence_level | Tipo de fuente | Ejemplo | Acción |
|---|---|---|---|
| high | official/help/docs | ayuda de Google Search Console o issue de GitHub con respuesta de mantenedor | Puede respaldar una afirmación si se conserva la URL |
| medium | community/blog | foro, publicación independiente o blog técnico | Usar para lenguaje del lector y añadir una fuente primaria |
| low | unknown | sin URL, inferencia pura o datos inventados | Rechazar o mover a una cola de investigación |
Cada ficha necesita evidence_level para que quien revisa sepa qué ideas requieren fuentes más sólidas. Un issue con respuesta de mantenedor puede ser high; una conversación solo entre usuarios permanece medium.
Los controles no borran silenciosamente todos los candidatos riesgosos. Asignan estados visibles para que una persona decida la siguiente acción.
Guardar fichas y admitirlas en el backlog
La salida final es una ficha candidata, no un artículo. Después de la aprobación humana, se convierte en una entrada del backlog para clustering de palabras clave y agentes de redacción.
Campos de la ficha candidata
| Campo | Tipo | Descripción | Ejemplo |
|---|---|---|---|
source_url | string | fuente original | https://github.com/user/repo/issues/123 |
reader_question | string | pregunta normalizada | «¿Cómo soluciono errores después de actualizar a v2?» |
evidence_level | enum | confianza de la fuente | high / medium / low |
search_value_score | number | oportunidad de búsqueda de 0 a 1 | 0,7 |
site_match_score | number | encaje de 0 a 1 | 0,8 |
value_score | number | valor añadido de 0 a 1 | 0,6 |
verify_score | number | verificabilidad de 0 a 1 | 0,9 |
total_score | number | total ponderado de 0 a 1 | 0,74 |
suggested_type | enum | formato recomendado | troubleshooting / comparison / best_practice / migration / release_update |
suggested_series | string | serie recomendada | cloudflare-bindui si existe esa serie |
duplicate_check_result | enum | resultado de solapamiento | unique / similar_to_existing / duplicate |
risk_flag | enum | riesgo de calidad | safe / batch_risk / no_value_added / fact_check_needed |
Las fichas pueden guardarse como JSON o registros de base de datos. La revisión considera todos los campos, no solo el título y una métrica de popularidad.
Campos del backlog
Un candidato aprobado se convierte en una entrada con:
- Título finalizado durante la revisión humana
- Palabras clave principales y secundarias
- Estado
to_write,writing,reviewopublished total_scoredel candidato- Idioma, como zh o en, según la configuración
- Serie, si
suggested_serieses válida - Fecha prevista de publicación y prioridad
Un artículo posterior puede definir el esquema completo y la API. Este flujo cubre únicamente la admisión de la ficha.
Flujo de revisión humana
Antes de admitir, una persona comprueba:
- Puntuación: ¿Es razonable
total_scorey un valor bajo comoverify_score = 0.2exige más evidencia? - Título y palabras clave: ¿
reader_questionrepresenta bien el problema y deben cambiarse las palabras clave? - Segunda búsqueda interna: ¿La deduplicación automática omitió un artículo similar?
- Decisión: Aprobar, rechazar o pedir más evidencia, y registrar el motivo
El flujo es extracción del agente → puntuación y filtrado estructurados → revisión humana → admisión. La automatización organiza señales dispersas en fichas comparables, mientras la responsabilidad editorial sigue en manos humanas.
Próximos pasos y artículos relacionados
Después de puntuar y revisar suelen seguir el clustering de palabras clave, la gestión del backlog y la planificación de redacción. Estos artículos aportan contexto:
- Agente de investigación de IA: de la búsqueda multiplataforma al informe de evidencia
- SOP semanal de GA/GSC para páginas con muchas impresiones y pocos clics
- Técnicas avanzadas de Google Search Console
- Planificación trimestral de temas para blogs técnicos
Un agente de investigación de temas es solo la primera fase de la automatización de un sitio de contenido. Convierte señales de varias fuentes en candidatos revisables; clustering, gestión de tareas, verificación de redacción y actualización quedan como pasos posteriores separados.
Crear un agente mínimo de IA para investigar temas
Normaliza señales de varias fuentes en fichas candidatas, puntúalas, deduplícalas y escribe en el backlog solo las aprobadas por una persona.
- 1
Step 1: Cargar el inventario de contenido
Lee artículos existentes, planes de series y etiquetas para establecer la base de deduplicación y encaje. - 2
Step 2: Obtener datos de GSC
Recupera clicks, impressions, CTR y average position por query y page, y marca la demanda existente y los vacíos. - 3
Step 3: Añadir contexto externo
Usa búsqueda general para preguntas de SERP y fuentes primarias, y guarda consulta, hora, URL y estado de recuperación. - 4
Step 4: Recopilar señales comunitarias y de issues en modo de solo lectura
Extrae expresiones de Reddit y errores, versiones o bloqueos funcionales de issues de GitHub sin realizar operaciones de escritura. - 5
Step 5: Normalizar y puntuar candidatos
Crea fichas candidatas y puntúa oportunidad de búsqueda, encaje con el sitio, valor añadido y verificabilidad. - 6
Step 6: Filtrar duplicados y riesgos
Normaliza entidades e intención y comprueba solapamientos, niveles de evidencia, riesgo de contenido escalado y hechos volátiles. - 7
Step 7: Revisar y admitir
Haz que una persona revise las mejores fichas, admite solo las aprobadas y registra crear, actualizar, añadir FAQ, fusionar o descartar.
FAQ
¿Un agente de temas debe priorizar resultados de Google o datos de Search Console?
¿Una publicación popular de Reddit puede convertirse directamente en tema de blog?
¿Qué temas técnicos pueden descubrirse en los issues de GitHub?
¿Cómo se distingue una demanda real de una queja aislada?
¿Debe detenerse el flujo si falla GitHub Search o el acceso a Reddit?
¿Google Custom Search JSON API es adecuada para un proyecto nuevo?
¿Qué debe revisar una persona antes de admitir un tema en el backlog?
13 min de lectura · Publicado el: 13 nov 2026

Guia practica de automatizacion de sitios de contenido con IA
Si llegaste desde búsqueda, lo más rápido es ir al artículo anterior o siguiente de esta misma serie.
Anterior
¿El contenido con IA aún sirve para SEO? Reglas de Google
Google explica cuándo el contenido con IA es aceptable, cuándo publicar a escala se convierte en spam y qué controles humanos reducen el riesgo.
Parte 1 de 4
Siguiente
Clustering de palabras clave con IA: de consultas a series y enlaces internos
Combina consultas GSC, ideas y artículos; agrupa por intención, valida con SERP y revisión humana, y asigna cada cluster a página, actualización, FAQ o enlace.
Parte 3 de 4


Comentarios
Inicia sesión con GitHub para dejar un comentario